ARTICLE · 1113836
学 ComfyUI,别再从下载 Workflow 开始
学 ComfyUI,别再从下载 Workflow 开始从文生图、Latent、LoRA,一直到 API、Server、MCP 和 Agent,真正值得学的不是节点,而是一套生成式 AI 的推理架构。 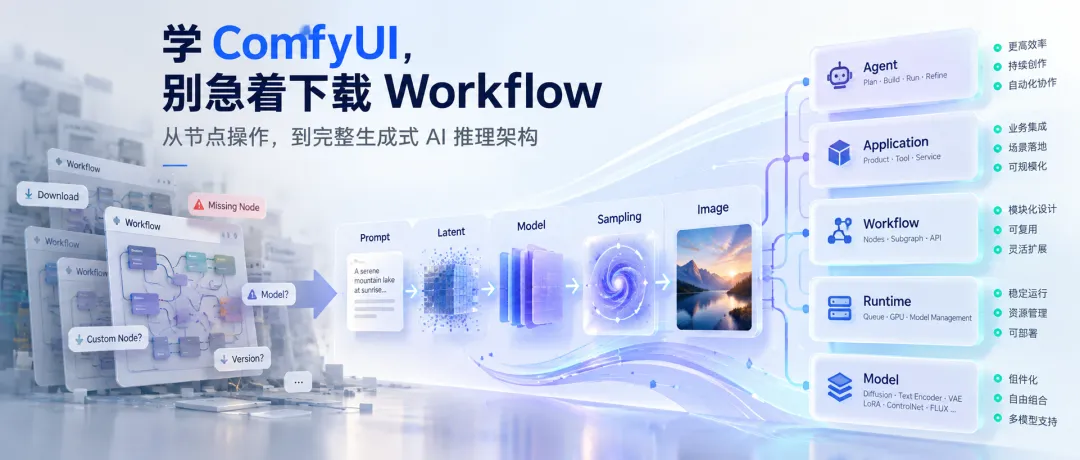
第一次打开 ComfyUI,很容易产生一种劝退感。Checkpoint、CLIP、VAE、KSampler、Latent、Conditioning……画布上摆着一堆陌生节点,再加上纵横交错的连线,它和我们熟悉的“输入 Prompt,然后点 Generate”完全不是一类产品。 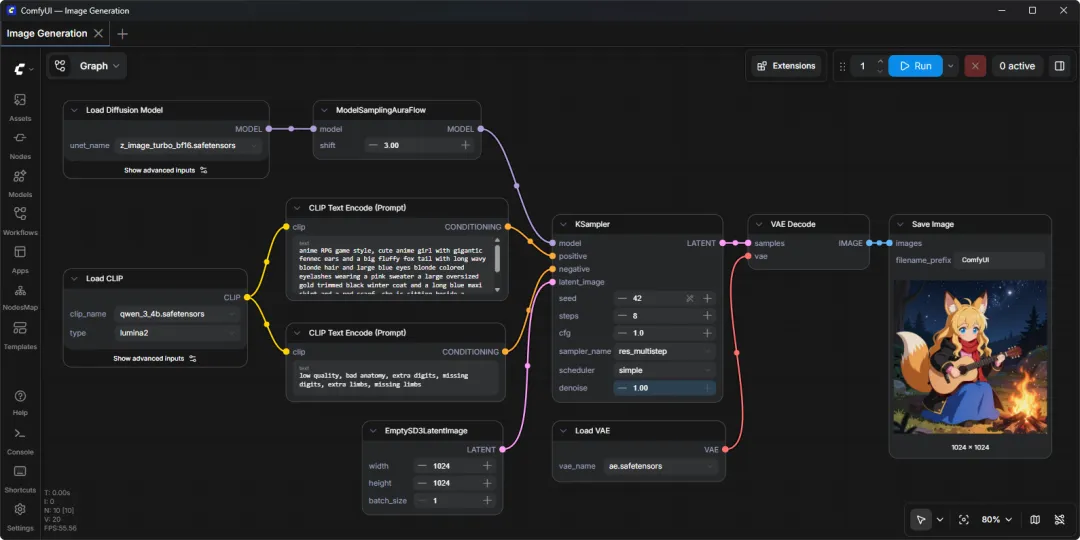
所以很多人学习 ComfyUI 的第一步,都是去网上下载 Workflow。缺模型就补模型,缺节点就安装 Custom Nodes,直到右上角不再报错,一张图片终于成功跑出来。如果准备系统学习 ComfyUI,我更建议按照这样一条路线往前走: 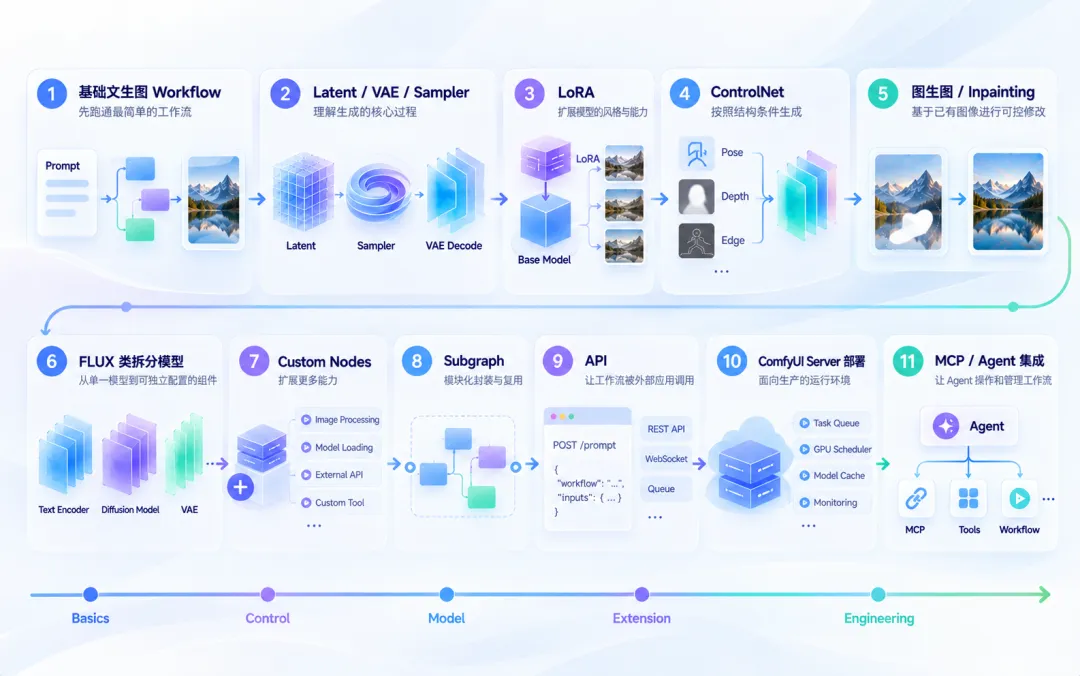
看起来步骤很多,但背后只有一条主线:先理解一次生成是怎么跑起来的,再理解怎样控制它,之后再进入工程化、服务化和 Agent 化。
ComfyUI 可以理解为一个面向生成式 AI 的可视化工作流编排器 + 本地推理引擎 + API 后端。 它最早因 Stable Diffusion 的节点式工作流流行起来,但现在已经明显超出“SD 出图软件”的范围:官方定位已经覆盖图像、视频、音频、3D、文本,以及本地模型和云端 Partner Models。 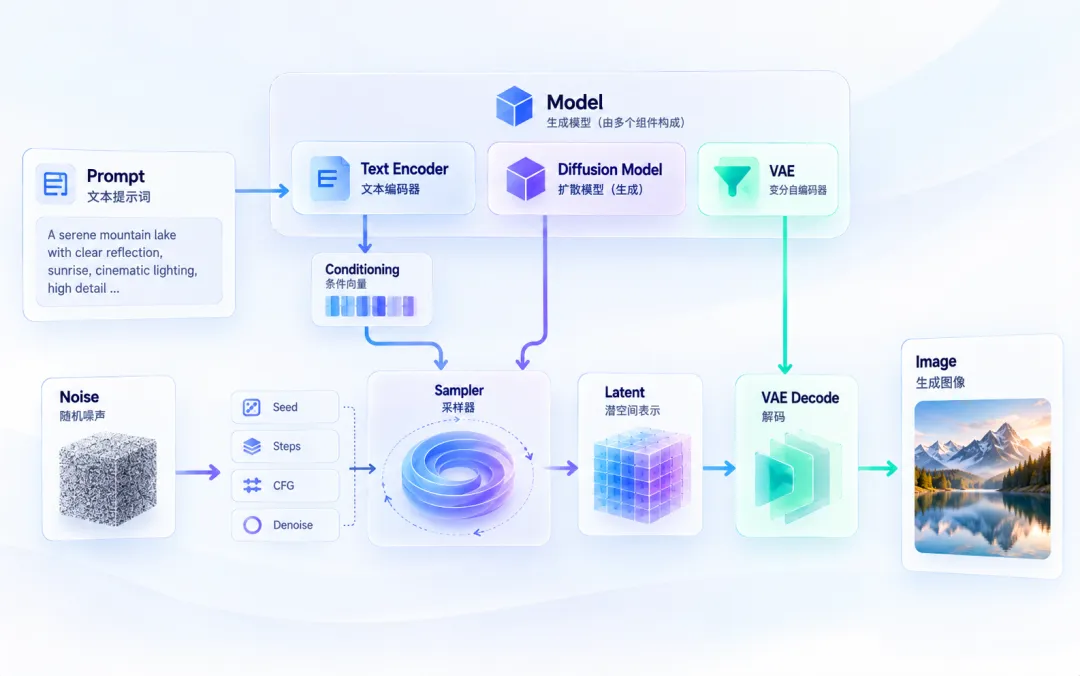
官方仓库还把它定位为可用于生产流程的模块化 AI Creation Engine。 新手刚开始不需要碰几十个节点的“大工作流”,一条最基础的 Text-to-Image 就已经足够。 典型流程只有几个核心节点:Checkpoint Loader、Text Encode、Empty Latent、KSampler、VAE Decode、Save Image。真正值得看的不是节点名字,而是它们之间到底在传递什么。 Prompt 输入之后,并不会直接交给扩散模型去“画图”。文本首先经过 Text Encoder,被转换成模型能够理解的 Conditioning;生成过程也不是直接在 1024×1024 的 RGB 图片上修改像素,而是在 Latent Space 中完成;采样结束之后得到的仍然是 Latent,最后还需要经过 VAE Decode,才会变成真正能够看到的 Image。 把这条链路自己搭一遍之后,ComfyUI 的学习难度会明显下降。因为从这时候开始,画布上的连线不再只是教程告诉你“应该这样接”,而开始具有明确的数据含义。 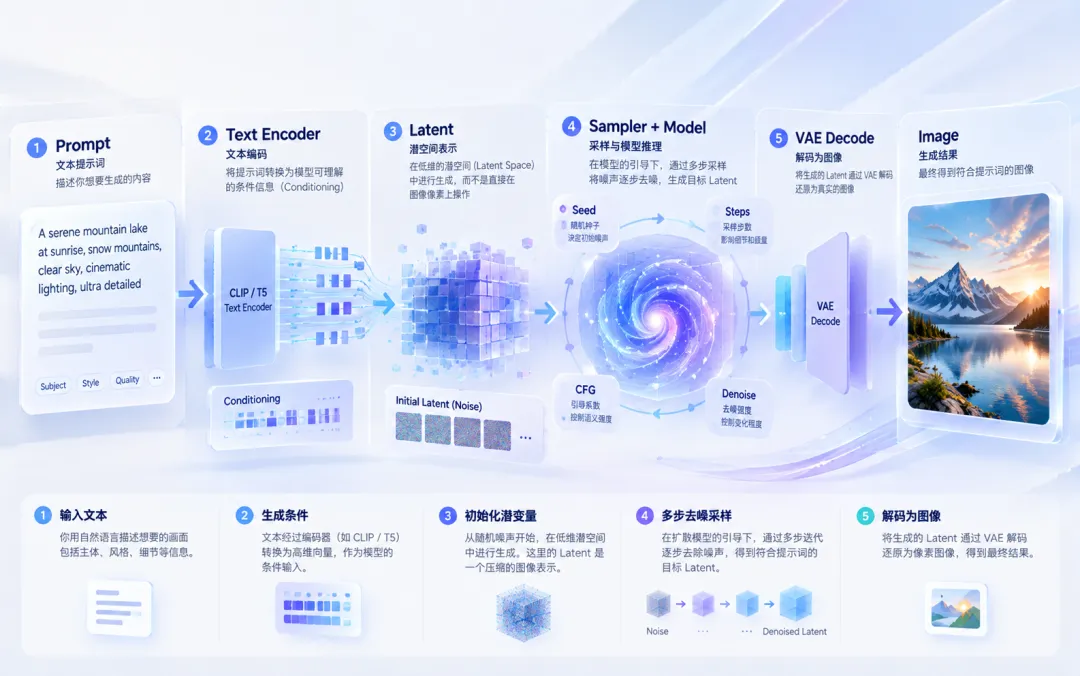
很多人用了很久 ComfyUI,KSampler 依然只是一个填写 Seed、Steps、CFG 的参数面板。真正理解扩散模型,绕不开这里。 可以把整个生成过程粗略拆成三个阶段:文本经过编码形成生成条件,Noise 在 Latent Space 中经过多轮采样逐渐形成目标 Latent,最后再通过 VAE 把 Latent 解码成 Image。 理解了这条链路以后,Seed、Steps、Scheduler、CFG、Denoise 这些参数才会从“调参经验”变成真正有意义的推理参数。 特别是 Denoise。 后面无论学习图生图、局部重绘,还是很多所谓“AI 修图”工作流,都会反复遇到它。它本质上影响的是:你允许模型从当前 Latent 状态重新生成到什么程度。 所以我更建议把这一阶段学扎实,而不是急着背“哪个 Sampler 出图更好”“CFG 设多少最好”。不同模型、不同蒸馏方式甚至不同 Scheduler 的最佳组合都会变化,但 Latent、Sampling、Decode 这套基本逻辑不会变。 一旦这层理解建立起来,很多所谓“玄学参数”其实都会变得清楚很多。
基础生成链路跑明白之后,我会先学 LoRA,再学 ControlNet。 LoRA 是理解“模型能力如何被扩展”的一个很好入口。在一些传统 WebUI 里,LoRA 看起来更像 Prompt 里附加的一条参数;到了 ComfyUI,它会真正进入计算图。Base Model 经过 LoRA 修改,再继续传给后面的 Sampler。 这个变化看似不大,却会建立一个很重要的认知:在 ComfyUI 里,模型本身也是 Workflow 中可以被传递、组合和修改的数据。 以后叠加多个 LoRA、Adapter,或者设计不同模型分支,本质上都是在延续这个思路。 ControlNet 则解决另一类问题。Prompt 更多是在告诉模型“我要生成什么”,ControlNet 开始进一步告诉模型“按照什么结构去生成”。 影响最终结果的已经不再只有 Prompt,而是模型、LoRA、ControlNet、参考图、结构条件等多个因素共同进入同一条推理链路。复杂 Workflow 的本质,并不是节点更多,而是控制条件更多。 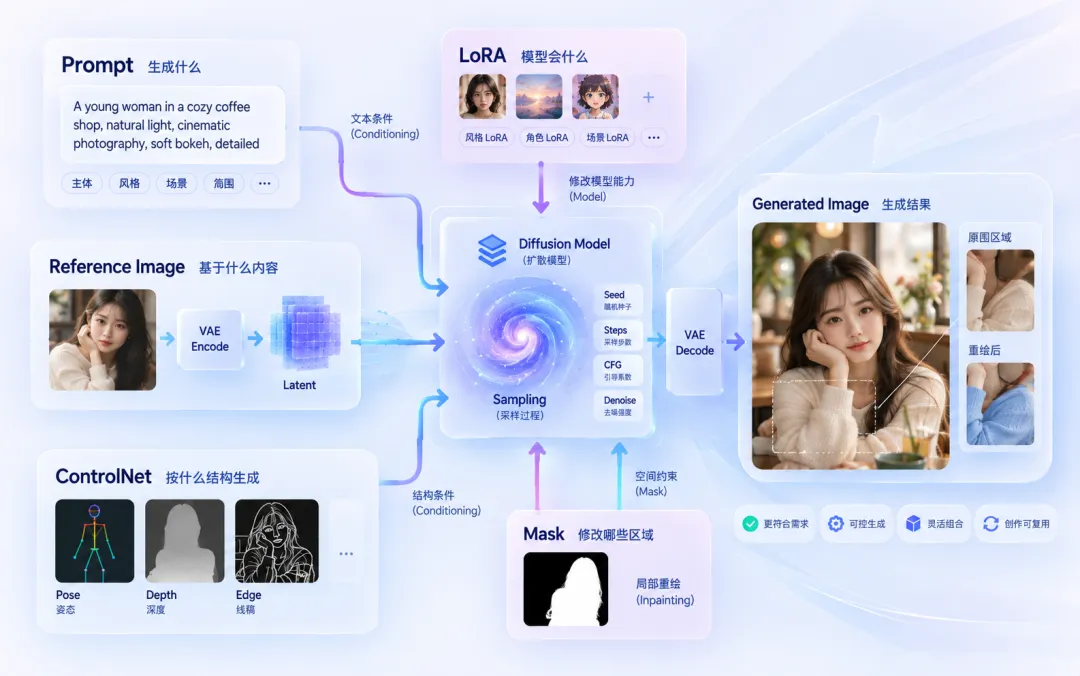
接下来再进入 Image-to-Image 和 Inpainting,会比一开始直接抄所谓“商业摄影 Workflow”清楚得多。 图生图的底层链路其实非常简单:原始 Image 先经过 VAE Encode 进入 Latent Space,在 Latent 上重新采样,然后再 Decode 回 Image。 理解这件事以后,很多操作都会被统一起来。 为什么 Denoise 越低,原图通常保留得越多?为什么提高 Denoise 之后,构图、纹理甚至主体都会发生变化?因为模型真正修改的不是“原始图片文件”,而是重新采样 Latent 的幅度。 Inpainting 只是在这条链路上再加入 Mask,把重新生成限制在指定区域。 换背景、换衣服、去除物体、修脸、商品局部重绘,看起来是完全不同的应用,拆到底层往往只是 Image、Mask、Latent 和 Sampling 的不同组合。 学到这里,再去看那些几十甚至上百个节点的复杂商业 Workflow,你会发现它们没有想象中那么神秘。大量复杂度,其实只是把前处理、检测、局部生成、增强和后处理串在了一起。
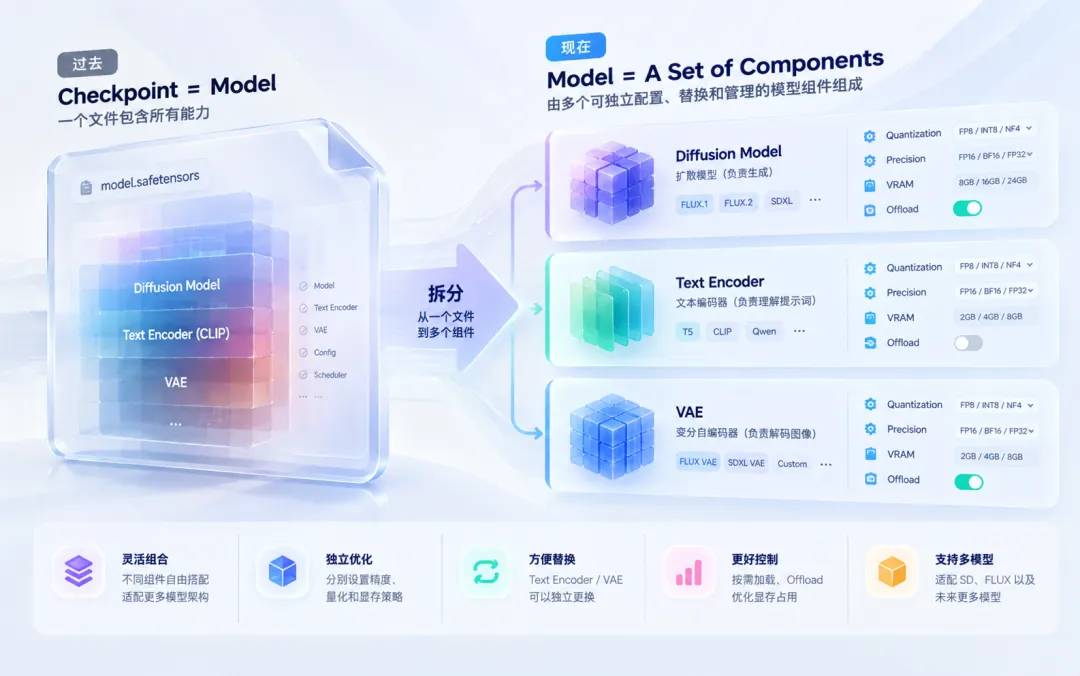
传统 Stable Diffusion 的使用方式,很容易让人形成一个固定印象:下载一个 .safetensors,这个文件就是模型。 到了 FLUX 这类模型,这种理解已经明显不够用了。 越来越多工作流开始把 Diffusion Model、Text Encoder、VAE 分开加载。不同组件可以使用不同模型文件、不同精度和量化方式,显存管理也开始分别考虑。 这时候再回头看最开始学习过的 Text Encoder、Latent 和 VAE,会发现前面的基础并没有白学。 所谓“一个生成模型”,在实际推理系统里,本来就不一定是一个单独文件,而更像是一组协同工作的 Model Components。Text Encoder 可以换,Diffusion Model 可以换,VAE 可以独立加载,模型精度、量化方式和显存策略也可以分别处理。 从这一阶段开始,学习对象已经不再只是“Stable Diffusion 怎么出图”,而逐渐变成了:现代生成模型到底是怎样被组织、加载和执行的。 这也是 ComfyUI 最值得长期学习的地方。它把很多原本藏在 WebUI 后面的东西,直接摊开给你看。
模型层理解得差不多之后,再开始研究 Custom Nodes 会合适很多。 ComfyUI 本身采用客户端和服务器分离的架构。前端负责 Canvas 和交互,Python Server 负责模型、数据处理以及真正的推理执行。Custom Node 本质上就是把某种能力包装成标准节点,定义输入、执行逻辑和输出,然后接入 Workflow Graph。 所以图像检测、抠图、深度估计、模型加载、第三方 API,甚至一种完全新的生成模型,都可以通过这种方式进入 ComfyUI。 如果本身有开发经验,我很建议在这个阶段自己写一个最简单的 Custom Node。哪怕只是接收 IMAGE,做一点简单处理,再输出 IMAGE,都比安装几十套节点包更容易理解 ComfyUI 的扩展机制。 等 Workflow 逐渐达到几十甚至上百个节点,另一个问题就会出现:画布开始失控。 这时候 Subgraph 才真正有价值。 当你开始考虑“这条 Pipeline 应该拆成哪些模块”,而不是“下一个节点放在哪里”,基本就已经从 Workflow 使用者进入 Workflow Designer 的阶段了。 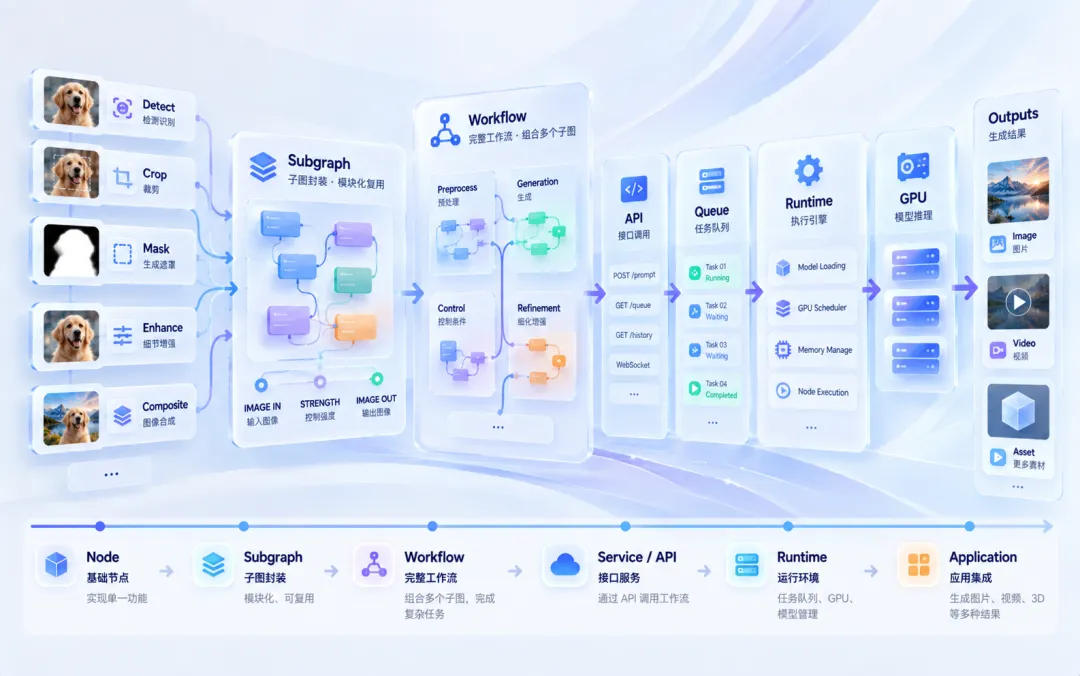
如果一直停留在拖节点,其实还没有看到 ComfyUI 更有意思的一面。 Workflow 可以转换成 API 使用的 Graph,由外部程序直接提交给 ComfyUI Server 执行。 以前的链路是 Human → Canvas → Workflow → GPU, 现在可以变成 Application → API → Workflow → GPU。 这意味着你完全可以把 ComfyUI 藏在产品背后。 例如做一个产品摄影应用,用户只看到“上传商品图”“选择风格”“生成”几个按钮,后台实际执行的却可能是一条包含背景处理、参考图、ControlNet、FLUX、Inpainting、Upscale 的复杂 Workflow。 最终用户甚至不需要知道 ComfyUI 存在。 到了这一阶段,ComfyUI 的角色已经开始从图片生成工具转变成AI Workflow Engine。 到这里,再把 ComfyUI 理解成一个“Stable Diffusion 节点 UI”,已经明显不够了。更准确一点,它已经接近: Visual Workflow + Model Runtime + GPU Job Engine。
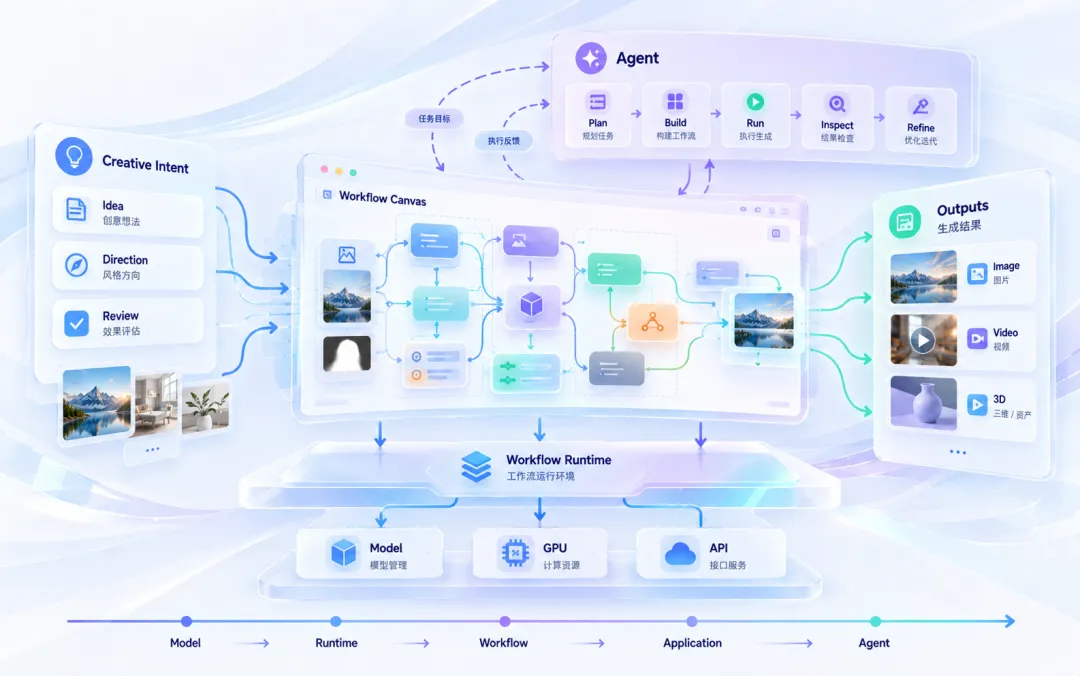
现在 Comfy MCP 已经可以让外部 Agent 搜索模型和节点、构建 Workflow、提交任务并获取生成结果;Comfy Agent 也开始直接进入 ComfyUI,让用户通过自然语言描述创作目标,由 Agent 帮忙搭建、修改和运行 Workflow。 如果前面的推理链路已经真正掌握,再来看 Agent,感觉会完全不同。你会发现它真正接管的并不是“生成图片”本身,而是在接管 Workflow 操作:理解目标、选择模型、搭建 Graph、执行任务、观察结果、调整参数,然后继续运行。 ComfyUI 真正值得学的,不是那些节点 如果只是偶尔生成几张图,完全没必要把 ComfyUI 学得这么深。下载一套成熟 Workflow,把问题解决掉就够了。 但如果准备长期使用,或者以后想把它用于自动化、产品开发、生成式 AI 应用甚至 Agent 系统,学习目标最好从一开始就换掉。 再往后,是一个复杂 Workflow 怎样拆成模块,怎样通过 API 交给其他应用,怎样作为 Server 长期运行,以及最终怎样让 Agent 自己去构建、执行和维护它。 把这些问题串起来以后,会发现前面那条看起来很长的学习路线,其实一直在做同一件事: 从 Model 到 Runtime,从 Runtime 到 Workflow,从 Workflow 到 Application,最后再到 Agent。
01|先把一张图是怎么生成的弄明白
02|Latent、VAE 和 Sampler,是最值得花时间的一关
03|LoRA 和 ControlNet:从生成,进入可控生成
04|图生图和 Inpainting,会重新理解“AI 修图”
05|到了 FLUX,要放弃“一个 Checkpoint 就是一个模型”的习惯
06|Custom Nodes 和 Subgraph,是从使用工作流走向设计工作流
07|学到 API,就应该暂时离开 Canvas
08|最后再学 MCP 和 Agent