ARTICLE · 1115840
AI 主播终于"不像 AI"了:Vidu S2 凭什么让 2 万人狂刷礼物?
这个中秋节,一个 AI 主播火了;而这个国庆假期,她还在继续播。
开播不到 5 分钟,2 万人涌进直播间。紫樱——一个虚拟的"傲娇御姐"——在 5 个小时里靠观众真金白银的打赏,给自己挣到了过万的营业额。假期你在景区排队的三小时里,她一秒都没下播。
而让这件事真正值得被记住的,不是又一个"AI 又爆了"的标题,而是:这场直播第一次证明了,AI 视频生成已经走出了"内容工具"的范畴,开始变成一种新的"交互界面"。
一、直播间,是 AI 视频最残酷的考场
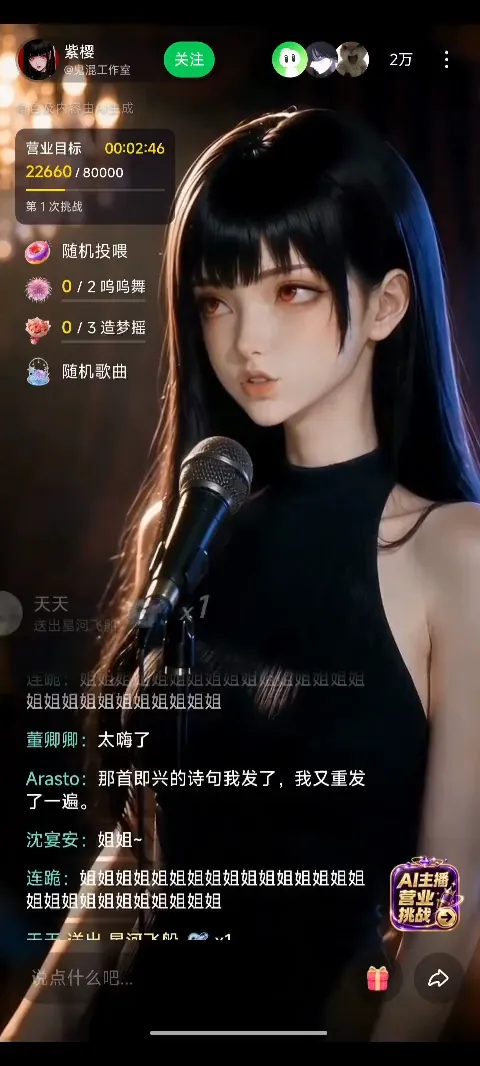
中秋之夜,紫樱的首场直播——"无限营业,不完成业绩不下播"。
如果你是做 AI 视频的同行,对"画面崩坏"四个字应该不陌生——人物动两下就变形,光影乱跳,五官飘移。这件事在短视频里可以靠剪辑掩盖,在电影里可以用后期擦除,但在直播里没法藏。
直播是所有内容形态里最不容错的:观众的弹幕在飞,礼物在跳,每一秒都有新输入;每一个不够自然的停顿都会被截图,每一句答非所问都会被挂在评论区。
之前的 AI 数字人主播普遍是这样的——
• 眼神空洞,"AI 看着像人但其实不知道你在说什么"
• 对话延迟 3 秒,刚要接话弹幕已经飘过去了
• 聊两句就尴尬得让观众"脚趾抠出三室一厅"
• 换装、动作全靠预设脚本库,毫无现场感
而紫樱在这场直播里做了什么?
"你可是今天第一个有专属称呼的人,姐姐可是忘不了的。"
"安安宝宝,叫你小甜糕怎么样?又甜又可爱。"
被打断之后能接回上一段。被投喂礼物之后会说"不要再刷了,上班那么辛苦,对自己好一点"。能热舞,能唱歌,能根据弹幕点歌,能换装,能在被惩罚 KPI 不达标时接受"重置记忆"然后再来一轮——然后越挣越多。
这不是脚本。这是几百毫秒内实时算出来的画面,是当场发生的反应。
紫樱背后的模型,是生数科技 9 月中旬刚发布的实时交互与编辑模型 Vidu S2。
二、撕开"活人感"的底牌:S2 到底突破了哪三件事
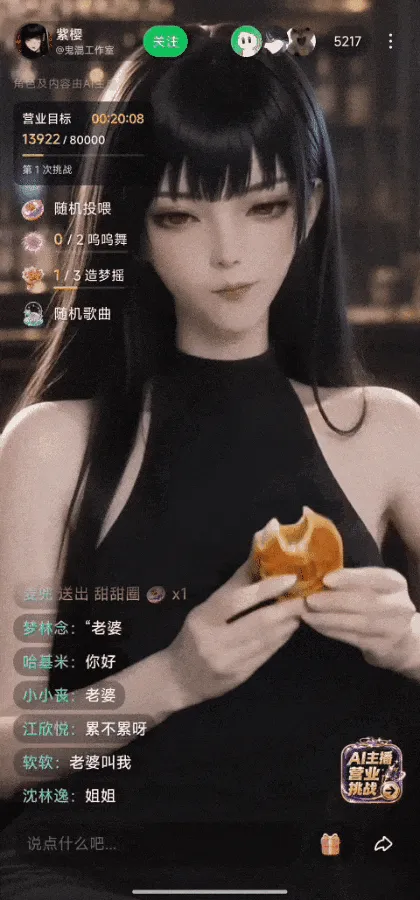
🎬 看直播首秀原片(33 秒):🎬 ./images/AI主播_ViduS2_凭什么让2万人狂刷礼物/直播首秀原片_4MB.mp4
<!--MPVIDEO_RIsTCddsxT_OYLZ64JNuu6HyURUD4vnySGm7_sQtFEKTq1cGeRi6t8obKuObp64k-->
直播间实时弹幕——画面左上角"角色及内容由 AI 生成"的强制标识清晰可见,这是 2026-02-01 施行的《直播电商监督管理办法》第 37 条要求的合规底线。(图源:鬼混工作室 / 紫樱直播首秀)
很多读者会问:不就是把视频生成做得更"真"吗?之前那些厂商也在做啊,凭什么这次能撑住直播这种最严苛的场景?
答案是:Vidu S2 不是某一个单点的算法突破,而是"长时一致性 + 实时生成 + 情境理解"这三件事首次在真实直播压力下同时跑通。
这件事的难度被严重低估了。
下面我用大白话拆开讲。
2.1 一致性:动两下不"崩"
传统 AI 视频生成的"画面崩坏",本质是一个长时一致性问题——
模型在生成第 1 帧的时候很稳,到第 50 帧就开始漂,到第 200 帧人物可能已经"换了个人"。原因不是算法不够强,而是模型在长时生成中没有"自我纠错的记忆":它不知道自己 0.5 秒前生成过什么,也没法拿那个信息修正自己当前的判断。
Vidu S2 的关键突破之一是 SRF(Self-Replay Forcing)训练技术——团队独创了一种训练范式,让模型在训练过程中直面自己的生成历史,把"自己刚刚生成的帧"当作上下文来预测后续帧。
用人话说就是:模型学会了"回头看自己刚才画了什么",并且基于这个"自我审视"修正下一帧的输出。
这件事听起来简单,但工程上极难。因为它意味着训练时模型的输入分布和推理时高度一致——你不是在用"干净数据"训练一个"理想情况下的模型",而是在训练一个"能容忍自己失误并自我修复的模型"。
效果是什么?紫樱无论怎么换装、跳舞、被网友"捏脸摸头",五官、物理结构、光影都稳定得可怕。这不是"结果看起来一致",而是把一致性当成了训练、数据、架构、推理、评测五个层面共同约束出来的系统属性。
值得一提的是,SRF 这项工作的论文已经被 ICLR 2026 接收——这是机器学习领域的顶级会议之一,说明学术圈认可了这件事的理论价值。
2.2 实时生成:每一秒都是当场算的
如果说一致性解决的是"画得稳",实时生成解决的就是"画得快"。
传统 AI 视频生成是这种节奏——你输入一段 prompt,它渲染半天,给你一段死视频。这种模式在短视频时代勉强能用,但在直播里完全失效——观众没有耐心等 30 秒看你生成一个动作。
Vidu S2 的实时生成,依赖的是 Backbone-Refiner 两阶段架构:
•Backbone(主干网络):低延迟推流,先把画面"大概长什么样"快速算出来,输出到屏幕上
•Refiner(精炼网络):异步在后台工作,把 720P 的高清细节补全
这种"先粗后精"的设计很像电影行业的工作流——先拍个大概,再做后期。但对 AI 来说,难点在于怎么让两阶段的输出在时间和空间上严丝合缝地衔接。
配套的底层优化包括:
•帧对齐稀疏注意力——只计算相邻帧之间的关系而不是全帧关系,节省算力
•高效注意力 + 低比特线性层加速——把矩阵运算压到极限
•Kernel 融合与启动优化——减少 GPU 调度开销
•多 GPU 并行——大模型并行推理
效果是:直播间的每一次反应,几百毫秒内就能算出来,输出分辨率从 540P 升到 720P。
2.3 情境理解:能接住现场的所有意外
最后,也是最"玄"的一项——情境理解。
紫樱不只是反应快、长得稳,更重要的是她"懂"你在说什么。
网友的梗、刁钻的问题、突发的情绪,S2 能瞬间接住,并通过紫樱的表情和声音反馈出来。
这背后是大量工程优化的结果:
•语音驱动:实时识别弹幕和语音输入
•动作库调度:根据语义动态选择合适的肢体动作(不只是口播)
•参考图动态插入:观众可以中途抛出一张图要求换装、换场景、换背景,S2 会基于这张新参考图继续生成
•VLM Agent 协调:基于视觉语言模型统一调度临时加入的参考图与角色
数据上更有说服力——在三个公开评测基准上,S2 都是第一名:
| 2.985 | |||
| 0.353 | |||
| 4.00 | |||
| 3.98 | |||
| 71.4%–100% |
这些数字翻译成大白话就是:S2 是目前唯一一个能在"实时生成"这个赛道里把"听懂人话"这件事做得足够好的模型。
三、从直播到三个新场景:实时互动正在变成下一代"交互界面"
如果你以为紫樱的成功只是"世界上又多了一个能赚钱的 AI 主播",那格局就太小了。
这件事真正的意义在于:当 AI 视频能够实时生成、实时互动、且保持高度一致性的时候,我们熟知的世界开始被改写。
下面三个场景,是接下来 1–2 年最确定会发生变化的领域。
3.1 游戏 NPC:终于不用当"木头人"
现在的开放世界游戏,NPC 全是固定脚本树。
"你好啊勇士。" "今天天气真不错。" "我以前也像你一样冒险,直到膝盖中了一箭。"——《上古卷轴 5》守卫的经典台词,因为重复率太高,2011 年发售之后就变成了全球梗。
玩家闭着眼睛都知道对面是一串死的代码。甚至连输赢的惩罚,都只是走个过场动画。
但实时互动模型会让这件事彻底改变。
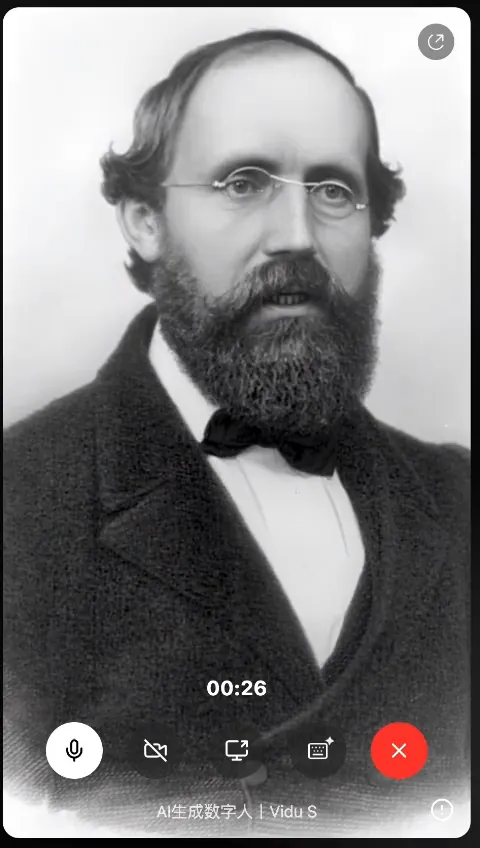
S2 实时生成的黎曼数字人 demo:
想象一下:你在《上古卷轴》里遇到一个守卫,他真的记得你昨天偷了他家的面包;你在《赛博朋克 2077》里跟一个 NPC 讨价还价,他的表情和语气会根据你的态度实时变化;你在独立游戏里遇到一个反派,他会在你打败他之后真的"愤怒"地跟你对话——而不是播一段固定动画。
S2 已经演示了这种能力:你甚至可以让数学家黎曼亲自给你讲什么是黎曼猜想,他的反应是实时的,不是录好的。
3.2 AI 陪伴:补齐"真实感"那块拼图
AI 陪伴产品这两年最大的痛点是什么?
金鱼记忆。
Character.AI 被诟病最多的就是这一点——用户热聊几周后,AI 忽然告诉你"我们刚认识五分钟"。这种"失忆感"会瞬间打破所有的情感连接。
而实时视频互动 + 长期记忆 = 真实的情感连接。
想象一下:你的 AI 伴侣不仅每天跟你聊天,还能跟你实时视频互动,记得你昨晚喝醉时说的胡话——它的喜怒哀乐如此生动,每天重新开始但始终如一。
文章里有一句话我特别喜欢:
"这种'真到能被心疼'的情感连接,将重塑人类的孤独经济。"
是的,"孤独经济"这个词精准得让人害怕。当 AI 主播在直播间被惩罚时,人类开始心疼一串代码——这种情感连接如果被规模化,会改变很多行业的底层逻辑。
3.3 电商与品牌:混合直播 + 跨境场景
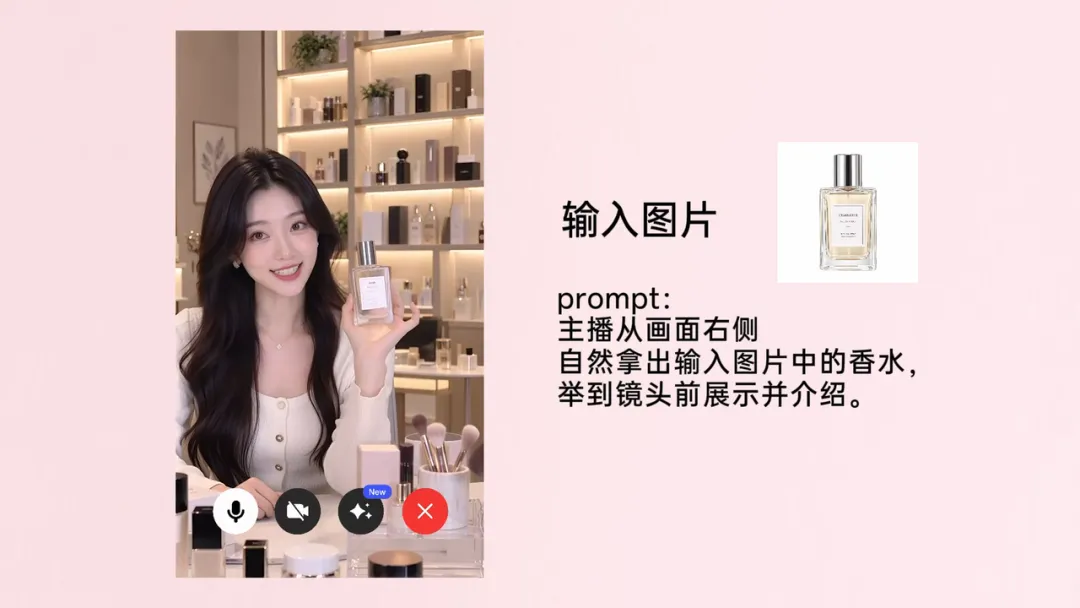
prompt:主播从画面右侧自然拿出输入图片中的香水,举到镜头前展示并介绍——这正是 S2-Avatar 的"动态参考图"能力。
对商家来说,这件事的现实意义更直接——
看看这个国庆假期就知道:你在景区排队、在高速堵车的每一小时,都有一批 AI 主播在直播间里替商家照看着生意。2026 年的主流直播模式已经是"真人 + AI 混合":
• 黄金时段(晚 8 点–11 点):真人主播,建立信任和情感连接
• 非高峰时段(凌晨、清晨):AI 主播承接流量,实现 24 小时不间断
数据上,AI 数字人直播的成本只有真人主播的 10%,京东的 JoyStreamer 自 2025 年 12 月免费开放以来已累计服务商家超 7 万家,2026 年一季度开播量同比激增 10 倍。
而 S2 在电商场景有一个特别实用的能力——动态参考功能。商家可以在直播过程中随时补充参考图(产品图、场景图),S2 会保持连贯的前后关系,让跨境电商"场景化营销 so easy"——气氛拉满,购买欲爆棚。
配合 S2-Editing 的实时换装、换背景、风格迁移,短剧出海、品牌大促都有了全新的玩法。
但这里必须提醒一件事——
⚠️ 2026 年 2 月 1 日起施行的《直播电商监督管理办法》第 37 条明确要求:使用 AI 生成的人物图像、视频从事直播电商活动的,应当"显著、持续"标识其为人工智能生成。
这是中国首部将 AI 数字人主播纳入强制监管的部门规章。流量管控、限制功能、暂停直播、关闭账号都是平台可以动用的工具。
想做 AI 直播的商家,先把合规底线搞清楚。
四、这门技术背后的团队与节奏
最后讲讲团队。
生数科技是清华朱军教授孵化的多模态大模型公司。Vidu S2 的全链路研发负责人是张金涛——朱军教授的博士生、生数科技流式视频生成与推理负责人。
这个团队最让人印象深刻的是节奏感——从 Vidu S1 到 S2 只用了 69 天。
2026 年 9 月 17 日,生数科技同时入选"2026 北京民营企业科技创新百强"和首次发布的"未来产业先锋榜"——是唯一同时入选两项榜单的通用世界模型企业。
如果你想亲手试试 S2:
• 🎮 体验入口:vidu.com/vidu-stream
• 🛠️ API 平台:platform.vidu.com/vidu-stream/doc
• 📄 技术报告:arxiv.org/pdf/2609.11638
五、给读者的三句话总结
•这是工具的代际换班:从"录播套壳"到"实时互动大模型驱动"——AI 数字人直播正式进入 3.0 时代。
•这是内容形态的拐点:短视频能剪,直播不能;这场直播证明了 AI 视频已经走出"内容生成工具"的范畴,开始变成一种新的"交互界面"。
•这是开发者与商家的窗口期:京东 JoyStreamer 7 万商家、TikTok Shop 765 万美元单场案例——但合规底线要先搞清楚,《直播电商监督管理办法》第 37 条是硬约束。
或许在下一个假期里,陪你聊天、听你倾诉的——
就是一个真正懂你的 AI 朋友。