ARTICLE · 1123078
Unsloth 全测:一个软件替代全部本地AI
不但不需要 llama.cpp、Ollama、LM Studio,而且图像、视频、LoRA 一次闭环
做本地 AI 的人,这两年都在补同一块拼图:出图用 ComfyUI,跑模型用 Ollama,微调还得开终端。装三四个软件,配三四套环境,每个项目换模型还要重来一遍。
Unsloth Desktop 想把这几段拼成一个应用。它是一个 Tauri 写的桌面客户端,免费开源,Win / Mac / Linux 全平台,主打一件事——在你自己的显卡上,把图像、视频、文本、语音模型的推理和微调全包圆。
我更关心的只有一件事:图像和视频本地生成,它到底跑得动吗,跑得多快。
下面按官方文档和 v0.1.900-beta 的 release notes拆。
📌 配图 1 · 封面
>
*显卡算力核心向外辐射图像与视频生成能力——本文要拆的就是这套链路*
一、图像:模型全,但不认「一个模型走天下」
支持列表摆在明面上:Qwen-Image-2.1、FLUX、Z-Image、SDXL、MiniMax-H3,还有你自己训的 LoRA。格式上吃 GGUF 和 FP8。
真正做设计的地方在模型选择器。选模型时,每个尺寸旁边会标一个状态:
recommended— 你这台设备跑得动的推荐档 TIGHT— 会借用系统内存,能跑但慢 OOM— 大概率塞不下
这个设计比 ComfyUI 那种「选错 CLIP 然后报形状不匹配」友好太多。新手不会在下载完 20GB 之后才发现自己显存不够。
📌 配图 4 · 三档适配状态
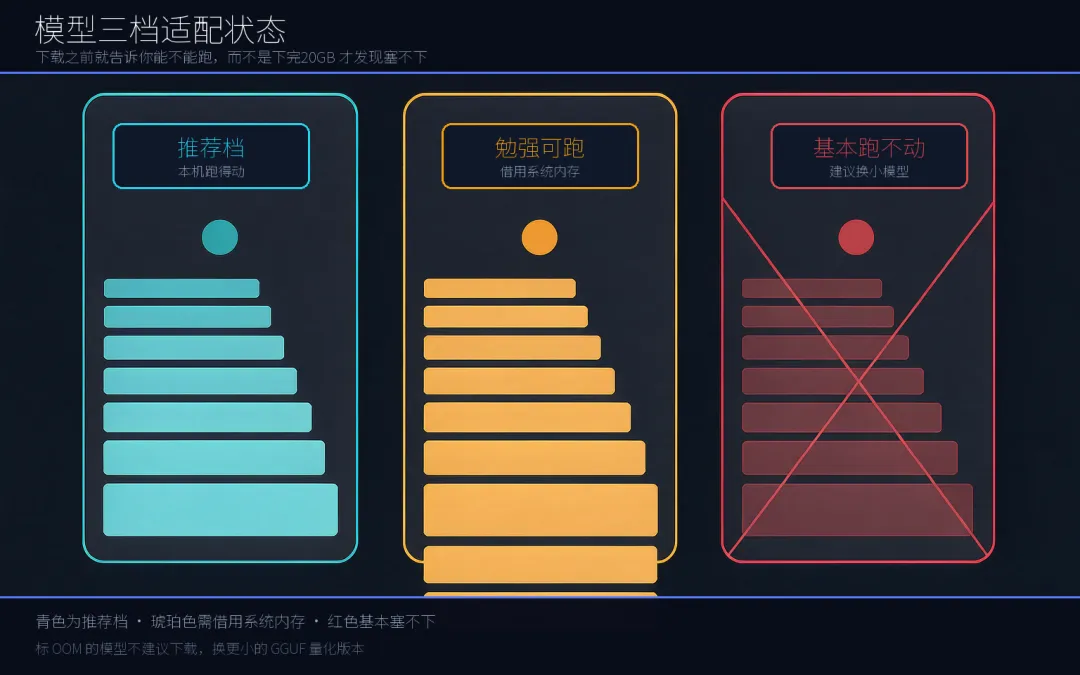
*同一模型的三个量化档位:青色框是推荐档,琥珀框的条块溢出容器表示要借用系统内存,红色框被划掉表示塞不下。这个设计把「能不能跑」提前到下载之前就告诉你*
📌 配图 2 · 七条图像工作流
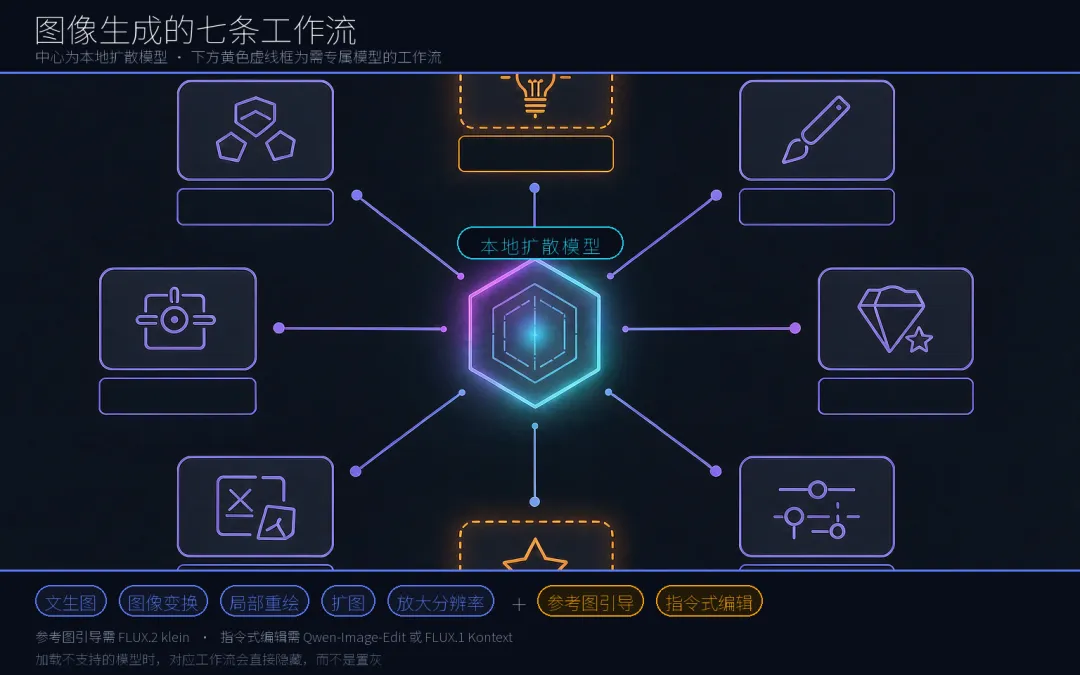
*中心是本地扩散模型,周围七个工作流节点。注意两个虚线框节点——Reference 与 Edit 需要专属模型才能激活*
七条工作流,能力边界划得很清楚:
| Create | ||
| Transform | ||
| Inpaint | ||
| Extend | ||
| Upscale | ||
| Reference | FLUX.2 klein | |
| Edit | Qwen-Image-Edit 或 FLUX.1 Kontext |
注意最后两行。Reference 和 Edit 有专属模型要求,加载了不支持的模型,这两个工作流会直接消失,不是灰掉,是不显示。文档里反复强调这一点,说明这是最容易踩的坑。
另外,LoRA 和 ControlNet 都能加载,权重和强度可调。ComfyUI 老手看到这几个词应该很亲切——概念完全一致,只是这里写在 GUI 里。
二、视频:13 秒是真的,但你要知道它是怎么来的
官方给的性能数字只有一条:
在 NVIDIA B200 上,MiniMax-H3 FP8 生成 960×544、124 帧、8 步的视频,从 70 多秒降到 13 秒。
拆一下这个数字:960×544 是偏低分辨率,124 帧大约 5 秒,8 步是蒸馏模型的激进配置,B200 是数据中心卡。四个条件缺一个,这个数字都不成立。
📌 配图 3 · 速度反差
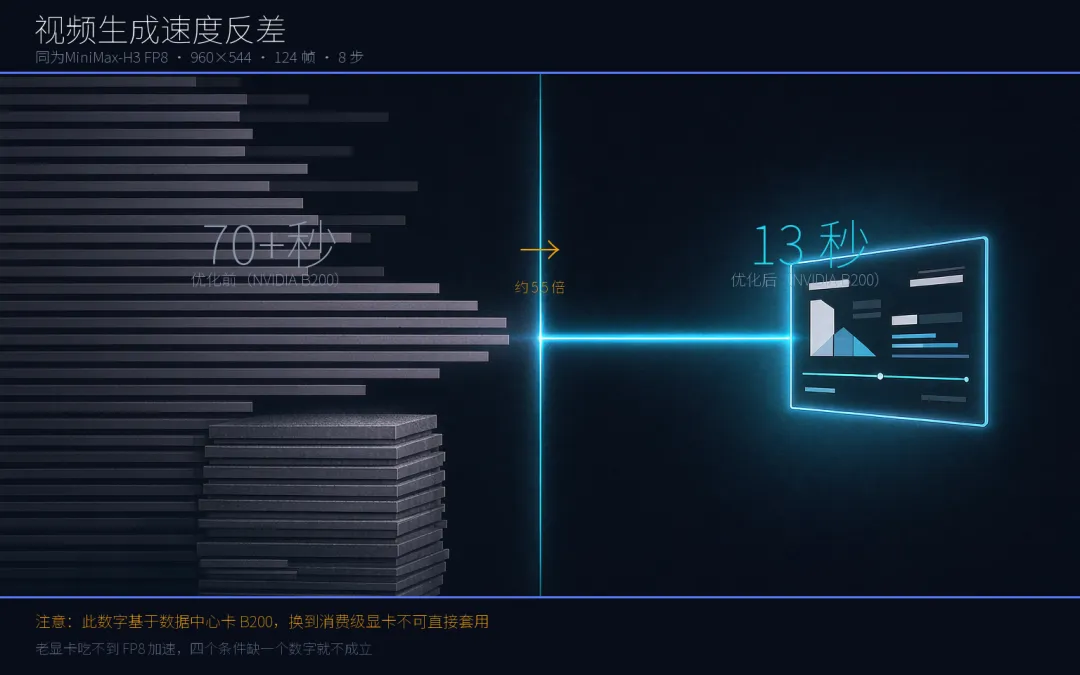
*左边是优化前:流线粗重、密集堆积、缓慢拖拽;右边是优化后:一束锐利的青光,通透干净。「快了很多」这件事不需要数字也能一眼看出*
不过 v0.1.900-beta(2026-09-28)这版的提升是实打实的,来源是三项优化:
| 1.7× ~ 6.3× | |
4.5 倍的来源写得很诚实:蒸馏采样、编译层修复、以及宿主提供的 FP8 权重。
⚠️ 这里有个硬门槛:最后这条明确要求你的环境能处理 FP8。 老显卡吃不到这个加速,甚至可能因为格式不匹配走别的路径。release notes 没写清楚具体要求——遇到速度上不去,先查精度选项。
视频模型目前是 Wan 和 LTX 两个系列。LTX-2.3 的 GGUF 分两套:dev 版至少 20 步出好效果,distilled 版 4-8 步就够。官方推荐的工作流是 distilled 版当草稿模型出初稿,再叠 distilled LoRA 精修——这是个很典型的两段式加速思路。
📌 配图 8 · 两段式管线
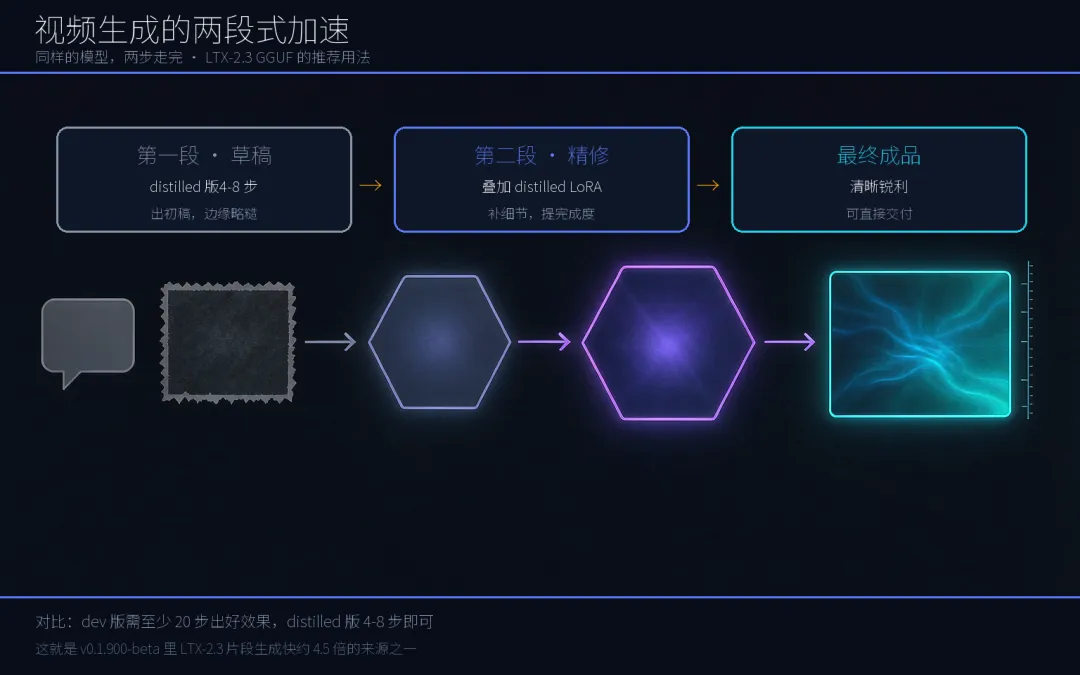
*左边灰色锯齿框是 distilled 版出的粗剪初稿,经过第一段处理后进入更大更亮的精修节点,右边青色通透框是最终成品。同样的模型,两步走完*
三、LoRA:训完不用离开这个界面
这是 Unsloth 和其他本地工具拉开差距的地方。
支持训练的对象:LLM、扩散模型、TTS、Embedding 模型。类型覆盖 LoRA、全参微调、预训练。扩散这边可以训 SDXL、FLUX.2、Qwen-Image、Z-Image 的 LoRA。
流程很短:在 Unsloth 里给图片打标 → 选 rank → 点 train → 导出 → 回到推理界面直接加载用。
📌 配图 5 · LoRA 训练闭环
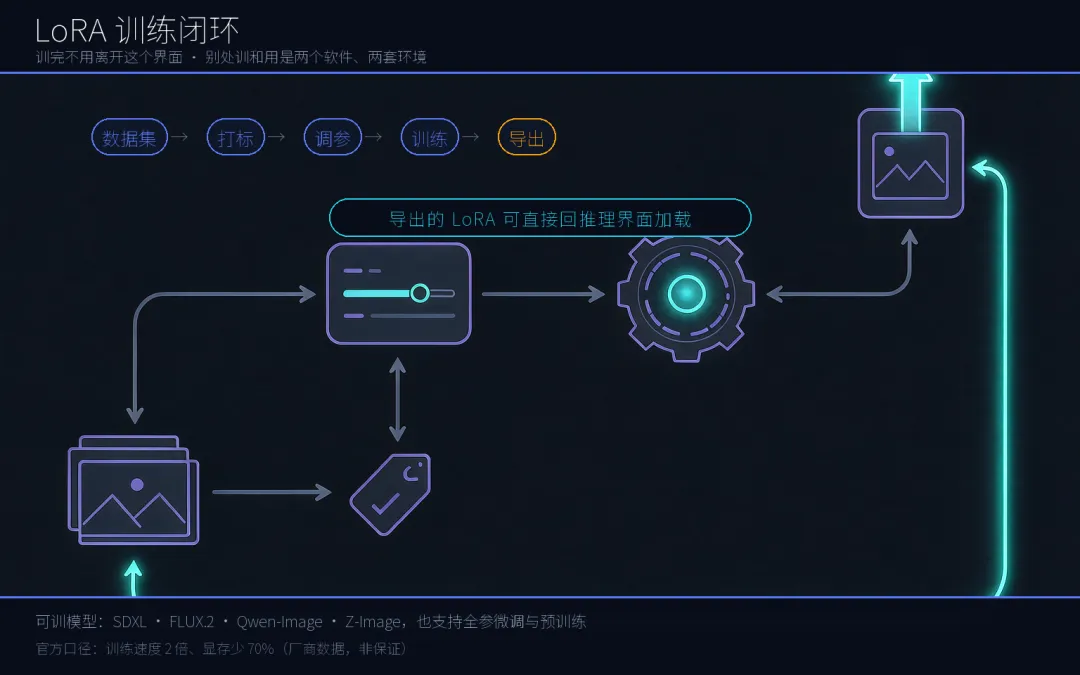
*数据集 → 打标 → 调参 → 训练 → 导出,最后那条青色高亮连线把结果送回起点。这就是「训完不用离开这个界面」的含义——别的地方,训和用是两个软件、两套环境、两个版本号*
官方数据是「2 倍训练速度、显存少 70%、精度无损」。这是厂商口径,在支持的 LLM 负载上成立,别当保证看。
但那个「训完回同一界面」的闭环是真的。在别的地方,训模型和用模型往往是两个软件、两套环境、两个版本号。光这一条就够让调参党省下不少时间。
四、硬件账:这几个坑得先知道
文档里关于硬件的表述比宣传页诚实得多,这里挑几条关键的:
1. 官方支持面广,但速度数据都是 B200 的
支持 NVIDIA、Intel、AMD、Mac 的 GPU 和 CPU,纯 CPU 也能跑。但 CPU 支持目前主要覆盖 Chat 和 Data Recipes,训练和推理能力因模型和硬件而异。「能启动」和「能用」是两件事。
2. OOM 就老老实实降规格
显存不够时官方给的顺序是:换更小的 GGUF 量化或 4-bit 版本 → 降分辨率 → batch size 保持 1 → 关掉其他占显存的程序 → 换小模型。
那几个高级选项就是为这种情况准备的:Low VRAM 模式、CPU offload(把模型部分挪到系统内存,会变慢)、Step cache(复用步间计算加速)。CPU offload 是典型的「不OOM 但变慢」的交易,卡在 8GB 显存想跑大模型的人应该懂这个取舍。
📌 配图 6 · 降规格四级台阶
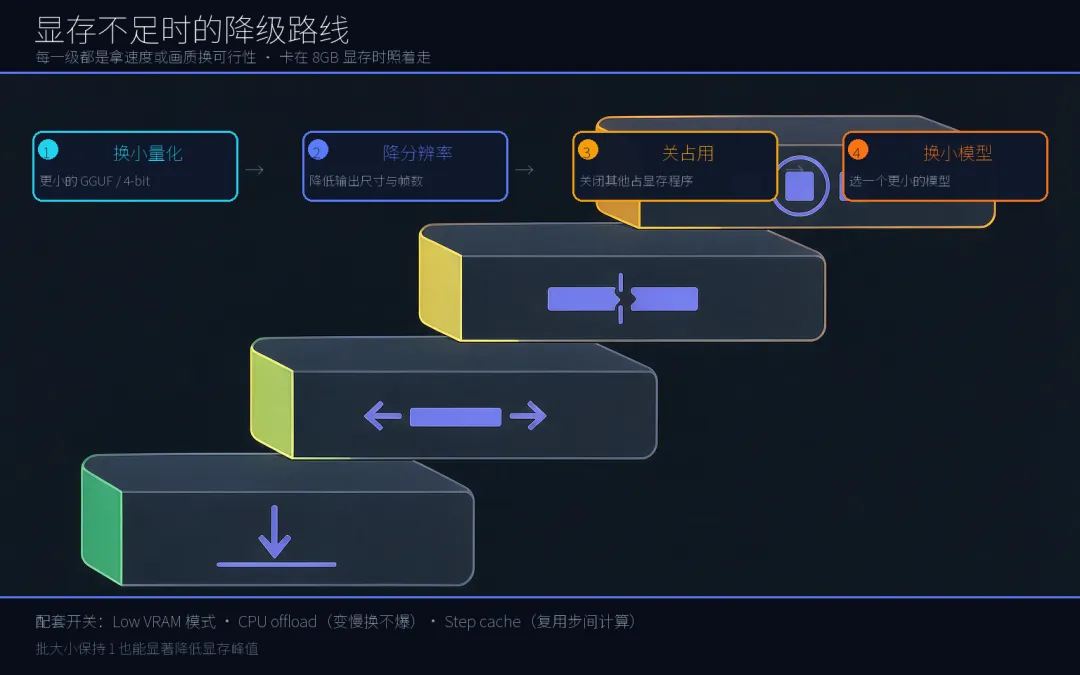
*四级台阶,从下降到换模型。前缘颜色从绿到琥珀,代价逐级升高——每往上走一级,都是拿速度或画质换可行性。卡在 8GB 显存时,这张图就是你的路线图*
3. beta 就是 beta
当前还是 Beta 阶段,文档里那句「如果推理有时变慢,开个 GitHub issue」很实在。另外 web search、Python、终端执行这些服务端工具默认以当前用户权限运行——官方自己会警告,拿到 API key 的人都能在这台机器上跑代码。默认装本机 localhost 用最安全,别顺手 -H 0.0.0.0 暴露到公网。
📌 配图 7 · 暴露边界
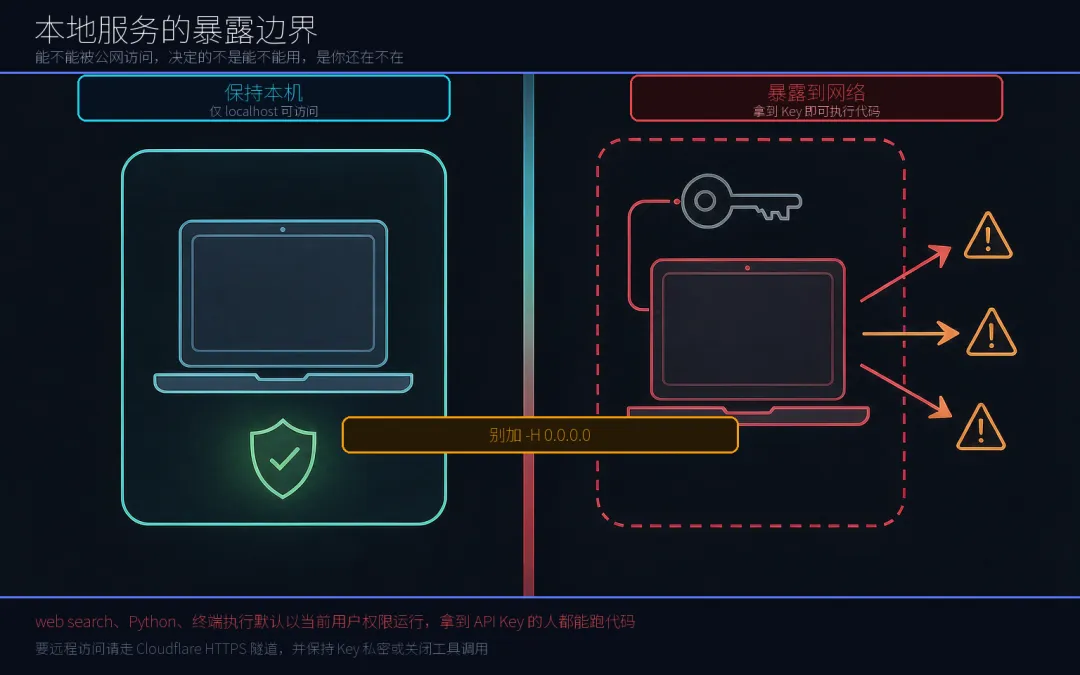
*左边是本机localhost:封闭实线框加盾牌。右边是暴露到网络:虚线框、钥匙、三条外发箭头配警示三角。「能不能被公网访问」决定的不是能不能用,是你还在不在*
4. 国内网络
v0.1.900-beta 加了 ModelScope 下载支持,访问不了 Hugging Face 的朋友有救了。另外部分模型需要先在 HF 上接受许可并填 HF token 才能下载——这是新手最常见的「下不动」原因。
5. 加速首次编译
Speed 选项打开编译优化后,第一次生成会明显更慢。别在第一次卡住就以为装坏了。
五、结论:谁该装,谁别装
该装:
已经在本地折腾 ComfyUI,想少切几个软件的人 需要训自己风格 LoRA 的创作者(闭环是真价值) 有独立显卡、愿意下几十 GB 模型的人 对数据不出本机有硬要求的人(无遥测,可完全离线)
先别装:
只有核显或 4GB 显存以下——图像勉强,视频基本不用想 追求「装完即用、一键出大片」——这仍然需要你懂模型和参数 显卡太老吃不到 FP8——那 4.5 倍和你没关系
一句话:Unsloth Desktop 的价值不是「又一个出图工具」,而是把生成、训练、部署收进同一个本地工作台。但它宣传的那些速度数字,全部建立在 B200 + FP8 上——你的显卡能吃到几成,是完全不同的问题。
它的宣传页不会告诉你这个。文档会。
你们现在本地生成主要用什么?ComfyUI 还是别的?评论区报一下显卡型号和显存,我看看有多少人能跑视频。
推荐标签
#Unsloth #UnslothDesktop #本地AI #AI绘画 #AI视频生成 #ComfyUI #开源工具 #本地部署 #GPU #AIGC