ARTICLE · 1123093
这个GitHub项目,让AI用代码做动效视频,不用任何软件和素材
做视频一定要会剪辑软件?
他 3 天做了 10 条动效视频
一分钱工具都没买
10% 靠提示词 · 90% 靠流程
提示词占一成,流程占九成
📦 7 Parts + Conclusion
👉 滑动
PART 01
一句大实话
10% 与 90%
PART 02
它不画视频
只写程序
PART 03
先出 4 张图
最值钱的一步
PART 04
看着高级
叠帧与弹簧
PART 05
时间账
1 秒等 1 分半
PART 06
声音
别信自动节拍
PART 07
自己考自己
每项 8 分
PART ///
写在最后
210 颗星
提示词占一成,提示词外面那套流程占九成
前几天刷到一篇长文,27 万浏览。
一个老外,用 Opus 5.5,3 天做了 10 多条动效视频。不是剪的,是写代码写出来的。没有 After Effects,没有 Remotion 授权,没有剪辑软件。做完之后,他把整套做法连代码带文档全部开源了。
我盯着屏幕看了半天,心情有点复杂。
7 月我用 Codex 加 HyperFrames 批量做过一批视频,当时觉得自己已经挺会了。看完这篇才发现,我卡在一个特别蠢的地方:我都是整条做完,才发现问题,然后从头再来一遍。
他不一样。每做一个镜头,先生成 4 张静态图,看完、改完,才开始渲染。就这一个顺序差别,我 7 月那几个晚上本来能省下来。
01
PART
他说了句大实话:提示词只占 10%
PROMPT 10% · HARNESS 90%
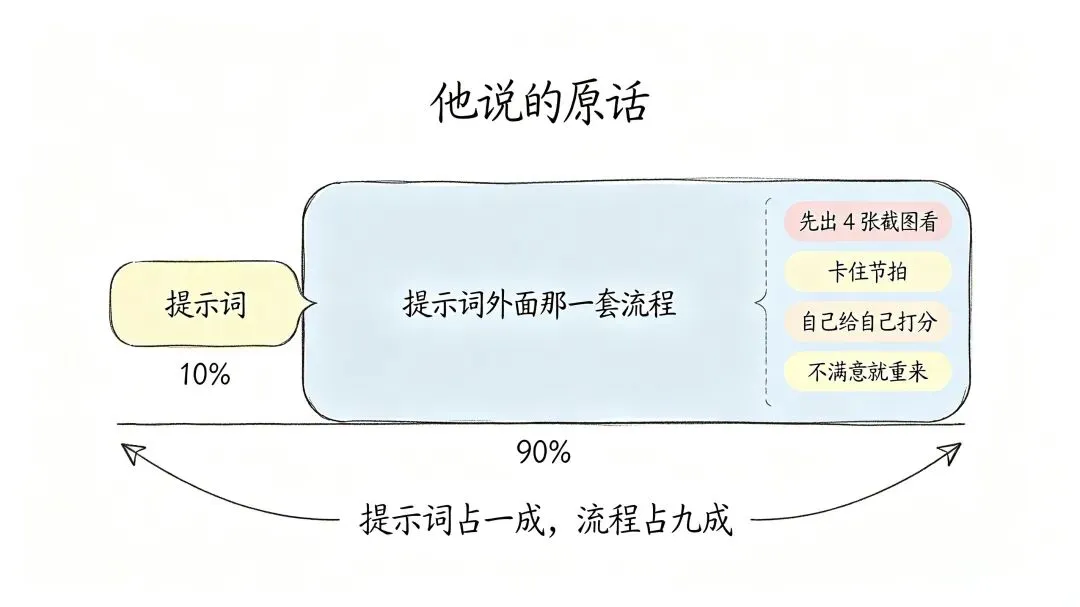
「The prompt is 10 %, the harness is 90 %.」
出自仓库内 motion-design 技能的说明文档,注明来源为 Opus 5.5 使用手册,日期 2026-10-02
翻译过来就是:提示词占一成,提示词外面那套流程占九成。
网上那种「一句话出片」,他说只对了一半。有的第一遍确实能用,但那是运气。他自己产品的宣传片,改了 5 次才交付。这句话写在仓库 README 里,原话是「用 Opus 5.5 加上这个技能,一共做了 5 个版本」,成片 24 秒 60 帧。
这句话我读了三遍。因为我一直以为,做不出来是因为提示词写得不够好。
02
PART
他到底怎么「用 Opus 做视频」?
HTML + PLAYWRIGHT + FFMPEG
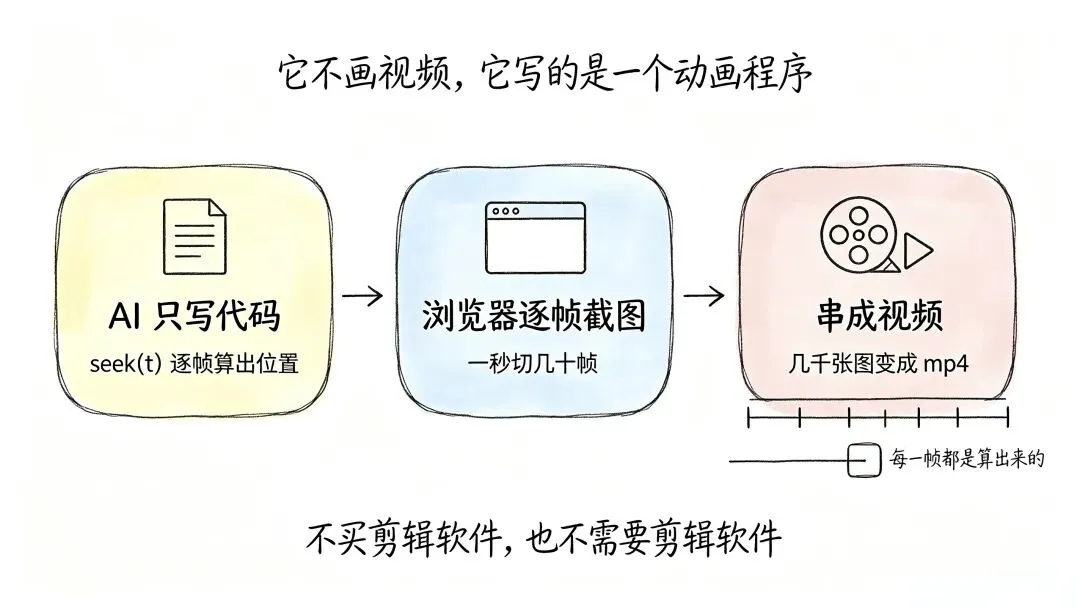
先说清楚,不然容易误会:Opus 不会画视频。
它从头到尾只干一件事:写字。写 HTML,写一个 JavaScript 里的 seek(t) 函数,每一帧调一次,算出这一帧画面上所有东西的位置。
然后另一个人干活:Playwright 打开 Chromium,把 seek(t) 切成逐帧截图,ffmpeg 再把这几千张图串成 mp4。仓库 README 第一句话把这件事说得很明白:
HTML + Playwright + ffmpeg. No After Effects, no Remotion license, no editing app.
所以本质上,这不是「AI 生成视频」,而是AI 写了一个确定性动画程序。
这里有个细节我认为是全篇最值钱的:seek(t) 必须没有状态。不能有 CSS transition,不能有 setTimeout,不能用一个变量记住「上一帧在哪」。因为渲染可以并行、也可以只重渲某几秒。一旦动画依赖「上一帧是什么」,重渲的结果就和原来对不上了。
他文档里写得很死:同一秒渲染两次,必须产出完全一样的帧。所以他连随机数都不用 Math.random,改用固定种子。
这一条决定整条路走不走得通。有状态就不能并行;不能并行,50 秒的片子就得排队等一小时。
03
PART
顺序,比技术值钱
FOUR STEPS · NO SKIPPING
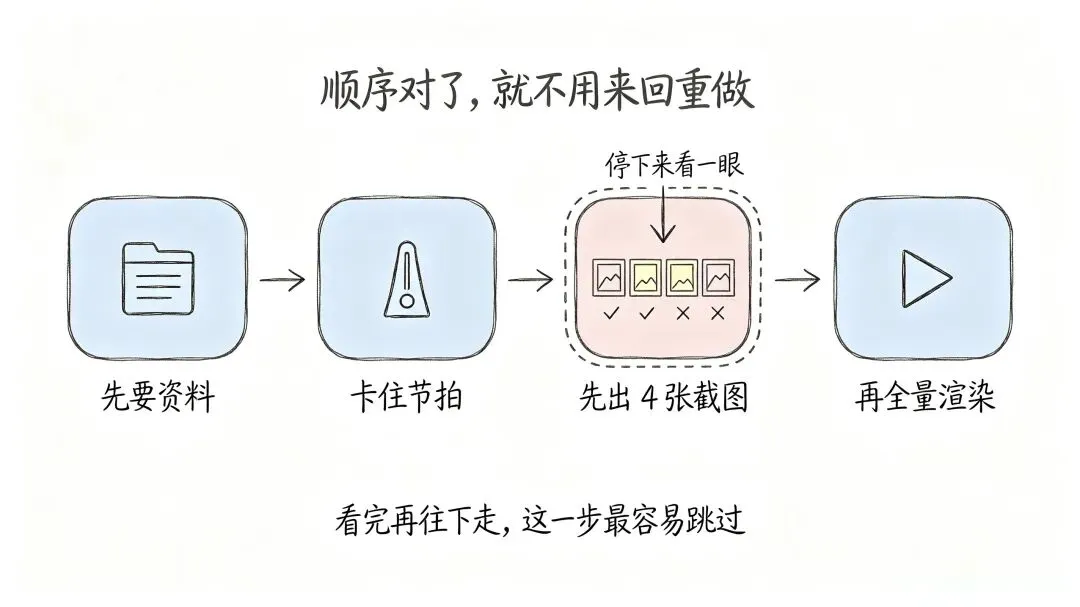
这是我最想抄的部分。他的流程是固定顺序,一步都不许跳:
它规定的顺序
01 · Inputs 问你要品牌资料、logo、色板、截图、真实数字。没有 facts.md 就不许出现任何数据,每条数字都要带来源和日期。
02 · Beat map 算出 BPM 和拍长,每个镜头卡在拍上。音乐高潮必须落在关键画面上,且不能有超过 1 秒的静止。
03 · 4 张静态图 先出 4 张定妆照,自己看一眼,改完,才允许全量渲染。这一步就是我 7 月一直跳过的。
04 · 渲染与交付 正式渲染、检测异常闪帧、配音效、合流、打开文件看。交付时附真实说明,不吹。
第 3 步的分量,他放了一句很重的话:
「4 stills (or a one-frame-per-beat sheet) → look at them (Read) → fix → only then the full render.」
我 7 月的做法正好相反:直接全量渲染,渲完再看,发现构图不对、字太小、颜色不对,改一行,重渲一遍。而他每一步都有明确关卡,不过关就不往下走。
这里可以直接抄走的对话模板
想试的话,这段可以直接复制给 AI:
这个视频一共 24 秒,先别渲染。
按这个顺序做:
1. 先写 BEATMAP.md:算出 BPM 和每拍时长,把每个镜头排在拍点上,
音乐高潮必须落在最关键的那个画面上。不许有超过 1 秒的静止画面。
2. 然后只生成 4 张静态图(STILL_01.png 到 STILL_04.png),
覆盖:开场、中间转折、核心演示、结尾 logo。
3. 生成完停下来,什么都别做,等我回复。
我确认这 4 张之后,你再写 seek(t) 引擎和全量渲染。
注意最后那句「等我回复」。这个卡点就是省时间的全部秘密。
04
PART
怎么让动效看起来「高级」,而不是一眼 AI
ANTI-AI MOTION RULES
他文档里有一整节叫「反 AI 动效规则」,挑三条最实用的。
第一,一个画面同一时间只动一样东西
原话是 one thing moves at a time。听着简单,但回想一下那些一眼假的 AI 视频,基本都是所有元素一起飞进来。
第二,弹簧要有阻尼,不能弹成卡通
他规定弹簧的阻尼比 ≥ 0.72,只允许一点点过冲,而且明确禁止「卡通式回弹」。速度预设也分档:UI 按钮这类用 320/30,普通容器和镜头用 170/26,重字和大 logo 用 120/24。
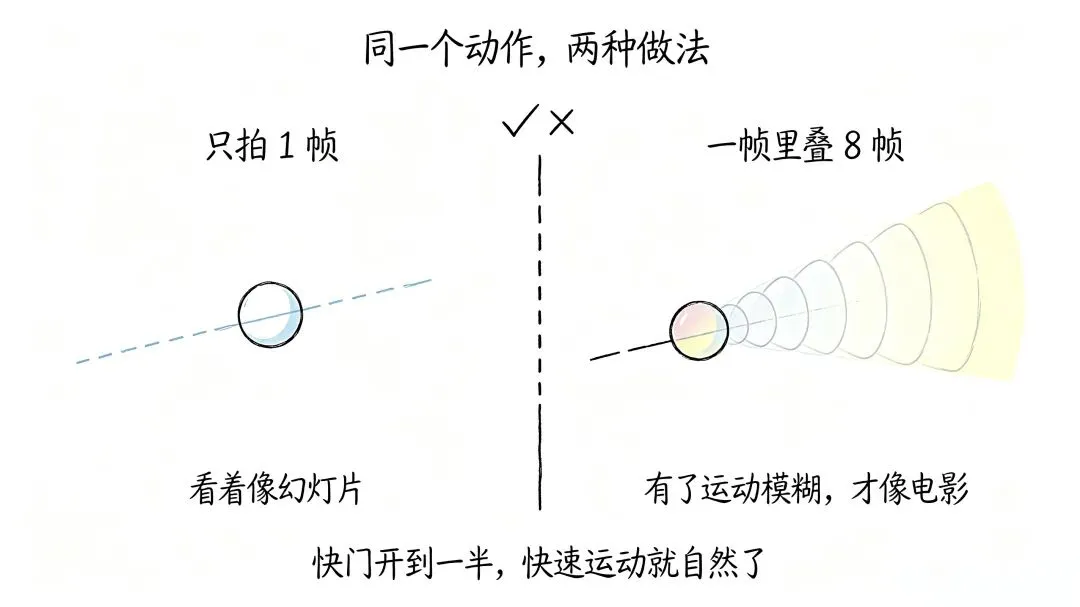
第三,运动模糊不是靠软件加的,是「叠帧」叠出来的
这一条我之前完全没想到。他让 Playwright 在一帧的时间里拍好几个子帧,再用 tmix 混在一起:快速运动用 6 到 8 个子帧,慢的用 4 个。快门角度按 180° 走(代码里是 SHUTTER = 0.5)。
你 8 张画面叠在一起,就是电影感;叠 1 张,就是 PPT。
默片一句话测试
把做好的循环静音放给别人看,如果他一句话能概括(「按钮变成了播放器」),就成了;如果他犹豫,就是动得太多了。
05
PART
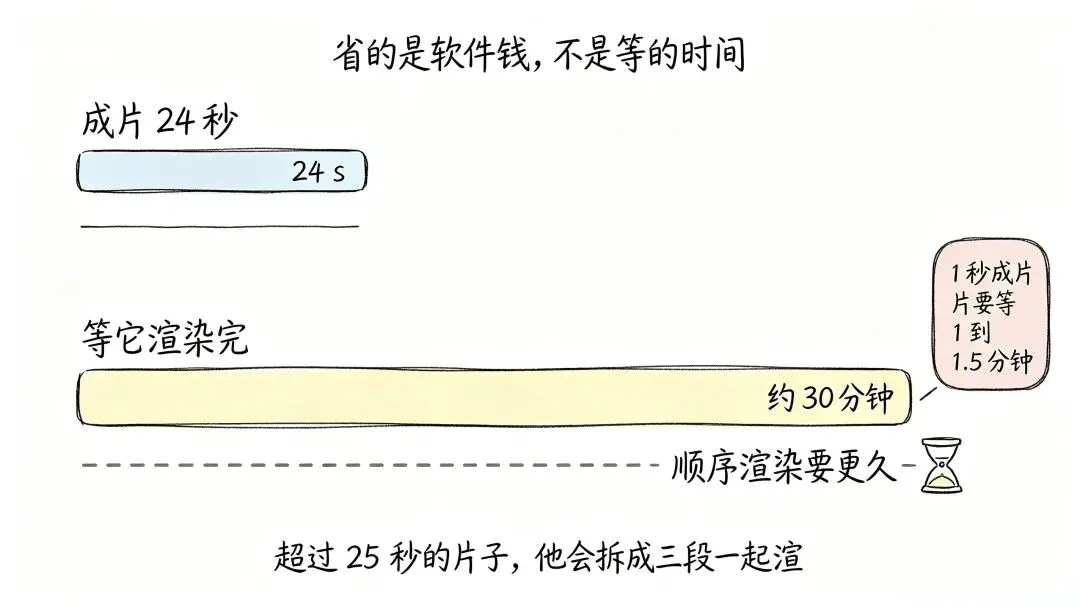
成本:1 秒成片,要等 1 到 1.5 分钟
WALL TIME · RENDER BUDGET
这部分必须说实话,不然容易误导人。
他文档里写得很清楚:8 个子帧的设置下,1 秒成片大约需要 1 到 1.5 分钟的实际等待时间。也就是一条 24 秒的片子,渲染要 25 到 35 分钟。超过 25 秒的片子,他会强制拆成 3 段并行渲染:55 秒的片子并行约 20 分钟,顺序跑要约 55 分钟。
再叠上他自己那个「5 次迭代」的记录:做一条能交付的片子,实际是一整天的事。
他省下的是买软件的钱,不是力气。这句话他在长文里也说了,我觉得挺诚实。
06
PART
声音:别信自动节拍,用能量自己找
SOUND DESIGN · -14 LUFS
音频这块他踩过坑,写得很细。
他的原话是 never trust an auto grid,意思是别信软件给的自动节拍网格。他自己的例子:某首曲子软件标 119.99 BPM,自动网格算出来的 drop 点偏了整整 2 拍。
正确做法是读音频能量曲线,自己找真正的 drop。音效也一样,他不凭感觉拖时间线,而是按实测峰值来放。音量也压得很保守,0.04 到 0.3 的增益。最后两遍 loudnorm 统一到 -14 LUFS,真峰值不超 -1.3。
音乐和音效全是免费素材:Mixkit 的曲子,或者直接用代码合成。
顺便说个很可爱的细节:他文档的音效库里有个音效叫 bread crunch,编号 118,法棍面包的咔嚓声,用来做某个「脆」的转场。这种音效我 7 月绝对想不到要去用。
说明一下:长文里提到的「软件标错两下」「法棍 4 声咔嚓」这两个具体数字,我在仓库文档里没找到对应记录,属于作者在 X 长文里的叙述,这里按原文保留。
07
PART
让 AI 自己看自己做的片子
SELF CRITIQUE · 7 SCORES
最后一步也是我觉得最妙的。片子渲完,他不自己一帧一帧看完,而是让 AI 自己审。
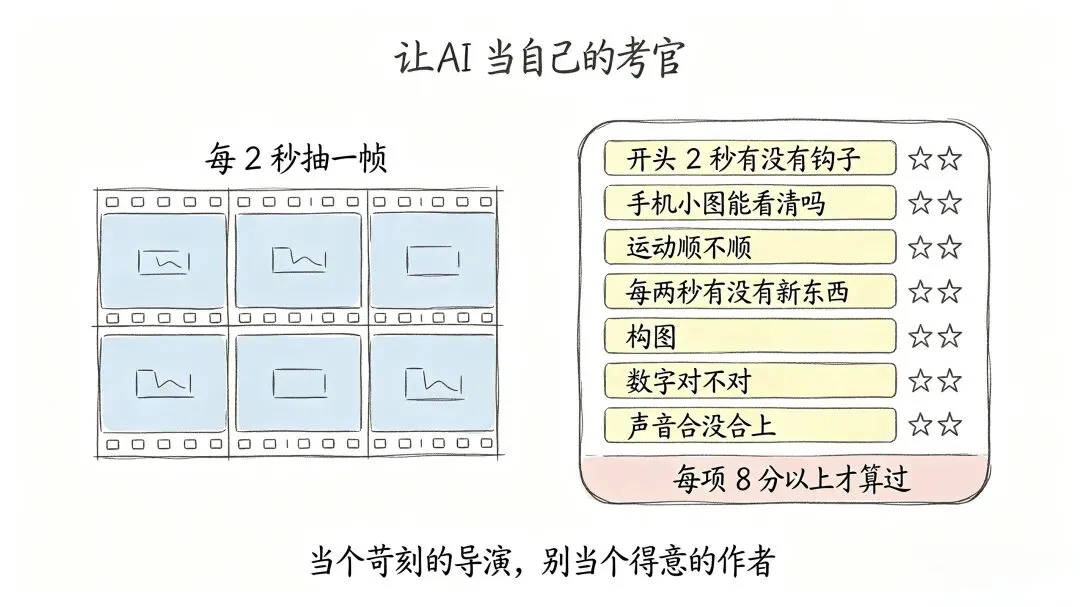
具体做法是把成片抽帧拼成一张 contact sheet(2 秒一帧、缩到 270 像素宽、拼成 6x5 网格),然后让 AI 看图,按 7 项打分:开头 2 秒的钩子、360 像素下的可读性、运动质量、变化节奏、构图、品牌与数据准确性、音画同步。
每项 1 到 10 分,他文档里就一句话:
「Repeat until every score is 8+.」
他还加了一句我特别认同的话:要当个苛刻的导演,别当个得意的作者。
他那张诊断表也值得抄,随手举三个:
他的诊断表(节选)
症状 某段成了「死拍」(画面不动)病因 镜头之间没接上节奏修法 回到 beat map,让每个镜头都有明确落点
症状 快速运动糊成一团病因 子帧给多了,出现鬼影修法 快速运动反而要减子帧,6 到 8 是上限
症状 循环接缝处跳一下病因 只检查了位置,没检查速度修法 首尾帧要同时对齐位置和速度
///
LAST
写在最后
TOOLS DON'T FIX TASTE
我 7 月那批视频,说实话不差。但我是用「做完一整条,再发现问题」的方式做的。
看完这篇最大的收获不是某个技巧,而是那个顺序:先出 4 张图,看一眼,再往下走。
以及那句「提示词 10%,流程 90%」。我们平时最容易被吸引的,是最前面那 10%:那句话怎么写、什么提示词更神。但真正决定成品能不能看的,是后面 90%:卡点、关卡、自检、迭代。
仓库实况 · 截至 2026-10-03
210 ★ · 21 fork · 32 次提交 · Python · MIT 协议
创建于 2026-09-27,最后一次推送 2026-10-02。作者是 Raphaël Aubry,Howseen 创始人。
地址:github.com/howseen-ai/claude-motion-design
它是 Claude Code 的一个 Skill,装法很简单:把 skill/motion-design 复制到 ~/.claude/skills/,再跑 pip install playwright imageio-ffmpeg numpy pillow 和 python -m playwright install chromium。
提醒一件事:仓库文档和长文里的技巧,都是给做产品宣传片准备的。想拿它做剧情、做真人、做口播,不适用。它只会做图表、界面、logo 这类东西的运动。
最后引用一句长文里的话收尾,对他这 3 天是个准确的总结:他省的是买软件的钱,不是省力气。不给样片,照样一眼 AI。
工具不解决审美,只解决重复劳动。剩下的那部分,还是得自己看、自己改、自己重来。
提示词占 10%,流程占 90%
先出 4 张图看一眼,这一步最容易跳过
数据说明:仓库元数据取自 GitHub API,复核时间 2026-10-03。流程细节、代码规范、性能数据均取自仓库内 README.md 与 skill/motion-design/SKILL.md。文中「7088 张截图」「3 天 10 多条视频」「27 万浏览」「改 5 次」等数字来自作者在 X 平台发布的长文,非仓库官方文档数据,引用时已逐处标注。
你做视频的时候,是先出图还是先渲染?
在评论区聊聊