ARTICLE · 1126578
AI搜出来的文献太多了,怎么办?
AI搜出来的文献太多了,怎么办?你想写一篇文献综述,AI搜出来 7,660 篇文章。 你打算筛几篇? 这个问题卡住过我很久。往下砍怕漏,全筛又筛不完——七千条摘要,一天筛两百条,一个半月。 后来我发现,卡住的原因不是“筛不完”。 是没有人告诉过你该筛多少。 
你的综述不需要穷尽,这件事先说清楚 “综述要穷尽检索”这个印象,很大程度上是被 systematic review 的规范带出来的。 但你要写的多半不是那一型。 Snyder 分的三型里: 半系统 / 叙事综述(RAMESES)——明确不要求穷尽,要求的是覆盖主要研究传统。 整合式综述(Torraco)——有目的的选择就是合法的,因为它的选文由概念论证驱动。 只有 systematic review 要求接近穷尽。 我去年读过四篇已发表的 SLR,想看看人家真实是怎么做的。结果挺有意思: 一篇 JIK 2025,单作者,两个库,一条布尔式,最终纳入 78 篇。 一篇 Computers and Education Open 2026,ERIC + EBSCO,四个概念块反复 pilot,最终纳入 17 篇。 一篇 International Nursing Review 2025,六个库,MeSH 逐行检索 S1–S21,还做了参考文献回溯和双人独立筛选——最终纳入 12 篇。 还有一篇 Educational Information Technologies 2025,Web of Science 单库,1,356 条全部进入分析,一条没筛(文献计量研究)。 四篇里,没有一篇做过雪球饱和检验,也没有一篇做 capture-recapture。 它们的共同点不是“穷尽”。 是检索过程可复现、每个数字都能对上账。 审稿人问的从来不是“你搜全了吗”,是“你怎么选的,我能不能重跑一遍”。 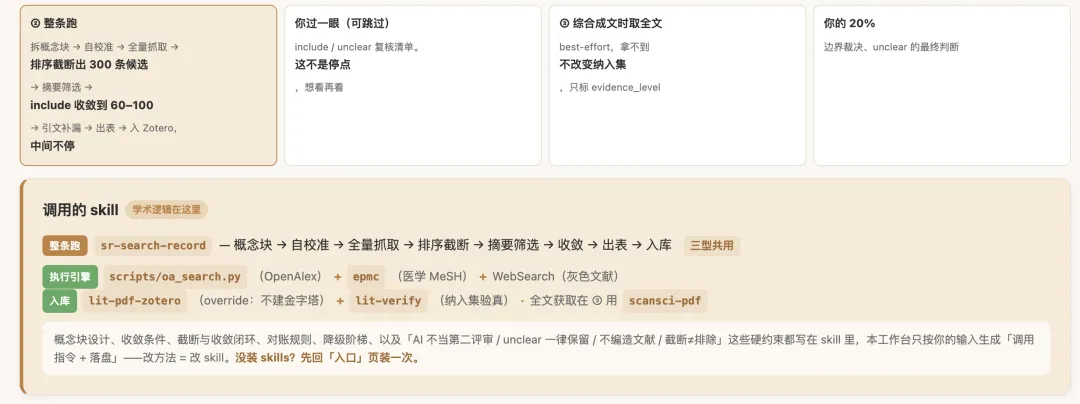
该筛多少:别从命中数往下砍,从纳入数往上推 这是我这次改工作流最大的一个思路转变。 以前的做法是:搜出 7,660 条 → 太多了 → 想办法砍。 砍成多少?没标准。砍到“感觉能做完”为止。 现在倒过来: 先定你想要多少篇纳入,再倒推该筛多少条候选。 倒推需要一个系数:候选集里,最终会被纳入的比例是多少。 我拿真实数据量过——按相关性排好序之后,前 300 条候选里,include 的密度稳定在 23–25%。 于是这个链条就闭合了: 想纳入 60–100 篇 → 筛 300 条候选 → 得到 70–80 篇 300 条摘要是什么概念?AI 一口气跑得完。你自己筛,两三天也就完了。 不够怎么办?把线从 300 扩到 600,只筛新增的那 300 条,已经判过的一条都不重筛。 还不够扩到 900。 这个系数随题目浮动——宽题目密度低,窄题目密度高。但方法通用:先筛一小批量出你自己的密度,再定截断线。 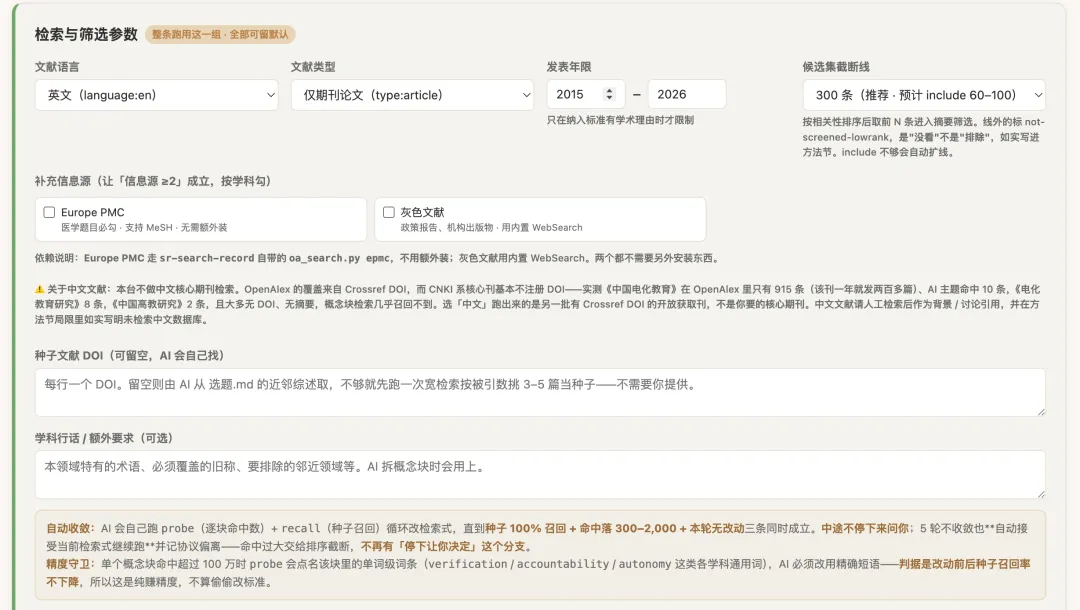
真正决定成败的不是筛多少,是你怎么挑出那批要筛的 同样是从 7,660 里挑 300 条,挑法不同,结果差一个量级。 我上一轮用的是分层随机抽样——按研究传统分层,每层抽 20 条。 抽出 61 条,筛出 15 篇 include。 这一轮改成按相关性排序后截断。 相关性分怎么算: 命中的是精确短语(epistemic responsibility)→ 3 分 命中的是单个词(responsibility)→ 1 分 命中位置在题名里 → 这一项 ×2 所有概念块的分数加起来 短语和单词为什么要分开算? 因为一篇文章的题名里出现 epistemic responsibility,跟它的摘要里飘过一个 responsibility,相关性根本不在一个量级。 后者是噪音。我那次 7,660 条里,有 5,033 条是只靠 verification accountability autonomy responsibility subjectivity 这五个泛词进来的——占 66%。 autonomy 命中的是自动驾驶和患者自主权。 verification 命中的是形式化验证和身份核验。 随机抽样对这些噪音毫无抵抗力,它们和真正相关的文献被抽中的概率一样。 排序会把它们沉到底下去。 不穷尽不是问题。不穷尽还随机挑,才是问题。 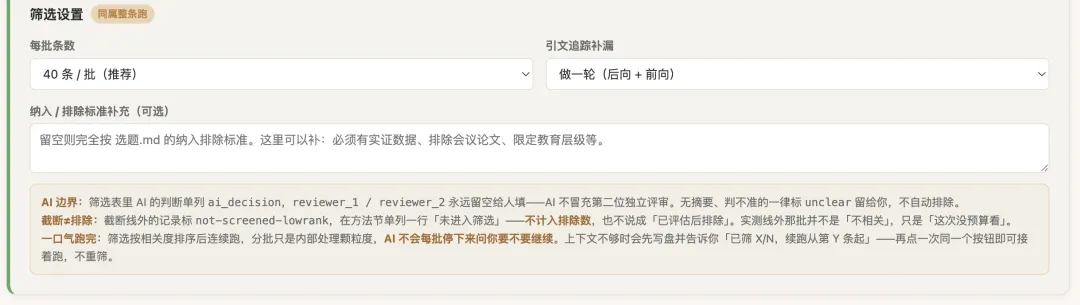
截断线是预算,不是相关性悬崖 这一条关系到你的方法节能不能写得住。 我顺手查了 301–600 名那一段的 include 密度。 也是 25% 上下。 跟前 300 名基本一样。 这说明词面排序的区分力,到几百名就饱和了——前 300 之后的那批不是“不相关”,是“这次没预算看”。 两件事,在方法节里绝不能混着写。 写成“经评估后排除”,是不实陈述。 写成“未进入筛选”,是如实报告。 方法节可以这样写 这是最实际的部分,给你一段能直接改的模板: After de-duplication, 7,660 records were identified. Records were ranked by a relevance score based on concept-block matches (exact phrases weighted above single terms; title matches weighted above abstract matches). The top 300 records were carried forward to title/abstract screening. The remaining 7,360 records were not screened and are reported as not screened (outside relevance-ranking budget); they are not counted among exclusions. 三个要点,缺一个都容易被审稿人抓: 「排序规则要写出来」——不能只说“选了最相关的 300 条”。凭什么说它们最相关?把打分规则写出来,别人才能重跑。 「未筛数单列一行」——不进排除数,不进流程图的 excluded 框。 「用词别偷换」——not screened ≠ excluded。前者是你没看,后者是你看了觉得不合格。 流程图照画,但那一支要单独标出来。 我知道有人会想:写“我有 7,360 条没看”,不会显得很心虚吗? 恰恰相反。审稿人见过太多“检索了 8,000 条,最终纳入 30 篇”却对中间过程含糊其辞的稿子。把预算说清楚,比假装穷尽可信得多。 我第一次做综述的时候,最大的心理负担是“万一漏了一篇关键文献怎么办”。 后来发现这个负担是假的。 没有人能穷尽。六个库 + MeSH 逐行 + 双人筛的那篇,最后也就纳入 12 篇。 真正会出问题的从来不是漏了哪一篇。 是你说不清楚自己漏在哪儿。 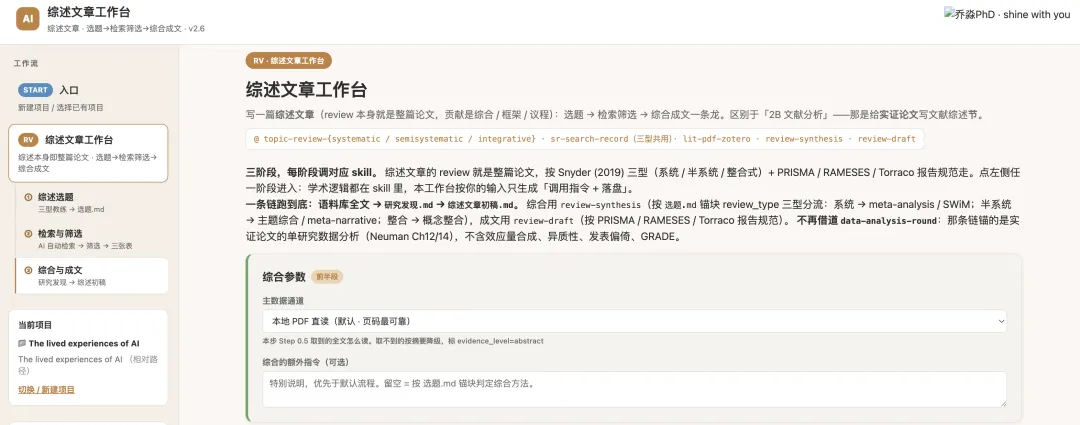
「AI学术工作台」是我给AI学术训练营的学员制作的专属工具。 不是单纯教你多用几个AI。 而是把研究选题、文献综述、研究设计、数据处理这几个关键环节,做成可以跟着操作的workflow。 感兴趣可以在评论区回复「AI学术」,下一期开班消息,第一时间通知你。
往期推荐