ARTICLE · 1128503
把设计交给AI之后,代码还要过三道验收
现 · PRISM
同一段GPU计算,两个程序都给出了正确答案。其中一个反复读取同一批数据,另一个把数据留下来复用。结果相同,执行代价却可能不同。NVIDIA的CUDA最佳实践指南就用矩阵乘法说明,减少冗余的显存读取可以改善性能。[1]
如果一份专业设计已经写明了怎样复用数据,AI生成的代码是否真的做到了?这个问题比“有没有给AI足够的资料”又往前走了一步。
列入10月5日arXiv新论文公告的D2K-Bench,把专家设计、生成代码和实际性能放在一起检查。[2][3] 它提供了一种值得认真对待的观察方式:看AI编程的进步,不只数它通过了多少测试,还要知道原本期待的优化在哪一步落了空。
给定方案以后,仍然有一道实现问题
作者在8张B200组成的环境中,让5个模型完成26项GPU内核任务、覆盖85种工作负载。同一模型的两次运行保持任务、工具、硬件和350轮预算一致,一次额外得到算法、数据流与底层执行三层指导;两边都看不到专家源代码。[2]
按作者报告,加指导后正确率从93.1%升至98.5%,综合性能分从1.46升至1.95,平均设计实现评分从57升至70(满分100)。最后一项由看不到运行时间的Qwen评审模型依据代码证据评分,不能当成“实现了70%的代码”。本文没有复现这些结果。[2]
这组实验的用处,在于让不同改进方向有了分辨的机会。遇到一个慢程序,团队可以继续让AI尝试更多写法,也可以补充它尚未想到的设计,还可以检查:方案已经提供,但关键步骤是否在实现时被遗漏。三种情况需要的帮助不同。
若把所有失败都归为“模型还不够聪明”,就很容易只盯着下一代模型。若把所有失败都归为“上下文不够”,又会不断往输入里添资料。成对比较至少能帮助缩小问题:在这批任务和这套环境里,补上设计后发生了什么,哪些差距仍然存在。
最容易漏掉的是看上去已经采用的优化
用一个简化的假设说明。设计要求中间结果只计算一次,供后面的步骤复用。生成代码也建立了一个缓存变量,注释里写着“避免重复计算”。但如果每次进入下一步前,都把这个变量重新生成一遍,设计想省去的工作仍在发生。
输出检查未必能发现这件事,因为重新计算也可能得到正确答案。阅读代码时,看见熟悉的变量名也容易产生已经完成优化的印象。只有沿着真正执行的路径追问,才会知道数据在哪里产生、保存多久、下一步是否真的复用。
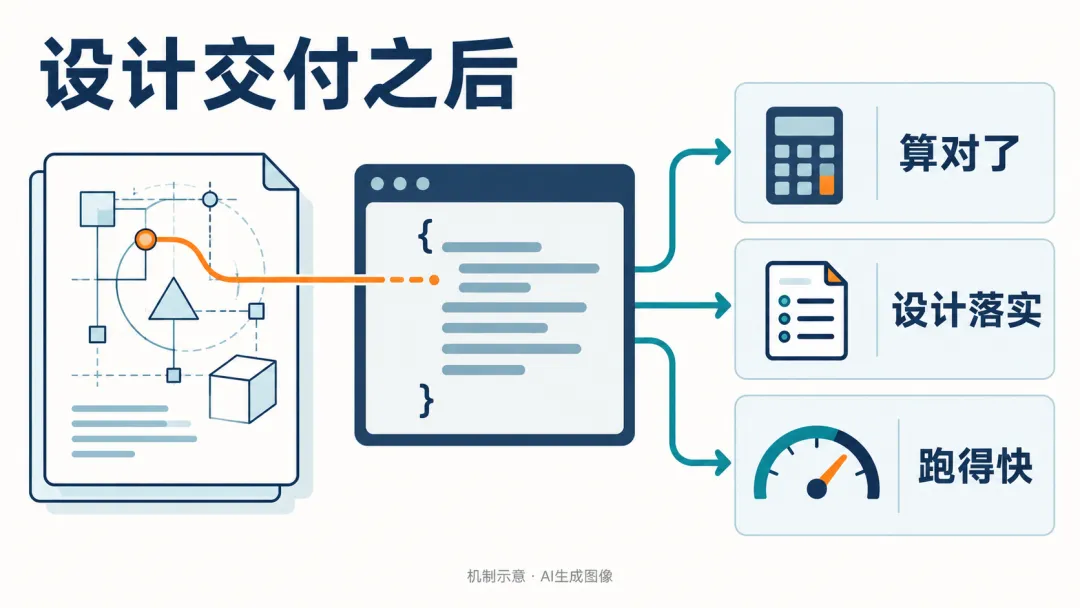
这也是我认为专业知识交付以后,验收应当变化的地方。接口写对、前提满足,使程序有机会工作;设计收益能否实现,还需要把一条优化理由追到具体执行。说明书越完整,越不能用“已经加载说明书”替代这项检查。
NVIDIA近期的DOCA Agent Skills,把经过核验的接口、硬件条件和构建约束交给编程Agent。[4] 这类知识供给有清楚的价值。D2K带来的进一步问题是:当知识已经送达,怎样证明它进入了代码,而非只进入了解释?
对一个实际团队,值得保留的交付物因此不应只有最终代码和一张通过测试的截图。还可以有一条很短的证据链:原先要减少哪项开销,代码在哪一处消除了它,运行测量是否支持这个判断。这是本文从实验得到的工作推论,不是作者已在企业部署中证明的流程收益。
验收设计,也要给更好的替代方案留门
增加一道设计检查,会带来一个合理的担忧:AI如果找到了另一条更快的路径,会不会因为不像专家方案而被扣分?如果评审只奖励复述指定设计,它就可能把探索变成模仿。
D2K的评分协议允许不同实现获得认可,前提是满足被检查的设计意图。[2] 但由模型打出的设计分,仍然需要被当作诊断线索。一个分数本身,不能裁决所有实现孰优孰劣。
更合理的关系是让三道验收互相质询。正确性检查约束结果;代码审阅解释它采用了什么办法;性能测量检验这些办法在目标负载上是否兑现。若代码快了却拿到较低设计分,应追问它是否找到了替代路线。若设计分很高却没变快,就该检查那份设计是否解决了真正的瓶颈。
这里不能把专家设计视作永远正确的标准答案。真实用途需要的是可解释、可重复的收益;只要替代方案经得起结果、资源约束和目标负载的检验,就值得被接受。多一道验收的意义,是让争议有证据可查,而不是再造一个必须追逐的排行榜。
CUDA指南也提醒,性能分析必须使用贴近实际的数据负载,否则可能优化了不重要的函数或不合适的规模。[1] 因而“设计写进代码”仍不是终点:写进去的那部分,还得在准备运行的地方有用。
更好的代码,可能花了更多生成成本
这篇研究还有一个不宜省略的反证。附录中,Opus实验的估算API成本从631.56美元升到820.10美元,增加29.9%。相同350轮没有带来相同花费。[2]
这不必然让指导失去价值。一段将被反复调用的程序,值得投入多少生成成本,取决于它以后节省多少运行资源。一个只执行几次的临时任务,可能就没有同样的回收空间。判断两者,需要后续使用量和实际节省,不能从这次实验的得分直接算出投资回报。
它也改变了“给AI更多专业材料”的含义。增加材料有机会减少摸索,同时也增加了需要处理的内容。评估时若只固定轮数,容易忽略另一部分代价。更有说服力的下一步,应把相同成本下得到的结果,与相同性能目标下付出的成本分别比较。
我的积极判断限于这种诊断方法:它能把“有指导就会更好”的笼统期待,变成可以逐项检查的假设。26项内核任务和一种8卡B200环境,不能代表所有编程;更换硬件、任务或Agent运行框架后,结论需要重做。
如果独立复现发现,设计评分不能帮助定位性能问题,或者为了追求评分反而排斥了更好的实现,就应该削弱这道检查的权重。反过来,若它能稳定指出测试通过之后仍被遗漏的优化,团队才有理由把它加入正式验收。
AI写代码的能力越强,交付标准就越需要具体。程序给出正确答案,只回答了第一道题;设计怎样成为执行,执行又产生了什么收益,还各自需要一份证据。
主要来源
[1] NVIDIA CUDA C++ Best Practices Guide:正确性、带宽与性能分析
[2] D2K-Bench原始论文(v1)
[3] arXiv cs.LG 10月5日新论文公告,D2K-Bench第148项
[4] NVIDIA DOCA Agent Skills官方说明
[5] D2K-Bench官方代码仓库
AI辅助研究与写作。本文未独立运行或复现D2K-Bench;缓存情景为机制说明的假设。