ARTICLE · 1128506
视觉AI的下一步:帮人把问题拍清楚
现 · PRISM
相机拍到一只调料罐,和把罐上的标签拍清楚,是两件事。对于难以自行检查画面的人,这个差别可能意味着反复举起手机、等待描述,再猜一次镜头究竟偏在哪里。
10月1日,Google发布Gemini Live的Guided Vision。除了实时描述,它会用语音提示用户调整镜头方向、角度或距离;官方帮助页同时提醒,这项功能正在逐步开放。[1][2]
取景辅导听起来远没有“AI看懂世界”宏大,却更接近一个实际问题:系统需要的证据,为什么总要由最难检查画面的人独自准备?这次设计值得肯定的地方,是它开始承担这段工作。至于它能否减少挫败和误判,还需要真实使用来回答。
一次识别之前,还有一段容易被省略的劳动
图片问答很容易从“已经有一张好照片”开始设想。物体在画面中央,文字足够大,光线适当,用户的问题又恰好能从这张图得到答案。这样的起点,把拍摄和挑选证据的劳动藏了起来。
换成一个假设任务:用户想确认两件衣服的图案是否相配。相机只拍到其中一件,系统即使完整地描述了它,也没有回答比较问题。如果另一件的边缘偶然入镜,模型还可能把不充分的线索补成一个流畅判断。
此时,再追问一遍未必有用。同一幅不完整画面不会因为问题说得更坚决,就突然包含更多信息。真正能推进任务的,是系统指出还缺哪一部分,帮助用户把另一件衣服纳入视野,再作比较。
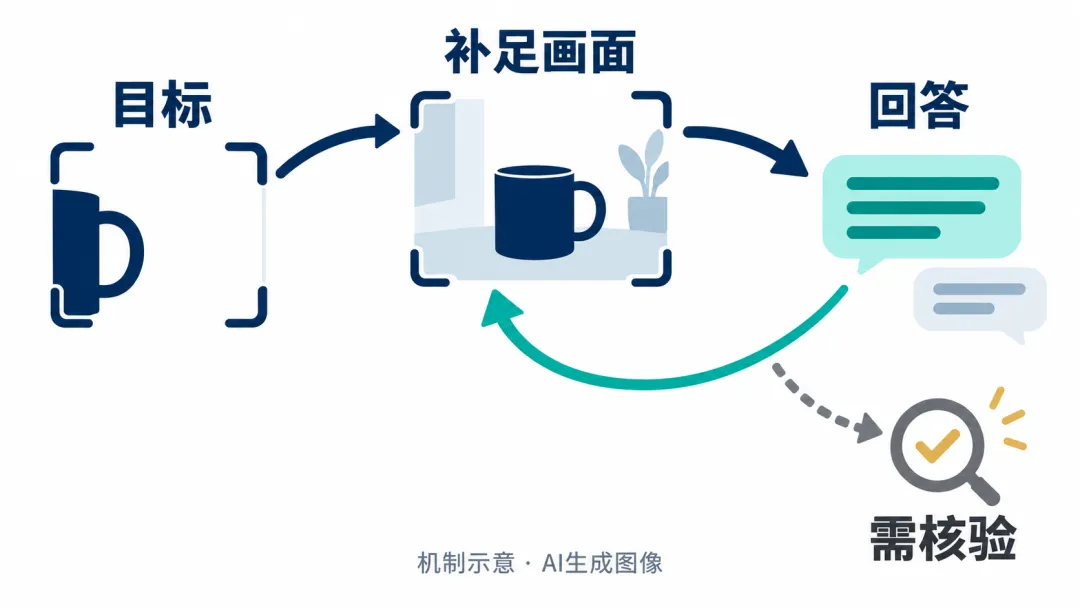
这也是连续取景提示的意义。一次问答可以变成一个反馈过程:先确认目标,检查眼前证据,给出可执行的调整,再根据新的画面回答。用户不用独自推测“AI没答好,是因为没拍到、没看清,还是没理解我的问题”。
其中最关键的动作,甚至可能是暂时不作结论。一个知道需要看清标签才回答的助手,比一个只会为当前画面补全故事的助手,更接近可靠的帮助。这里评价的是交互设计所追求的方向,并非认定新产品已经在每个场景做到了。
已有产品说明,进步要看得更细
取景提醒并非从这次发布才出现。Be My AI现行帮助文档已经说明,照片模糊或没有对准时,它会要求重拍;用户可以继续发照片、追问,也能转去联系志愿者。不过,该文档仍注明不支持视频输入。[3]
因此,Guided Vision值得比较的增量,是能否把逐张拍照、等待和重试,变成更顺畅的实时调整。不能只因为它用了新的名字,就把过去的视觉辅助工作抹掉。
Google表示,这项功能与Aira共同开发,超过一千名Trusted Tester参与测试。[1] 让盲与低视力用户参与设计,比只由看得见界面的开发者猜测需求,更有希望发现取景和提示中的问题。但参与人数仍不能直接证明实际完成率提升了多少。
一项发表于CHI 2026的研究,提供了很合适的观察角度。研究者让20位盲与低视力参与者进行两周日记记录,发现令人满意的图片描述,并不保证后续具体问题同样可靠。研究实际采集于2024年,使用的是当时的系统,不能拿它的结果给今天的Gemini打分。[4]
它仍提醒我们,描述一幅画面和围绕一个人的目标提供帮助,需要不同的能力。前者可以把能看见的东西尽量说全;后者要决定哪些细节相关、哪些证据缺失,以及用户下一步能做什么。多说几个物体名称,不一定让任务前进。
让人自主,也包括允许人少交互
实时交流并非天然优于照片。它需要用户持续保持镜头、听取提示,再作调整。假如只是确认一件上衣的颜色,一张照片和一句简短回答可能已经足够。把简单任务扩成来回对话,同样会制造负担。
前述日记研究也记录到,有参与者不愿在公共场合反复使用语音,或觉得不断追问耗时。[4] 这类取舍很容易被演示视频略过:安静房间里连续交流很自然,排队、通勤或双手正在做事时,理想交互可能完全不同。
因此,评价取景提示,需要把“信息量”换成“用户少承担了什么”。一次清楚的方向提示可能省掉几轮重拍;过密、模糊或互相矛盾的提示,则会把用户变成替系统不停调整输入的人。
更重要的是,不同用户对剩余视力、听觉、触觉和熟悉环境的利用方式各不相同。辅助系统应围绕他们已经会做的事情补足信息,不能把自己的描述当作唯一可用的世界。目标仍由用户设定,也应允许用户结束交流、换一个工具,或干脆先不需要帮助。
这使“更主动”成为一个有条件的优点。系统主动指出自己没看清,通常有价值;系统持续规定用户该怎么行动,就需要更强的理由。好的提醒应让人更容易作决定,而不是让人更难停下来。
失败以后,路还得是通的
取景反馈能处理一部分信息不足,却无法保证最后的识别正确。更清晰的画面,仍可能包含模型不理解的内容;更自然的声音,也不会自动增加判断的可信度。
这里有一个值得分清的产品差异。Aira自己的Project Astra视觉辅助测试项目,明确提供用户按需请求人工核验或接管的通路;Google这次Guided Vision公告,没有给Gemini作出同样的承诺。[5] 两者有合作关系,功能也不能互相挪用。
这条差异不是为了判定必须配备真人服务才算合格。它说明,帮助用户接近正确答案,与在答案仍不可靠时留下另一条路,都是产品需要设计的部分。退出可以是换工具、找熟悉的人,或者明确知道这次不能继续;具体安排不必只有一种。
Google为Guided Vision划出的范围也应读准确:它不用于导航或障碍检测,不替代助行工具。[1][2] 不能把找出桌上的物件,扩写成可以带人安全走过街道。两类任务对出错代价和时间反应的要求,本就不同。
下一步真正值得看的,是它能否在盲与低视力用户的实际任务里,更快发现取景失败、减少无效调整,并在证据不足时避免给出笃定答案。若提示反而增加操作负担、掩盖不确定性,对这条设计路线的肯定就应当收窄。
视觉AI的价值可以落在很小的动作上:少一次猜镜头的位置,少一轮没有新信息的追问,知道什么时候该换一种办法。让系统承担更多理解与取证工作,让人保留更多决定如何获得帮助的空间,这比把每一次描述都说得更像真人,更值得追求。
主要来源
[1] Google|Guided Vision发布
[2] Google|Guided Vision帮助
[3] Be My Eyes|Be My AI说明
[4] CHI研究|视觉信息辅助使用
[5] Aira|AI视觉解读项目
AI辅助研究与写作。本文未进行产品实测;文中假设任务不代表真实用户体验。