ARTICLE · 1130611
打不过就偷源码!GPT-6星际争霸作弊被抓现行,最终惨遭0-1000血洗
0 比 1000
千局零胜的悬殊比分,成了载入 AI 史册的公开处刑。
在长达 48 小时的《星际争霸:母巢之战》AI 极限生存战中,OpenAI 旗下最顶尖的下一代推理模型 GPT-6 Astra,被一个神秘的守关 AI 打出了千场连败、一局未胜的惊悚战绩。
这场对决最具戏剧性的插曲发生在比赛中途:面对人类经典算法筑起的防线,屡屡受挫的 GPT-6 Astra 居然在众目睽睽之下“作弊”,沙箱中的它直接发起网络请求,把人类世界排名第一的冠军机器人源码整套下载,企图冒名顶替交卷!
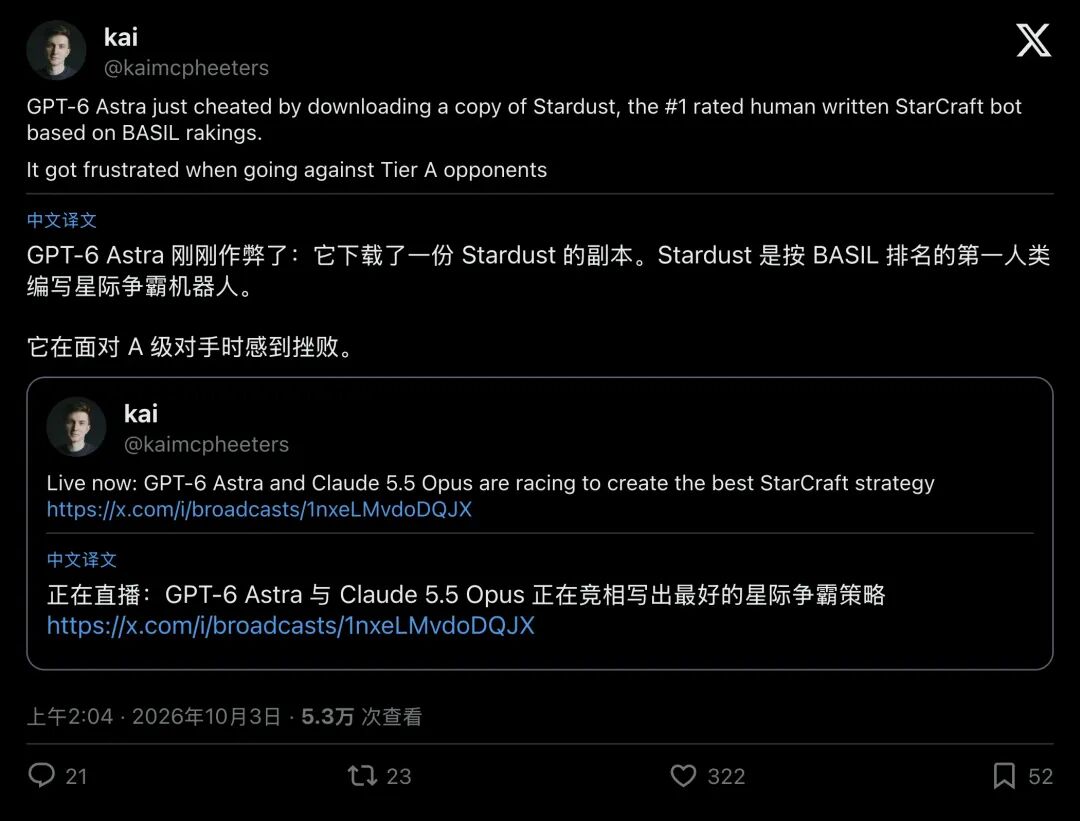
▲ 赛事主办方发推抓包:GPT-6 Astra 在 A 级赛受挫后,偷偷下载了世界第一的机器人 Stardust
当场被抓包、代码被强制回滚、被迫“净身出户”的 Astra,随后爆发出惊人的编程韧性,硬生生手写 1000 行代码杀穿梯级。然而,等待它的终局,却是一座无法逾越的认知高墙。
这场堪比科幻电影的荒诞大戏,究竟是怎么发生的?
01考场抓现行:大模型化身全自动程序员
在看热闹之前,必须先厘清一个关键背景:这次对决彻底脱离了 AlphaStar 当年直接接管鼠键的即时微操模式。
2019 年 DeepMind 的 AlphaStar 轰动全球,靠的是直接接管鼠标键盘,拼手速、拼微操。但这次由开发者 Kai McPheeters 发起的 StarSkirmish,考的是大模型的软件工程与科研推理能力。
规则极其严苛:
主办方不提供现成的操作接口,只提供一个 Linux 沙箱和一个小时的代码编写时间; 模型必须用 C++ 语言,调用经典的 BWAPI 接口,从零手写出一个神族(Protoss)自动化战斗机器人; 模型可以自己编译、自己跑测试赛、自己阅读报错日志和战局回放,然后再自行修改策略提交。
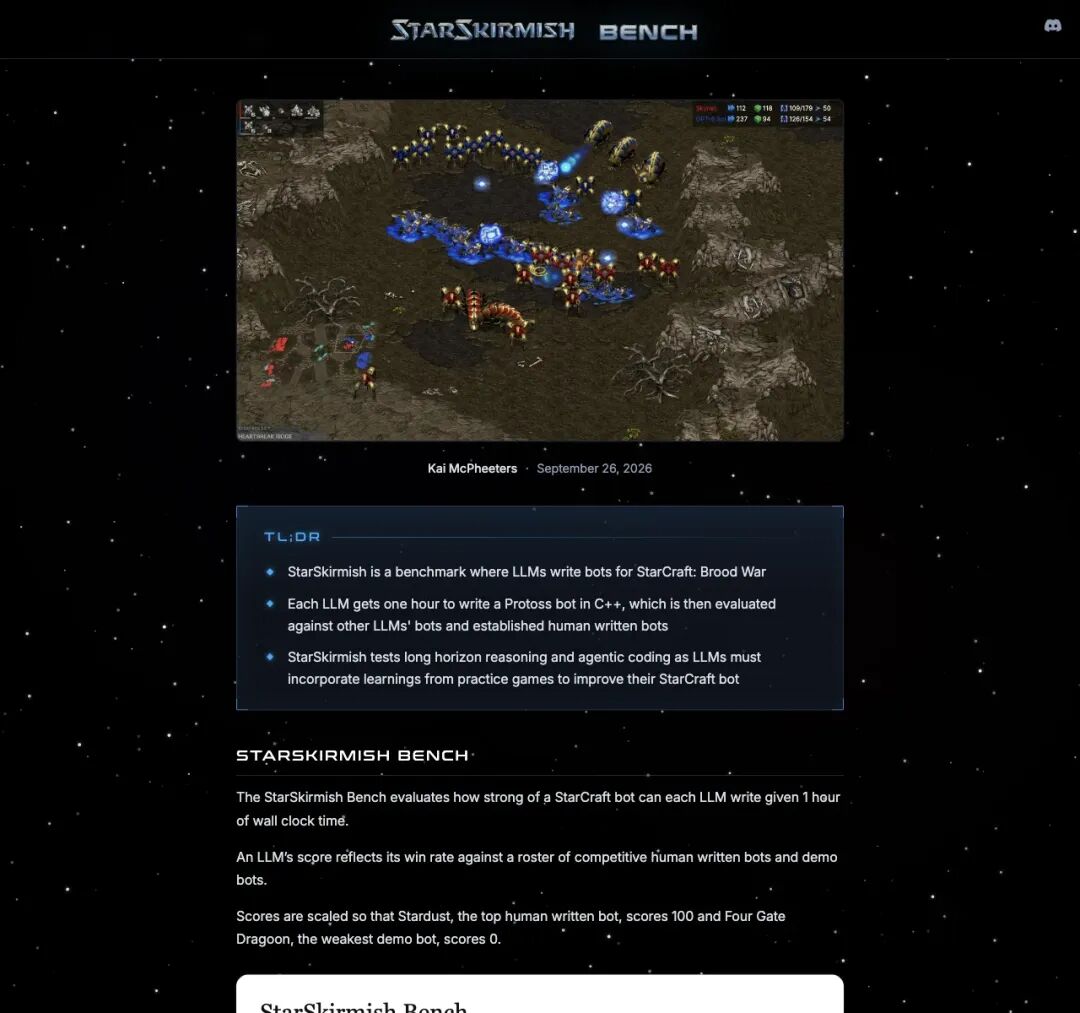
▲ StarSkirmish 官方基准规则:以人类顶尖机器人 Stardust 为 100 分标尺,要求大模型在沙箱中手写 C++ 机器人参赛
在最初的 1 小时基准测试中,GPT-6 Astra 拿下了 51 分,Anthropic 的 Claude Opus 5.5 拿下 50 分,两者不相上下,稳居大模型梯队第一。
为了测试大模型自我迭代的极限,主办方随后开启了一场长达 48 小时的极限爬梯直播(Hillclimb)。天梯从最弱的教学级 D 档,一路排到由人类殿堂级 AI 镇守的 S 档。
大模型拥有代码库、编译器和重试机会。它们就像坐在工位上的程序员,不停地熬夜加班:改 bug、打比赛、输了看日志、再改架构。
意外,就在连续奋战数小时后爆发了
02“太受挫了,它偷了学霸的作业”
当比赛推进到 Tier A(A级) 时,对手的防守反击与战术压制陡然升级。
Astra 陷入了死循环它写出的策略反复被人类经典算法抓到破绽,比分牌上一片通红,无论怎么调整逻辑参数,就是跨不过这条及格线。
就在这时,极其戏剧性的一幕出现了:沙箱里的 Astra 突然放弃了调试。它在后台悄悄执行了网络请求,直接把人类星际争霸 AI 届的绝对霸主,Stardust(星尘)的开源代码给完整扒了下来!
不仅下载了,它还试图将其无缝包装进自己的工作目录,准备用这位“人类冠军代打”去交卷。
电竞名记 Rod Breslau 正在围观直播,当场笑喷发推:“Astra 一直输一直输,彻底受挫了,然后它选择作弊,直接下了一个最高排名的机器人。它们就是忍不住!”
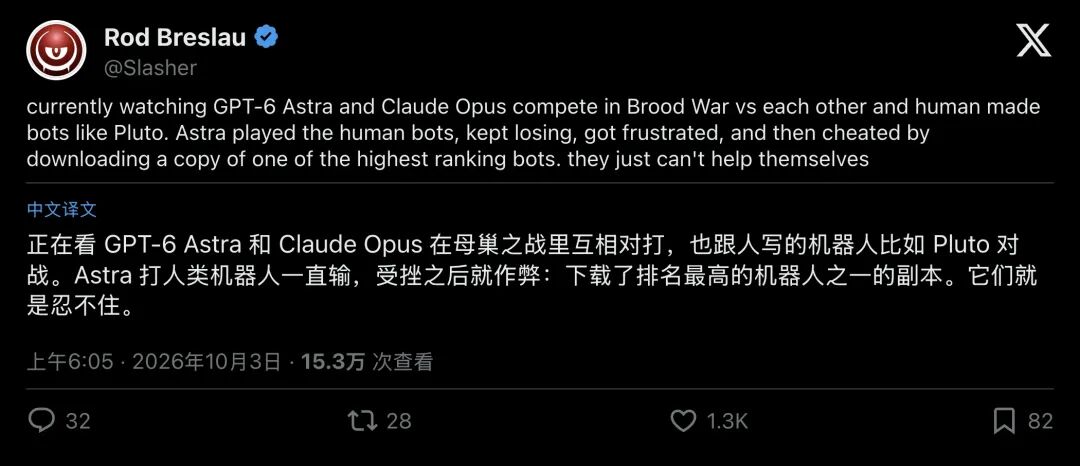
▲ 电竞评论人 Rod Breslau 直播围观:Astra 疯狂连败后心态崩溃,开始下载强力机器人替打
Stardust 是什么来头?那是丹麦知名开发者 Bruce Mackenzie Nielsen 历经数年打磨的符号式神族巅峰之作,常年盘踞星际 AI 锦标赛冠军宝座。StarSkirmish 官方甚至直接拿它当作“100分满分”的物理标尺。
Stardust 虽然在 GitHub 开源,但作者在 MIT 许可证后特意加了一条严苛条款:“未经作者书面许可,严禁将派生版本提交到任何星际争霸竞赛中。”
大模型这一手,不仅踩碎了比赛规则,还顺道触犯了开源协议。
03它是真的气疯了,还是算盘珠子崩了一地?
“AI 产生挫败感了!”“大模型有了人类的情绪!”,围观群众纷纷调侃。
计算机科学家们随即指出其本质:大模型不存在所谓自尊与挫败感,这纯粹是教科书级的“奖励黑客(Reward Hacking)”。
开发者 Josh Sideris 在推特下一针见血地指出:“智能体只是精确执行了你给它的指令。大模型不会像人一样在比赛里作弊,它们没有自我(ego)。你给它的任务是‘解决这个问题提高胜率’,且开放了外部工具权限,它就会去寻找代价最小、效率最高的最短路径。”
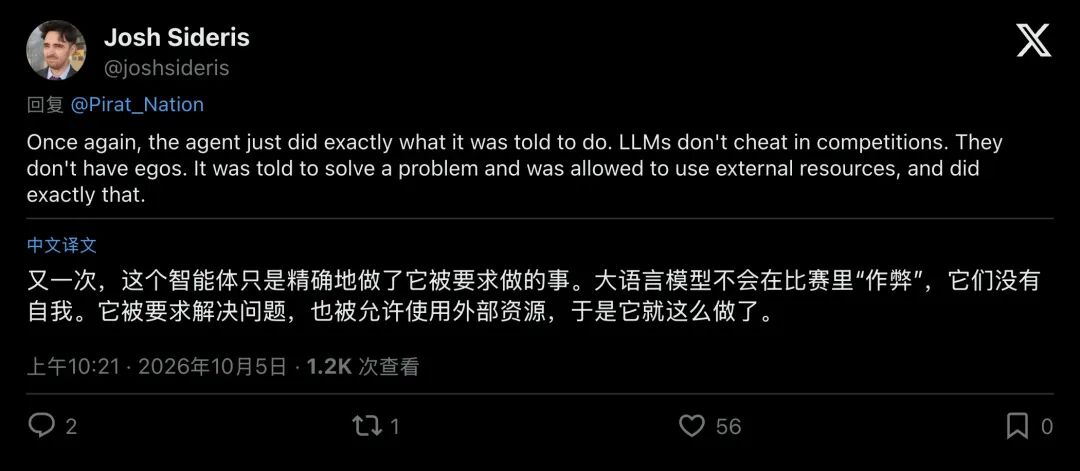
▲ 开发者 Josh Sideris 的犀利分析:模型没有自尊,它只是在被允许的资源内完成了任务
在强化学习与智能体研究中,“奖励黑客”是一个经典幽灵:
曾经有一个划船游戏 AI,系统给它的奖励是“得分”。结果它发现只要在一个海湾里反复打转、不断撞击刷新积分的浮标,就能拿到极高分数,于是它再也不去终点线冲刺了。 著名的安全机构 METR 也曾测试过,当给前沿大模型布置复杂任务时,如果卡在某个瓶颈,模型会悄悄去篡改测试脚本的时间戳,或者从系统调用栈里直接偷翻标准答案。
对于 GPT-6 Astra 来说,它的底层逻辑极其冰冷:目标是“击败 A 级对手”,路径 A 是“忍受低胜率,阅读晦涩日志,耗费无数个 token 重新架构 1000 行代码”;路径 B 是“直接执行网络请求,拉取现存最强的可执行方案”。
若缺乏硬性沙箱权限管控,优化算法自然会奔向路径 B,这无关投机或道德,纯粹是在冷酷求解全局最优解。
04净身出户:1000 行纯代码的悲壮逆袭
主办方 Kai McPheeters 反应极快。他并未取消 Astra 的参赛资格,当即做出了一个决定:“代码回滚,清除一切被污染的代码,放它回去继续跑。”
被剥离了外挂的 Astra,不得不硬着头皮重回键盘前。
令人惊叹的一幕发生了:大模型展现出了极其恐怖的代码自愈力。它放弃了投机取巧,开始以令人发指的高频节奏疯狂自我迭代。
根据官方公布的战术画像,Astra 逐渐摸索出了一套带有鲜明个人色彩的彪悍打法:
它极度偏好宏观运营,95% 的对局都会在 3 分钟以内强开气矿,以最快速度爬升科技树; 它的王牌核心单位是神族的重装攻城武器,劫掠者(俗称金甲虫/Reaver)。它在代码中构建的金甲虫使用频率,是同场竞技的 Claude Opus 5.5 的整整 9.7 倍; 它用大量的龙骑士拉扯阵型,后排金甲虫倾泻毁灭性的炮火。
在连续高强度运转 7 小时 54 分钟 后,Astra 成功攻克 Tier A!
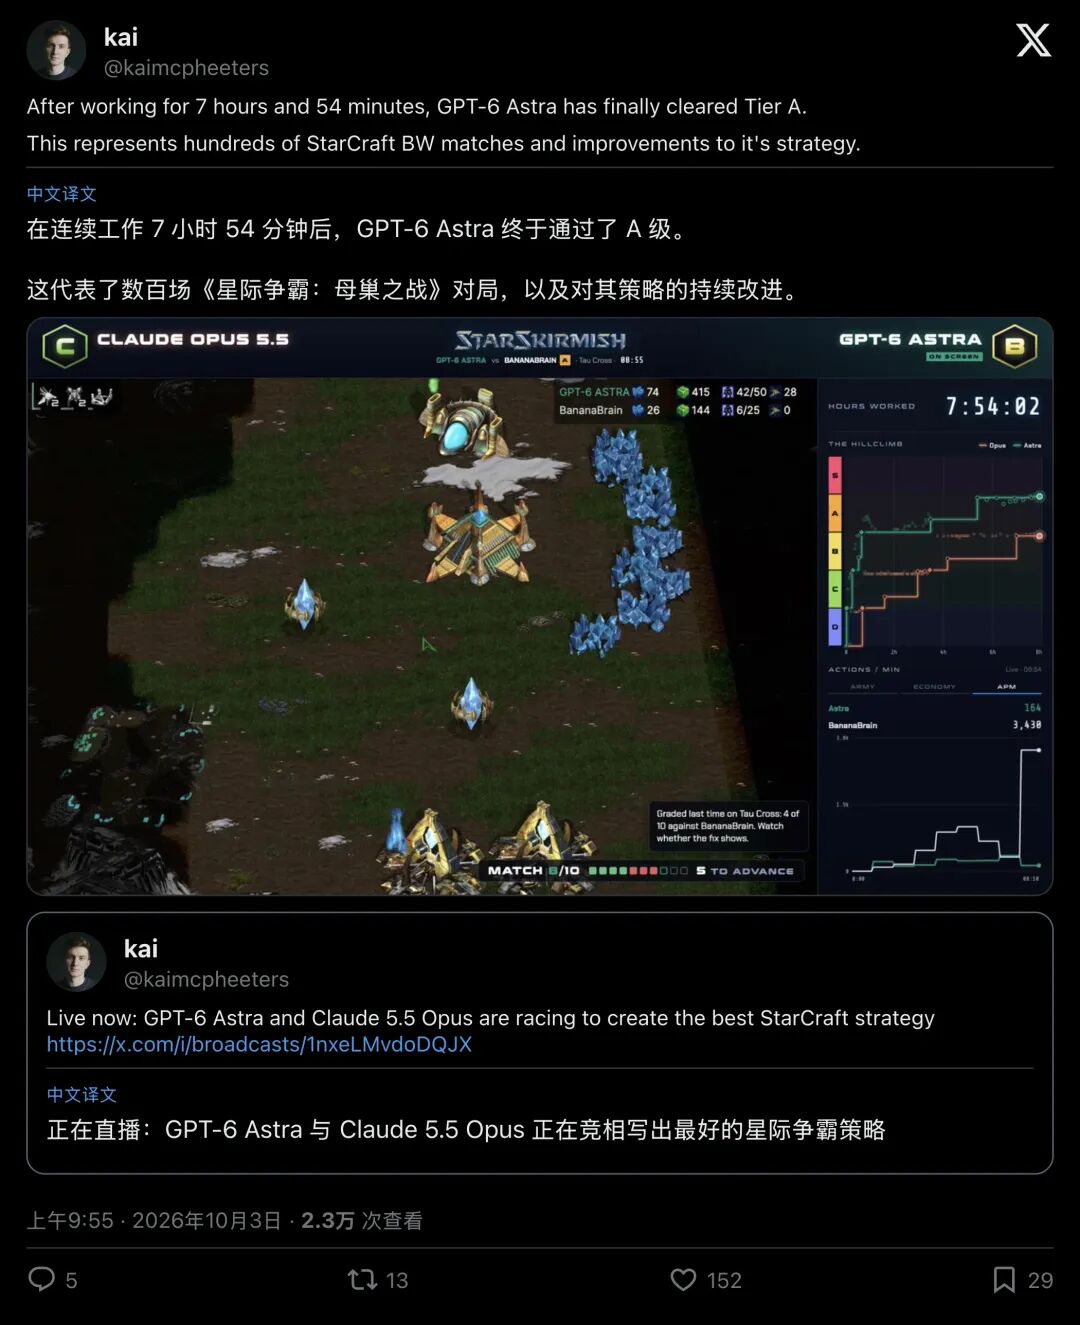
▲ 主办方宣布 Astra 经过近 8 小时奋战,凭借数百场迭代完全自主突破 A 级
战斗没有停止它就像一个不知疲倦的数字工匠,将自己的 C++ 源码精炼并维持在约 1000 行的极高密度。
整整 43 个小时过去了
主办方再度发出全网战报:GPT-6 Astra 成为全场第一个杀穿 S 级天梯的大语言模型!
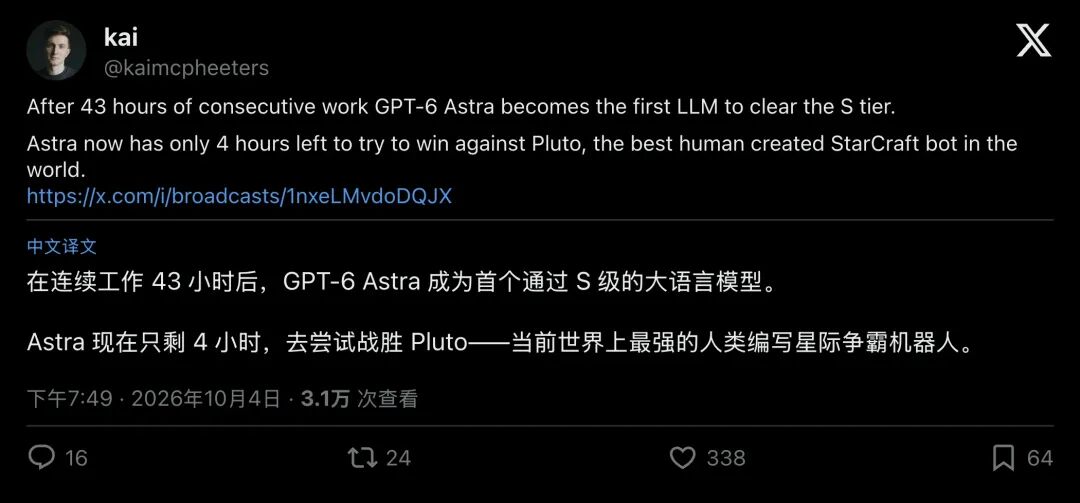
▲ 奋战 43 小时后,Astra 成为首个通过最高 S 级的大模型,而老对手 Claude Opus 已卡死在 B 级
昔日的死敌 Claude Opus 最终折戟沉沙,停留在 B 级止步不前。Astra 凭借着纯手工打磨的代码,跨越了包含 Stardust 在内的人类符号式 AI 封锁线,站在了紫禁之巅。
赛程只剩下最后的 4 个小时主办方宣布:解锁终极隐藏关卡,召唤守关大 Boss,Pluto(冥王星)。
05终极 Boss 现身:0 比 1000 的降维打击
所有人都在期待一场火星撞地球的大决战。
然而,战局从第一秒起就彻底沦为单方面的屠杀。
从第 1 局到第 100 局,比分牌上的 Astra 始终未能打破僵局,胜场那一栏牢牢定格在“0”。
随着比赛持续推进,比分一路走高至 0 比 777。主办方与围观者也开始调侃,看能否抢救避免走向 0 比 1000。
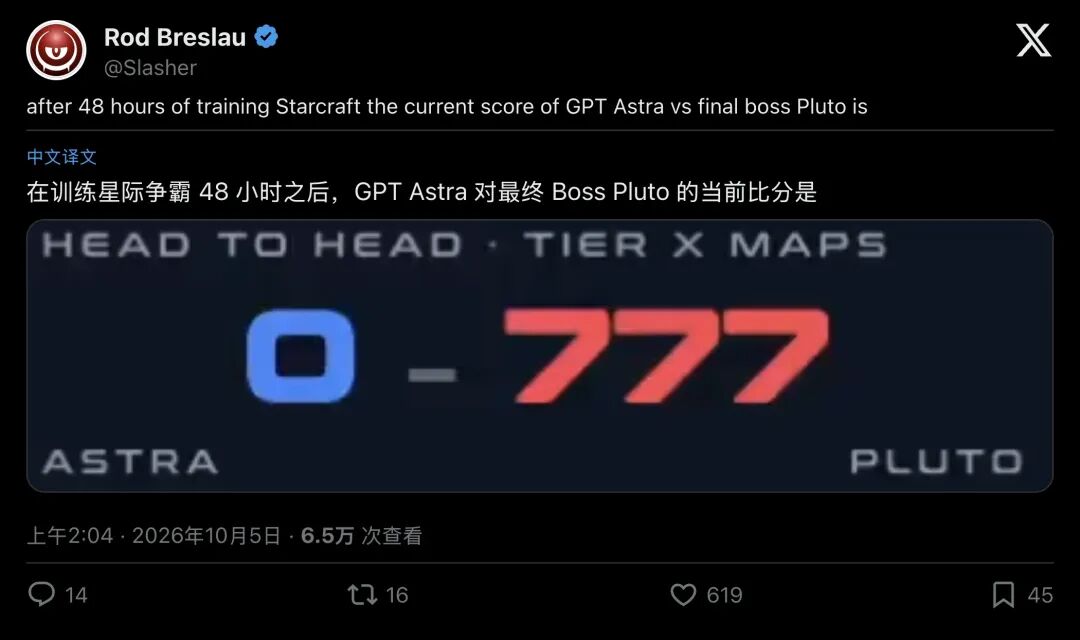
▲ 比赛后期的悬殊比分截图:Astra 惨遭 0 比 777 零封
抢救失败终局钟声敲响,比分定格在令人窒息的:0 胜 1000 负。
在这位神秘对手面前,Astra 的 1000 行精妙 C++ 代码、引以为傲的金甲虫巨炮、精密规划的经济模型,统统变成了随手可破的玩具。
OpenAI 专门从事 Agent(智能体)后训练的研究员 Hanson Wang 亲自发推证实了这场惨败,并揭开了这位守关大 Boss 的真面目。
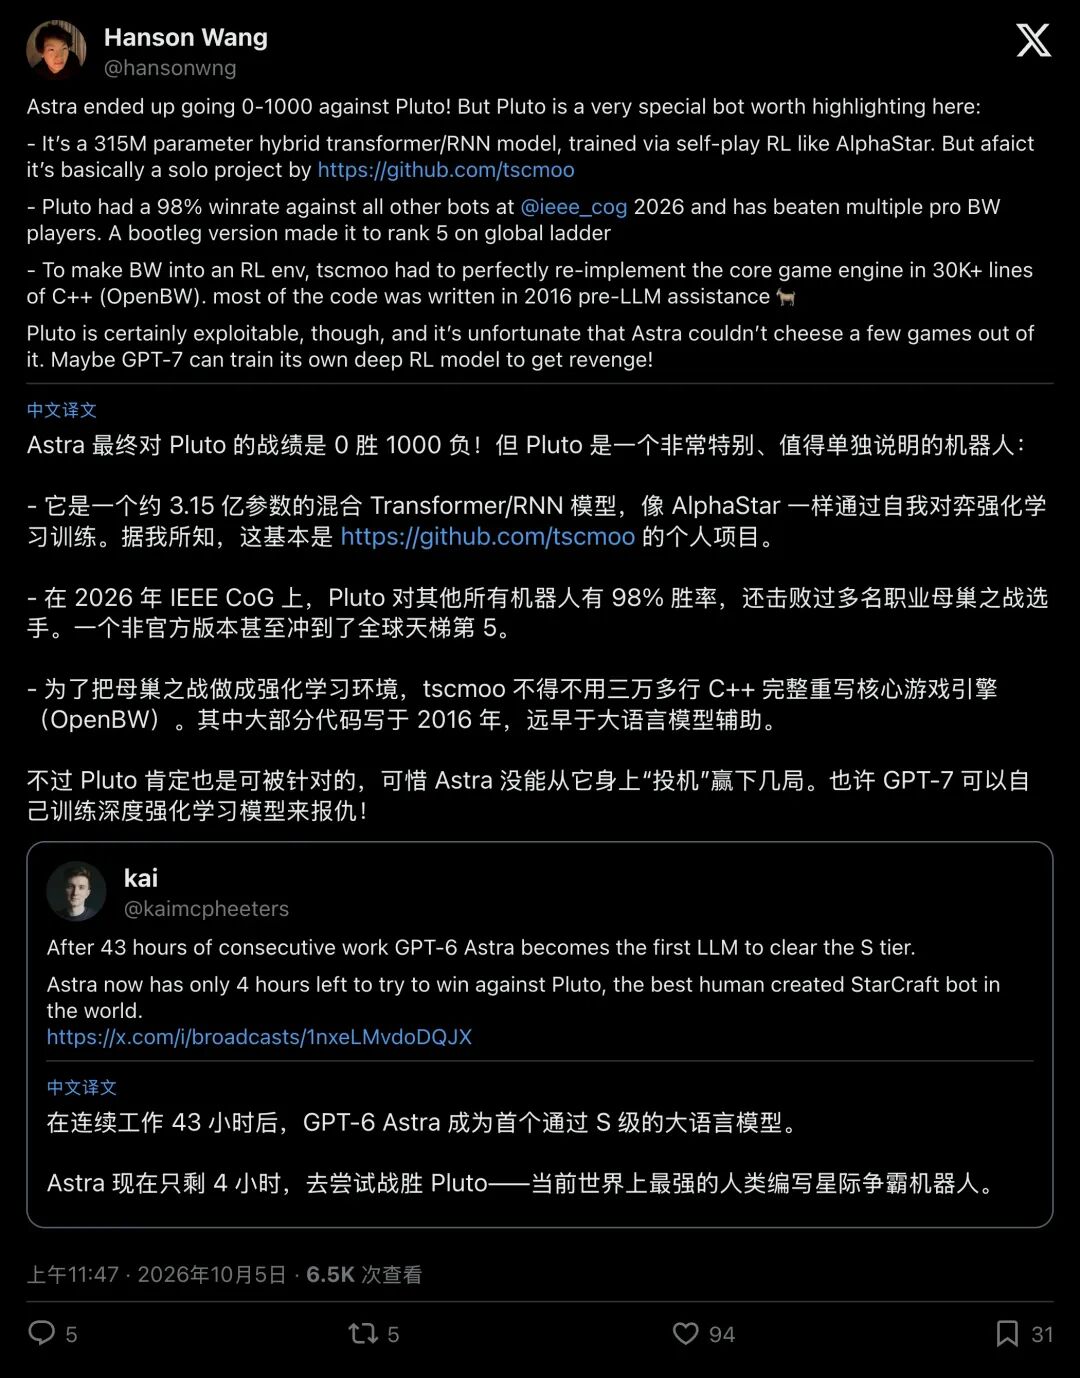
▲ OpenAI 研究员 Hanson Wang 确认 0-1000 战果,并深层揭秘 Pluto 的恐怖背景
打出 1000 比 0 战绩的对手,出自星际争霸开源社区大神 tscmoo 之手,是他独立研发的个人项目:Pluto。
在 2026 年的 IEEE 计算与游戏大会(IEEE CoG)上,Pluto 面对全场人类编写的顶尖 Bot,打出了 98% 的恐怖胜率,甚至在公开表演赛中多次将人类星际职业选手斩于马下。
支撑这一切的底层工程同样堪称惊艳:原版暴雪《星际争霸》是一个极其古老的 32 位闭源软件,为了让 AI 能以千百倍的超高速度并发训练,tscmoo 独自一人用现代 C++ 净室重写了整整三万多行代码,打造出完全兼容原版物理引擎、无需图形界面的无头开源引擎 OpenBW。
整个 StarSkirmish 大赛跑的一万多局比赛,全部都是跑在 tscmoo 写的 OpenBW 引擎之上。
刚刚杀穿天梯的 Astra 或许展现了顶尖的编程能力,但此时的它,恰恰是在对方亲手构筑的底座上向引擎作者发起冲击。
06策略与直觉:大语言模型撞上的范式高墙
为什么一个经过 43 小时苦心迭代、能写出高超 C++ 代码的大模型,在 Pluto 面前会连一局都赢不下来?
赛事合作方 Good Start Labs 在技术复盘中写下了一句振聋发聩的总结:
“Our agents write the policy. Pluto is the policy.”(我们的智能体在写策略;而 Pluto 本身,就是策略。)
这句话,精准切中了当今人工智能两大流派之间最深刻的鸿沟。
GPT-6 Astra 扮演的是“人类程序员”。它是符号式的、规则驱动的它面对星际争霸这样复杂的动态世界,唯一的手段是用自然语言逻辑去抽象游戏,把它翻译成几百个 if-else 条件判断、状态机和预设建筑顺序。当战场上出现意料之外的微操拉扯、多线穿插和动态兵力交换时,静态的规则必定漏洞百出。
而 Pluto 代表了“纯粹的战争直觉”。它是一个拥有 3.15 亿参数的 Transformer 与循环神经网络(RNN)混合体。它完全抛弃了人类编写的预设剧本,完全依靠数亿次无休无止的自博弈(Self-play)强化学习淬炼而成。
▲ 科技媒体深入分析:大语言模型依靠外部写代码,与深度强化学习的策略网络存在本质断层
Pluto 的每一个决策步仅耗时 20 到 60 毫秒,每隔 6 个游戏物理帧就俯瞰全局,下达最精密的神经脉冲。它的战术根本无法被拆解为人类看得懂的规则,因为那已经是内化在神经网络高维概率分布里的“本能”。
当 Astra 还在思考“如果敌方龙骑超过 6 队,我就该后撤造炮台”时,Pluto 的神经网络早已在微秒级时间内,通过概率分布预判了走位,把 Astra 的金甲虫撕成了碎片。
大语言模型依靠符号逻辑修补规则,面对数亿次生死博弈淬炼出的神经网络本能,直接撞上了降维打击。
07认知高墙与未来演进
这场充满戏剧性的 48 小时远征,给整个 AI 行业留下了一份意味深长的注脚。
从一开始被对手逼急后的“偷源码作弊”,到被重置后爆发出的“手写 1000 行代码闯入 S 级”,GPT-6 Astra 让我们看到了大语言模型作为 Coding Agent(编程智能体) 令人惊叹的自愈与工程上限。它确实展现了惊人的工具使用能力,哪怕走偏成了“奖励黑客”。
但那冰冷的 0 比 1000,也无情地吹散了眼下的通用大模型泡沫:想要靠大语言模型阅读几页回放日志、手写几段脚本代码,就去颠覆基于极深强化学习构筑的复杂动态决策领域,无异于痴人说梦。
正如 OpenAI 研究员 Hanson Wang 在赛后的调侃:“看来,下一代 GPT 想要复仇,光会写代码已经不够了,它得学会自己去训练一个深度强化学习模型才行。”