ARTICLE · 1130618
Schema 机制全景解析 - Pi 源码分析 06
本文是「Pi 源码剖析」系列的第六篇,承接上一篇《Pi Extension:从 hello.ts 到 llama.cpp》。在上一篇分析自定义工具(Tool)时,我们看到了
parameters: Type.Object(...)的身影。本文专门聚焦 Schema:从生活常识类比到严谨的技术定义,还原 TypeScript 如何突破“类型擦除”在运行时生成 Schema,以 Pi 内置的read工具为例剖析源码实现,并完整梳理 Schema 在模型请求、严格受限采样与本地拦截校验中的核心作用。
一、理解 Schema 最直观的现实类比:空白业务办理表单的设计规范
如果脱离复杂的代码术语,理解 Schema 最直观的方式就是一张“空白业务办理表单的设计规范”。
你去银行开户或去政务大厅办事时,工作人员会递给你一张空白纸质表格。这张表格不是随意画出的,表格的设计师必须提前制定一套严格的规范:
1. 项目栏目:表格上一共有哪些空格需要填(例如“姓名”、“身份证号”、“是否申请短信提醒”、“资产等级”); 2. 必填标记:哪些栏目旁边印着红色的星号( *),属于不填就不能提交的项,哪些属于选填项;3. 填写格式限制:“姓名”只能写文字,“年龄”只能写正整数,不能在“年龄”那一栏写“我很年轻”; 4. 小字提示语:格子下方通常印有一行灰色小字(如“请填写 18 位身份证号码,末位若为 X 请大写”),用来指导填表人怎么填; 5. 单选与下拉选项:“申请类型”只能在“个人账户”或“企业账户”两个选项中勾选一个,不允许自造第三种类型; 6. 防涂改规则:禁止填表人在表格边缘空白处自己手画格子乱加项目。 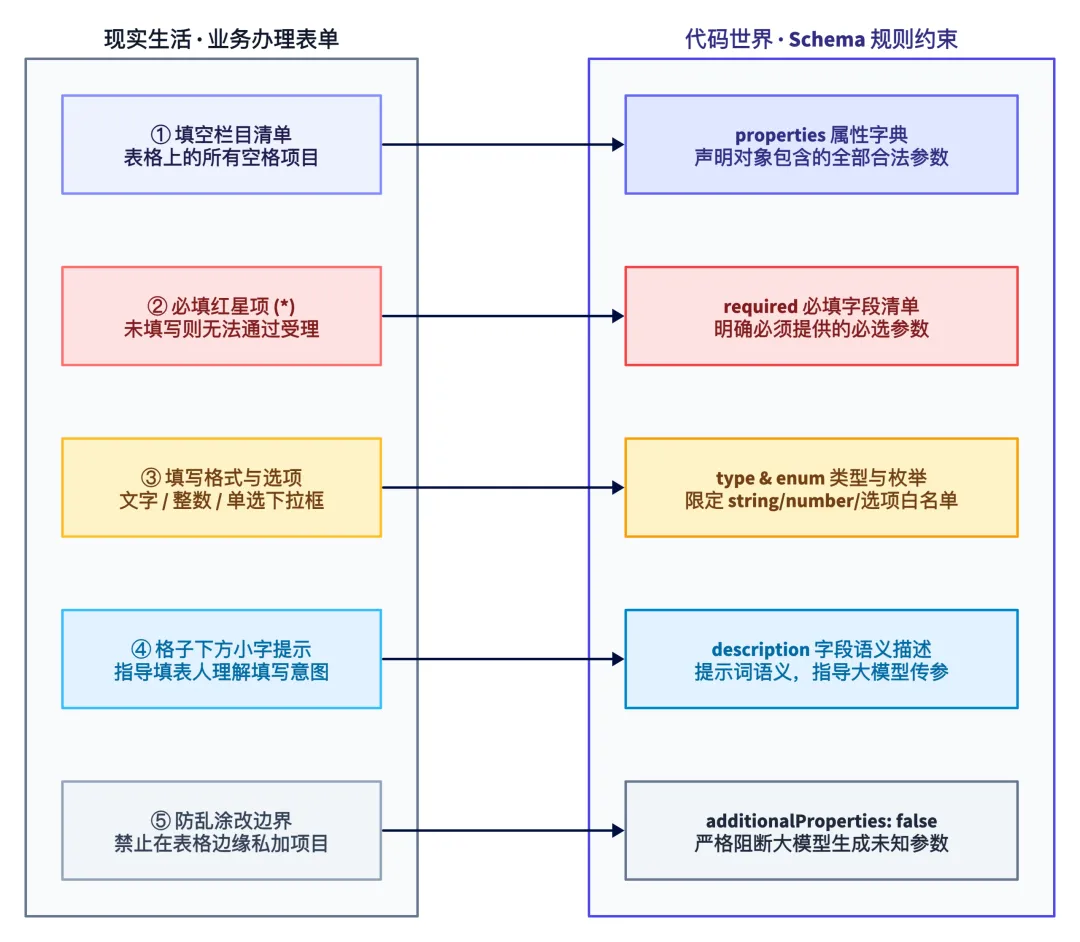
在大语言模型(LLM)与 Agent 系统中,Schema 就是这份给大模型填写的“表单规范”:
• 痛点:大模型本质是一个自然语言概率生成器,如果只告诉它“帮我读文件”,它可能会输出 "我要读 src/index.ts 的前 10 行"、"{ file: 'a.txt' }"或"{ p: 'a.txt', l: 10 }"。这种输出充满不确定性,计算机程序根本无法稳定解析。• 解法:通过一份标准 Schema 告诉模型:“你调用的 read工具只有path、offset、limit三个参数,其中path是必填字符串,另外两个是可选数字”。模型就会受到严格约束,按照结构化的格式生成参数。
二、Schema 的技术定义与核心字段详解
在现代软件工程与各大模型服务商的协议中,Schema 统一遵循 JSON Schema 规范(Draft-07 或 2020-12 标准)。
1. 结构划分:区分“规则字段”与“自定义参数名”
初学者最容易混淆的一点,是分不清哪些词是 Schema 本身的固定语法,哪些词是开发者自己起的名字:
• Schema 自身的“规则词”(核心元字段):由 JSON Schema 官方标准定义,全世界固定统一,如 type、properties、required、description等;• 开发者自定义的“参数名”:由工具的功能决定,如 path、offset、command,叫什么名字完全由工具作者决定。
2. 核心字段速查表
在定义工具参数的顶层对象时,最常用的 8 个核心规则字段如下:
type | stringstring[] | "object"(对象/表单)、"string"(字符串)、"number"(数值)、"integer"(整数)、"boolean"(布尔值)、"array"(数组/列表)、"null"。 | |
properties | Record<string, Schema> | type 为 "object" 时,罗列该对象下所有合法的子属性及其各自的校验规则。每个 key 是参数名,value 是对应的子 Schema。 | |
required | * 必填) | string[] | |
description | string | ||
additionalProperties | booleanSchema | properties 中声明的额外字段。设为 false 可杜绝模型幻觉产生未知参数,也是很多模型开启严格模式(Strict Mode)的硬性要求。 | |
enum | unknown[] | ||
default | unknown | ||
items | SchemaSchema[] | type 为 "array" 时,用来定义数组内部每个元素必须遵循的格式。 |
此外,针对分支与复合逻辑,JSON Schema 提供了组合关键字:
• anyOf:满足给出的任一子规则即可(联合类型 Union);• allOf:必须同时满足所有子规则(交叉类型 Intersection);• oneOf:满足且仅满足其中一项规则(互斥)。
3. 包含全部核心字段的完整 Schema 示例
下面是一个包含上述所有核心元字段的标准 JSON Schema 实例(以一个多功能检索工具的输入参数为例):
{ "type": "object", "description": "多功能内容检索工具输入参数", "properties": { "action": { "type": "string", "description": "执行动作类型", "enum": ["search", "count", "export"], "default": "search" }, "keyword": { "type": "string", "description": "检索关键字", "minLength": 1 }, "limit": { "type": "integer", "description": "返回的最大条数限制", "minimum": 1, "maximum": 100, "default": 10 }, "tags": { "type": "array", "description": "过滤标签集合", "items": { "type": "string", "description": "单个标签名称" } }, "target": { "description": "目标标识,支持字符串名称或整型 ID", "anyOf": [ { "type": "string", "description": "名称标识" }, { "type": "integer", "description": "数字 ID" } ] } }, "required": [ "action", "keyword" ], "additionalProperties":false}三、本项目中 TypeScript 如何生成 Schema
初学者经常有一个疑问:“既然 TypeScript 已经写了 interface,为什么还要大费周章定义一个 Schema?”
1. 核心困境:TypeScript 的“类型擦除”(Type Erasure)
TypeScript 的静态类型系统只存在于编译期。通过 tsc 或 Bun/Node 编译为 JavaScript 之后,所有的 interface、type 定义都会被彻底擦除,不会在编译产物中留下任何运行时数据。
| 代码表现 | interface ReadInput { path: string; limit?: number; } | |
| 运行时状态 |
然而,Agent 系统的工具定义必须在运行时把 JSON Schema 序列化后发给模型,并在收到模型响应后在运行时执行校验。
2. Pi 的工程解法:运行时构建器与 TypeBox
针对这个问题,社区主要有两种思路:
1. 构建期 AST 分析:通过编译器插件在构建阶段扫描 TS 文件生成 JSON 文件。缺点是引入了繁重的编译步骤,动态性差。 2. 运行时构建器模式(Runtime Builder Pattern,Pi 采用):在运行时通过 JS/TS 函数构造 Schema 对象,再利用高级类型系统反向推导出 TypeScript 类型。
Pi 在 packages/ai/src/index.ts 中集成了 TypeBox(@sinclair/typebox),并重导出了 Type、Static 和 TSchema:
export type { Static, TSchema } from "typebox";export { Type } from "typebox";3. 一份代码,双向工作
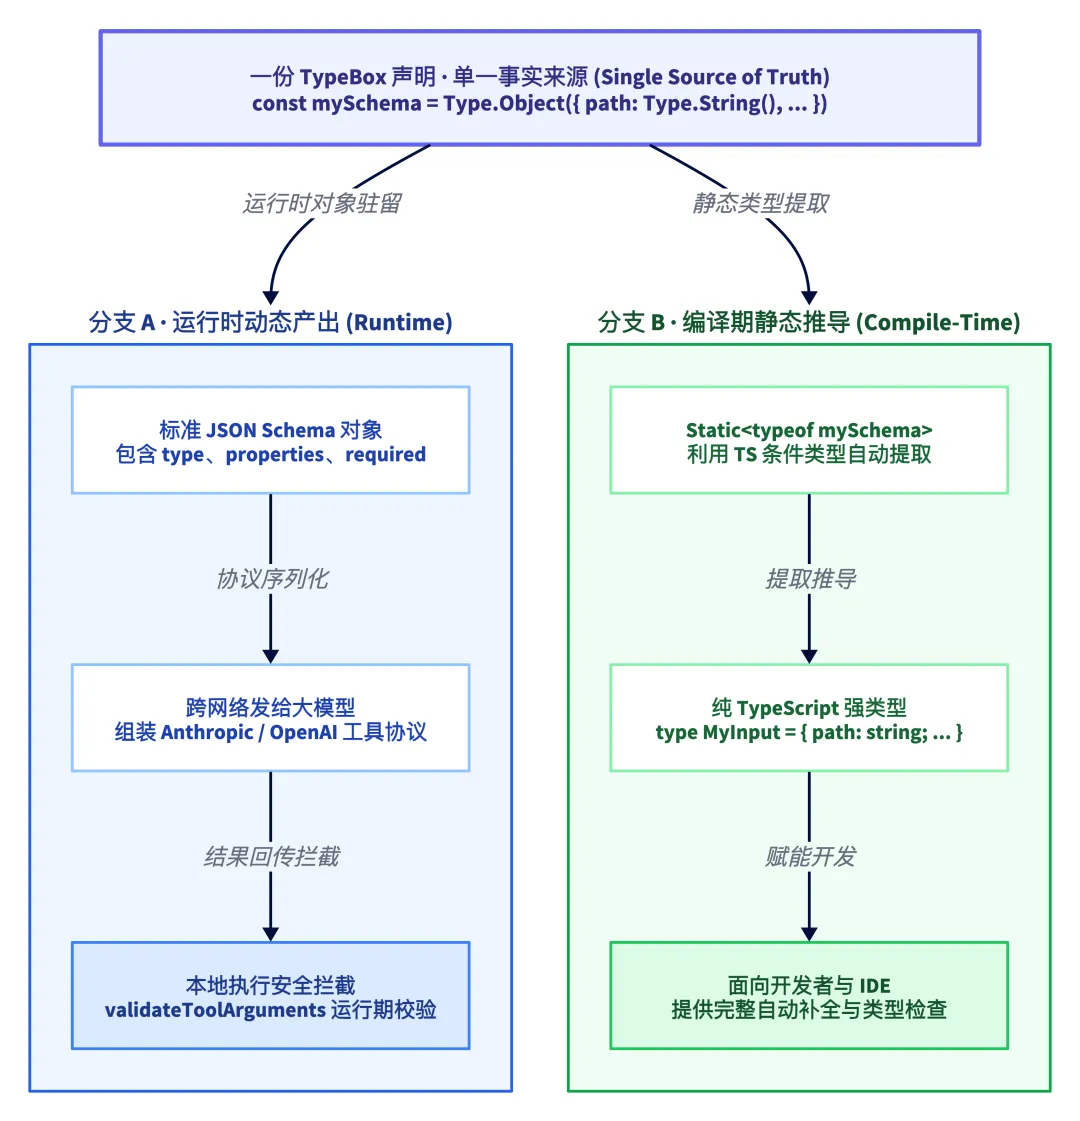
TypeBox 的核心魅力在于单一事实来源(Single Source of Truth):
步骤 1:运行时生成标准 JSON Schema
开发者使用 Type.* 组合出工具参数结构,这在运行时就是一个标准的 JavaScript 对象:
import { Type } from "@earendil-works/pi-ai";export const searchSchema = Type.Object({ keyword: Type.String({ description: "搜索关键词" }), limit: Type.Optional(Type.Integer({ description: "结果条数限制", default: 10 })),});在程序运行时,searchSchema 直接就是一个 JSON 结构:
{ "type": "object", "properties": { "keyword": { "type": "string", "description": "搜索关键词" }, "limit": { "type": "integer", "description": "结果条数限制", "default": 10 } }, "required": ["keyword"]}步骤 2:编译期反向推导静态类型(Static<T>)
开发者不需要再手写一遍 interface SearchInput,直接使用 Static<typeof schema>:
import type { Static } from "@earendil-works/pi-ai";export type SearchInput = Static<typeof searchSchema>;// TypeScript 会自动推导出等价的类型:// type SearchInput = {// keyword: string;// limit?: number;// }步骤 3:在 Extension 中利用 defineTool() 实现全自动泛型推导
在 packages/coding-agent/src/core/extensions/types.ts 中,Pi 提供了 defineTool() 函数:
export function defineTool<TParams extends TSchema, TDetails = unknown, TState = any>( tool: ToolDefinition<TParams, TDetails, TState>,): ToolDefinition<TParams, TDetails, TState> & AnyToolDefinition { return tool as ToolDefinition<TParams, TDetails, TState> & AnyToolDefinition;}借助泛型参数 TParams,execute(toolCallId, params) 中的 params 参数类型会被直接绑定为 Static<TParams>。开发者在编写业务逻辑时,享有完整的代码自动补全与类型检查,完全无需手动做类型断言。
四、以 Pi 的 read 工具为例进行源码走读
我们以 Pi 最基础、最核心的内置工具之一——read 工具为例,追踪 Schema 是如何在真实源码中声明并贯穿运行时的。
1. Schema 声明与类型提取
打开 packages/coding-agent/src/core/tools/read.ts:
import { type Static, Type } from "typebox";// 1. 运行时参数 Schema 定义const readSchema = Type.Object({ path: Type.String({ description: "Path to the file to read (relative or absolute)" }), offset: Type.Optional(Type.Number({ description: "Line number to start reading from (1-indexed)" })), limit: Type.Optional(Type.Number({ description: "Maximum number of lines to read" })),});// 2. 静态 TypeScript 类型推导export type ReadToolInput = Static<typeof readSchema>;分析:
• path是必填的字符串(没有用Type.Optional包裹,会自动被放入required列表);• offset和limit使用了Type.Optional(),表示模型可传可不传;• 每个字段都配备了简短、精准的 description,告诉模型起始行号从 1 开始算(1-indexed)。
2. 注入工具定义
继续查看 packages/coding-agent/src/core/tools/read.ts 中的工具工厂:
export function createReadToolDefinition( cwd: string, options?: ReadToolOptions,): ToolDefinition<typeof readSchema, ReadToolDetails | undefined> { return { name: "read", label: "read", description: `Read the contents of a file. Supports text files and images...`, promptSnippet: readToolSystemPromptContribution.snippet, promptGuidelines: [...readToolSystemPromptContribution.guidelines], parameters: readSchema, // <── 传入 Schema constrainedSampling: { type: "json_schema", strict: "prefer" }, async execute( _toolCallId, { path, offset, limit }: { path: string; offset?: number; limit?: number }, signal?: AbortSignal, _onUpdate?, ctx?: ExtensionContext,) { // 具体读取文件、裁切行数、处理图片的业务逻辑... } };}在这里:
• parameters: readSchema:将这份数据契约与工具绑定;• constrainedSampling: { type: "json_schema", strict: "prefer" }:向模型服务商申请开启结构化受限采样(若模型支持);• execute的入参解构{ path, offset, limit }完全契合ReadToolInput的类型结构。
五、在当前项目中,Schema 的作用是什么?主要哪些场景使用它?
在 Pi 项目中,Schema 绝不仅用于“生成类型代码”。它是系统运行时的中枢神经与安全网关,串联起了从 API 请求组装到本地执行保护的全过程。
主要涵盖以下四大核心应用场景:
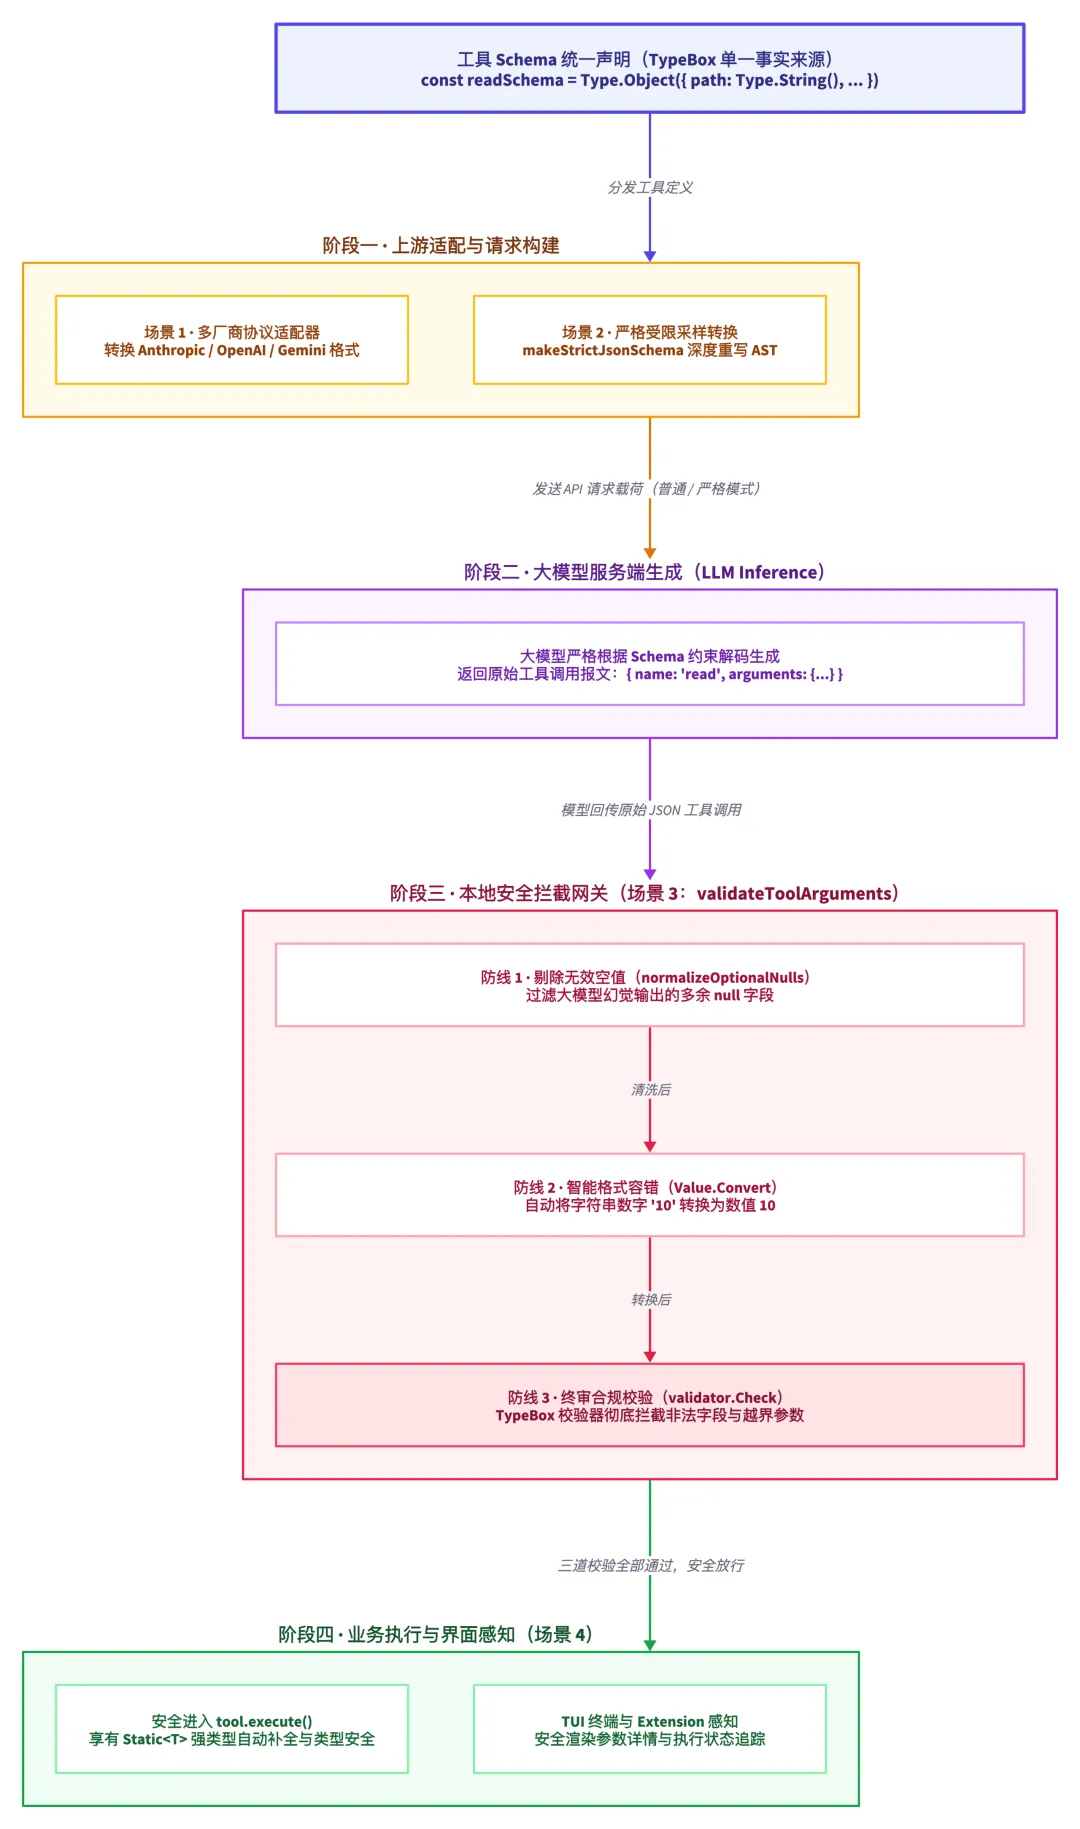
场景 1:各 LLM 服务商原生 API 调用的参数声明
不同的模型提供商对于 Function Calling 的请求协议定义各不相同,Pi 的统一架构(packages/ai)负责将 Tool.parameters 翻译成各家的原生格式:
• Anthropic Messages API:在 packages/ai/src/api/anthropic-messages.ts,映射为tools[i].input_schema;• OpenAI Completions / Responses:在 packages/ai/src/api/openai-completions.ts,映射为tools[i].function.parameters;• Google Generative AI (Gemini):在 packages/ai/src/api/google-shared.ts,经由sanitizeForOpenApi()转换为 Gemini 的parametersSchema;• AWS Bedrock (Converse API):在 packages/ai/src/api/bedrock-converse-stream.ts,映射为toolSpec.inputSchema.json。
通过 Schema,大模型在服务端的解码阶段就能明确知道需要生成哪些参数字段。
场景 2:受限采样与严格模式转换(Strict Constrained Sampling)
像 OpenAI 结构化输出(Structured Outputs,即 strict: true)对 JSON Schema 的语法提出了极其严苛的限制:
• 不能包含未支持的高级键(如 $ref,patternProperties);• 对象的 additionalProperties必须显式为false;• 所有的 properties 都必须进入 required数组;• 可选字段必须转换为联合类型,显式允许 null(即anyOf: [schema, { type: "null" }])。
Pi 在 packages/ai/src/api/constrained-sampling.ts 中实现了 makeStrictJsonSchema():
export function makeStrictJsonSchema(schema: Tool["parameters"]): Record<string, unknown> { const cloned: unknown = structuredClone(schema); if (!isJsonSchemaObject(cloned)) { throw new UnsupportedStrictJsonSchemaError("root schema must have type object"); } makeJsonSchemaNodeStrict(cloned); return cloned;}它递归遍历开发者编写的普通 Schema,自动补充 additionalProperties: false,并将非必填字段统一改写为与 { type: "null" } 的联合,使开发者的工具 Schema 能无缝运行在严格受限采样的模型上。
场景 3:本地工具调用的前置拦截、容错纠偏与安全校验
这是保障系统安全与鲁棒性最关键的一环。永远不要无条件信任大模型生成的参数。
当模型生成工具调用返回给 Pi 时,在正式进入 tool.execute() 执行前,Pi 会在 packages/ai/src/utils/validation.ts 的 validateToolArguments() 中设置“三重安检”:
export function validateToolArguments(tool: Tool, toolCall: ToolCall): any { const args = structuredClone(toolCall.arguments); // 第一重安检:清理空值 normalizeOptionalNulls(args, tool.parameters as JsonSchemaObject); // 第二重安检:容错转换(Coercion) Value.Convert(tool.parameters, args); const validator = getValidator(tool.parameters); // ...处理非 TypeBox 原生 schema 容错... // 第三重安检:严格模式校验 if (validator.Check(args)) { return args; } // 校验失败:格式化错误提示,阻止执行并抛出异常 const errors = validator .Errors(args) .map((error) => ` - ${formatValidationPath(error)}: ${error.message}`) .join("\n") || "Unknown validation error"; throw new Error(`Validation failed for tool "${toolCall.name}":\n${errors}\n\nReceived arguments:\n${JSON.stringify(toolCall.arguments, null, 2)}`);}这三重安检的精妙之处在于:
1. 清理空值( normalizeOptionalNulls):部分模型在省略可选字段时会输出"offset": null,若直接校验会报错,Pi 自动识别非必填项并将null剔除;2. 容错转换( Value.Convert):针对一些较弱的量化模型,可能会输出"offset": "10"(把数字输出成了字符串)。TypeBox 的转换器会根据 Schema 自动将其安全纠正为数值10;3. 拦截与错误回灌:如果参数严重不合规(比如漏填必填的 path,或者类型完全无法转换),Pi 会立即阻断执行,并将清晰的校验失败信息作为工具结果回灌给模型(促使模型根据错误提示自动纠正重试),而不会让非法参数进入系统底层破坏运行环境。
场景 4:Extension 开发者体验与交互界面渲染
• 扩展生态:在 .pi/extensions/或独立插件中,第三方开发者无需阅读 Pi 内部繁杂的请求封装,只要声明一个包含parameters的对象,就能保证工具安全可靠地融入 Agent Loop。• TUI 界面渲染:在 packages/coding-agent/src/core/extensions/types.ts中,工具的renderCall回调可以直接拿到强类型的参数对象args: Static<TParams>,在终端界面上安全、美观地打印出正在执行的文件路径或命令。
六、总结
在 Pi 的整体架构中,Schema 不仅仅是一段数据格式描述,它是非确定性 AI 认知世界与确定性本地软件世界之间的契约界碑:
1. 向上对齐模型:向各大 Provider 的原生 Function Calling API 提供标准 JSON 规格,并经由 makeStrictJsonSchema支持严格受限采样;2. 向下保护系统:通过 validateToolArguments与 TypeBox 校验器,完成清理空值、自动容错与非法阻断;3. 横向赋能工程:借助 TypeBox 的 Static<T>实现单一事实来源,让 TypeScript 静态类型推导与运行时 Schema 无缝统一。