ARTICLE · 1137641
超节点方案重塑AI算力产业趋势,开启系统级算力新周期
1. 全球算力需求激增:AI 应用升级与基础设施扩张形成共振
1.1. 前沿模型与 Agent 化应用升级推动算力需求持续攀升
前沿模型迭代与应用升级正推动 AI 工作负载加重,全球算力需求持续攀升。近期, GPT-5.5、DeepSeek V4 几乎同期上线,突破百万 Token 长上下文能力,可处理多步骤推 理、长文档理解及多轮交互等复杂任务,使单次推理可覆盖数百页文档信息。这些功能 升级背后,需要大量训练算力的投入,成为推动算力需求持续增长的重要因素。当前模 型升级的趋势已从“更会回答”转向“更会处理复杂任务”,算力消耗激增不仅源于模型 参数扩张,更受推理阶段任务复杂度影响。单任务计算量、显存占用及数据传输均显著 增加,从而提升了整体算力负载。Token 是大模型处理语言的基本单位,模型所有输入 与输出均以 Token 计量,其数量直接决定计算量——上下文越长、任务越复杂,Token 消耗越高。援引高盛预测数据,随着消费端和企业端 AI Agent 加速普及,全球 Token 消 耗量将从 2026 年的约 5 千万亿 token/月增长至 2030 年的 120 千万亿 token/月,四年增 长约 24 倍,CAGR 约 121%。
AI Agent 应用快速扩张和多模态任务激增,推动推理算力需求激增成为算力需求 增长的核心引擎。Agent 具有任务拆解、工具调用、多轮反思与自主执行等特性,让单 次指令的推理链条变长、调用层数增加、上下文持续累积。结合多模态交互能力,单个 任务往往需要跨模态信息融合与复杂推理,导致 Token 调用量呈指数级增长,形成“用 量乘数效应”,进一步放大推理算力需求。据 IDC 预测,2027 年推理算力在智能算力总 需求中的占比将超过 70%,推理算力需求将接棒成为主引擎。
1.2. 海外厂商持续扩建 AI 基础设施,算力供给进入加速释放阶段
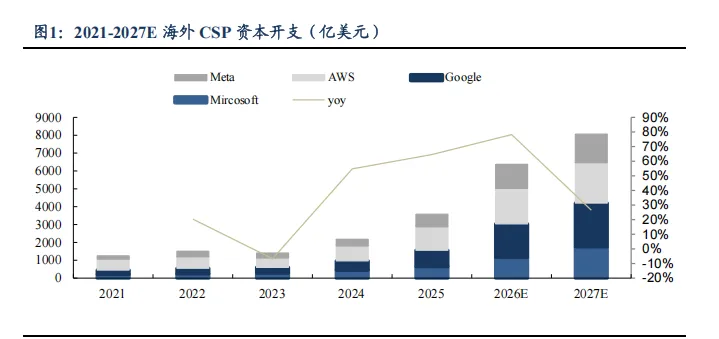
海外云厂商加码资本开支,验证算力需求持续性。算力需求的爆发式增长远超市场 预期,但当前算力供给存在短期瓶颈,受硬件、架构及资源调度等多重因素制约,短期 内难以快速匹配需求增长。海外头部云厂商正在加速算力供给以应对需求压力,资本投 入持续上升成为直接验证。2025 年,Alphabet 关于服务器、网络设备和数据中心等技术 基础设施支出 914 亿美元,公司预计 2026 年将增至 1800 亿美元左右;Meta 将 2026 年 资本开支指引由 1,150 亿-1,350 亿美元上调至 1,300 亿-1,450 亿美元,多家 hyperscaler 几 乎同步加码 AI 服务器与数据中心基础设施,表明全球 AI 正由技术验证加速迈向生产级 部署,算力需求仍处于高景气上行区间,进一步支撑算力产业的持续增长预期。
2. 国产算力需求:国内 AI 应用放量推动国产算力需求释放
国产算力需求与基础设施建设同步提速,产业进入加速发展阶段。一方面,以 DeepSeek V4 为例的一众国产大模型不断升级,加速进入商业化规模化应用,带动训练 与推理负载同步提升。据国家统计局数据,到今年 3 月份,日均 Token 调用量突破 140 万亿,比上年末增长超 40%。另一方面,虽然当前全球高端 AI 算力仍高度依赖 NVIDIA 等海外厂商,但 AI 芯片同时受到出口管制、供应链限制及地缘政策等因素影响,海外 算力供给存在不确定性,促使国内算力产业在高端芯片、服务器及自主生态建设方面具 备更强的国产替代需求,也进一步推动本土 AI 算力体系加速发展。在需求扩张与自主 可控趋势推动下,国内算力基础设施已进入加速建设阶段,智能算力规模持续扩张。国 家数据局披露,截至 2026 年 3 月底,全国智能算力总规模已达 188 万 PFLOPS(FP16), 其中八大国家算力枢纽节点占比超过 80%。“东数西算”等全国一体化算力网络建设也 在持续推进,通过跨区域资源调度优化算力布局,缓解区域性供需错配问题。且根据 IDC 预测,2026-2028 年中国的智能算力规模仍将维持约 40%的年均增速,智能算力在整体 算力市场中的占比有望进一步提升,中国 AI 算力产业增长空间仍具备较强释放潜力。
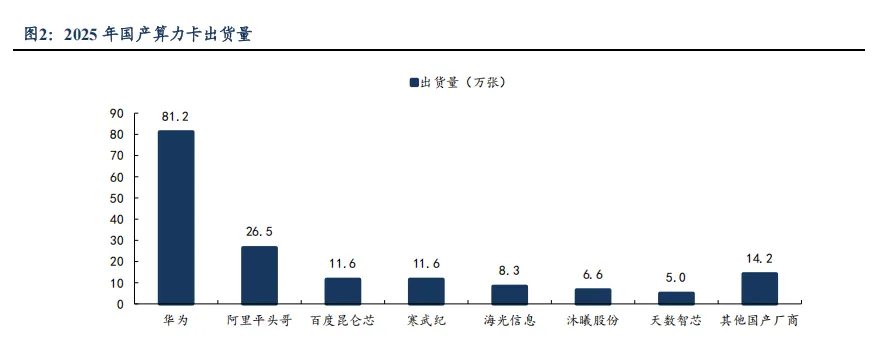
国产算力需求的主要矛盾正在由“缺卡”转向“高效用卡”,系统组织能力成为关键。 算力卡,即 AI 加速卡,以 GPU、ASIC 及相关异构芯片为主要形态,是承载大模型训练 与推理任务的核心硬件载体,通过提供高并行计算能力,支撑大规模参数模型的迭代与 部署。根据 IDC 的数据显示,2025 年中国市场的 AI 加速卡出货量约为 400 万张,其中 国产算力卡出货量约为 165 万张,市场份额约为 41%。国产加速卡供给缺口逐步缓解, 但应用端仍存突出问题:单卡层面,据中国电子技术标准化研究院测试显示,国产 GPU 实际可用算力约为标称值的 50-70%,还面临着功耗大与生态成熟度不足等问题。单纯 粗放堆卡已无法匹配复杂算力需求,需转向系统级优化。
3. 算力集群演进:算力集群形态与算力需求演进高度同步演化
随着大模型计算复杂度持续提升,传统算力集群的效率瓶颈逐步显现。在通用计算 阶段,算力供给以 CPU 为核心,节点间协同程度有限,主要依赖单机或小规模集群满 足基础计算需求。随着深度学习模型规模扩张及 Transformer 架构普及,GPU 逐步成为 算力核心,系统演进为多 GPU 协同的 Scale Out 集群架构。在该架构下,GPU 通过 NVLink 实现机内高速互联,跨节点则依赖 InfiniBand 等网络协议进行通信。然而,随着千亿级 甚至万亿级模型训练普及,以及张量并行、专家并行与序列并行等多维并行方式的广泛 应用,跨节点通信频率与数据规模显著上升,大规模梯度同步和 All-to-All 通信开销持 续上升,通信延迟与带宽拥塞逐步成为制约有效算力释放的核心瓶颈,并进一步向功耗、 散热及运维复杂度等系统层面传导。传统横向扩展模式已难以匹配高频通信与大规模并 行计算需求,算力集群开始从以服务器为核心的松耦合架构,向更高密度、更强协同的 一体化计算单元演进。
4. 超节点:国产算力需求的破局之策
4.1. 超节点架构加速规模化落地,推动国产 AI 集群向高密度协同演进
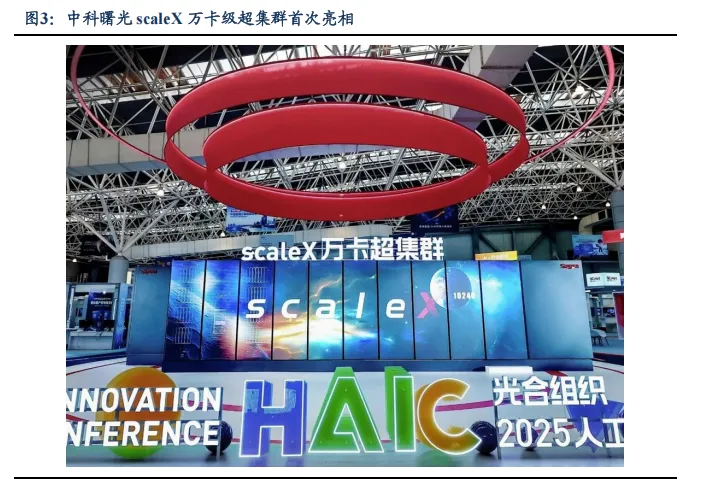
超节点架构正成为国产 AI 算力突破通信瓶颈、促进有效算力释放的核心演进方向。 超节点的核心定义是以高带宽域为边界的大规模 Scale Up 计算单元,通过高速互联协 议、交换节点、统一寻址访存机制及系统调度,将数十至数百个计算模组组织成低时延、 高带宽、可编排的逻辑计算体。其核心价值并非单纯增加卡数,而是缩短高频通信路径、 降低同步开销,实现峰值算力向有效吞吐的转化。超节点架构在产业端形成规模化落地, 成为新一代国产智算集群的发展重心,国内厂商积极布局:华为昇腾384、阿里磐久128、 百度天池 512 等超节点架构均实现“百卡级”超节点架构突破。2025 年 12 月,中科曙 光 scaleX 万卡超集群首次亮相。2026 年 2 月 5 日,3 套 scaleX 万卡超集群系统在国家超算互联网郑州核心节点同步上线,建成全国首个部署 3 万张国产 AI 加速卡的算力池。
在 2026 数字中国建设峰会上,华为称昇腾 384 已部署超 500 套,实现规模化商用,标 志着国产 AI 基础设施正从传统分布式集群向高密度系统级算力架构加速演进。
超节点打破传统服务器物理边界,重构产业协同创新的算力新范式。超节点作为系 统级创新架构,通过极致的内部高速互联与全栈协同设计,从底层架构破局,实现大规 模资源紧密耦合与高效协同。有效解决传统服务器集群在大模型训练中面临的通信墙、 功耗墙和复杂度墙三大技术瓶颈:传统集群通常采用以太网或 PCIe 组网,供电与散热 相对分散,计算节点呈松散堆叠形态,导致延迟高、带宽不足、散热受限、部署运维复 杂,超节点则通过柜内高速互联、原生液冷、集中供电与统一管理,大幅提升通信效率、 降低能耗、简化调度。超节点架构能通过物理与逻辑层面的深度紧耦合,实现算力集群 的效率跃升,从而支撑并行计算任务,加速 GPU 间的参数交换和数据同步,重构 AI 算 力基础设施的基本范式。