ARTICLE · 1137643
从文档到本体再到知识图谱:我们如何构建这条流水线
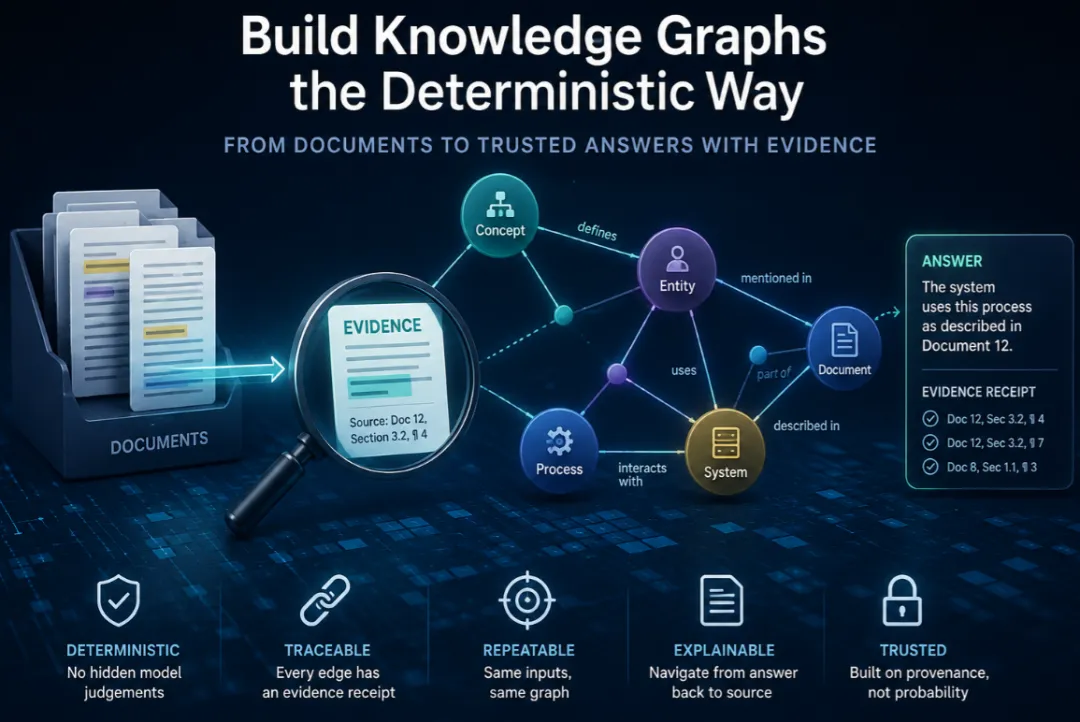
将企业文档转化为可溯源、可导航的知识层
在之前的文章中,我们了解了如何在不让 LLM 凭空"发明"企业语义的前提下,从企业文档中构建本体。本体为我们提供了受控词表,更重要的是,它保留了支撑每个概念的证据。
但本体只解决了问题的一部分。
我们真正想构建的是一条流水线:它能处理数千份企业文档,识别出有意义的概念,把这些概念在整个文档集合中连接起来,并且让每一个结果都能回溯到其来源。
本体给了我们语义层:概念的含义是什么,以及企业是如何谈论这些概念的。
而知识图谱将提供导航层:这些概念出现在哪里、它们与什么相连,以及哪些源文档段落支撑着这些连接。
下一步就是知识图谱。
构建图谱的"显而易见"的方式,制造了另一个问题
一旦确定需要图谱,最显而易见的架构就是把文档再处理一遍:抽取实体、推断关系、构建节点和边。
这个方案看起来很合理,直到我们意识到它意味着什么:我们在让两条流水线各自独立地解读同一批文档。
本体可能认定段落 A、B、C 确立了一个概念;图谱流水线可能认定 B、D、E 描述了围绕它的关系。如果两边都有 LLM 参与,我们就得到了对同一企业知识的两个概率性解读。
如果它们不一致,系统该信任哪一种解读?
文档在构建本体的过程中已经被解读过一次了,我们不想再做第二次解读。
证据层成为了"契约"
幸运的是,本体工作已经给我们留下了一样有用的东西:一个证据层。
每份文档都被拆解为若干小型证据记录,每条记录携带其文档版本、标题路径、位置、重要术语、可能的关系信号,以及一个稳定的证据 ID。本体在提炼出业务概念时,保留了这些证据 ID。
因此,我们不是从原始文档独立构建图谱,而是用同一份证据来构建图谱。
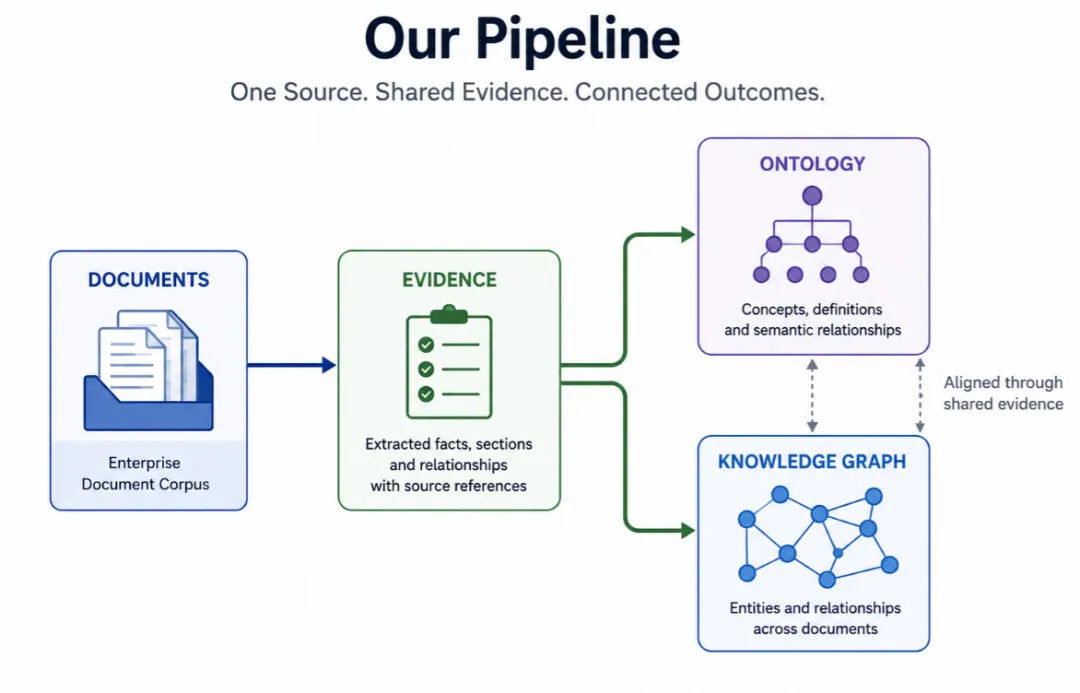
这是关键性的架构决策。证据成为了共享契约:本体用它来确定含义;图谱用它来确定导航路径。
从证据到可导航的地图
一旦证据层就绪,构建图谱就变成了一系列确定性的步骤。
图谱构建器首先根据证据中已保存的位置信息,重建文档层级结构:
文档 → 章节 → 证据片段
这些成为图中的第一批节点,保留了每一条信息的原始出处。
接下来,我们把证据中有用的信息转化为图的节点。
图中只包含少量几种节点类型:
Document(文档) —— 源文档及其版本Section(章节) —— 信息在文档中出现的位置Evidence(证据) —— 精确的源材料片段Subject(主语/主题) —— 跨文档被提及的规范化术语或实体Concept(概念) —— 由本体定义的业务概念
一个重要的区分是:我们并不会把整份文档复制进图谱。图谱只存储导航知识所需的结构、标识和引用。
现在我们来创建边(关系):
Document → CONTAINS → SectionSection → CONTAINS → EvidenceEvidence → MENTIONS → SubjectSubject → RELATES_TO → SubjectConcept → SUPPORTED_BY → Evidence
结构性边直接来自文档的位置信息。语义关系只有在端点可以解析、且存储的证据足够强时才会被添加。
如果一条关系无法被有把握地确立,我们就把它保留为未解析的引用,而不是把不确定性硬变成图谱中的"事实"。
这是最重要的部分。
本体中的每个概念已经包含了支撑它的证据 ID,而这些证据记录现在已经是图中的节点了。
所以概念链接器既不需要相似度搜索,也不需要再调用一次 LLM:
Concept → 证据 ID → Evidence → Section → Document
本体与图谱因此通过一个精确的证据引用连接在一起,而不是又一次语义上的近似匹配。
最后,我们持久化存储节点、边以及遍历所需的索引。
每个图记录至少保留其稳定 ID、类型、来源/证据引用以及相关元数据。边则保留端点、关系类型和溯源信息。
这使得查询层在遍历图谱的同时,仍然能够回溯到原始来源。
当图谱说某份文档支持某个概念时,它因此可以指向最初帮助确立该概念的确切源位置。
Python 流水线刻意保持简单
这条用 Python 实现的流水线是确定性的,并且"乏味"得刻意为之:
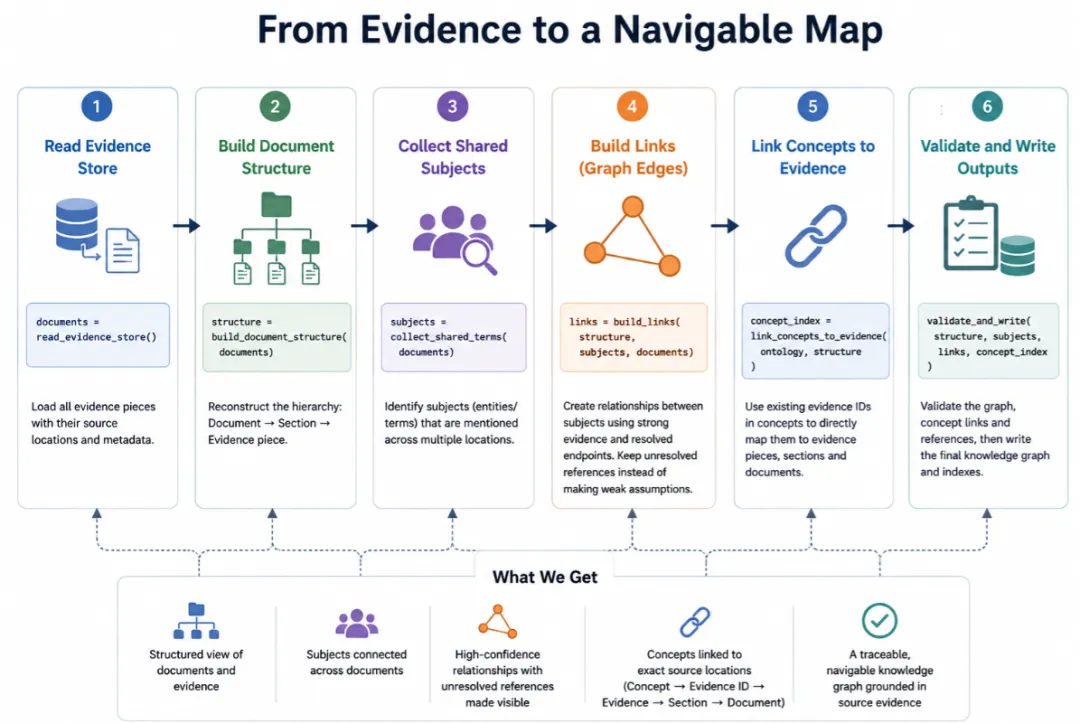
有趣的部分并不在于 Python 代码本身,而在于各个阶段之间的契约。结构来自已保存的文档位置;概念链接来自已有的证据 ID;关系来自先前捕获的信号,只有在通过校验后才会被提升为正式关系。
给定相同的证据存储和本体,这条流水线会生成相同的图谱。
当有人提问时,这一切带来了什么改变
假设有人问:"如果客户身份(Customer Identity)发生变化,会波及什么?"
系统首先将这个问题对齐到本体中的"客户身份"概念。它的证据 ID 把我们带入图谱,在那里我们可以遍历到支撑证据、相关主题、需求、章节和文档。
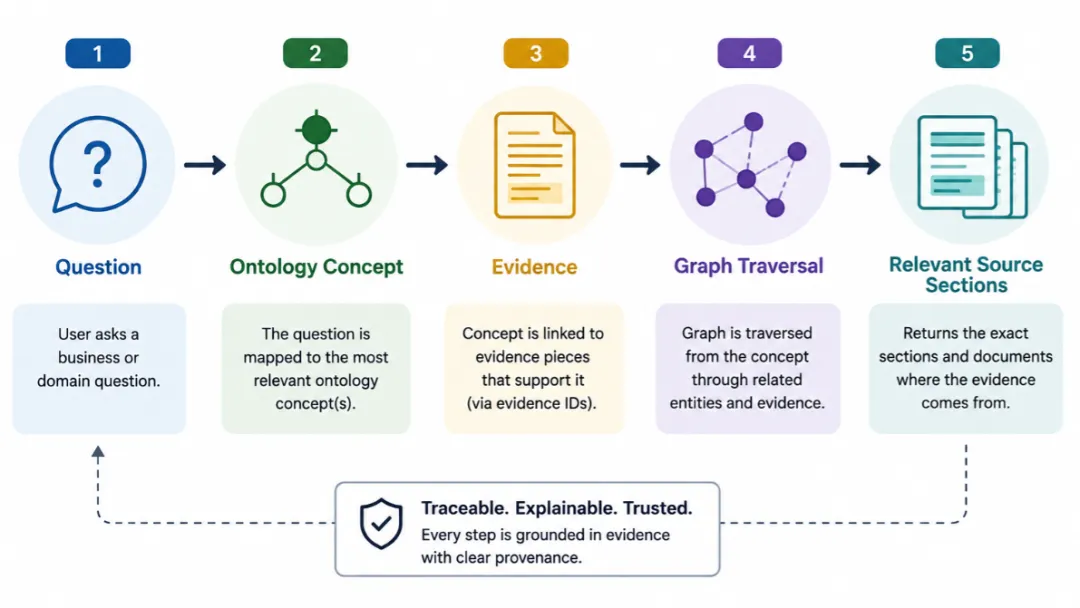
只有这些聚焦后的材料需要展示给人,或者传给 AI 助手。
这就是为什么我把图谱看作上下文工程(context engineering)的一部分。它并不会让 LLM 变得更聪明,但它让我们能够控制什么样的上下文送达模型,更重要的是,让我们知道为什么选中了这些上下文。
每一条关系都应该有一张"收据"
这种可重复性给了我们比"可复现"更重要的东西:溯源(provenance)。
一条结构性链接的存在,是因为有一个文档地址;一条主题链接的存在,是因为某个术语出现在一条证据记录中;一条关系的存在,是因为一个已存储的信号通过了必需的检查;一条概念链接的存在,是因为本体保留了支撑它的证据。
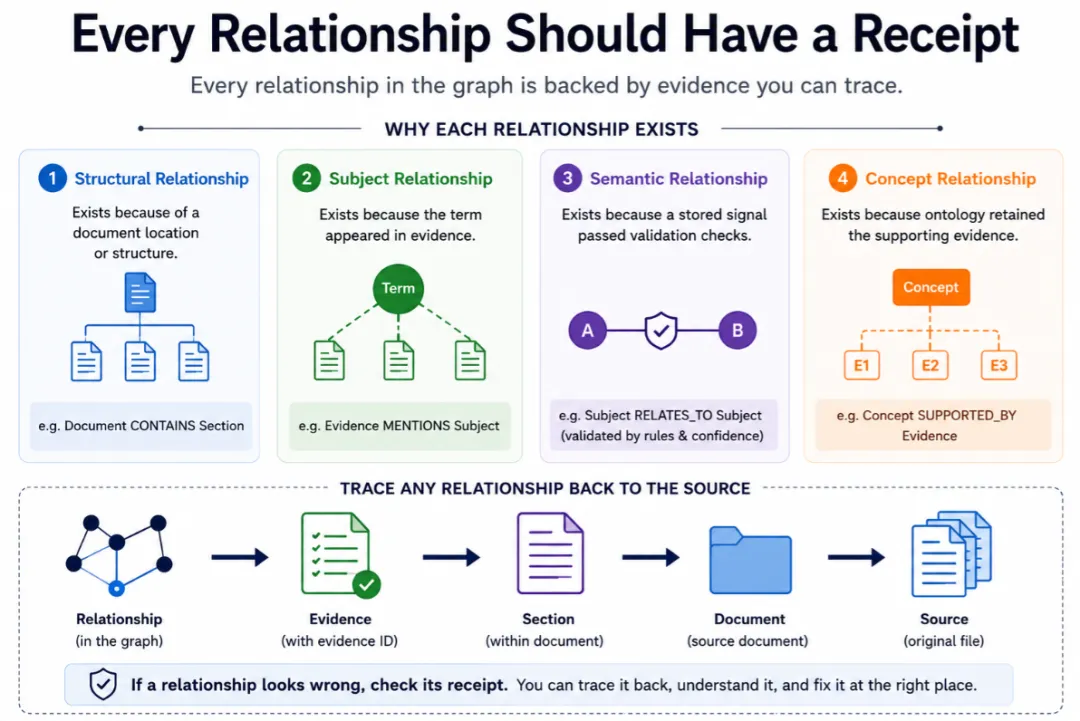
如果有什么发生了变化,我们可以把变化追溯到文档、证据或本体,而不必疑惑"模型是不是又换了个判断"。
这也改变了我们处理错误的方式。如果某条关系看起来不对,我们不必去问"模型为什么生成了这个?",而是可以检查产生它的证据,判断问题究竟出在源文档、早期的语义抽取,还是提升该关系的规则上。
图谱不仅告诉我们什么与什么相连,它还能展示我们为什么相信这个连接存在。
这就是我所说的"给每条边一张收据"。
更大的启示
我们从一个知识图谱问题出发,但更重要的架构决策,是避免对文档进行第二次解读。
如果本体和图谱各自独立地从同一批文档生成,它们就会漂移(drift)。如果两者都扎根于同一份证据,它们之间的关系就变得可检查、可审计。
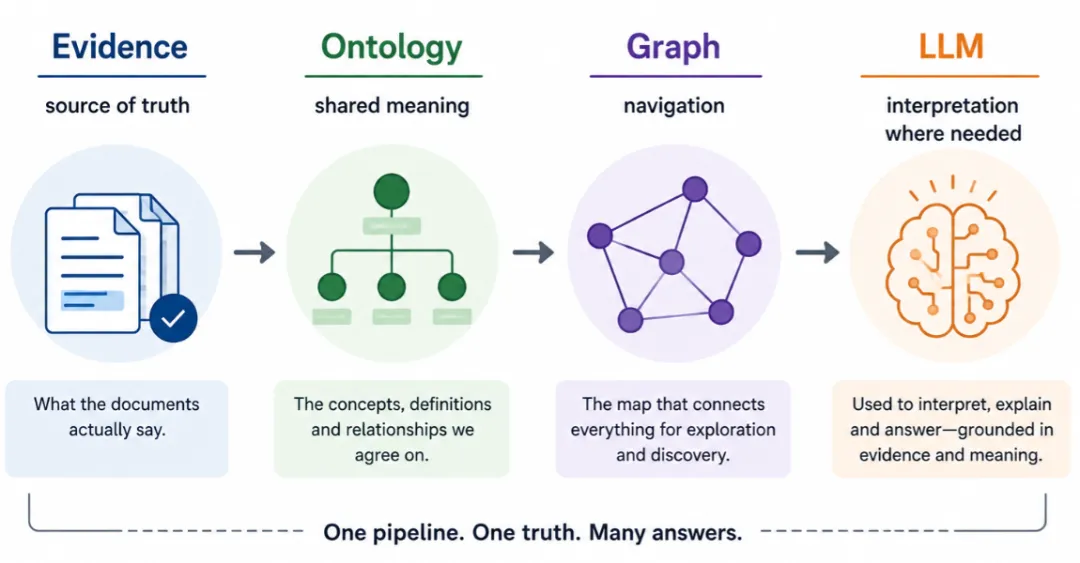
我们的目标从来不只是"从文档集合中画出一张图",而是帮助人和 AI 系统以一条清晰的路径回溯到源头的方式,抵达正确的知识。
本体赋予系统共享的含义,图谱赋予系统一张地图,而证据让两者都值得信任。