ARTICLE · 1137646
测灵智测平台-需求文档功能介绍
同一段需求,机器读到的形态和你写的不一样
你给 AI 一份需求,让它出测试点。它返回得又快又整齐,模块分好了,功能点列全了,连字段都替你补了几条。
你扫一眼,觉得哪里不对,但说不上来。
上线之后有人问:「订单状态为空的订单能不能删?」你才想起来 —— 这条需求里从来没写过。而它,也没问。
AI 读需求最危险的地方,不是读错
是用编造把空缺填满。
一段需求里没规定的字段规则,被写进测试点,变成用例里的一条断言,最后在测试报告上显示「验证通过」—— 通过的是一个从来不存在的规定。这种错误不报错、不告警,它会一路走到线上。
所以这篇要讲的不是「AI 怎么读需求」,是它读到没有的地方,怎么办。
一、它先产出的不是文档,是一份「理解」
这个平台上,「生成需求文档」不是一步 —— 前面还有一步单独跑:需求理解。
输入是一段需求描述(或者从页面上采集来的资料),输出不是一篇文章,是一份有固定形状的结构:
• 模块 —— 需求覆盖了哪几块 • 功能点 —— 每个功能点带两样东西:预期交互(列表查询 / 新增 / 预览…)和关键字段 • 业务流程 —— 步骤序列,以及每一步牵涉到哪几个功能点 • 关键字段 —— 类型、是否必填、取值范围 • 业务规则 —— 每条规则标出出处,以及它属于哪个功能点 • 待确认问题 —— 见下一节
先有这份结构,再有文档。 因为下游要的不是一篇能读的文章,是能取用的东西:用例生成的三个阶段要按功能点和字段去找覆盖,知识库同步要把它们抽成知识点。直接吐一篇 markdown,后面这些都得重新解析一遍。
二、找不到根据的地方,它列成问题,不写成句子
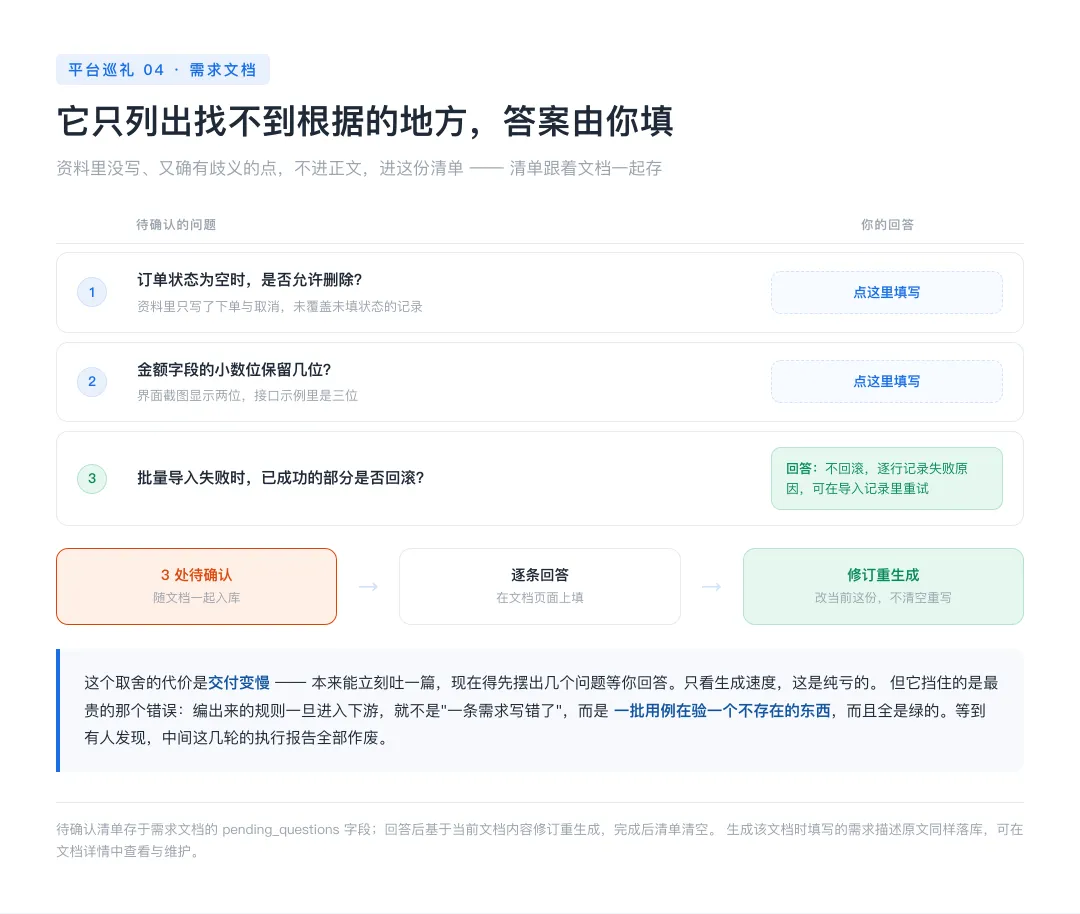
图 1:它只列出找不到根据的地方,答案由你填
需求理解里有一个字段专门装这件事:待确认问题。凡是资料里找不到根据、或者有歧义的点,不进正文,进这份清单。
清单跟着文档一起存下来。你在页面上逐条回答,提交之后 基于当前这份文档修订重生成 —— 不是从头再写一遍,是拿你现在看到的内容改。答完,清单清空。
这个取舍值得说清楚:
它让交付变慢了。 一份需求进来,本来能立刻吐一篇,现在得先摆出几个问题等你回答。只看「生成速度」,这是纯亏的。
但它挡住了那个最贵的错误。 编出来的规则一旦进入下游,就不是「一条需求写错了」,是一批用例在验一个不存在的东西,而且全是绿的。等到有人发现,中间这几轮的执行报告全部作废。
需求本来就含糊,这不是 AI 的问题。平台能做的不是把含糊猜对,是把含糊显式化 —— 从「文档里看不出来」变成「清单上写着第 3 条待确认」。
顺带一个变化:你生成这份文档时填的需求描述原文,也落库了。以前它只活在创建弹窗的输入框里,生成完就丢,页面一刷新无从追溯;现在文档详情里能看能改,用例生成时也会拿它去定位相关内容。
三、几份资料合到一起,先归一结构
从浏览器扩展采集回来的是一份份页面资料。如果一次采集覆盖多个模块,这就不是「合并几段文字」那么简单。
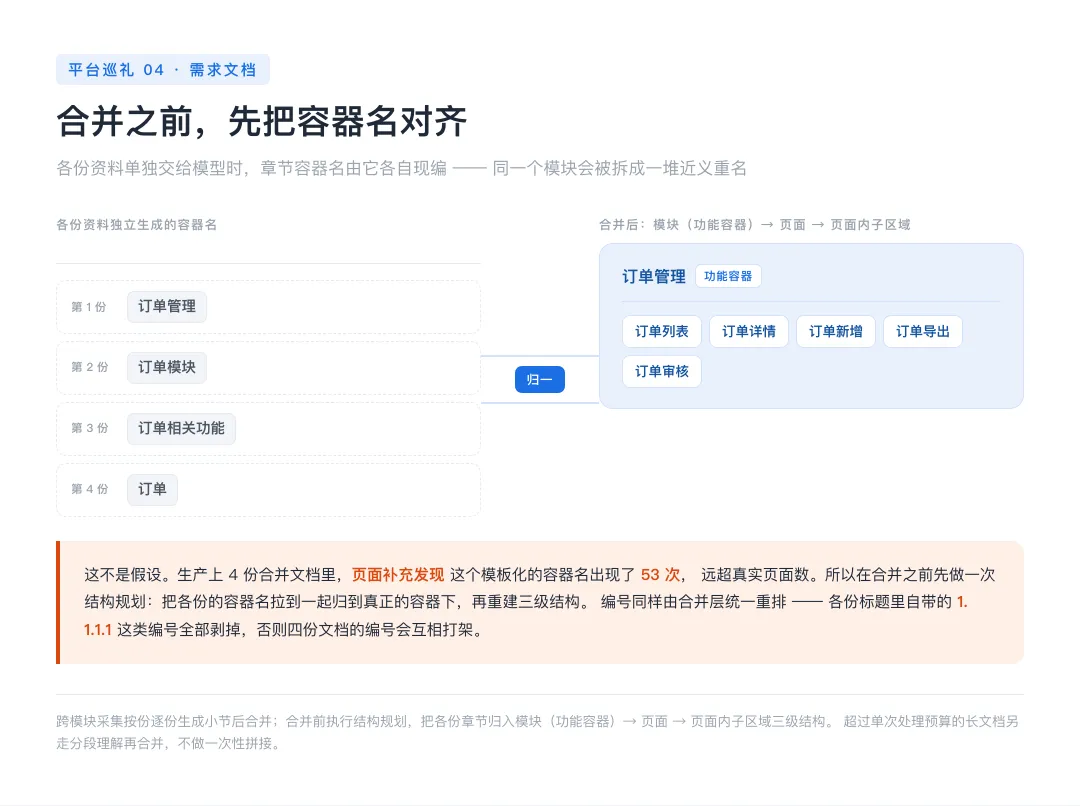
图 2:同一个模块,被各份资料各自编出了不同的名字
问题出在逐份生成。 每一份单独交给模型,是让它自己组织章节结构 —— 于是同一个「订单管理」,第一份里叫「订单管理」,第二份里叫「订单模块」,第三份叫「订单相关功能」,第四份干脆叫「订单」。四份合起来,读者会以为这是四块不同的东西。
这不是假设。生产上的 4 份合并文档里,### 页面补充发现 这个模板化的容器名出现了 53 次 —— 远超真实页面数。
做法是合并前先做一次结构规划:把所有份的容器名拉到一起,归到真正的「模块 / 功能容器」下,再重建三级结构 —— 模块(功能容器)→ 页面 → 页面内子区域。编号由合并层统一重排,各份标题里自带的 ## 1.### 1.1.1 全部剥掉,否则四份文档的编号会互相打架。
还有一条不写在界面上的约束:长文档不硬拼。 超过单次处理预算就走分段理解再合并,避免大输入把模型预算吃光、返回一个空结果。这既是成本考虑,也是稳定性考虑。
四、对你的价值
第一条:需求变更变成增量的。 迭代需求是独立完整的文档,不注入主需求做基准 —— 主需求那份保持原样,迭代挂在它下面。回头看的时候,「当时为什么这么定」有据可查。
第二条:待确认清单本身就是交接材料。 需求评审会上最耗时间的,是「这里到底什么意思」来回确认。清单把这些提前摆出来了 —— 而且写明是在资料里找不到根据,不是随口一问。
第三条:文档不是终点,是源头。 一份需求文档生成完,它的功能点、字段、规则会同步进知识库、会被用例生成的三阶段取用、会算出关联用例数。你补一条规则,下游好几个地方跟着变 —— 这也正是前面那两条取舍值得的原因:源头脏一点,下游全脏。
下一篇讲 UI 元素库:同名元素那一类问题,靠什么区分。想在自己的系统上试一遍,欢迎在公众号后台留言,或发邮件到 clzc_ai2026@qq.com。