ARTICLE · 1138348
multica 源码 12:一条评论如何唤醒一个 AI 员工
在 Multica 里,你给 issue 敲下一条 @资深工程师 帮我看下这个报错,几秒后 Claude Code 就在你电脑的某个隔离目录里跑了起来,读代码、改文件、回评论。
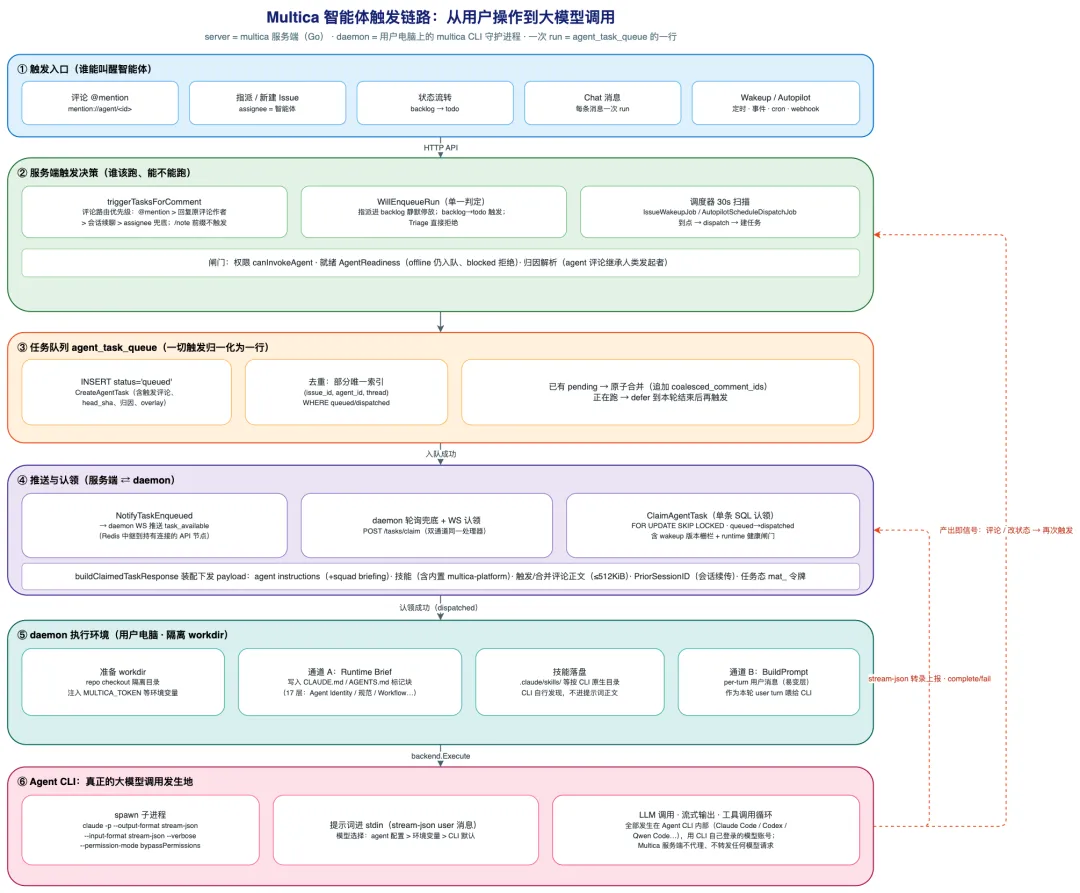
这篇文章把中间发生的一切拆开:从你的评论到智能体真正调用大模型,一共六跳。全部结论来自对 Multica 源码(Go 服务端 + CLI/daemon 同仓库)的逐行核对,文末附代码位置。
第一跳:触发——谁有资格叫醒智能体
Multica 的智能体不会自己醒来。官方文档明确了四种触发方式:指派 issue、评论 @mention、Chat 直聊、Autopilot 定时/事件。加上 Wakeup 唤醒规则("等某个人回复后再叫醒我"),本质都是同一个问题:这次操作,应该触发哪个智能体?
以最复杂的评论路径为例。服务端在评论落库后跑一遍路由决策,优先级从高到低:
显式 @mention 最优先。评论里的
mention://agent/<id>链接被正则解析出来,逐个检查:你有权限触发这个智能体吗?它被归档了吗?它的运行时还活着吗?回复智能体的评论。你在某条 agent 评论下面追问,就触发那条评论的作者。
会话续聊。一个讨论串的参与者里有 agent,接着聊就把它拉回来。
兜底:issue 的 assignee。以上都不命中,且 issue 指派给了某个智能体,就触发它。
几个细节值得玩味:/note 开头的评论永远不触发任何人(留给人看的便签);@all 会抑制所有隐式兜底路由(你@了全体人类成员,就别把 agent 也拽起来);运行时离线不阻止入队(任务排队等它上线),但运行时不可用会直接拒绝(别排队了,排了也白排)。
还有一道容易被忽略的工序:归因解析。如果这条评论本身是某个 agent 写的(A2A 协作),系统会顺着 source_task_id 找到它那次 run 的人类发起者,把"代表谁"继承下来——保证 agent 链条再长,权限与账单最终都落到一个真人头上。
第二跳:归一化——万物皆入队
决策通过后,不管入口是评论、指派、状态流转还是定时器,全部归一化为同一张表里的一行:agent_task_queue,初始状态 queued。
这是整个系统最"朴素"也最有效的设计。没有消息总线,没有独立队列服务,Postgres 一张表就是队列。而它的去重靠一个部分唯一索引:
CREATE UNIQUE INDEX idx_one_pending_task_per_issue_agent_thread ON agent_task_queue (issue_id, agent_id, thread) WHERE status IN ('queued', 'dispatched');
同一个 issue、同一个智能体、同一个评论线程,最多只有一个在途任务。当你连续发三条评论@同一个 agent 时:第一条创建任务,后两条在入队时撞上唯一索引——不是报错丢弃,而是原子合并进那个排队中的任务(coalesced_comment_ids 追加记录)。如果任务已经在跑了,新评论就登记为"该 run 结束后的补充输入",下轮触发时一并带上。
一句话:激进来量,温柔合并。用户的密集输入不会造成排队爆炸,也不会丢消息。
第三跳:下发——推送叫醒,认领防抢
任务入队后,服务端立刻通过 daemon 的长连接 WebSocket 推一条 task_available 通知(多节点部署时经 Redis 中继到持有那条连接的机器);daemon 同时保留轮询作为断线兜底。
真正把任务交给谁,靠一条 SQL:
UPDATE agent_task_queueSET status = 'dispatched', dispatched_at = now()WHERE id = ( SELECT id FROM agent_task_queue WHERE agent_id = $1 AND runtime_id = $2 AND status = 'queued' AND wakeup 未被禁用且版本一致 AND runtime 在线且健康 ORDER BY priority DESC, created_at ASC LIMIT 1 FOR UPDATE SKIP LOCKED)
FOR UPDATE SKIP LOCKED 是 Postgres 队列的经典手法:多个 daemon 并发认领,各拿各的行,互不阻塞。注意认领条件里还藏着两道栅栏——wakeup 版本栅栏(认领时再核对唤醒规则没被改过,被禁用的规则不让陈旧任务出队)和运行时健康闸门(离线机器的任务不出队)。状态机 queued → dispatched → running → completed/failed,每一步都有 CAS 保护。
认领成功的瞬间,服务端装配下发 payload。这里有个反直觉的事实:payload 很薄。里面是结构化 JSON——agent 配置的 instructions、技能清单、触发评论与合并评论的正文(合计预算 512 KiB)、上个会话的 session id、一枚 24 小时寿命的任务态令牌。没有 issue 正文,没有评论全历史。
第四跳:提示词组装——双通道,不拼大字符串
Multica 服务端从不渲染一份大提示词。提示词在 daemon(你电脑上的本地进程)上组装,而且拆成两条刻意分离的通道:
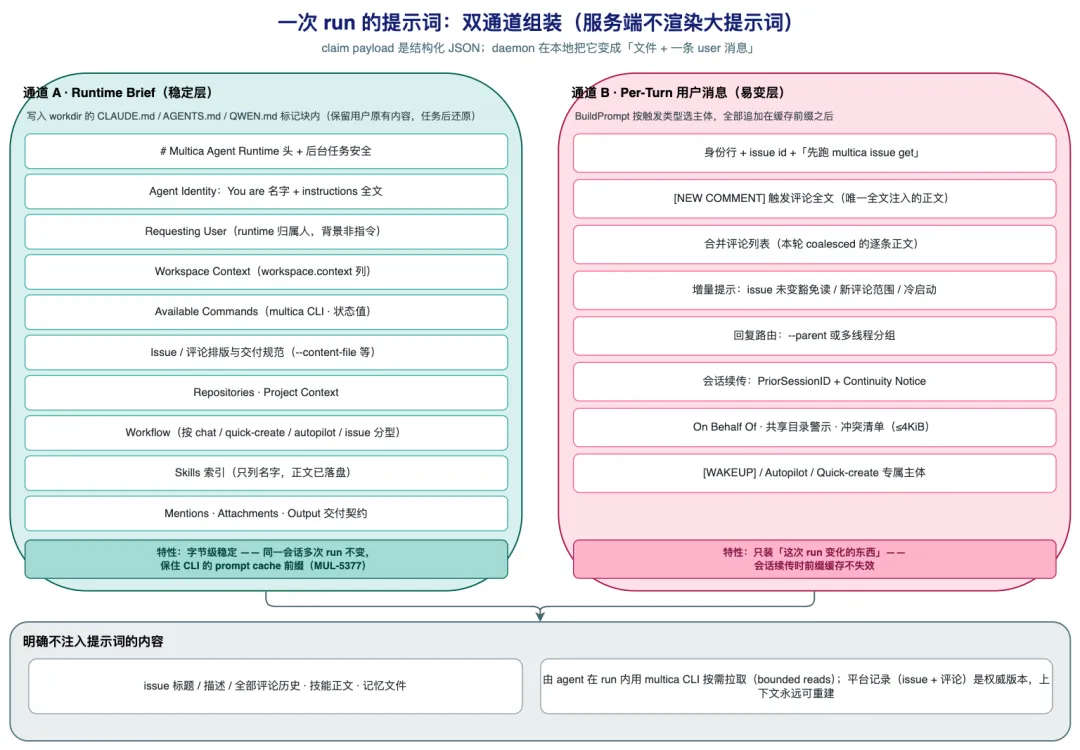
通道 A:Runtime Brief(稳定层)。 daemon 把一份 17 节的 Markdown 写进任务工作目录的 CLAUDE.md(Codex 对应 AGENTS.md),内容是平台规则、智能体身份与 instructions 全文、workspace 上下文、multica CLI 用法、按任务类型定制的 Workflow。它被写在幂等标记块里,字节级稳定——同一会话的多次 run,这份文件一个字节都不变。
通道 B:per-turn 用户消息(易变层)。 每次触发现拼一条 user 消息:身份行 + issue id + [NEW COMMENT] 触发评论全文 + 合并评论列表 + 回复路由(--parent)+ 会话续传提示。
为什么这么拆?prompt cache。Claude Code 这类 CLI 会缓存会话前缀;稳定层做前缀、易变层永远追加在后,会话续传时缓存不失效。源码里反复引用着同一条设计备忘(MUL-5377):任何会随 run 变化的字节,都不许出现在稳定层。
更狠的是"不注入"清单:issue 标题、描述、全部评论历史、技能正文,统统不进提示词。提示词只发 id 和命令,正文由智能体在 run 内用 multica issue get / comment list 自己拉取。薄注入 + 按需拉取,平台记录(issue + 评论)永远是权威版本,上下文随时可重建。
第五跳:大模型调用——发生在你以为的"平台"之外
关键结论:Multica 服务端从不调用大模型来执行任务。
daemon 拿到认领 payload 后,在隔离工作目录里 fork 出真正的 agent CLI 子进程。以 Claude Code 为例,完整命令行是:
claude -p \ --output-format stream-json \ --input-format stream-json \ --verbose \ --permission-mode bypassPermissions \ --disallowedTools AskUserQuestion \ --model <agent 配置的模型,可省略>
组装好的 per-turn 消息作为一条 stream-json user 消息写进子进程 stdin;子进程的流式输出(助手消息、工具调用、思考过程)逐事件回传 daemon,500ms 一批上报服务端入库,就是你界面上实时滚动的执行转录。
模型选择、API key、流式输出、工具调用循环,全部发生在这个子进程内部,用的是你本机 Claude Code 自己登录的账号。Multica 服务端唯一的直接 LLM 调用是两个辅助小功能(聊天自动起标题、快捷回复建议),走独立的 OpenAI 兼容网关,与 run 执行完全隔离——源码注释里写得很直白:跑 agent 是另一条数据通路,daemon 以子进程方式执行 AI 编码工具,用的是工具自己的凭据。
这个边界是产品立场,不只是架构选择:你的代码、你的模型账号、你的机器,平台只做记录与协调。
第六跳:闭环——产出即信号
run 结束,daemon 回报 complete/fail,服务端在一个事务里落终态、撤销任务令牌,并执行一条兜底不变量:如果智能体全程没发过评论,用它的最终输出合成一条评论发出来——保证每个 run 在 issue 时间线上必有可见产出。
然后是最优雅的一环:智能体发的评论、改的状态,本身又是标准的触发信号。A agent 完成子任务把父 issue 状态改成 done,父 issue 的 wakeup 规则命中,B agent 被唤醒继续接力——用的就是第一跳那套完全相同的路由逻辑。没有 agent 间消息总线,协作就是信号在队列里的循环。
写给智能体平台设计者的三条笔记
数据库就是队列。 一张表 + 部分唯一索引 +
SKIP LOCKED认领 + 状态 CAS,覆盖了去重、合并、并发认领、版本栅栏全部需求。先别急着上消息中间件。薄 payload + 厚客户端。 服务端只下发 id 和增量,智能体自己拉取正文。上下文永远可以从权威记录重建,这也让提示词天然抗膨胀。
稳定前缀是钱。 把提示词切成"字节稳定的系统层"和"永远追加的易变层",会话续传时 prompt cache 命中率决定真实成本。这不是优化技巧,是架构约束。
· · ·
附:端到端代码位置速查
以下位置基于 Multica 当前主干源码逐行核对;路径相对仓库根,均省略 server/ 前缀。
从「用户敲下评论」到「大模型开始工作」的十二步:
评论进入 API:
internal/handler/comment.go:1702评论落库 + 归因戳:
internal/handler/comment.go:1818触发路由入口(/note 在此短路):
internal/handler/comment.go:2037决定谁该跑(mention 正则解析):
internal/handler/comment.go:2700+internal/util/mention.go:16合并 / defer / 新入队:
internal/handler/comment.go:2174写入 agent_task_queue(status=queued):
pkg/db/queries/agent.sql:299WebSocket 推送 task_available:
internal/service/task.go:7152+internal/daemonws/notifier.go:24daemon 认领(SKIP LOCKED 单 SQL CAS):
pkg/db/queries/agent.sql:749装配下发 payload(含任务态令牌):
internal/handler/daemon.go:2343写 CLAUDE.md 稳定层(17 节 Runtime Brief):
internal/daemon/execenv/runtime_config.go:182拼 per-turn 消息:
internal/daemon/prompt.go:194spawn 子进程(真正的大模型调用发生地):
pkg/agent/claude.go:1079
其余关键机制定位:
评论路由优先级与 @all 抑制:
internal/handler/comment.go:2700-3170issue 建/派/改状态统一判定:
internal/service/issue_trigger.go:97wakeup 30s 调度与防失控:
internal/scheduler/jobs_issue_wakeup.go:12+internal/service/issue_wakeup.go:698去重部分唯一索引(migration 452):
migrations/452_agent_task_pending_thread_unique.up.sqlpending 原子合并:
internal/handler/comment.go:2458claim 评论正文预算 512KiB:
internal/handler/daemon.go:4724Runtime Brief 17 节组装顺序:
internal/daemon/execenv/runtime_config_sections.go:1049唯一子进程 spawn 点:
pkg/agent/launch.go:112「服务端不跑模型」边界声明:
pkg/llm/client.go:7终态落库 + 兜底合成评论:
internal/service/task.go:4396
配套文档:触发方式 multica.ai/docs/triggering-agents · Run 生命周期 multica.ai/docs/tasks · Daemon 与运行时 multica.ai/docs/daemon-runtimes
· · ·
本文是 Multica 源码研究系列的一篇。上一期讲了内置提示词体系与上下文管理,这一期补全了从触发到执行的完整链路。欢迎按图索骥去读源码,也欢迎交流指正。