ARTICLE · 1154671
【阿昌AI小课堂11】2-3丨AI是怎么回答你的?每次对话背后的操作大揭秘
ㅤ
📌 上节回顾
ㅤ
【阿昌AI小课堂10】2-2丨AI是如何学习的?小白也能看懂的大模型训练全解析
——上节课,我们打开了AI的「学习档案」:预训练打底、微调塑形、对齐立规矩。
ㅤ
ㅤ
ㅤ
ㅤ
你有没有注意到一个细节:
ㅤ
每次给AI发消息,它的回答不是一下子「弹」出来的,而是一个字一个字地「流」出来,就像有人在实时给你打字。
ㅤ
有些朋友可能觉得:这是不是界面做的动画效果,让它看起来更自然?
ㅤ
其实不是。
ㅤ
这不是特效,这就是AI真实的工作方式。
ㅤ
今天我们就来打开这个黑箱:从你按下发送,到屏幕上出现第一个字,中间到底发生了什么。
ㅤ
ㅤ
ㅤ
🌊 它不是在「打字」,它是在「实时生成」
ㅤ
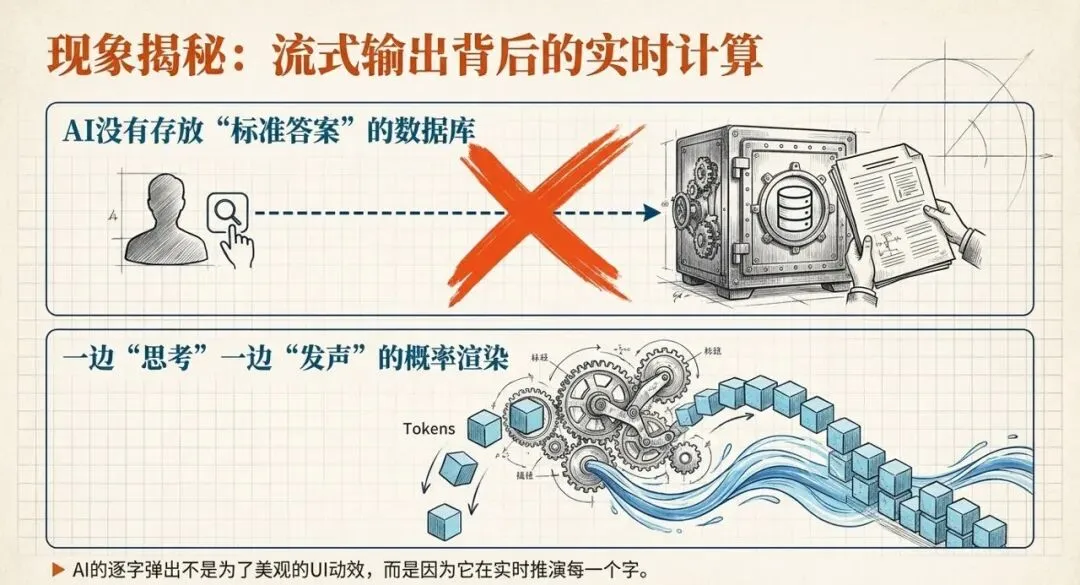
先说结论:AI的流式输出,是它逐字生成的实时呈现。
ㅤ
ㅤ
可能有点反直觉,AI在开始回答你的那一刻,其实还不知道这句话会怎么结尾。
ㅤ
在2-1节我们知道了AI的文字接龙机制:
它是一边「想」一边「说」的,
想出一个字,输出一个字,再想下一个字,再输出……
ㅤ
这不是比喻,这就是它字面意义上的工作方式。
ㅤ
那它具体是怎么「想」出每一个字的?
ㅤ
ㅤ
🔍 打开黑箱:从你按下发送,到它输出第一个字
ㅤ
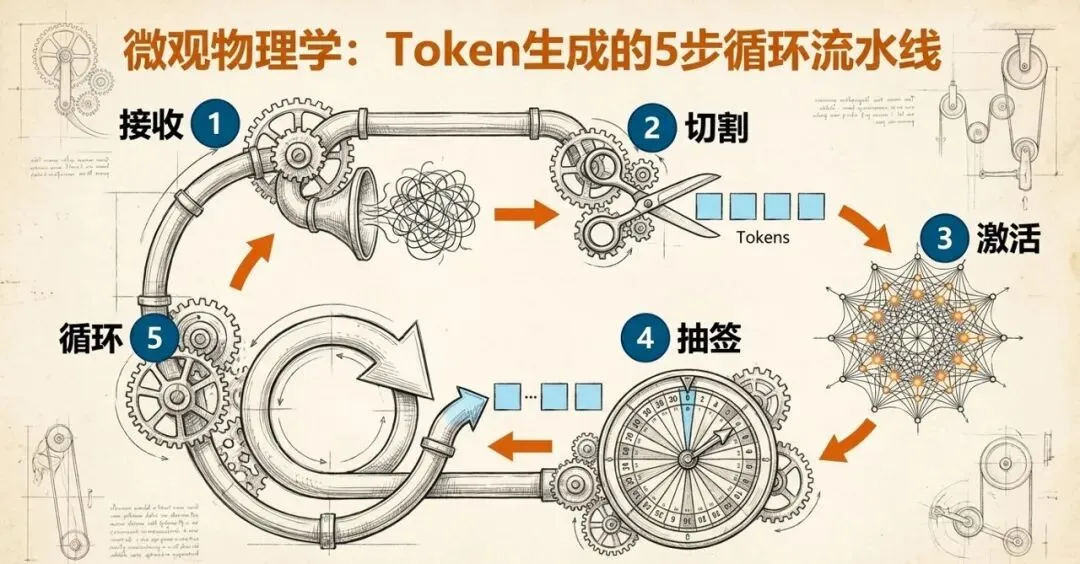
我们把这个过程拆成5步,你就明白了。
ㅤ
ㅤ
Step 1|接收你的输入
你发送的文字,进入模型。
ㅤ
Step 2|切成Token
文字被切割成一个个Token。
ㅤ
比如:
「你好吗」可能被切成「你」「好」「吗」,
也可能被切成「你好」「吗」。
这一步是把你的话变成AI能处理的原材料。
ㅤ
Step 3|在参数里激活规律
这些Token被转化成数字,在数百亿个参数构成的规律网络里流动。
ㅤ
模型根据你输入的Token组合,在这张规律网络里计算出一个结果:
接下来,最可能出现的是什么Token?
不是一个Token,而是所有可能的Token,
每个都有一个概率。
ㅤ
Step 4|按概率抽签,生成下一个Token
模型拿到这张概率清单,然后按概率抽签,选出一个Token,输出给你。
ㅤ
注意:
不是直接选概率最高的那个,而是按概率分布抽签。
概率高的Token被抽到的可能性更大,
但概率低的也有机会被抽到。
ㅤ
Step 5|循环,直到说完
把刚输出的Token加回输入,重新执行Step 3和4,生成下一个Token。
ㅤ
如此循环,
一个Token一个Token地生成,
直到模型判断该结束了,输出一个结束符,回答完成。
你看到的那个流式输出,就是这个循环在实时运转的样子。
ㅤ
ㅤ
🎲 同一个问题,为什么每次回答不一样?
ㅤ
理解了按概率抽签,这个问题的答案就呼之欲出了。
ㅤ
既然是抽签,同一个问题每次抽到的路径就可能不同,每次回答自然可能就不一样了。
ㅤ
这不是AI出了故障,不是它不稳定,这是概率采样的必然结果,是设计如此。
ㅤ
可以记住这个规律:
ㅤ
ㅤ
概率分布比较分散,抽签池里的候选词五花八门,每次抽到的结果差异就会比较明显
ㅤ
ㅤ 概率高度集中在正确答案附近,抽来抽去都差不多,所以两次回答会很相似
ㅤ
还有一个更重要的推论:
ㅤ
既然AI是根据上文来预测下文的,那你给它的上文不同,
它的概率分布就会不同,抽出来的下文也就完全不同。
ㅤ
换句话说,你问问题的方式,直接影响它给你的答案。
ㅤ
这就是为什么怎么问比问什么更重要,也是我们模块三要重点研究的。
ㅤ
ㅤ
ㅤ
理论说了这么多,现在轮到你亲手验证了。
ㅤ
这节课的实验只有一个动作:把同一个问题,发给AI两次。
ㅤ
第一步:选一个问题
ㅤ
实验能不能成功,问题的选择很关键。
ㅤ
推荐用开放性或创意类问题,
这类问题的概率分布比较分散,差异最容易被观察到。
ㅤ
给你两个现成的实验问题,直接复制就能用:
ㅤ
🔖 创意类:给我的咖啡馆起三个有意思的名字
🔖 开放类:用一句话描述一下春天
ㅤ
当然你也可以用自己想到的问题,只要是开放性的就行。
ㅤ
⚠️ 温馨提示:
如果你用的是事实类问题(比如北京在哪里),两次回答可能几乎一样,
这不是实验失败,而是因为事实类问题的概率高度集中,抽签池太窄了,抽来抽去都差不多。
ㅤ
换一个开放性问题,差异就会出现。
ㅤ
第二步:发送两次,对比观察
ㅤ
Step 1| 打开你常用的AI工具(任何一个都可以)
ㅤ
Step 2| 输入实验问题,发送,等待回答完成,把结果记下来或截图
ㅤ
Step 3| ㅤ不要刷新页面,重新输入同一个问题,再次发送
ㅤ
Step 4| 对比两次回答:哪些地方不一样?哪些地方相似?
ㅤ
第三步:解读你看到的差异
ㅤ
做完实验,你可能遇到三种情况:
ㅤ
情况①:差异很明显
ㅤ
🎉 恭喜,你亲眼看到了概率采样:
同样的输入,不同的抽签路径,产生了不同的输出。
这就是AI概率性本质的直接证明。
ㅤ
情况②:差异很微妙
ㅤ
👀 仔细看,用词、句式、举例的顺序往往有细微不同。
这也是正常的,AI的语感让它倾向于相似的表达方式,
但每次抽签的路径都不完全一样,微妙的差异就藏在细节里。
ㅤ
情况③:几乎没有差异
ㅤ
🔄 换一个更开放的问题再试一次。
事实类问题的概率分布太集中,不适合这个实验,
就像让你填「1+1=___」,你每次都只会填「2」,
不是因为你没有创意,是因为这道题的答案空间太窄了。
ㅤ
无论你观察到哪种情况,有一件事已经发生了:
你不只是「知道」AI是概率机器,现在你亲眼见过了。
ㅤ
ㅤ
ㅤ
试着填完这句话:
ㅤ
AI回答你,不是在___,而是在___。
ㅤ
如果能填出来,这节课的核心认知你已经掌握了。
ㅤ
填完之后,再想想这个问题:
ㅤ
既然AI是根据上文预测下文的,
你给它的问题越清晰、越具体,它的抽签池会怎么变化?
这对你平时问问题的方式,有什么启发?
ㅤ
这个问题,模块三会给你一个系统的答案。
ㅤ
ㅤ
ㅤ
👁️ 推理模型是怎么深度思考的?
ㅤ
你现在理解了标准的推理过程,每次回答都是逐Token概率采样的循环。
ㅤ
但你可能听说过深度思考模式或推理模型,
它们好像比普通模型「想得更深」,这是怎么回事?
ㅤ
感兴趣的话,
可以用关键词「推理模型的技术原理与应用实践」,自行探索。
ㅤ
ㅤ
📌 下节预告
ㅤ
【阿昌AI小课堂12】2-4丨AI为什么老失忆,上下文窗口是怎么工作的?
——下节课,我们聊一聊,AI的记忆有多长?超出之后会发生什么?
ㅤ
注:
1. 本文仅为个人观点,不代表任何机构或组织的立场。
2. 文中部分资料数据来自网络,如有错误,欢迎指正。
3. 文中部分图片来自网络,版权归原机构或作者所有。
推荐阅读
【阿昌AI小课堂02】1-1丨AI极简科普,一句话说清AI的本质
【阿昌AI小课堂03】1-2丨AIGC是什么?AI的「内容工厂」全景图
【阿昌AI小课堂04】1-3丨AI能帮我做什么?普通人的AI场景入口
【阿昌AI小课堂05】1-4丨用豆包制作个人头像,AI工具初体验
【阿昌AI小课堂06】1-5丨AI不能做什么,看懂AI的能力边界
【阿昌AI小课堂07】1-6丨AI工具生态全景:工具是皮,模型是心
【阿昌AI小课堂08】1-M丨AIGC模块通关:恭喜你进入了AI世界的大门
【阿昌AI小课堂09】2-1丨什么是大模型,什么是大语言模型?
【阿昌AI小课堂10】2-2丨AI是如何学习的?小白也能看懂的大模型训练全解析
关注公众号回复【提示词】领【御用提示词】
加阿昌好友备注【AI课程】领【AI入门手册】