ARTICLE · 1159525
AI短片拉片 | 《candy》:这人根本没拿AI片子当AI片子做啊...
九分钟的短片,哔哩吧啦单口聊了快一个小时,看完以后又看了他上半年大火的《牌子》,又有了新的感触。
这次先把拉片的收获整理一下。一部分是看完就能拿去练的镜头,另一部分,是它真正不好学的地方。拆到最后,发现实拍经验、空间想象还是非常重要,以及非常现实的钞能力。
《糖果》的设定很有意思:一个叫“潘”的未知存在出现,人与人之间的恶意会触发“糖化”——外星势力承接坏人。
它没有一上来就通过旁白念世界观,先给观众看便利店里的冲突、欺负老人和狗,在具体的微小事情中解释了世界观,最后再把事情扩展到战场、全球。
概念很大,但每一步都有具体事情,镜头节奏非常快,少数事件1-3个镜头就快速带过。
我觉得这是它剧本和执行都是很到位的,影片的最后,通过三个镜头交代了和平后的平静、离开家暴丈夫的女人和校园暴力结束的班级——世界变了,到底变在哪儿——创作者不过度煽情地都呈现出来了。
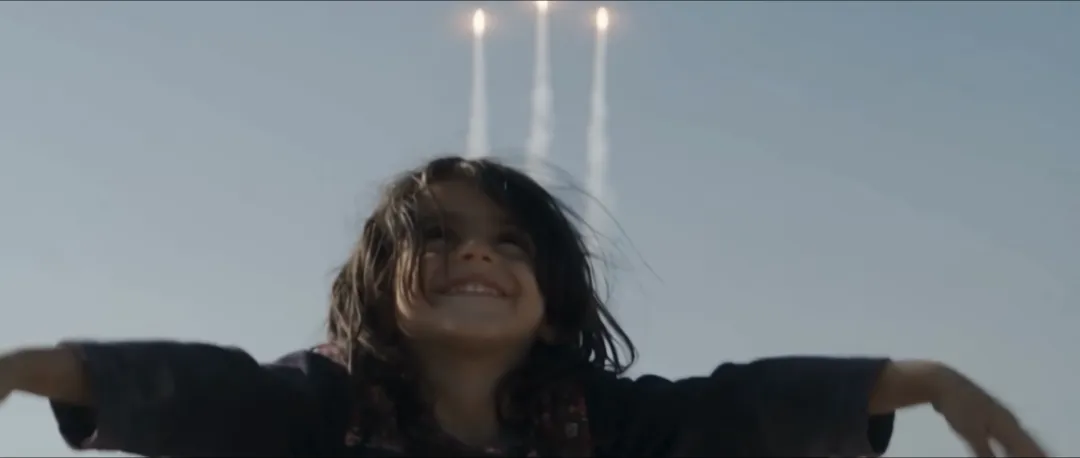
此处的“很好学”主要针对AI直出的分镜以及短视频时代观众的观看期待,如果想要做一个节奏快且视觉新鲜的影像,可以尝试一下下述“邪修”镜头。能不能做到原片的质感,那另外说。
开场的糖果、嘴唇、眼睛,都非常近。哪怕镜头拉到相对远的位置,主体依然占据很大的画面。
刚开始做 AIGC 短片,很容易把分镜做得太完整,AI给的全景或中景也是如此——一个人站在那里,至少要看见上半身,背景也最好交代清楚。结果每张图都挺完整,放在一起却没什么记忆点。
《糖果》开头这几个镜头就很抓眼球。眼睛的细节、脸上的阳光、后面的天空,都在建立一个明确的视觉中心。
挑一个你希望观众记住的东西,试着只拍它的局部。嘴唇、眼睛、手,或者一颗糖。先想清楚这一刻要看什么,再决定画面里留多少东西。
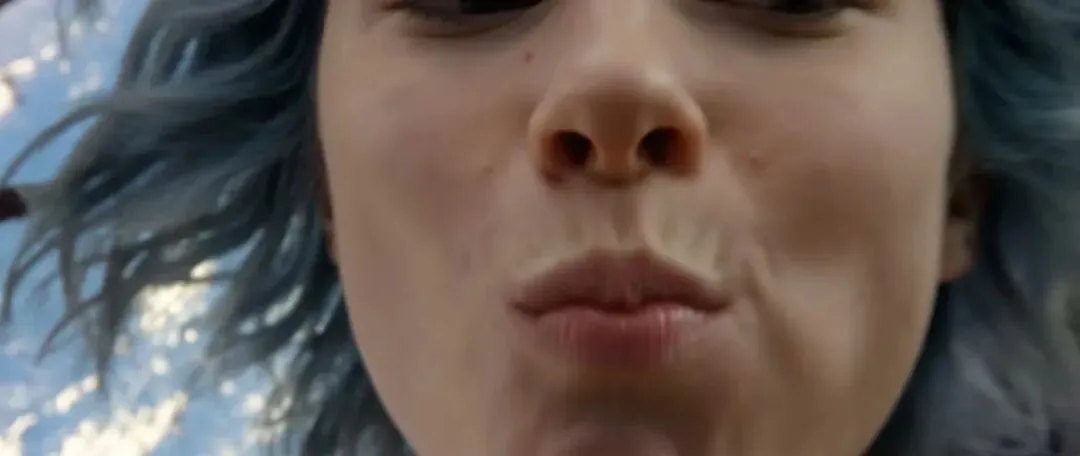
▲ 开场的大特写,主体占满画面,先把注意力抓住。
“潘”没有一开始就完整地摆在观众面前,它先在人的脸上留下一个影子。看到后面,你才知道前面这个影子意味着什么。
我觉得这很讨巧,也很值得学。一个重要的东西,可以先通过它对环境的影响出现:影子、反光、人物的反应,都能让观众先感受到它,再看见它。
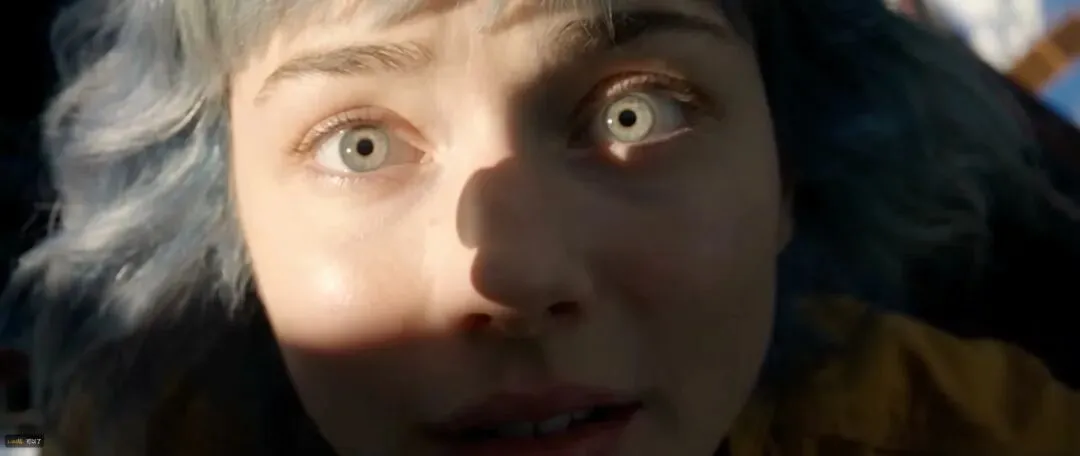
▲ 先让阴影落到脸上,再让观众认识“潘”。
糖果放在前景,人退到后面,周围普通的东西突然都变得很大。
到了后面,又用海滩、街区这些大俯视,把局部的冲突扩展成全球的事情。
这些镜头很容易带来新鲜感,但它们也有表达上的作用。蚂蚁让你看到另一种尺度;俯视配合“放牧”的说法,让人类看起来像被某种更大的存在观察。
如果自己的分镜一直是平视中景,可以先从这里改。不过机位最好在出图时就想好,普通中景后期裁大一点,透视关系也不会自动变成微距或低机位。
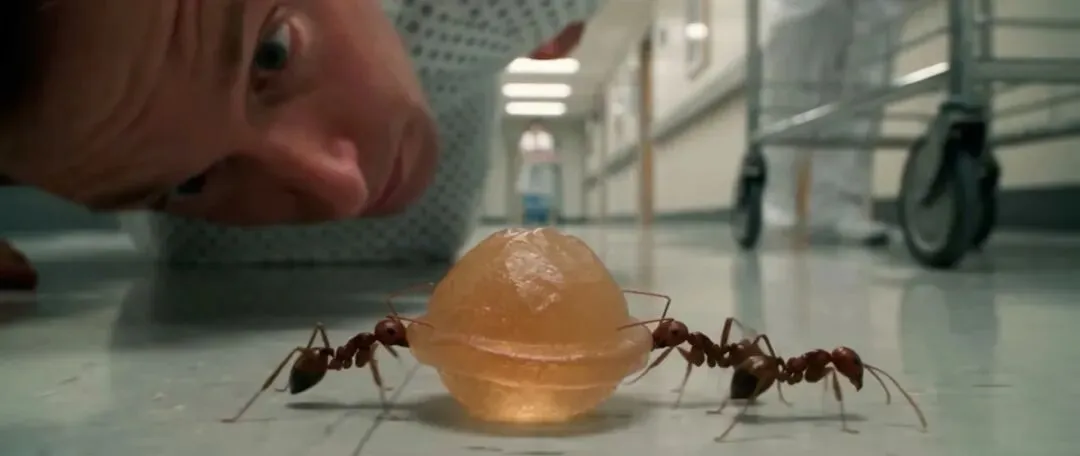
▲ 贴近蚂蚁的高度,一颗糖就成了很大的东西。
警局里大部分人穿深蓝色,浅色衣服的人就很容易被注意。实验室则用了正面、轴对称的画面,深蓝的房间、整齐的白制服、中心位置的后脑勺,一起形成一种冷漠感。
人物要不要站在中心?背景和主体要不要拉开颜色?画面希望人感到严肃、压迫,还是混乱?这些都应该在分镜阶段做决定。
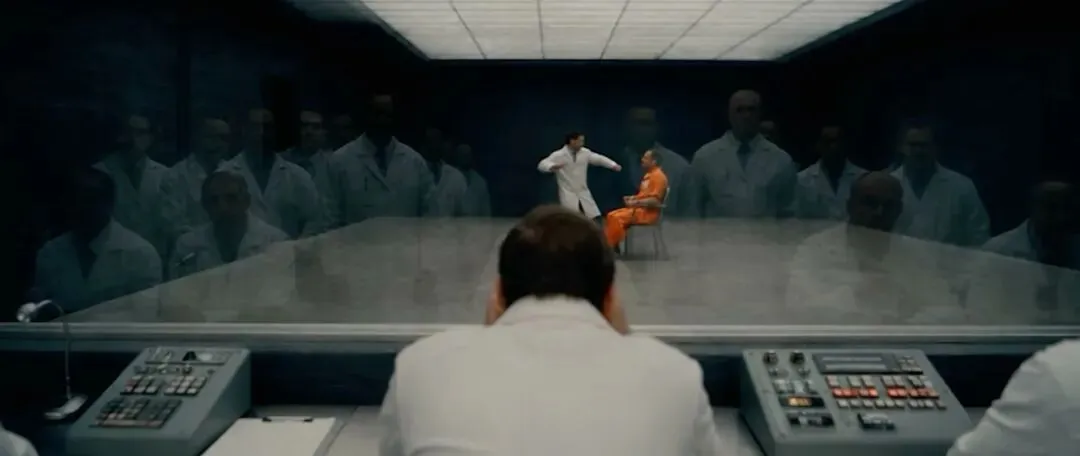
▲ 中心轴、背影和整齐的环境,一起建立实验室的冷漠感。
这个片子很喜欢拿场景里的小东西连接下一场戏。镜子、经过的人、车辆的遮挡、降下来的投影幕,都能成为切换的机会。
在怒路症那个争执里,画面虽然是居中轴对称构图,但是核心的人物和有变化的动作都集中在画面左边,前面的人从车里伸出来的手在左边、糖从左爆出来,镜头再向左滑,借车的遮挡进入下一个场景,下一场的警察推门而入从画右走向画左,后景里的人也是往左走的。
你的注意力一直被带着往左,一切都比德芙丝滑。
制作分镜的时候可以先把相邻两个镜头摆在一起看:前一个镜头把观众的眼睛带到哪里?下一个镜头的重要东西又在哪里?有没有一个动作或者物体,能把它们接上?
这些单个镜头拆出来,都能讲明白,但整部片子做下来,难度就完全不一样了。
我拉到后面越来越明确的一点是:创作者调用了很多实拍里的人物调度经验。
在影片的结尾,两个警官先说话,一个小混混从左边入画引起警官的注意,警官和小混混聊天转成新的对话。这三人渐行渐远后,左边有了一点空间,就有两个人裹着透明的塑料球从后景走向前景再从右边出画。镜头在他们出画以后缓慢后拉,经典的包饺子大结局画面。
这种人物的调度就看得出创作者的豪气——完全不用管抽卡积分,就是要AI人跟着指示走、跟着指示对话。
焦点转移也是我们在AI短片里很少看到的——便利店里,前面的人说完,焦点转到后面,让你去看另一个人的反应。实验室里也是,谁说话、谁回应,摄影机就把注意力带过去。
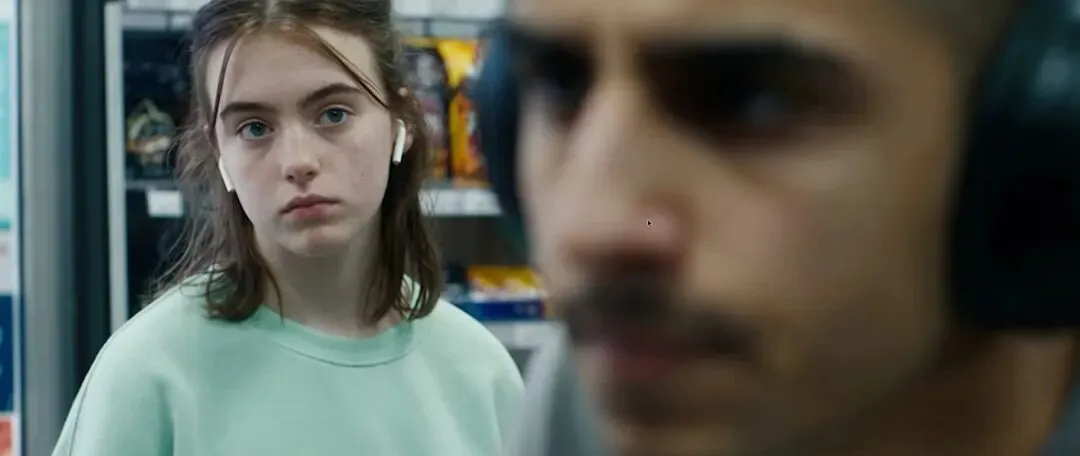
▲ 这一帧焦点落在后景人物,前景人物虚化
前中后景做出空间感。厂房里的画面,空间本身可能很平,但前面两个人聊天,中间站着一个人,最后面还有人在穿衣服。用人的位置和动作,就把前中后景做出来了。
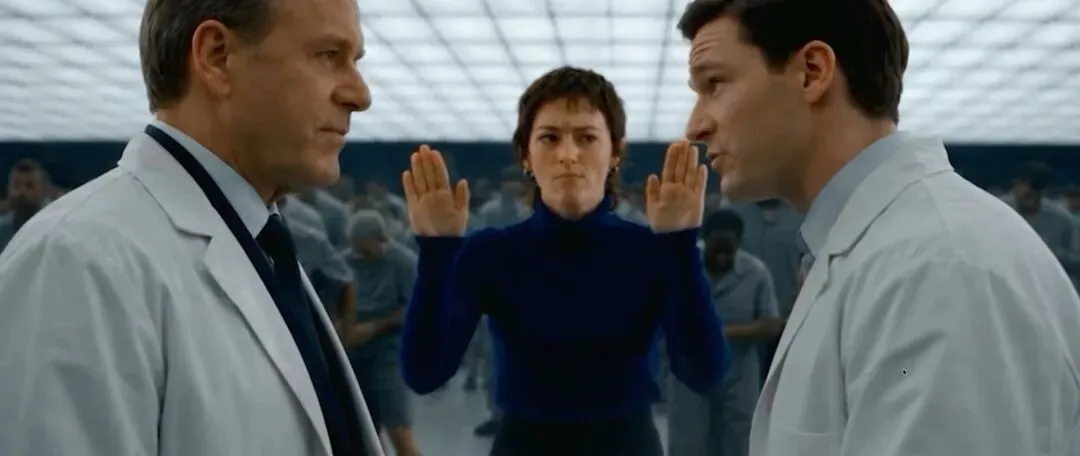
▲ 前景的对话、中间的人物和后景的活动,把空间分成了几层。
所以,你要考虑的事情会一下子变多:这个人站在哪里,另一个人离他多远,谁先动,谁后动,谁挡住谁,摄影机站在哪里,焦点什么时候过去。
前一个镜头拍完,换到下一个机位,观众还得知道他们在同一个地方。
这就需要创作者对整个空间有想象。脑子里得有一个能让人走动、对话、相互遮挡的场景。单张图里的构图,只是其中一个瞬间。
影片最开头的便利店的爆发就在一个镜头里解决了多层信息传递:店员先警告闹事男,闹事男咄咄逼人,他的朋友劝他,闹事男推开劝事朋友,灯开始闪,安静,炸之前还有很微妙的停顿,boom!人第一次在画面里面炸开,化成五彩缤纷的糖果。
人物交互、环境灯光和动作节奏,都得在合适的时间发生。
写一句“灯光闪烁,人物变成糖果”是非常简单的,但这句话里面,还有很多需要创作者决定的细节动作与演绎节奏。
小的细节分开都很容易的样子,但如果想做到它整个片子的程度,就得继续补人物调度、空间理解和节奏判断。个人感觉,它从剧本到画面调配,很多地方都是拿实拍的思路在做 AI 短片。
还有一些很AI导向的剧本撰写思维:糖果铺满公共交通空间这种奇观,可以在写剧本时就先想——我的片子里,有没有一个值得记住、用自己的有限预算实拍做不出来的画面?再给它找到合适的剧情位置。
对我来讲,提示词已经是相对简单的一层了,AI都能出提示词。更难的是,创作者怎么选择镜头,怎么修改提示词,能不能想清楚人在这个空间里怎么动,以及观众看完,到底接收到了什么。
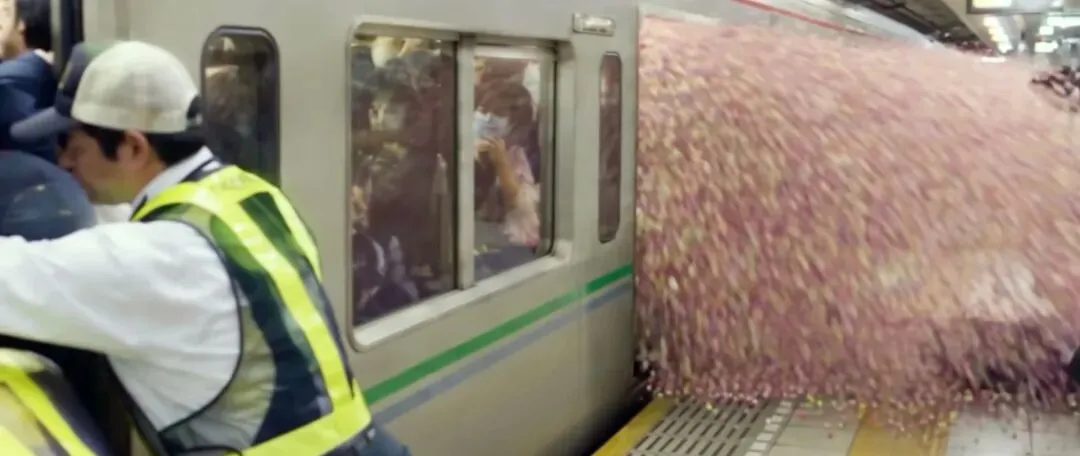
▲ 糖果铺满列车空间,奇观也在交代事件的规模。
很开心捏,开始做拉片记录了哈哈!
下一次想分享我8-10月份做的AIGC有关的交互作品,自从加入了codex开发,AIGC素材的可使用方式多了很多。
嘿嘿
文中配图为《糖果/CANDY》截图,可见发布账号:DiDi_OK。