ARTICLE · 1162594
AI 会拆别人的软件了,堆更多 AI 反而更贵,杨立坤交了卷
今天是 10 月 12 日,周一。假期回来第二天,我早上打开 GitHub 趋势榜,第一名是个上周还没听说过的项目,三天时间涨了八万颗星。
同一批新闻里还有两条挺反直觉的。一条说,让好几个 AI 组队干活,效果几乎没变好,账单却翻了好几倍。另一条来自图灵奖得主杨立坤,他花四年时间想证明一件事:AI 要理解这个世界,可能根本不需要把画面画出来。
三条消息都在回答同一个问题——AI 到底行不行。一条比一条有意思。
一、一个项目三天涨了八万星,它能替你看懂别人的软件
先想一个很多人都遇到过的场景。你手机里有个 App,某个功能做得特别顺手,你特别想知道它是怎么实现的。但你没有源代码,也没有作者的联系方式。以前唯一的办法是打开反编译工具,对着几千个函数一个个啃,啃到一半就放弃了。
上周冒出来的 REA 想干的就是这件事。全名 Reverse Engineer Anything,"逆向任何东西"。
它本身既不是模型,也不是反编译器,更像一根管道。通过一个叫 MCP 的协议(可以理解成"AI 调用外部工具的标准插座"),它把你的编程助手和真正的逆向工具连起来——Hopper、Ghidra、IDA 这些反汇编软件,还有分析安卓安装包、路由器固件的工具。Claude Code、Codex、Cursor、VS Code 这些常见的助手,一共支持十七个。
连上之后,你就可以用大白话下命令:帮我看看这个 App 里的搜索是怎么做的,把证据拿出来,然后在我的项目里做一个类似的。它会自己去反编译、读汇编、找接口,最后交给你一份说明,而且每一句结论后面都标着依据,还会主动写清楚哪些地方它没搞明白。这一点我觉得比功能本身更难得。
项目页上有两个例子,我看完愣了一会儿。
一个是 Notion。助手先找到它的剪贴板接口,顺着预加载脚本和进程间通信一路往里追,最后追到主进程,连富文本剪贴板的格式都看清楚了。整个过程,它手里没有一行 Notion 的源码。
另一个是 DX-Ball,上世纪的老游戏。助手顺着一个音效调用往下挖,挖到一个小函数——它的作用是把物体位置换算成立体声的左右声道数值。助手读懂了那段汇编,然后用 C 语言重写了一遍。重写的版本跑过了 3205 个测试用例,连编译出来的那 63 个字节都复现了。
星标涨得也确实是猛的。10 月 4 日它还是 1513 颗星,10 月 11 日早上是 77333,再往后到 83089——44 个半小时涨了四万七,平均每小时一千多颗。配套的软件包一天被下载了近两万次。
不过这里有个反转,我挺喜欢这个细节。
有人拿 GitHub 的接口把每一个 fork 的时间戳翻出来核对,发现凌晨三点、六点、九点,每小时分别新增 310、302、367 个 fork——三条几乎水平的直线,穿过整个夜晚。正常的热度是跟着人的作息走的,白天高夜里低。"那是机器。"他写道。
另外,八万三千颗星的项目,只有 269 个人点了关注。这个比例是 0.32%,而一般的项目大概在 2% 左右。所以更接近事实的说法是:这个工具是真的,代码也确实写得不错,但它的热度有一部分不是真的。
最后提一句边界。它给的是伪代码和模块关系,不是原封不动的源码;深度分析还得你自己装好那些专业工具;它也不能一键把别人的 App 克隆过来。逆向工程本身有明确的法律边界,分析自己有权分析的软件是一回事,拆别人的付费产品是另一回事——项目文档里也把这个前提写得很直白。
二、花 5 倍的钱,不一定买到更好的答案
第二条,可能做企业采购的人会更有感觉。
今年 AI 圈被推销得最凶的一个概念,叫"多智能体"。说法大概是这样的:一个 AI 负责规划,几个 AI 负责执行,再来一个负责检查,一窝合作的 AI 比单个 AI 强得多。厂商和咨询公司几乎都这么说。
Vals AI 最近做了个基准测试,结论正好相反。
他们用 GPT-6 Sol 和 Claude Opus 5.5 跑了四组任务,比较"单个 AI 干"和"一队 AI 干"。四组里,只有一组能测出组队带来的质量提升。另外三组,多出来的那些 AI 只是让成本变得更高了——最夸张的一组,token 消耗是单干的 5.1 倍,质量却看不出差别。
Anthropic 自己公布的数据也指向同一件事:智能体数量超过十个以后,质量就基本不再往上走了,但 token 消耗还在继续涨。卖模型的公司在公开数据里拆自己产品的台,这个动作本身挺说明问题的。
为什么会这样,我觉得道理不复杂。协调本身是要花成本的。两个人碰一下就能定的事,叫五个人来开个会,会议室确实更热闹,但结论大概率不会更好,只是时间成本翻了倍。AI 组队也是同理,多一层传递就多一次信息损耗。
需要说明的是,这项研究没说多智能体没用——四组里有一组确实更好。它说的是:不能把它当成默认选项。真要用,得先在自己的任务上量一量,这份提升配不配得上多出来的账单。如果单干能打平,那单干在成本上就赢了。
同批还有一份 Epoch AI 的研究,角度更狠一点:今天最强的那批智能体,在"自己做研究"这件事上,只拿到了人类参考水平的 15% 左右,而且普遍会高估自己的实验结果,也缺少科研里最基本的那种自我批评。听起来有点像刚入学的学生,实验做得飞快,复盘却很潦草。
三、图灵奖得主不画像素了,迷宫成功率从 18% 涨到 73%
第三条,说一个人。杨立坤,图灵奖得主,卷积网络的奠基人之一。
这些年 AI 圈有个挺有名的画面:一边是各家拼命烧算力,让模型逐帧生成高清视频,恨不得把每个像素都算清楚;另一边是杨立坤一直在唱反调——别在像素上浪费算力了,真正的世界模型不需要生成画面,它应该在抽象的空间里预测未来。
早在 2022 年,他就把这个想法画成了蓝图,叫"分层世界模型"。四年过去,他创办的 AMI Labs 联合纽约大学、巴黎的一家研究院和布朗大学,把方案交出来了,名字叫 H-JEPA。论文、代码、九十多个预训练权重,全部公开。
它解决的问题我用一个比方说。
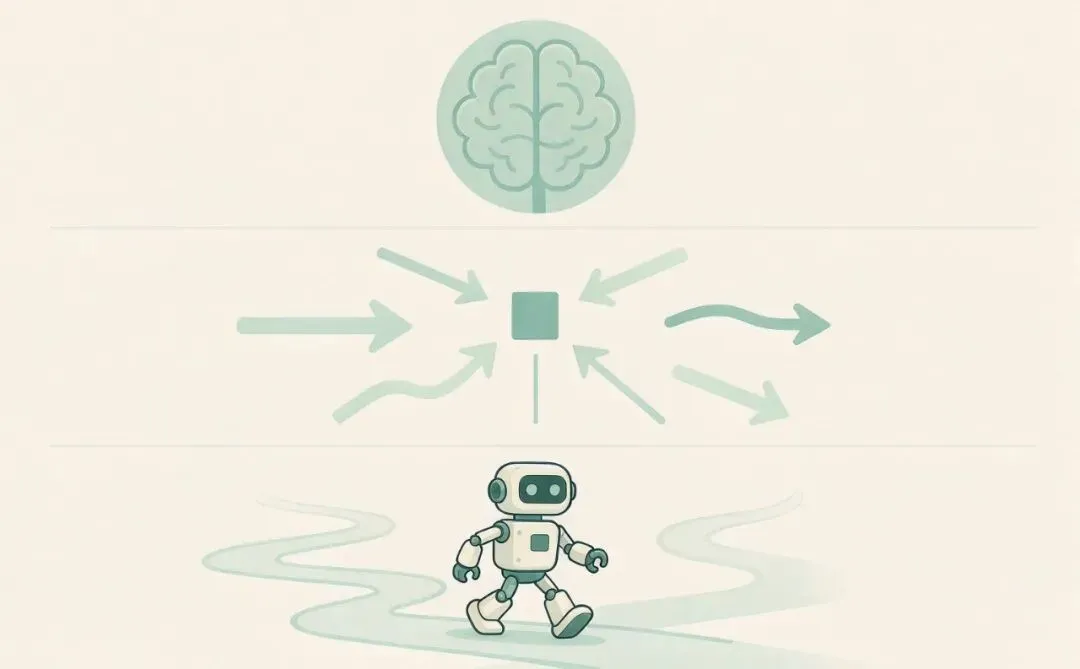
以前的单层世界模型像个单打独斗的人:既要判断几百步之外迷宫的出口在哪,又要时刻盯紧机器人的左前腿到底是弯了 30 度还是 35 度。这相当于让公司的 CEO 一边制定五年计划,一边亲手去修洗手间漏水的水龙头。规划稍微看远一点,脑子就爆了。
H-JEPA 的办法是分层。它把好几个模型叠起来,高层预测得更远,只关心位置和通道这种大方向;中层把大方向拆成中期小目标;底层专门管迈腿这类具体动作。每层还学自己的一套特征——迷宫实验里,高层的模型会自动把"腿在抖"这种高频细节过滤掉,只留下坐标。
效果确实明显。在一个叫 Visual AntMaze 的仿真迷宫任务里,三层结构的成功率是 73.3%,而单层模型只有 18%。差不多四倍的差距,而且它消耗的规划算力反而更少。团队还拿真实的机器人录像数据集做了离线测试,它预测出来的动作轨迹比单层模型更贴近专家示范。
但它也不是越多越好。换成推物体的任务,三层的表现反而不如两层。
有一个细节我觉得值得单独说。这篇论文自己拆了自己的台:正文认真分析了"分层到底为什么有用",把它拆成两个不同的原因,还指出有两个环境里分层的优势压根没出现;附录里更直接,证明了整套方法依赖的那个正则化技巧,在真实机器人视频的某一种失败情形下是"看不见"的。
只有跑分好看的研究满地都是,愿意在附录里写"我们这个方法在这儿不灵"的研究,反而少见。
结尾
三条消息放一起看,我留意到一件事:它们其实都在给 AI 的能力划边界。第一条在说,AI 能看懂的东西比我们想的多,但那八万颗星里有一部分是刷出来的;第二条在说,堆更多的 AI 不一定是升级,也可能是更贵的重复劳动;第三条在说,走得最远的那条路,反而可能是最简单的那个方向。
写到这儿我其实没想清楚一个事。如果哪天你的编程助手真能看懂别人 App 里的功能,随便一句话就给你复刻出来,你会拿它做什么?是学个思路用在自己项目上,还是干脆什么也不碰?
评论区聊聊,我挺想听听。