ARTICLE · 1166485
丹纳赫把实验室交给了AI
丹纳赫把实验室交给了AI
生命科学工具巨头宣布建首个 AI 自主实验室,2027 年初运行:亲和试剂发现至多提速 8 倍、年产量至多增十倍。
10 月 7 日,丹纳赫宣布建设首个 AI 自主实验室,2027 年初在旗下 Abcam 规模化运行。亲和试剂(能精准抓住目标分子的抗体一类研究工具)的发现速度"至多提升 8 倍",年产量"至多增长十倍"——实验室自己设计、自己构建、自己测,再把每一轮结果喂回模型。
这条新闻里最容易被划走的三句话
丹纳赫同时给了四条交付指标。
速度上,亲和试剂发现至多快 8 倍;
规模上,年试剂产出从"每年几十个"到"每年几百个",至多十倍;
质量上,每一个设计都要被验证、被测试、并回流去改进下一个,明说"不以牺牲科学严谨性换速度";
可持续性上,长期是补充传统免疫法(用动物免疫制备抗体的老办法),不是取代它。
落地点在 Abcam——2023 年 12 月被丹纳赫以约 57 亿美元收购的抗体试剂公司。参与拼图的是五家运营公司:贝克曼库尔特生命科学、Cytiva、Genedata、IDT、Molecular Devices;设备调度与机器人自动化由 Automata 承担,这家公司 2026 年 1 月刚拿到丹纳赫的投资。
根因分析(为什么"质量"那条最关键):
速度和产量是给业务看的数字,"每个设计都要验证、测试、回流"才是这套闭环真正的门槛——它意味着实验室不能只追求跑得快,还要保证每一轮留下的东西经得起复查。少了这一条,闭环就只是把跑偏的流程加速了一遍。
为什么是卖仪器的公司来干这件事
过去几年 AI 制药的死结不在模型,而在验证。
模型公司没有实验能力,药企又不愿意把自己的湿实验数据交出去。于是验证环节要么没人做,要么由药企自己花钱慢慢做。
丹纳赫手里恰好有两头。仪器那头,它知道怎么把移液、孵育、检测这类动作做准做稳;抗体试剂那头,它知道一个候选抗体到底算不算合格。这条路和"AI 公司去找药企合作"不同——它把验证从甲方的成本,直接变成了自己可以交付的产品。
这不是新事。Molecular Devices 的 CellXpress.ai 自动化细胞培养系统早就在用 AI 提高细胞系培养的重复性;Genedata 2024 年 8 月被收购,补的是生物信息这一层。
根因分析(为什么仪器厂商集体转向讲"闭环"):
仪器厂商的价值正在从"精度指标"往"能不能产出模型能直接吃的数据"移动。精度是一次实验的属性,数据形态是长期的资产——这也是为什么今天每一家做自动化实验室的公司,都在强调同一件事:闭环,而不只是单机性能。
闭环对仪器提出的三条硬要求
想清楚这一点,就知道这套东西对卖设备的一方意味着什么。
1.数据要能被机器直接读。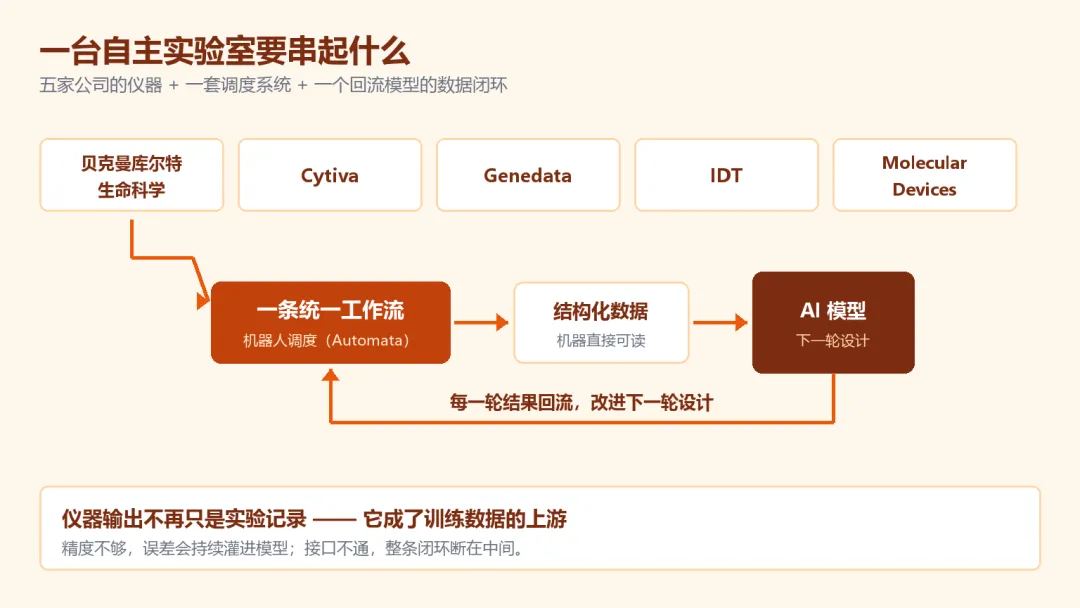
根因分析(为什么这三条现在才要紧):
因为"每一轮都回流"把仪器的角色改了——仪器输出不再只是实验记录,而是训练数据的上游。仪器精度不够,误差就不再只毁掉一次实验,而是会持续往模型里灌。这会重排仪器厂商的评价标准:谁更准当然重要,谁产出的数据模型能直接用,权重正在快速上升。
人没撤场,只是换了位置
丹纳赫首席科学官把分工说得很直白:实验室要实现"至多 8 倍"的提速,"而科学家继续做关键决策"。总裁兼首席执行官 Julie Sawyer Montgomery 10 月 1 日刚接任,她的说法是让有前景的想法更快变成已经验证过的系统。
这套逻辑放到药企的合规语境里并不陌生。自动化系统可以执行、可以记录、可以推荐,但放行必须由有资质的人签字。
真正的新问题是:以后每一轮设计里,模型建议的那部分、科学家拍板的那部分,界线要画在哪里;模型版本和训练数据范围要交代到什么程度;哪些设计失败过、为什么被放弃——这些都得能拿出来回答。
根因分析(技术闭环解决什么、质量体系解决什么):
技术闭环解决的是"做不做得出来",质量体系解决的是"信不信得过"。后者不到位,前者跑得越快,返工越贵。这也是为什么这套公告里,"验证、测试、可追溯"这几个词的分量,比"8 倍"更值得盯。
别把"至多 8 倍"当成实测结论
公告把速度、规模、时间点全部写进了前瞻性陈述(forward-looking statements)免责段落——意思是这些是目标,不是已经测出来的结果。实验室要到 2027 年初才"规模化运行",第一批数据还没出来;官方对"AI-ready 数据"只给了方向,没给标准。
所以看这类自动化实验室新闻,先问五个问题:
数字是实测还是目标? 什么时候真跑起来? 覆盖哪些环节、替代不了哪些? 数据格式对不对得上模型? 谁签字放行?
信号(本篇五问的答案):
目标是目标、2027 年初、补充而非替代免疫法、标准未公开、科学家做关键决策但监管口径未涉及。五条里三条还没有确定答案,这才是这条新闻真正的分量所在。
一句话收尾:卖仪器的公司亲自下场跑实验,验证成本变成了可交付的产品——这比任何一份行业预测都更能说明闭环这件事落地了。
互动提问:如果你们实验室也在做自动化,最缺的是哪一环:机器能直接读的数据、能被统一调度的设备,还是事后能追回来的完整记录?欢迎在评论区聊聊。