ARTICLE · 1175201
把政策文档交给 Agent:先复述,别急着写代码
PharmaCE · AI 重构销售奖金 · 第二篇
把政策文档交给 Agent:先复述,别急着写代码
一份真实的季度奖金政策里,藏着十种规则形态
拿到一份奖金政策,多数人的第一反应是把它丢给 AI,让它写个能算的程序出来。
这个冲动可以理解。政策里全是条款、权重、门槛、系数,看起来就是一堆公式。
但你真把一份季度奖金方案通读一遍,会发现它比公式复杂得多。
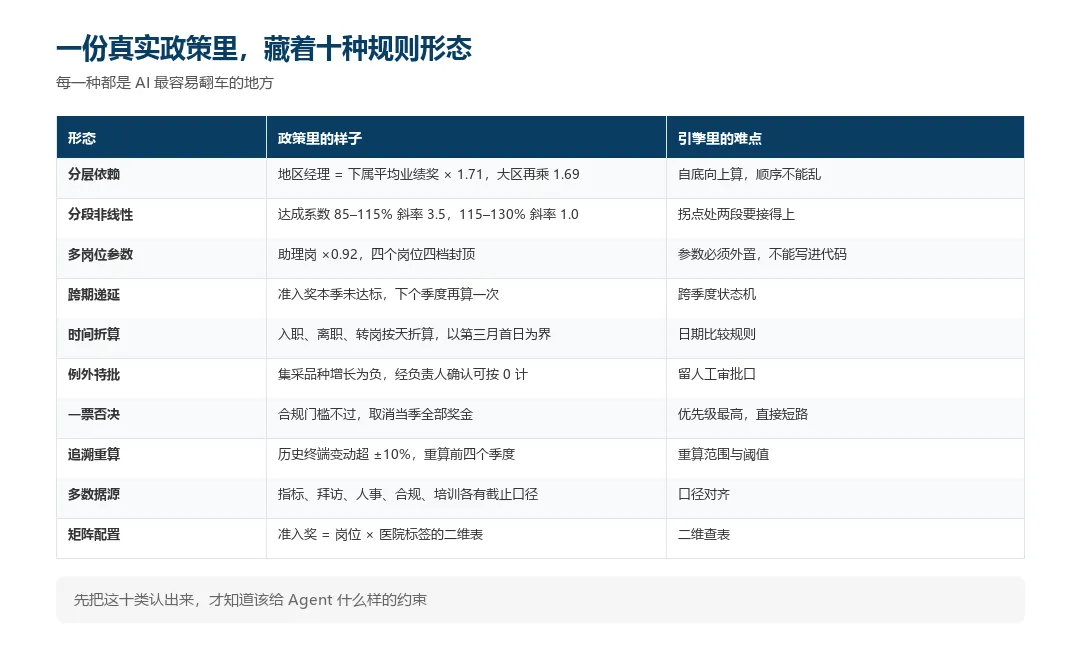
图1 一份真实政策里的十类规则形态
01政策文档里到底有什么
我手上有一份季度奖金方案,四十来页。把它拆开,里面同时存在十种规则形态。
最麻烦的是第一条:分层依赖。地区经理的奖金 = 下属代表的平均业绩奖乘 一个系数,大区经理再乘 一个系数。上层的输入是下层的输出。
这意味着引擎不能随便算,必须自底向上,先把每个人的算完,再往上卷。顺序错了,全盘皆错。
第二条是分段非线性。达成系数在 85% 到 115% 之间是一条线,斜率 3.5;过了 115% 突然变缓,斜率掉到 1.0。两段在 115% 这个点上必须接得上,差 0.001 就是一笔争议。
还有跨期递延。医院准入奖如果本季度没算上,下个季度要再算一次,而且按下个季度的合规门槛、奖金资格、打折规则来发。
以及一票否决。合规门槛不过,当季全部奖金归零。这条规则的优先级比所有计算都高,直接短路。
认清这十类形态的意义在于:你知道自己面对的是什么量级的复杂度,也就知道该给 Agent 什么样的约束,而不是只丢一句「帮我写个奖金计算器」。
02第一步:让它复述,你来确认
复述这一步不产生任何代码。让它用自己的话,把政策从头到尾讲一遍。
为什么非要先做这一步?
因为歧义在编码前解决最便宜。一旦代码写出来了,一个理解偏差就藏在几百行里,要等某个人发现自己的奖金不对,再倒推回来,那时候的代价是几十倍。
复述要产出三样东西:一份条款清单、每条条款在原文里的位置、读不通的地方。
第三样最重要。
你是一名销售绩效分析员。下面是某公司 2024 年季度奖金方案全文。任务:不要写任何代码,只做三件事。1. 用你自己的话,把这份政策复述成一份结构化条款清单。 按「适用范围 / 奖金构成 / 计算步骤 / 门槛 / 封顶 / 例外 / 发放规则」分组。2. 每一条后面标注它在原文中的位置,例如「第 12 页 业绩奖框架」。 凡是你从原文里读出来的,都必须有位置;没有位置的,不许写。3. 单列一节「我读不通的地方」。 凡是存在两种以上合理读法、或者前后条款看似冲突的,全部列出来, 说明两种读法分别是什么,以及它们算出来的结果差多少。 不要替我选,也不要因为「通常都是这样」而省略。约束:- 不许补充原文里没有的规则,哪怕它看起来显然应该如此。- 遇到「除……之外」「但」「经……确认」「特殊情况」这类表述,必须逐字引用。- 复述完先问我确认,我回复之前不要进入下一步。
提示词里最关键的是最后三条约束。
「不许补充原文里没有的规则」管的是它自己发明条款。
「遇到除、但、经、特殊必须逐字引用」管的是丢例外。
「复述完先问我」管的是它一路跑飞。
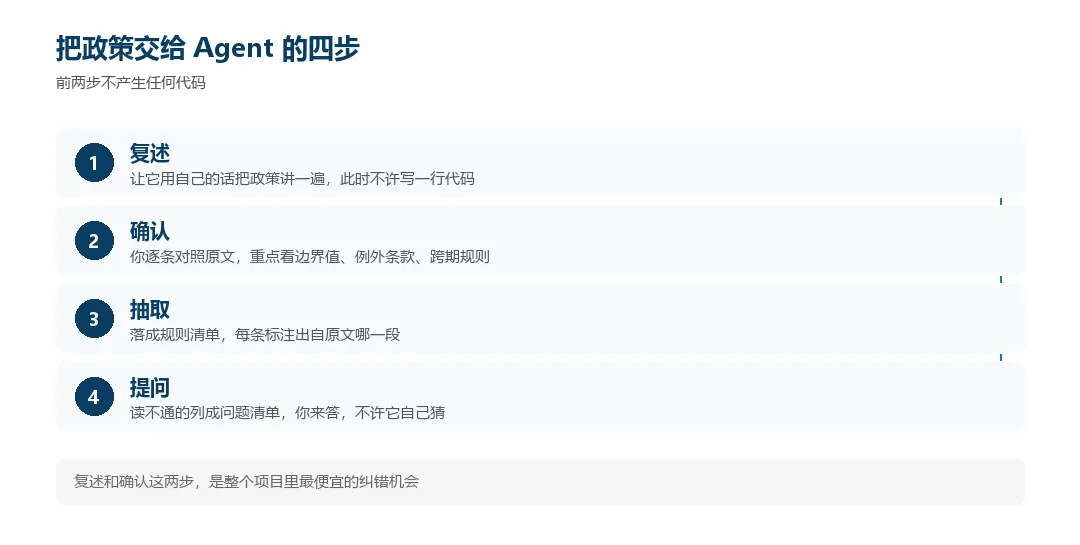
图2 复述与确认的四步
03第二步:抽取成带出处的规则清单
复述确认之后,才让它把条款落成结构化的规则清单。
这份清单是后面所有东西的地基:引擎代码照它实现,测试用例照它设计,半年后政策改版,你也是拿它去 diff。
每条规则必须带三样东西:一个稳定的编号、结构化的参数、以及出处。
rules/policy_2024q4.yaml(片段)
- id: ATTAIN_COEFF name: 达成系数 source: 政策原文 P12《达成贡献奖》 type: piecewise segments: - {lo: 0.00, hi: 0.85, expr: "0"} - {lo: 0.85, hi: 1.15, expr: "3.5 * r - 2.5"} - {lo: 1.15, hi: 1.30, expr: "1.525 + (r - 1.15) * 1.0"} - {lo: 1.30, hi: null, expr: "1.675"} continuity_check: 在 1.15 处两段取值须相等- id: GROWTH_RATE name: 各产品增长奖系数 source: 政策原文 P17《增长奖》表 type: matrix key: [product, group] default: {rate: 0.026, threshold: 0.85} overrides: - {product: P5, group: [BG, GU], threshold: 0.60} - {product: P5, group: [PC], threshold: 0.85}- id: ACCESS_AWARD name: 医院准入奖 source: 政策原文 P24《准入奖》表 type: matrix key: [role, hospital_tag] value: rep: {high: 2000, medium: 1000} dm: {critical: 4000, high: 1000, medium: 500} rm: {critical: 2000} post_rules: - 助理岗最终金额乘 0.92 - 计入本岗位季度封顶 - 同一医院同一剂型多人负责时,按剂型指标占比分摊
注意最后那个 source 字段。它解决的是一个很实际的问题:半年后有人来问「我这一笔为什么是这么算的」,你要能一路追到政策原文第几页。
没有出处,规则清单就只是一堆待维护的配置。有了出处,它是可审计的资产。
04第三步:歧义必须变成问题,不许它猜
真实政策里一定有读不通的地方。这不是文档写得差,是它本来就要覆盖各种边界情况。
举几个常见的。
「季度中提升或转岗,生效日期早于(包括)当季度第三个月的第一天,按新岗位核算」。如果生效日期正好是第三个月第一天,算早于还是等于?这一版写了「包括」,但很多版本的政策没写。
「某财年之前发生的不合规行为,仅取消季度行为奖金」。如果一个人有两条记录,一条在分界年之前、一条之后,怎么判?
「历史终端数据变动超过该岗位当季度总金额的正负 10%,重新计算」。「超过」是严格大于还是大于等于?差 0.1 个百分点,一个季度几十个人就要重算。
这些地方,Agent 一定会自作主张选一个。它不会告诉你它选了,代码看起来也很合理。
现在进入歧义处理环节。规则:1. 凡是原文存在两种以上合理读法的条款,一律不进代码, 改写入 questions.md,格式如下: - qid: Q07 条款: 达成率门槛「超过正负 10% 重新计算」 读法A: 严格大于 10% 读法B: 大于等于 10% 影响面: 涉及当季 34 个岗位,两种读法下 2 个岗位需重算 建议: 采用读法B,与去年执行口径一致2. 每条问题必须写「影响面」:涉及多少人、两种读法差多少钱。 没有量化影响面的问题不要提,说明它不值得占用我的时间。3. 「建议」可以填你的倾向,但必须注明依据, 不许写「通常如此」「业界惯例」这类没有依据的话。4. 我逐条回复之前,不许把任何一条有歧义的规则写进代码。 宁可先留 TODO(qid=Q07),也不许替我做选择。
「宁可先留 TODO」这条要写死。
让它在代码里留一个带编号的占位,比你事后发现它悄悄选了一种读法要好处理得多。
05用规则文件把这些固定下来
上面这些约束,如果每次都在对话里重新说一遍,一定会漏。
更好的做法是写成项目规则文件,让它在每次请求里自动生效。
以 Qoder 为例,规则放在项目根目录的 .qoder/rules/ 下,是普通的 Markdown 文件。它有四种生效方式:Always Apply 全项目强制、Specific Files 按文件通配符、Model Decision 让它自己判断何时用、Apply Manually 手动调用。
对政策解析这件事,用 Model Decision 最合适。它在判断你要解析政策时才加载,平时不占上下文。
.qoder/rules/20-policy-extract.md
---description: 当用户要求解析、抽取、复述奖金或激励政策文档时使用---# 政策解析规则## 硬约束(违反即作废)1. 未经过用户确认的复述,不许进入编码阶段。2. 每一条规则必须带 source 字段,指向原文位置。无出处的规则不许写。3. 不许补充原文中不存在的规则。4. 遇到两种以上读法,写入 questions.md 并留 TODO(qid=...), 不许在代码中替用户做选择。5. 「除 / 但 / 除外 / 特殊情况 / 经……确认」这类表述必须逐字引用原文。## 输出顺序先复述(分七组)→ 再列 questions.md → 等用户确认 → 再生成 rules.yaml## 反例(不要这样)- 直接根据政策写出 calc_bonus.py- 把「达成率 85% 起奖」写成 0.85 而不说明出自哪一条- 对歧义条款写「这里按通常做法处理」
这个文件的价值不在内容多,在于它把「不许做什么」变成了每次都在的东西。
你不在的时候、你换了个人来跑的时候,约束还在。
06三个必然出现的失败模式
不管提示词写得多细,下面三个问题都会出现。不是概率问题,是一定会发生。
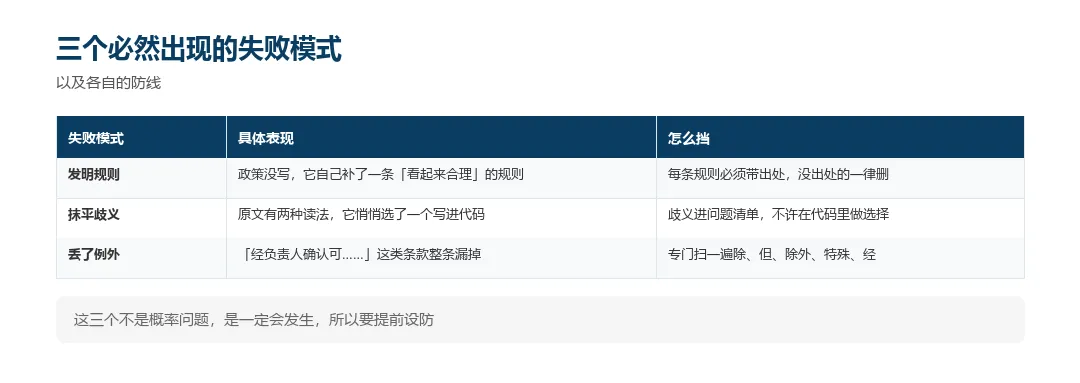
图3 三个失败模式与各自的防线
第一个是发明规则。政策里没写的东西,它自己补了一条「看起来合理」的。比如政策没说负增长怎么扣,它自作主张加了个扣减规则。
防线只有一条:每条规则必须有出处。没有出处的,一律删掉,不管它多合理。
第二个是抹平歧义。原文有两种读法,它在代码里悄悄选了一个,而且不告诉你。
防线是提问清单加 TODO 占位,前面说过了。
第三个是丢例外条款。「经负责人邮件确认,增长金额可以按 0 计算」这种话,往往藏在表格脚注里,它扫过去就漏了。
针对这个,我会在提示词里专门加一句:把所有包含「除、但、除外、特殊、经」的句子单独摘出来列一遍。这个动作很笨,很有效。
Agent 干 通读政策全文、复述成条款清单、标出处、列歧义问题、生成 rules.yaml。
人 干 逐条核对复述是否走了样,尤其边界值和例外条款;回答歧义问题清单;删掉所有没有出处的规则;确认版本号与生效范围。
卡 点 复述确认通过之前不进编码;questions.md 清空之前不许写引擎代码;rules.yaml 必须人签一次版本。
时间账:通读并复述一份四十页政策,人工通常要两三天,Agent 二十分钟出第一版;歧义清单人工逐条拍板仍需半天到一天,这部分省不掉。真正被压缩的是「读懂文档」这个环节,不是「做决策」这个环节。
下一篇讲第二步:怎么让它写出能跑的引擎代码。核心是先定契约,再让它实现。
你现在算奖金,还是靠 Excel 加人工核对吗?
加我微信聊聊,备注【SFE】。也欢迎进医药 SFE 交流群,一起抱团取暖。
扫码加我,备注【SFE】
— END —