ARTICLE · 1178227
Agent 能直接拆开并复刻软件?软件公司还靠什么活?
先说来源。这篇内容基于 InfoQ 编译的一篇文章,讲的是 GitHub 上一个叫 REA 的项目。我挑出对做 B 端软件、做交付的人最有价值的部分,加上自己的判断。
一、REA 是什么,为什么值得聊
截至 10 月 12 日,这个叫 REA(Reverse Engineer Anything)的仓库已经攒了 12 万颗星。作为参照,年初那个引爆全民热潮的 OpenClaw,爆发第三天累计新增是 6 万颗星。
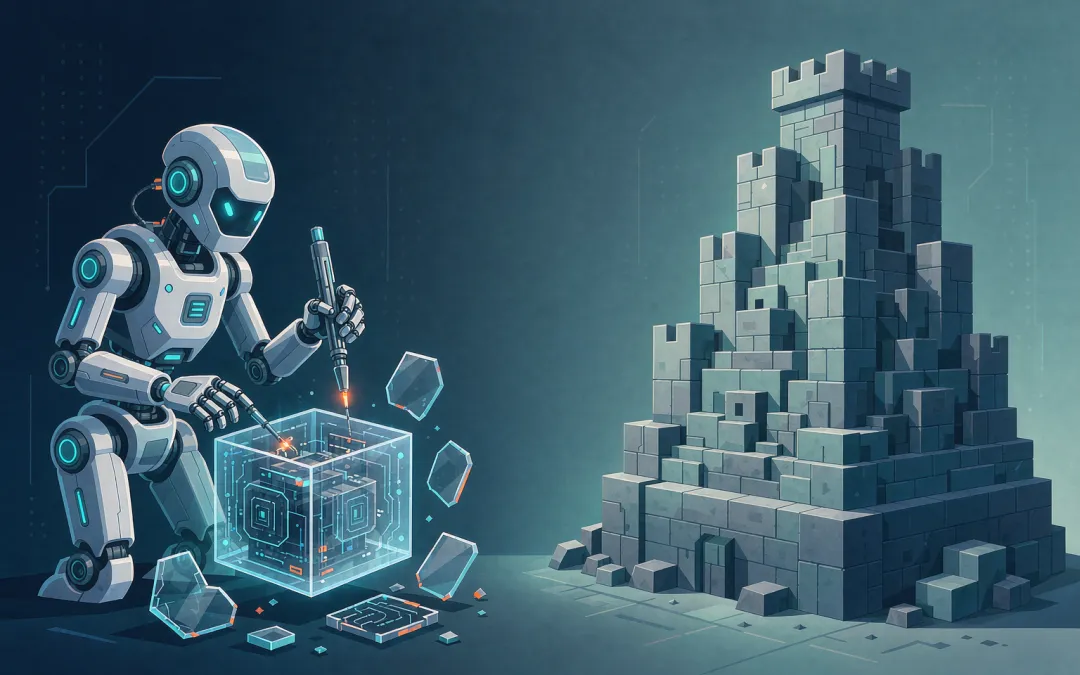
它做的事,用作者自己的话说:让 Agent 去逆向分析一切,从应用行为一路深入到原生二进制。
路径并不复杂——用 Claude Code、Codex 这类 AI 编程助手,通过 MCP 接管 Ghidra、Hopper 这些老牌逆向工具,让模型能读懂没有源码的软件,追踪某个功能的实现线索,然后照着写一个相似版本。
它覆盖的范围比想象中宽:
- 原生程序
:Mach-O、ELF、PE,以及 macOS 的 .app 包,包含 Swift 和 Objective-C 元数据 - 各类程序包
:ZIP、APK、IPA、ASAR,甚至不解压就能生成文件清单 - Electron 和 JavaScript 应用
:静态梳理入口点、模块、IPC 通道、preload 脚本和 source map,不用把应用跑起来 - 网站
:通过本地 Chrome DevTools 端点,被动观察你已经控制的浏览器 - .NET 托管程序
:不执行程序也能检查元数据和成员 - 版本差异分析
:比较同一个应用的两个版本,输出变更报告
这份清单里,最该让做 B 端产品的人警惕的,其实是后面几条。因为它拆的不是算法,是你系统的结构——模块怎么分、进程怎么通信、数据怎么流转,全在里面。
二、技术一点都不新,新的是「谁来操作」
有个事实容易被忽略:REA 调用的那些工具,没有一个是新的。Ghidra 早在 2019 年就开源了,Hopper 的历史能追溯到 2011 年,IDA 更是上世纪 90 年代就是逆向工程师的标配。
逆向工程这件事,存在了几十年。它之所以没变成人人都会的技能,是因为门槛在"人"身上——你得会找反汇编器、啃它的 API、在一堆符号里翻来覆去、手动追调用图,还得在几个工具之间来回倒腾文本。绝大多数业务开发者,没时间也没必要学这个。
REA 做的事,本质上是把这套硬功夫的调度权交给了 Agent。
今年 4 月已经有类似的实战:一位安全人员用 Cursor 配合 Opus,从普通游戏一路拆到了银行类 App。他事后总结,很多 App 的逆向时间在 30 分钟上下,花费不到 5 美元。
所以真正的变化不是"能不能逆",而是成本曲线被压平了。以前逆一个 App,需要一个熟练的逆向工程师干上好几天;现在,半小时、几美元。当一件事的成本下降两个数量级,它就从少数人的手艺,变成了常规手段。
三、那么问题来了:护城河到底在哪
原文采访了几位专家,观点出奇一致:护城河不在代码里。
技术专家徐昊的说法我印象很深——克隆能拿走的是代码,拿不走的是知识。面对一个没有源码的软件,重点从来不是"用另一种技术把它重写一遍",而是去推断它的业务逻辑,搞清楚它到底在干什么。"你把它重演出来,我觉得这东西没什么意义。"
另一位受访者阎志涛(QuickCreator 联合创始人)给了一个很锋利的反问:如果源码一旦可以获得,软件生意就无法继续,那开源软件的商业模式早就应该不存在了。
这个逻辑很难反驳。开源项目的代码本来就人人可看、可研究,也可以在许可证允许的范围内修改使用,但企业仍然在买商业订阅、托管和技术服务。以 Red Hat 为例,它的订阅说明里列出的价值是:面向生产环境的软件、生命周期管理、兼容性、补丁和更新、技术支持。客户花钱买到的,明显超出"下载一份代码"。
代码的可获得性相同,服务能力、客户关系和履约记录却可以差很远。 这才是那门生意真正的支撑点。
四、我在工业软件里看到的,和这个判断完全对得上
我在 MES 行业做了几年,读到这个结论时有种"原来如此"的感觉——因为它早就发生在我们这行了。
客户买的从来不是那套代码。
同一套 MES,装到 A 厂能用,搬到 B 厂就水土不服。原因不复杂:工艺路线不一样,设备型号不一样,班次规则不一样,连报工的粒度要求都不一样。这些差异不会因为你拿到了源码就自动消失。
交付一个大项目,写代码的时间大概只占三成。剩下七成花在哪?需求梳理、现场实施、数据迁移、权限梳理、培训和上线后的长期运维。这些工作没有一行是"写代码"。
客户的信息部完全可以自己开发,他们也有这个能力。但他们通常不选——因为要养一支既懂工艺流程、又懂系统架构的团队,成本比向专业供应商付费高得多,而且这套能力还得长期存在,不能项目结束就散。
所以像 REA 这类工具,对 MES 这种系统的冲击,其实比我预想的小。
但反过来看,有一类公司会非常危险。
五、真正危险的,是这三种公司
第一种,产品价值就等于"功能本身"的。 你的竞争力就是那几个功能点,别人拆出来照着做一个就能用,那你确实没有防线。
第二种,靠信息不透明赚钱的。 客户不清楚你是怎么实现的,所以只能选你。一旦实现路径变成公开信息,这层溢价就没了。
第三种,躺在成绩上不更新的。 原文里那句话很扎心:问题已经不再是"会不会有人克隆你",而是"什么时候被克隆,以及克隆你的人会不会跑得更快"。
我自己想补一条判断:功能型的产品最危险,服务型的产品最安全。 这也是为什么我一直认为,在工业软件这个领域,只做标准化产品、不碰实施和服务的路线,长期是走不通的——不是说产品不重要,而是产品只能证明你能用,服务和交付才决定客户敢不敢用。
六、但也别高枕无忧
原文里有一句提醒,我觉得比"护城河换位置"更值得警惕:
服务体系本身,也会被 AI 改变。
过去需要很多人力完成的排查、文档整理、配置检查,以及一部分实施工作,将来可能由更小的团队借助 AI 完成。如果新公司既能做出合适的产品,又能以更低的成本提供可靠服务,它就有机会一步步建立客户信任。原有的服务商不能因为自己手里有完整体系,就认定这个优势会永远保持。
这话放到制造业特别成立。做实施的人都知道,最耗人力的从来不是开发,是配置和文档——每一家客户的工艺参数、班次规则、报表口径都要单独适配一遍。如果这部分能被 AI 大幅吃掉,小团队的交付能力会明显跃升,反过来对大厂构成威胁。
最后
护城河没有消失。它只是从"你看不到我的代码",挪到了"你拿不走我的服务能力和业务理解"。
对做技术的人来说,这意味着两件事:
一是写代码这件事本身在贬值。不是说不重要,而是它正在从"稀缺能力"变成"基础能力",光靠它撑不起溢价。
二是你懂哪门生意的哪一部分,才是新的定价基础。同样是后端,懂制造业排产的,和只会写 CRUD 的,未来会越来越不像同一个职业。
我自己的答案很简单:把工艺知识、行业 know-how 变成别人拿不走的东西。代码可以被拆开,但这几年在现场踩过的坑、和客户业务部门吵过的每一架,拆不走。
以上是我的理解,供参考。
(本文基于 InfoQ 编译文章整理,观点部分为个人判断。)