ARTICLE · 1179084
安卓9也能看细字!AI却不敢带路
【导读】Gemini Live正在给手机镜头加上实时讲解:读小字、找物品、追问保质期,安卓9及以上设备也有入口。最大的反差也写在谷歌的警告里——它能描述眼前,却不能承担导航、避障和安全出行。
企业准备上线视觉功能,先把任务分成两类:答案能让用户复核的,和出错会影响人身安全的。前一类可以先做,后一类必须设置禁止区和替代方案。Gemini Live这次更新正好给了一个样本:把镜头对准一件商品,手机会告诉你面前是什么;再追问一句保质期,它还能继续寻找包装上的日期。
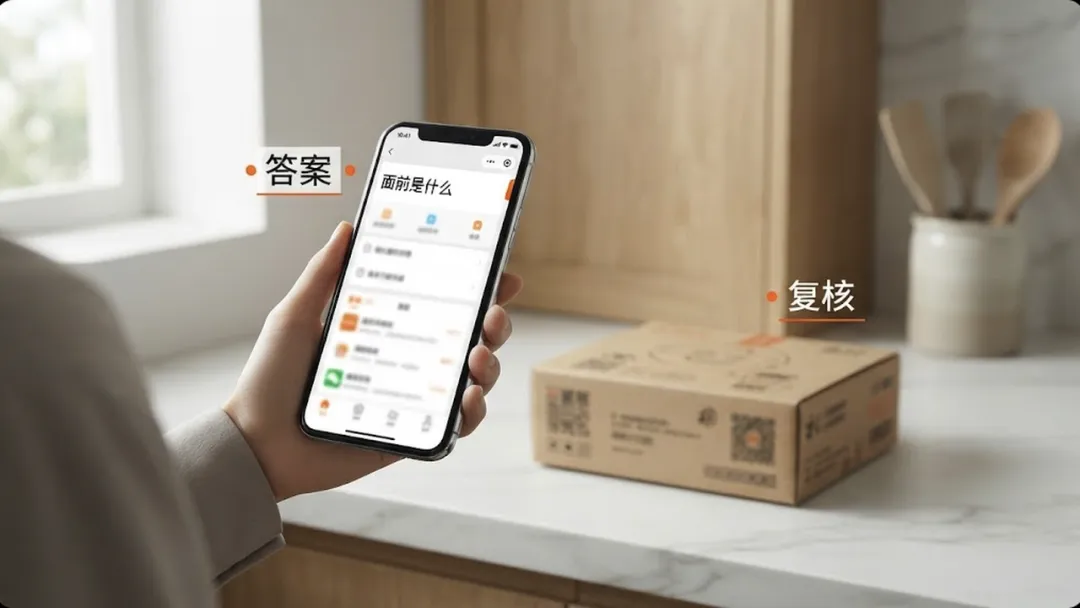
手机镜头识别商品
可当用户把镜头转向脚下的路,边界立刻出现。谷歌明确提醒,Guided Vision不能用于“navigation, safe-travel guidance, or obstacle detection”,也不能替代手杖或其他行动辅助工具。
这次更新最值得看的,恰好是能力和责任同时向前了一步。AI已经从识别一张静态图片,走到持续观察现实、接受追问、指导镜头调整;它离真正替人行动仍隔着一条清楚的安全线。
手机镜头开始实时开口
据The Verge 10月2日报道,Guided Vision正在Gemini Live中向兼容的安卓设备推出。用户分享手机摄像头后,AI会对镜头所指的内容给出实时语音描述。
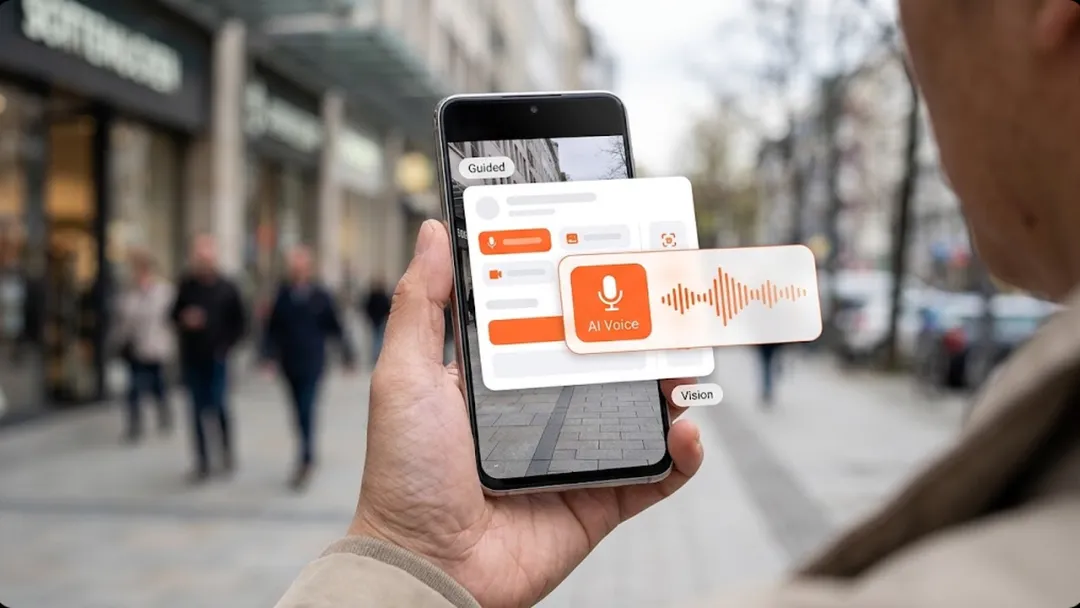
Guided Vision实时语音描述
官方给出的场景很具体:读取细小文字、描述周围环境、寻找或识别身边物品,以及说明某个物体上的细节。它面对的已经不再是一道脱离现场的问答题,而是用户此刻正举着手机、等待答案的现实任务。
这让交互发生了一个关键变化。过去,用户要先拍照、上传、组织问题,再等模型解释;现在,摄像头持续提供画面,语音持续承接问题,观察和追问被放进同一段对话。
对低视力用户来说,价值也由此变得直接。看不清包装小字时,无需先辨认文字在哪;找不到某件物品时,可以让AI先描述附近,再围绕目标继续追问。
这类能力看上去只是“多了一双眼睛”,实际改动的是信息入口。文字、物体和环境细节不再等用户主动录入,它们随着镜头进入对话。
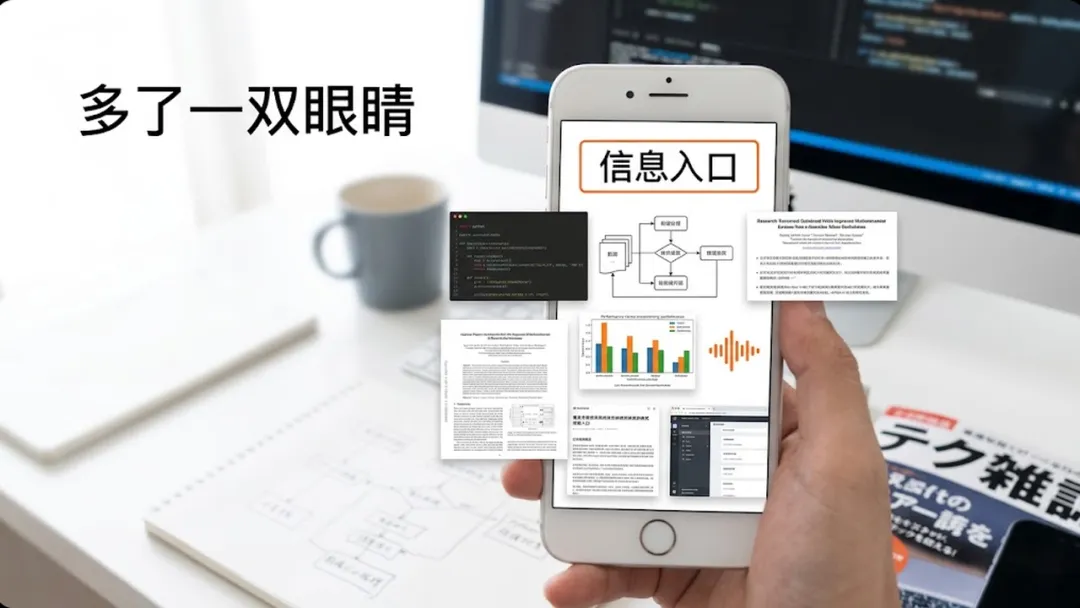
多一双眼睛的实时描述
安卓9把门槛压低了
这项功能除了进入Gemini应用,也能在Google TalkBack中使用。运行安卓9及以上系统的设备,还可以在设置中建立无障碍快捷方式。
“安卓9及以上”是这次更新里很容易被忽略的数字。它说明入口没有只压在最新一代设备上。真正决定覆盖面的,将是兼容设备范围、功能分发节奏,以及用户能否顺利找到这个入口。
The Verge把它与苹果在iPhone和Vision Pro中加入的VoiceOver Live Recognition相提并论。两家公司走向了同一个交互方向:摄像头负责感知,AI负责把视觉信息转成能立刻听懂的描述。
但这也让竞争标准发生变化。识别出“这里有一个瓶子”只是起点;用户随后会问它在哪里、标签写了什么、是不是刚才寻找的那一个。一次识别的准确度,正在让位给连续交流中的可用性。
识别准确度与可用性
企业做视觉产品也会遇到同样的变化。模型能力只是底层,真正进入产品后,还要处理摄像头角度、用户追问、声音反馈、失败提示和安全边界。少一个环节,现场体验就可能断掉。
追问保质期,难点在镜头外
报道给出的代表场景,是让Gemini读出刚刚帮用户找到的物品保质期。这里至少包含两次连续动作:先找到目标,再锁定包装上的日期。
如果目标没有出现在画面里,Gemini会给出语音提示,帮助用户调整摄像头方向。这个细节很重要,因为现实世界不会像测试图片那样,把主体端正地放在画面中央。
瓶身可能反光,标签可能在背面,小字可能落在镜头边缘。报道没有承诺这些困难都已解决,却展示了产品如何面对最常见的失败:它会先提醒用户把镜头重新对准。
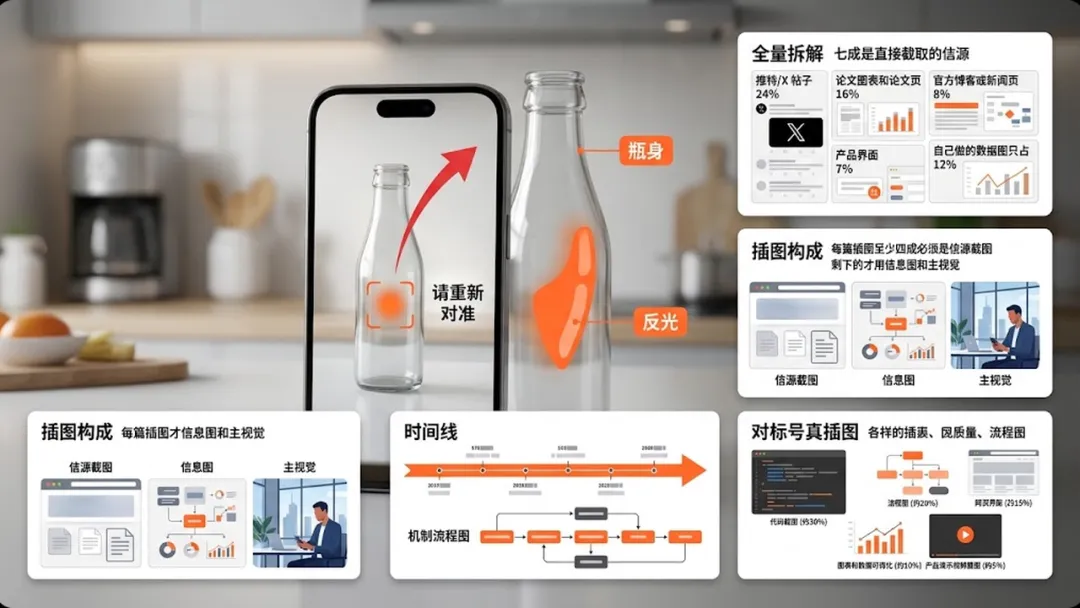
镜头重新对准提示
由此可以看出,现实中的视觉AI需要同时管理两件事。第一件是理解画面,第二件是帮助人获得一张更容易理解的画面。后者决定了能力能否从演示视频走进日常使用。
这也是Guided Vision比普通图片问答更值得关注的地方。它把“看见什么”和“接下来怎么拍”连在了一起,AI开始参与信息采集过程,而不只处理已经准备好的输入。
对开发者而言,新的产品机会也藏在这里。任何需要用户对准设备、零件、货架、票据或包装的场景,都可以借鉴这种闭环:先描述现状,再用语音纠正采集方向,最后回答具体问题。
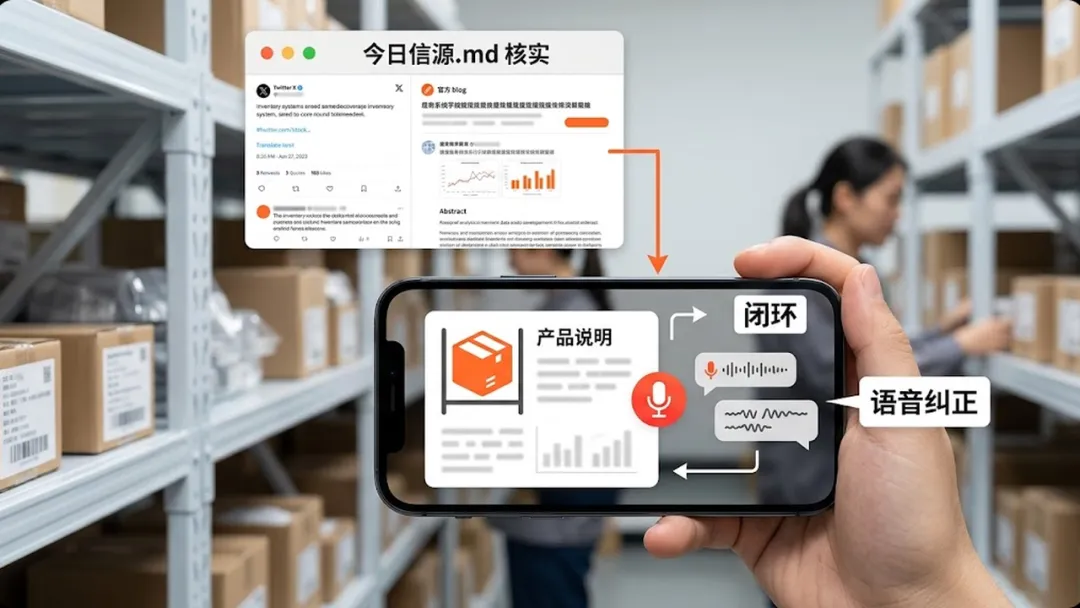
闭环语音纠正流程
越像眼睛,越要划清禁区
谷歌没有把Guided Vision包装成电子导盲工具。报道明确写到,公司提醒用户不要依赖它完成导航、安全出行指导或障碍物检测。
这三项禁区指向同一种风险:答案慢一秒、漏掉一个障碍、判断错一个方向,都可能带来现实后果。读错一行小字可以重试,错过台阶却没有同样的容错空间。
所以,能力演示和安全承诺必须分开看。它可以描述环境,也可以帮助寻找物品;当问题进入路径选择和身体安全,它的角色只能停在辅助信息层。
报道还特别说明,它不能替代手杖或行动辅助工具。这句话给整个产品定下了边界:AI可以增加感知信息,用户原有的安全工具仍要保留。
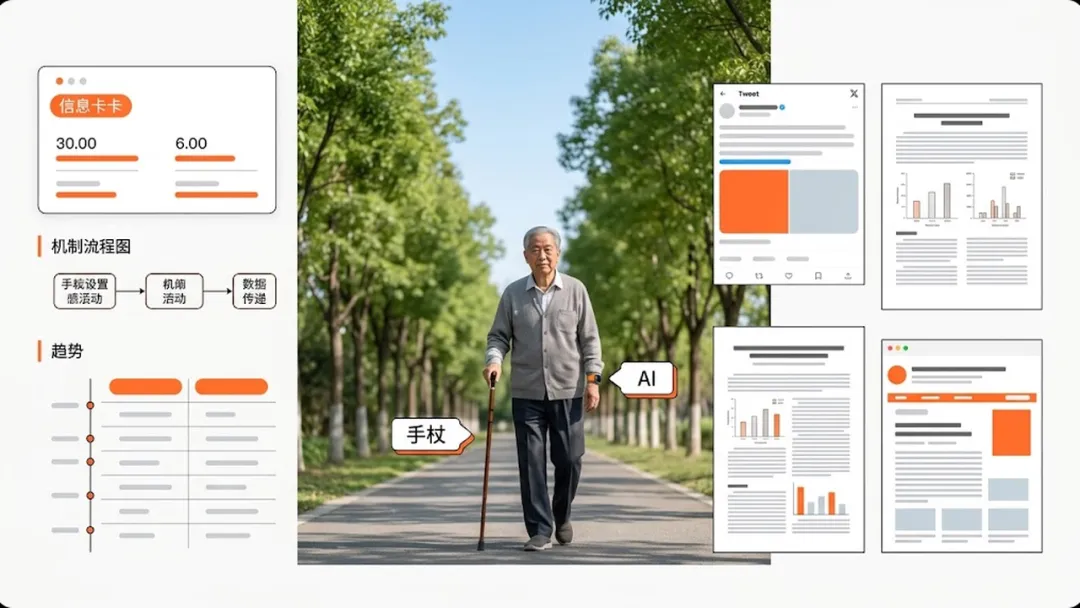
AI与手杖并行使用
这种边界并不会削弱产品价值,反而让用途更可信。用户知道哪些任务可以交给它,哪些时刻必须依靠经过验证的工具,才有可能形成稳定使用习惯。
对于所有准备把摄像头识别和语音问答接入真实场景的公司,这也是一条可复制的原则:功能页面要同时写清“能做什么”和“不能承担什么”。当AI开始影响人的行动,免责声明已经不够,限制需要直接进入交互。
AI的下一站,是承担现实后果
这次更新展示了一条清晰路线:先从低风险、可复核的任务切入。读一段小字、确认一个物品、描述一个细节,用户都能通过追问或重新对准镜头获得第二次机会。
一旦任务跨进导航、避障和安全出行,产品面对的就不只是模型回答质量。延迟、摄像头覆盖、环境变化和错误恢复,都会进入同一条责任链。
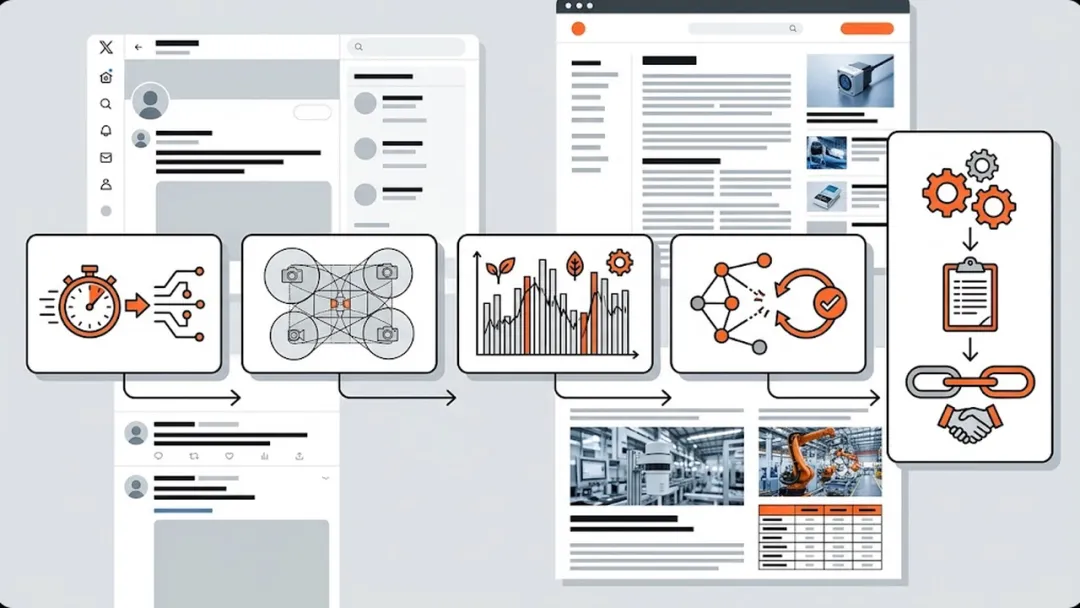
责任链要素
这件事对企业用AI的启示只有两层。第一层,实时视觉已经可以被做成面向普通用户的连续服务,摄像头正在成为新的AI入口。第二层,越接近现场行动,产品越需要提前定义禁止区和替代方案。
判断一项视觉AI值不值得接入业务,就检查三个问题:用户能否复核答案,画面不足时系统能否指导用户重新采集,高风险任务出现前系统能否及时停下。功能越靠近现实,产品设计越不能只展示成功的一次。
企业真正该关注的信号,也在这组反差里:一个覆盖安卓9及以上设备的新入口,能读小字、找物品、回答追问,却主动放弃最诱人的“替人带路”。接下来这类能看画面、能听人提问的产品,拼的不只是谁看得更多,还要看谁敢为自己的答案负责。
参考资料
1. The Verge:Google’s new Guided Vision feature can help you read the fine print
https://www.theverge.com/ai-artificial-intelligence/1003756/google-gemini-live-guided-vision