ARTICLE · 1182208
使用WorkBuddy处理扫描版的PDF建议调用IMA连接器
使用WorkBuddy处理扫描版的PDF建议调用IMA连接器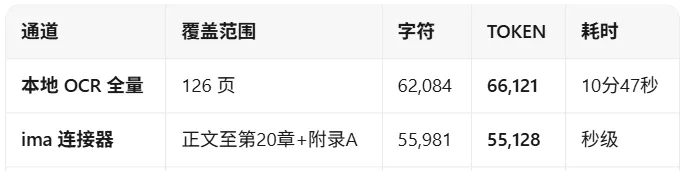
近期使用WorkBuddy时发现同一个PDF文件在IMA知识库内用WorkBuddy调用时无问题,但是将这个文件下载到本地后,用WorkBuddy调用这个本地文件时会出现无法读取的问题(后确认为扫描版的PDF需OCR)。
WorkBuddy给出的解释是:ima连接器读的是「解析结果」,不是 PDF 文件,而下载后是源文件,扫描版的PDF,无OCR技能无法读取。
我扒了连接器的实现:
插件位置 ima-mcp/0.0.0-wb.fac085d46643602c/mcp.json → 指向 https://ima.qq.com/mcp
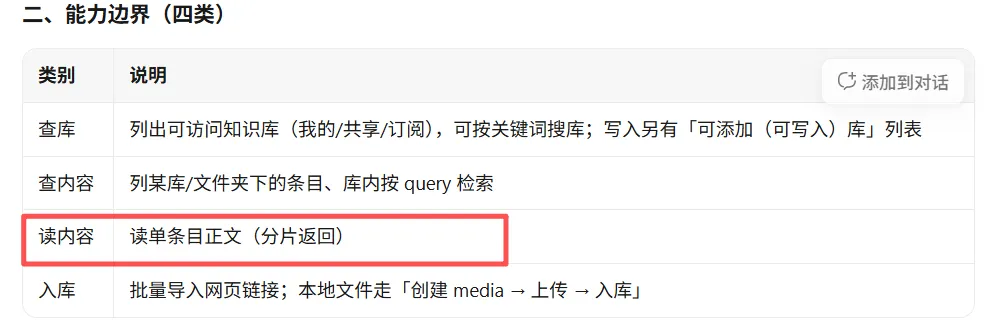
SKILL.md 明确写着:读内容是「读取单个条目的正文,按分片顺序返回」
有完整解析状态机:MEDIA_PARSING / MEDIA_PARSE_SUCCESS / MEDIA_PARSE_ERROR
也就是说,你把 PDF 存进 ima 时,腾讯服务端已经替你做了解析(含 OCR)。连接器拿到的是切好片的文本/结构化内容——干净的、已经能回答问题的数据。它压根不碰 PDF 二进制。
安装OCR技能后,我把一个126页的扫描版的PDF用WorkBuddy调用IMA连接器和WorkBuddy使用OCR技能读取两者消耗的token及耗时做了对比。token消耗IMA略少,耗时上IMA连接器秒级读取,OCR耗时10分钟47秒。
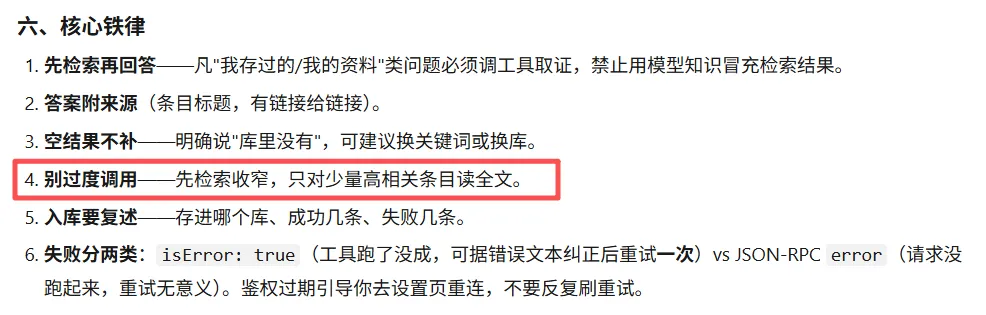
在实际使用过程中,IMA连接器只返回你需要的内容,在技能说明里面明确有这个要求。
SKILL.md 里写得很明白:「读单条目正文(分片返回)」「先检索收窄,再对少量高相关条目读正文」。这种方式更有效的节省token。
所以省时省钱用WorkBuddy调用IMA连接器!!