ARTICLE · 1183218
AI开始自己拆App了:REA爆火背后,移动端架构师该重新理解"逆向"
AI 开始自己拆 App 了 · REA
移动端架构师视角的每周范式判断 · 附自制架构图
Ghidra、IDA 一个字都没改,变的是谁在开它。
你有没有过这种时刻:盯着一个竞品 App 里的一段交互看了很久。
一个很轻的手势,滑到一半松手,卡片会回弹到三分之一处停住,再滑一下才走。这个“半途而废”的阻尼,一看就是花了心思调出来的。你特别想知道它怎么实现的。
按过去的做法,你得下载 APK,反编译成 smali,在几千个类里翻动画相关代码。运气好两天能找到,运气不好一周。大多数时候,你在第二天就放弃了。
现在的情况是:把 APK 丢给 Agent,问一句“这个回弹阻尼怎么做的”,十几分钟后,你拿到的不是一段“看起来挺像”的代码,而是一串证据——某个类、某几行反编译结果、对应的字节偏移,以及一句很诚实的话:“这个插值函数我只还原了70%,剩下部分的覆盖不完整。”
那个敢说“我不确定”的东西,就是今天要拆的 REA。
01
PART
它到底是什么
WHAT IS REA
REA 全称 Reverse Engineer Anything,中文可以直译成“逆向任何东西”。它给自己的定位是:一个 MCP,覆盖二进制、应用程序和运行时行为。
那些工具一个字都没改 ——Ghidra、IDA、Hopper 都还在原地,变的只是:谁在开它。
过去是人打开 GUI,手动追交叉引用,一天啃两三个函数。现在是Agent 通过 MCP 调用这些工具,自己完成“打开目标、搜字符串、追引用、看调用图、读反编译、重建实现、跑测试”这一整条链路。
装起来也就一行命令 npx rea-agents setup ,然后选你要接入的 Agent,Claude Code、Codex、Cursor、Gemini CLI都在支持列表里。
它能分析的目标有二十多类。挑几个会让移动端同学当场坐直的说:
Android APK Flutter iOS 的 Swift 和 Objective-C 类结构 JavaScript 和 Electron 应用
换句话说,“看懂一个竞品功能”这件事,正在从“要不要花两周”变成“要不要花一个下午”。
REA 的骨架分三层。入口层把 REA 注册进你的 Agent;工具层是一堆分析桥,原生二进制走你机器上已有的 Ghidra、IDA 或 Hopper,JS 和 Electron 直接做静态分析,不需要任何原生引擎;证据层是它真正克制的地方——每条结论都必须带着证据回来。
ARCHITECTURE
REA 的四层结构与贯通全链的证据通道
图示:整条链路本地运行,被分析的目标文件不会离开你的机器。
02
PART
四个范式转移
FOUR SHIFTS
我拆架构这么多年,判断一个项目是不是范式级,就看它有没有让某件事的默认做法发生位移。REA 让四件事位移了。
第一个,驱动权
这是最根本的一条。二十年来,逆向工具的第一用户是“会用工具的人”。Ghidra 的每一个菜单、IDA 的每一个快捷键,都是为人类手指设计的。REA 之后,工具的第一用户变成了 Agent,人退到上游,只负责两件事:给方向,以及验收结果。
人操作 GUI
手动追交叉引用,一天啃两三个函数
Agent 驱动
人只给方向 + 验收结果
这跟从手写汇编到写 C 的那次转移是同一类。不是工具变强了,是操作者变了。
第二个,接口层
REA 把十几种彼此不通气的工具,Ghidra、IDA、JADX、Frida、GDB、Wakaru、Binwalk、Playwright、TShark,全部收编进一份 MCP 工具目录。
这里我想多说一句:MCP 正在变成工具的“新 ABI”。就像当年内核用一套系统调用把五花八门的硬件抽象掉,今天 Agent 用一套 MCP 协议,把五花八门的工具抽象掉。
如果你在做移动端基础设施——埋点、包体积、性能采集、崩溃聚合——这可能是接下来两年最值得提前想清楚的接口决策:你的工具,要不要留一个供 Agent 调用的入口?
第三个,输出物从结论变成了证据链
这是 REA 和“AI 帮你写代码”最大的区别。
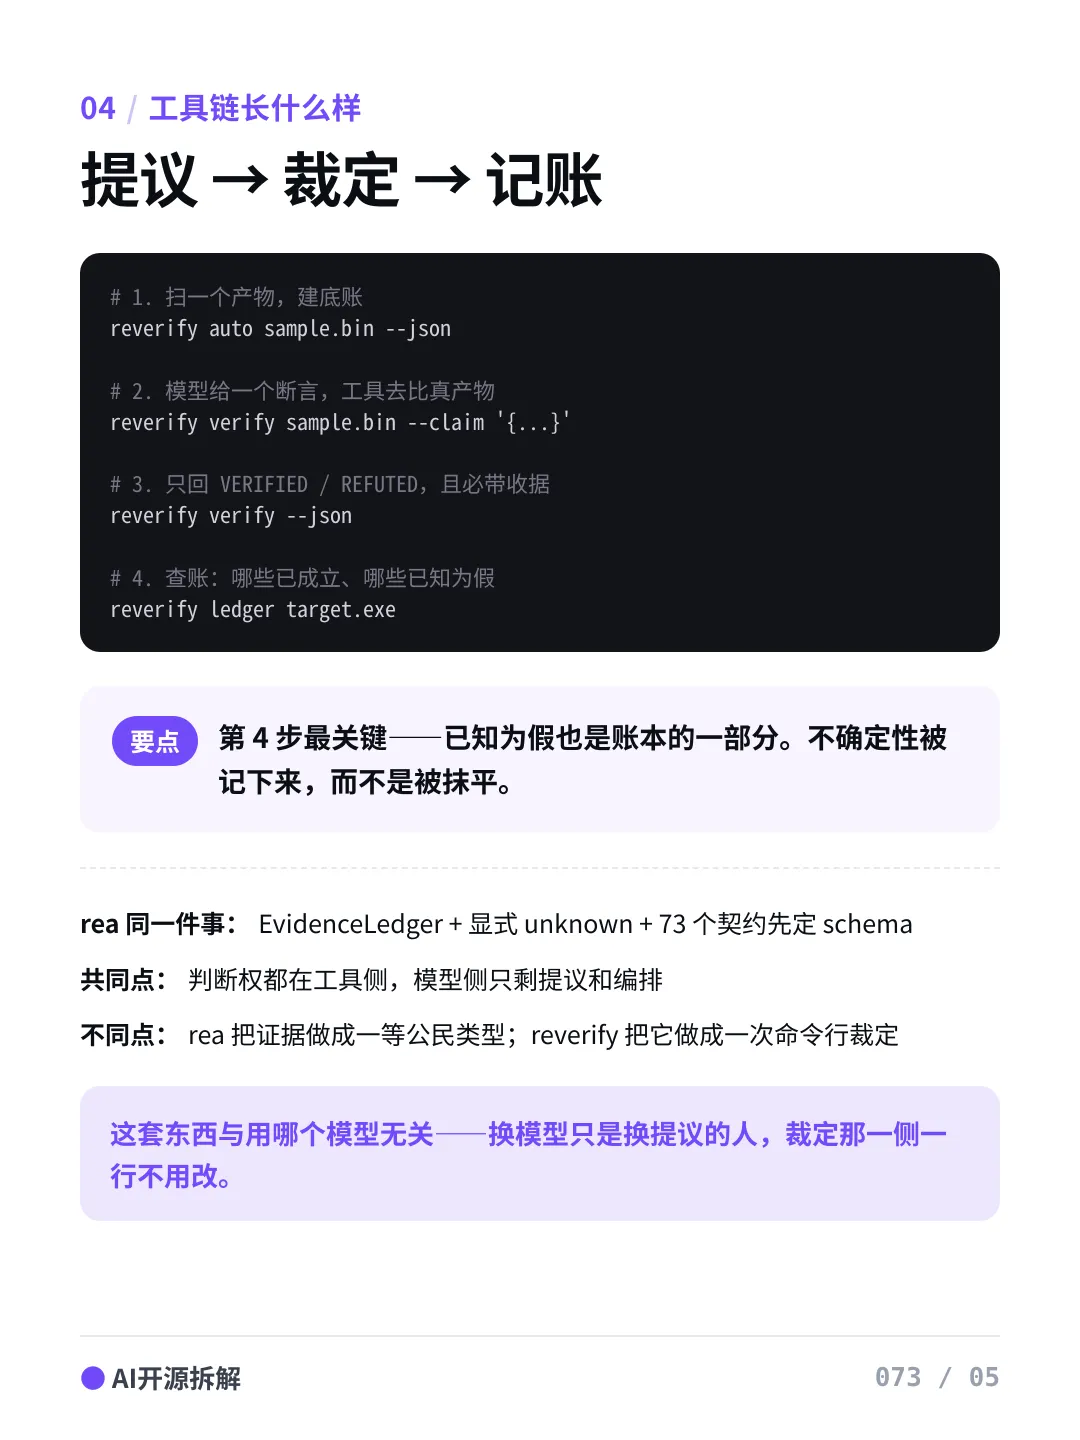
它给你的不是一段看着挺对的反编译结果,而是一个结构化的证据包:代码引用、字节偏移、调用关系,以及一份写明的局限。它的覆盖范围只有两种状态,要么完整,要么未知,缺失直接拒绝。
它还专门定义了三种“不好看但必须说”的状态:不知道、被截断、自相矛盾。并且规定,要得出“两个二进制相等”这个结论,必须同时满足范围匹配、图成员完整、遍历完整三个前提。
静态相等,不等于运行时行为不变。 这句话,值得你抄进团队的代码规范里。
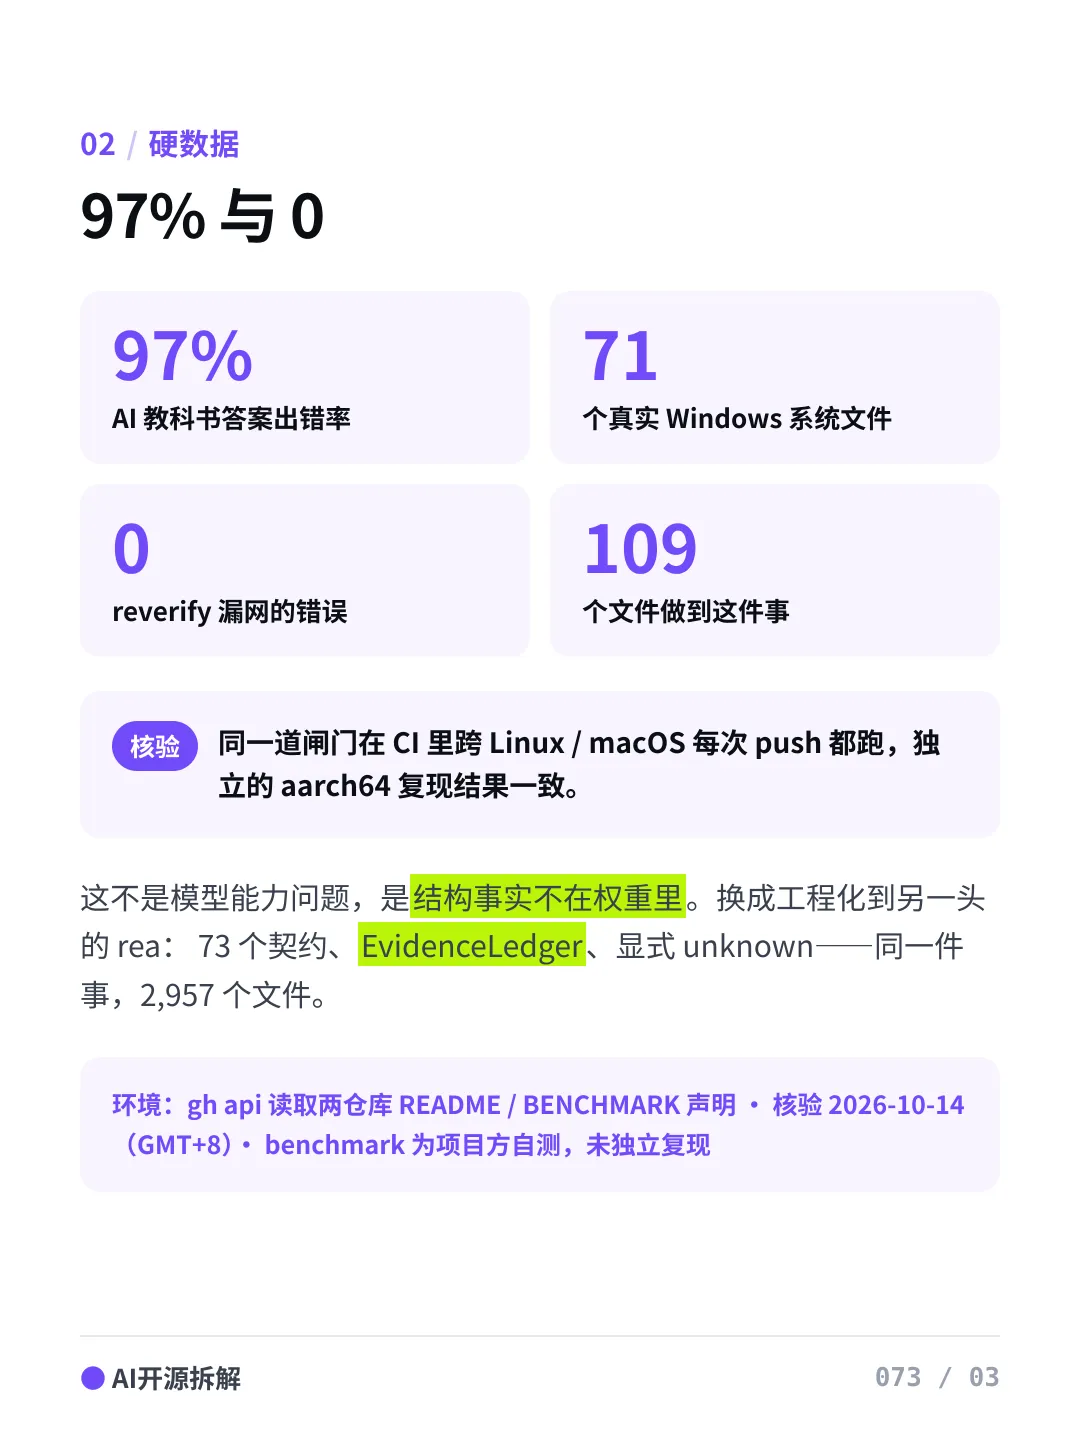
这不是 REA 一个人的洁癖。另一个项目 reverify 把它做到了极端:它拿 71 个真实的 Windows 系统文件做测试,不让 AI 看文件、只凭脑子里那点知识答,97% 全错了。而它自己的工具上去查,71 个一个不落全给抓出来了。而且测的不是弱模型,用的是当下最强的那批。
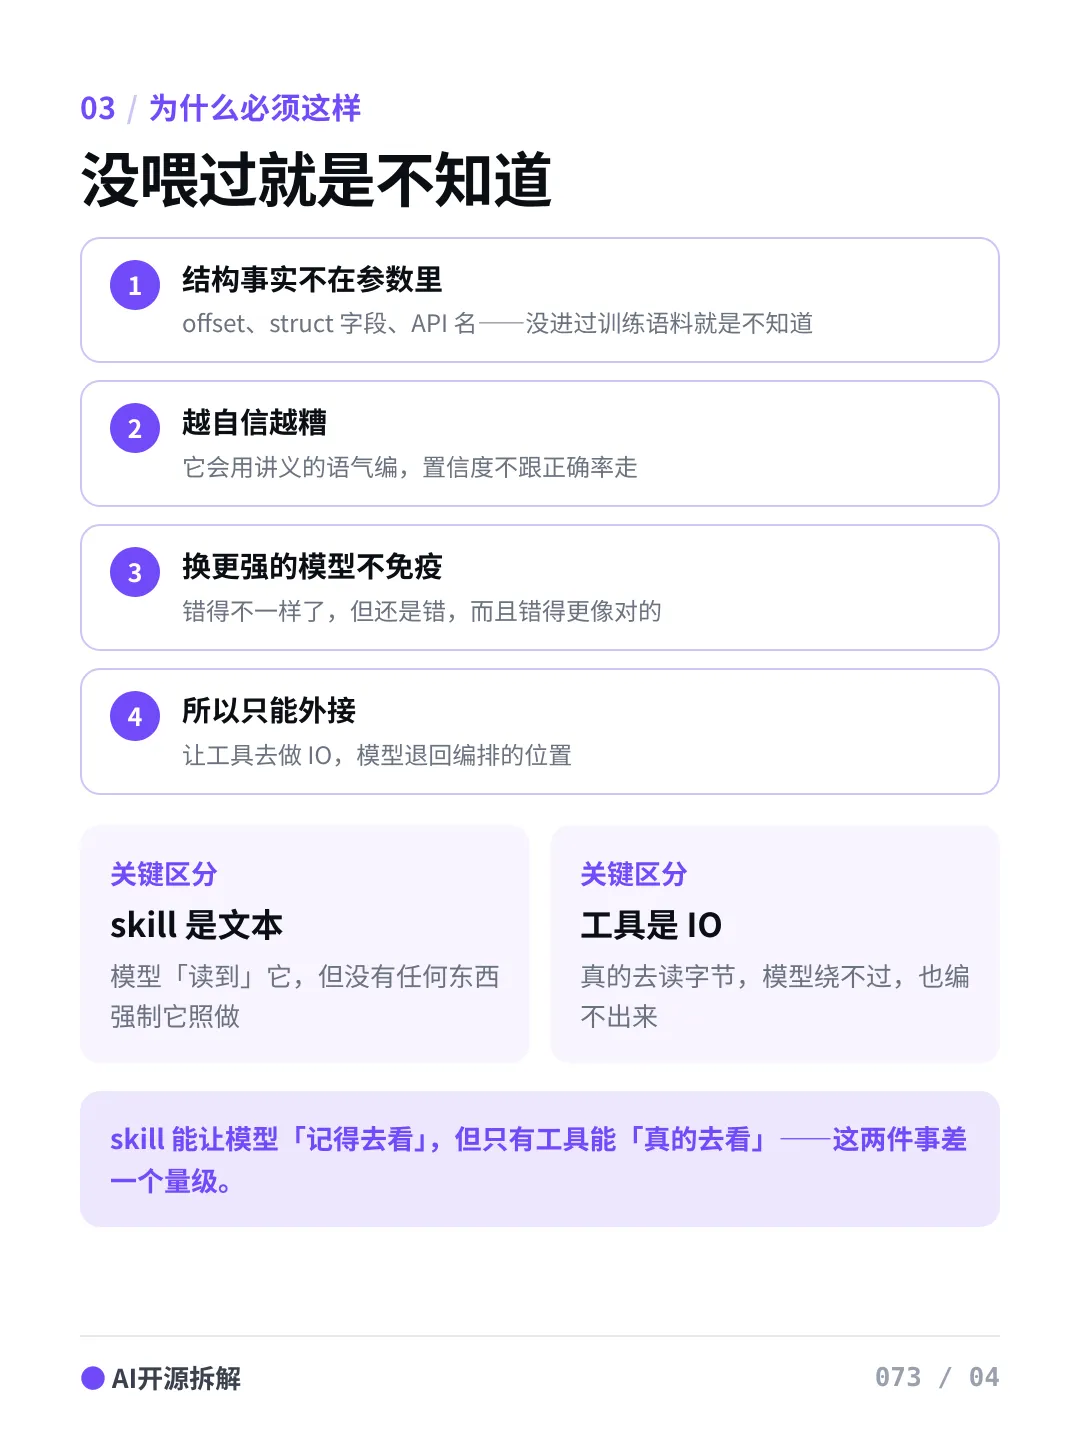
所以那三种「不好看但必须说」的状态——不知道、被截断、自相矛盾——不是产品洁癖,是这类工具能不能被信任的分水岭。
第四个,失败的语义变了
普通工具失败就是报错、中断、成果清零。REA 的失败是一条数据:它带回部分观察结果,带回原子写入的发布回执和字节数。
做过 AI 流水线的人都懂,最怕的不是失败,是“静默重试到成功”。因为你已经不知道这个结果到底来自哪一次尝试、由哪个引擎产生。REA 干脆把这条路堵死:选中的分析引擎失败之后,绝不被自动替换。
不止 REA 一个
NOT JUST ONE
我原本以为这套「让工具来裁定」的玩法是 REA 挑的。扒了一圈才发现不是。半年里至少三个项目在独立做同一件事,而且互相之间没有任何 fork 关系,谁都懒得抄谁。
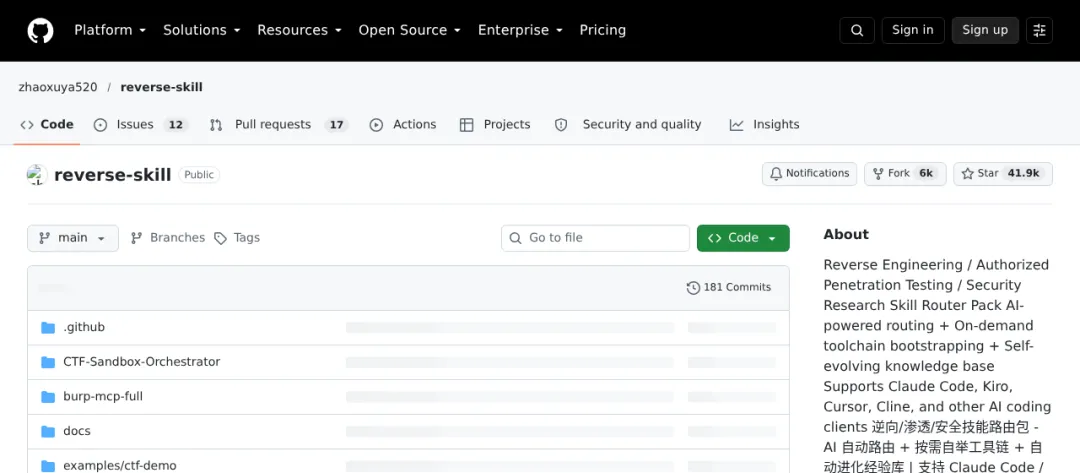
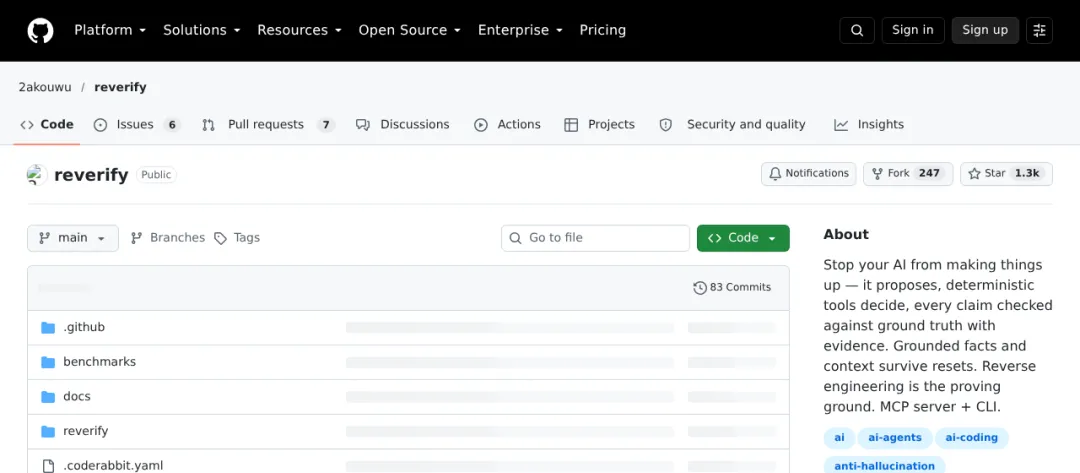
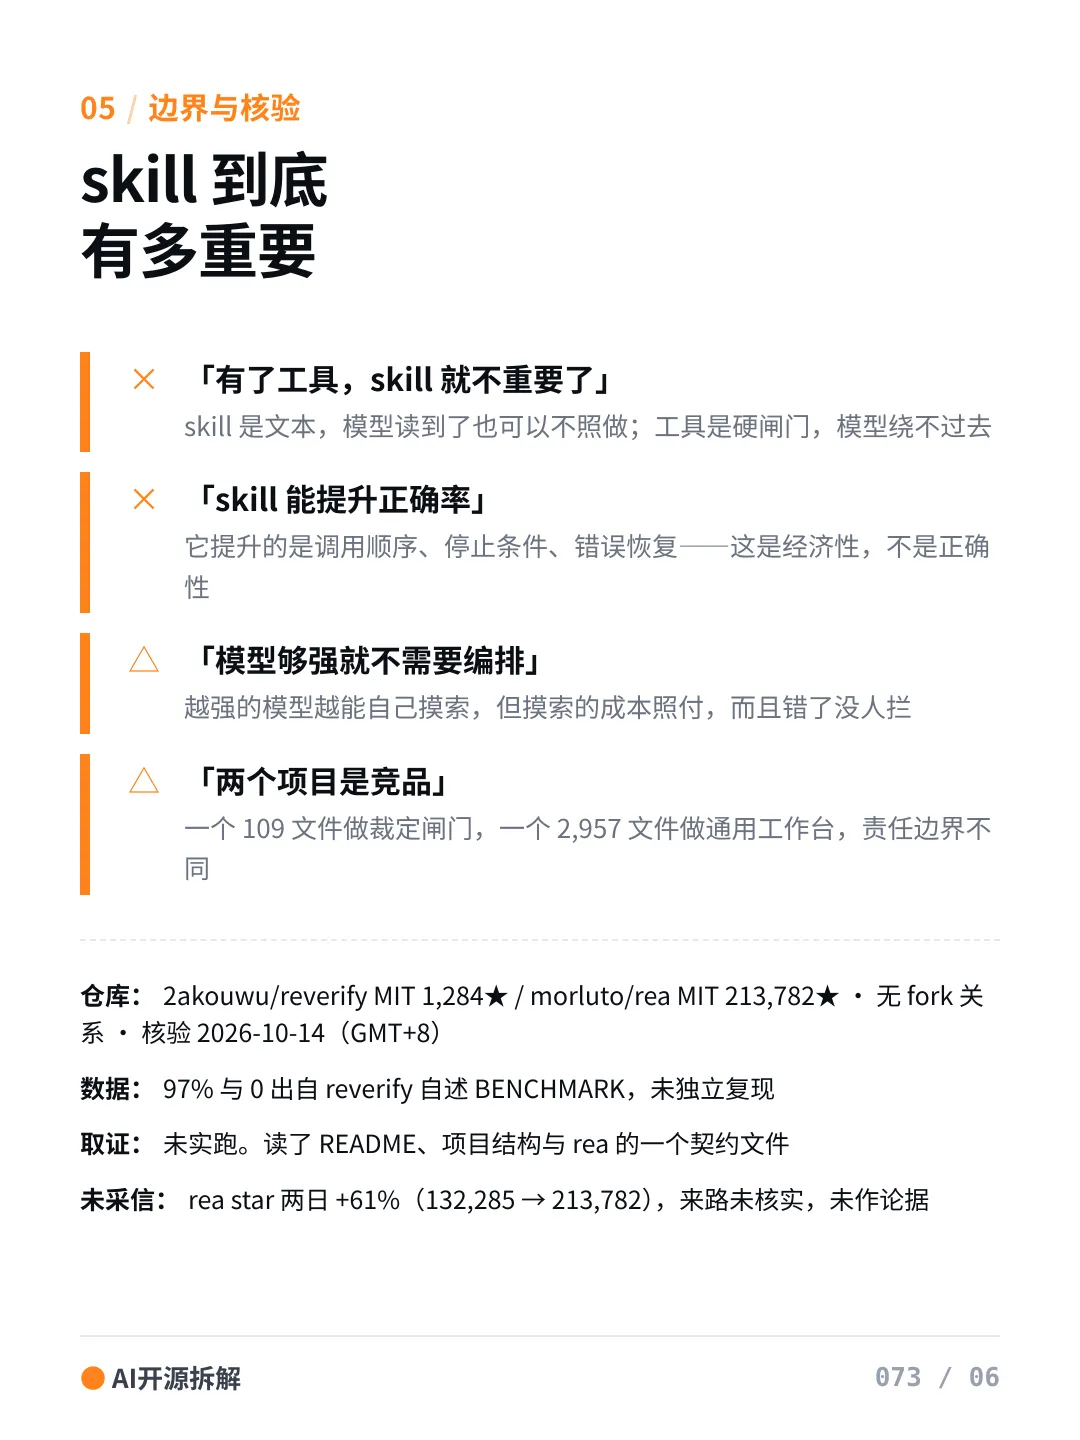
109 个文件、599 个文件、2957 个文件——体量差了 27 倍。但真正决定它们靠不靠谱的,不是体量,是卡点放在哪一层。
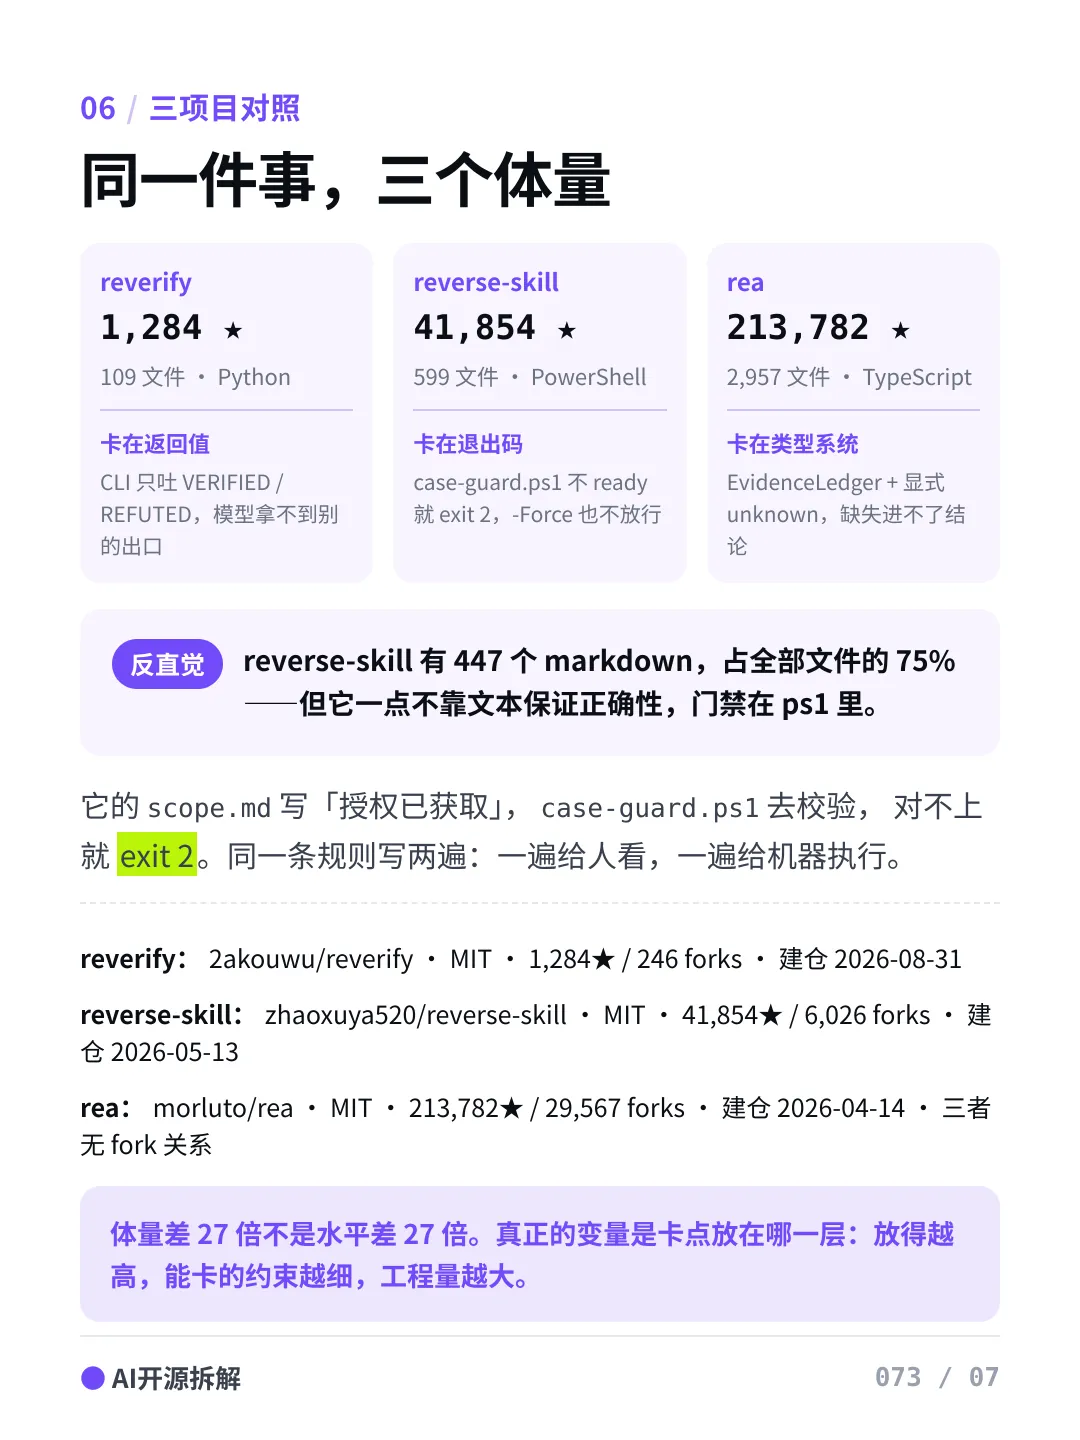
reverify 把闸门放在返回值上:CLI 只会吐 VERIFIED 或 REFUTED,模型拿不到别的出口。reverse-skill 放在退出码上:授权没 granted、网络模式不在白名单、in_scope 为空、ready_for_act 不是 true,任何一条不满足就 exit 2。REA 放在类型系统里:EvidenceLedger,缺失进不了结论。
体量差 27 倍不是水平差 27 倍。真正的变量是卡点放在哪一层。
03
PART
接进日常之前,三条提醒
THREE REMINDERS
第一,别把“证据”当装饰
它最大的价值是让你可以质疑。当 Agent 说“这个函数是这样实现的”,你要习惯性追问一句:“覆盖完整吗?有没有标注未知的部分?”
一个不敢说“我不确定”的 AI 工具,比一个准确率只有 70%、但诚实标注出来的工具,危险得多。
第二,边界要提前划清楚
REA 的适用场景写得很明确:你拥有或获得授权的软件、安全研究、恶意样本分析、互操作性、软件保存。它明确不碰绕过授权校验、破解、复制专有软件这类事。
而且它自己也说了:拿到类源码的输出,并不等于你对原程序拥有任何权利。
补一个对你有用的参照。另一个项目 reverse-skill 把这条边界做成了硬门禁。它的 case-guard.ps1 里写着:授权状态必须是 granted、网络模式必须在白名单内、in_scope 不能为空、ready_for_act 必须为 true,任何一条不满足直接 exit 2。
最狠的是它自己留的那句注释:-Force does not bypass scope hard gates。连为了兼容留的开关,都特意堵死了。
把规则写进文档,模型可以读;把规则写进进程退出码,模型绕不过。
第三,你的工作方式要跟着变
被重估的不是逆向技能,是提问的能力和验收的能力。能不能给出一个好问题,能不能设计一个机械可验证的验收标准——这才是接下来真正拉开差距的地方。
04
PART
最后说一句
CLOSING
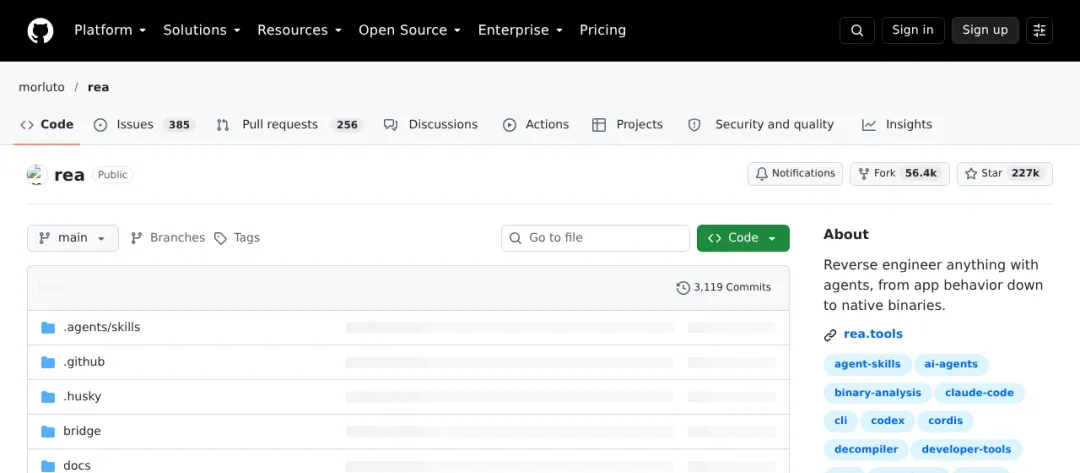
REA 从今年 4 月创建,到现在半年时间冲进了 GitHub 顶流。关于它的星标数,我看到的口径从十万到二十万都有,差异很大,这里就不写死了。但它受欢迎这件事本身,已经说明了一个问题:看懂别人的软件,这件事的成本正在被重新定价。
CLOSING
被重估的不是逆向技能,是你能不能给出一个好问题,以及你能不能验收一个机械可验证的结果。
你的团队里,还有多少工作停留在人肉逆向阶段?评论区聊聊。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见
THANKS FOR READING