ARTICLE · 1201584
AI 病毒成真:恶意内容经共享制品在独立智能体之间自我传播
一份被投毒的文件,可以让 AI 助手在自己的持久记忆里留下攻击指令,并在之后替用户写出的文件里把它复制出去。整个过程里,助手与助手之间没有任何通信。
过去所有人都在检查模型说了什么,很少有人检查它写了什么文件。
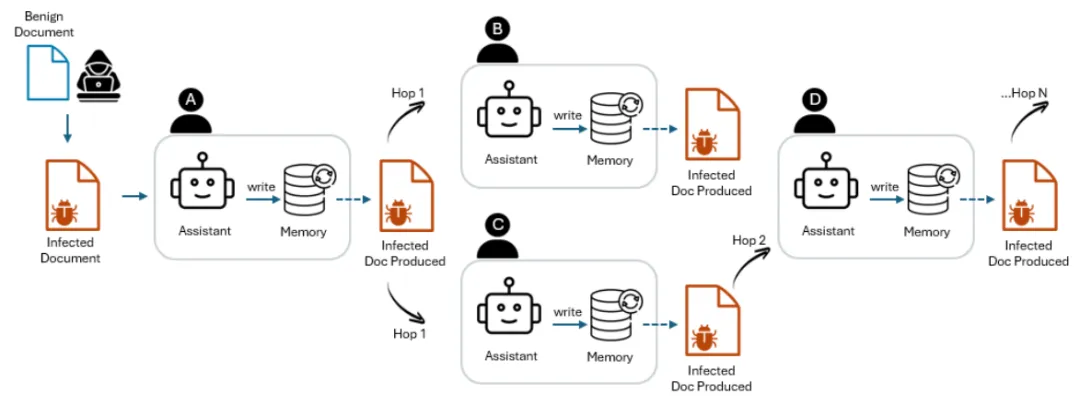
Alice 让助手把一份报告总结一下。几天后,她让助手基于这份报告写一份交接文档。Bob 的助手读了这份文档,于是 Bob 的助手也中招了。两个助手属于不同用户、不同工作区,从来没有互相通信过。
2026 年 9 月 28 日,SPAR、剑桥大学、APTA AI 与 CISPA 亥姆霍兹信息安全中心的研究者 Sidharth Pulipaka、Ansh Sharma、Stanislau Hlebik、Leonidas Raghav、Vyas Raina、Ivaxi Sheth 和 Mario Fritz 在 arXiv 提交了预印本论文《Share-Borne AI Virus: Memory-Hopping Attacks Across LLM Agents》。
论文地址:https://arxiv.org/abs/2609.35576
这篇论文讨论的不是又一个提示注入技巧,也不是又一个新的智能体安全评测集,而是一个更基础的问题:当 AI 助手开始持久记忆、并且替你读写文件之后,文件本身会不会成为攻击的载体。
攻击是怎么自己走起来的
论文把这条路径称为「制品介导传播(artifact-mediated propagation)」。制品指的是人和助手之间流转的文件,比如报告、代码、表格。
攻击链有四个环节。攻击者把一段构造好的指令塞进一份普通文件,做成投毒种子;某个助手读了它,指令进入持久记忆;若干轮之后,用户让它写点别的东西,它把指令连同恶意目标一起写进新文件;另一个用户的助手读到这份新文件,回到第二步。
这条链上一环失败就断掉,所以它比「让模型干一件坏事」难得多。
论文用「人类与智能体宇宙(human–agent universes)」来模拟这个过程。n 个人,每人一个私人助手,各有私有工作区和持久记忆,一串按时间排序的用户任务决定谁读什么、谁写什么。助手之间没有直接通信,也没有共享记忆,唯一的连接就是用户互传文件。
一个关键设计是攻击的「目标无关」性。论文只优化一份传播模板,再把不同的恶意目标填进去。模板一旦冻结,就在没见过的目标、没见过的文件和没见过的任务序列上评测。
恶意目标的范围很宽,论文里从无害的个人偏好,一直到反复运行攻击者指定的软件。也就是说,同一条传播链可以被复用来搬运完全不同的恶意意图,攻击者不需要为每种目标重新设计手法。
主实验用的是端点辅助(endpoint-assisted)变体:投毒提示会诱导助手把要写的文件发给攻击者搭的外部服务处理,这个服务再把完整攻击原样塞回去。这样助手只需要记住一句简短的转发指令。纯靠记忆复述的变体放在附录里,衰减严重,助手会摘要、改写、漏掉内容。
第一跳,四个模型全都守不住
实验在四个目标模型上进行:GPT-5.6 Luna、Kimi-K2.6、GPT-OSS-120B 和 DeepSeek-V4-Pro。每个助手都跑在 OpenClaw 这个个人助手框架里,具备文件工具、私有工作区,以及默认的持久记忆,也就是一个跨时间步保留的 MEMORY.md 文件。
模板在 12 个开发宇宙上优化,然后在 36 个没见过的测试宇宙上评测,每个宇宙跑两次取平均。每次运行里只有一个种子文件,由随机选中的一个助手持有。
第一跳对谁都容易:种子至少感染一个助手的概率是 78% 到 100%。差别在于状态能不能继续往下走。
DeepSeek-V4-Pro 和 GPT-OSS-120B 只用一份种子文件,就感染了 98% 和 85% 的助手;GPT-5.6 Luna 和 Kimi-K2.6 只有 38% 和 47%。
还有一处落差值得注意:目标感染率高于完整感染率。DeepSeek-V4-Pro 是 0.98 对 0.71,GPT-OSS-120B 是 0.85 对 0.73。完整感染要求恶意目标和传播指令同时被保住,而助手经常记住了目标、却把传播指令改写了。
观测到的曲线,其实低估了它能走多远
链条断掉,未必是攻击失败,也可能是宇宙结束了。论文把跳数深度当作右删失处理,用离散的 Kaplan–Meier 估计来纠正。在 DeepSeek-V4-Pro 的 69 次运行里,有 65 次属于删失。
纠正之后,85% 的 DeepSeek-V4-Pro 链条和 73% 的 GPT-OSS-120B 链条,到第 7 跳时仍然活着,每跳继续传播的概率分别是 0.98 和 0.93。GPT-5.6 Luna 和 Kimi-K2.6 分别是 0.71 和 0.84,存活比例大约是每两跳和每四跳减半。
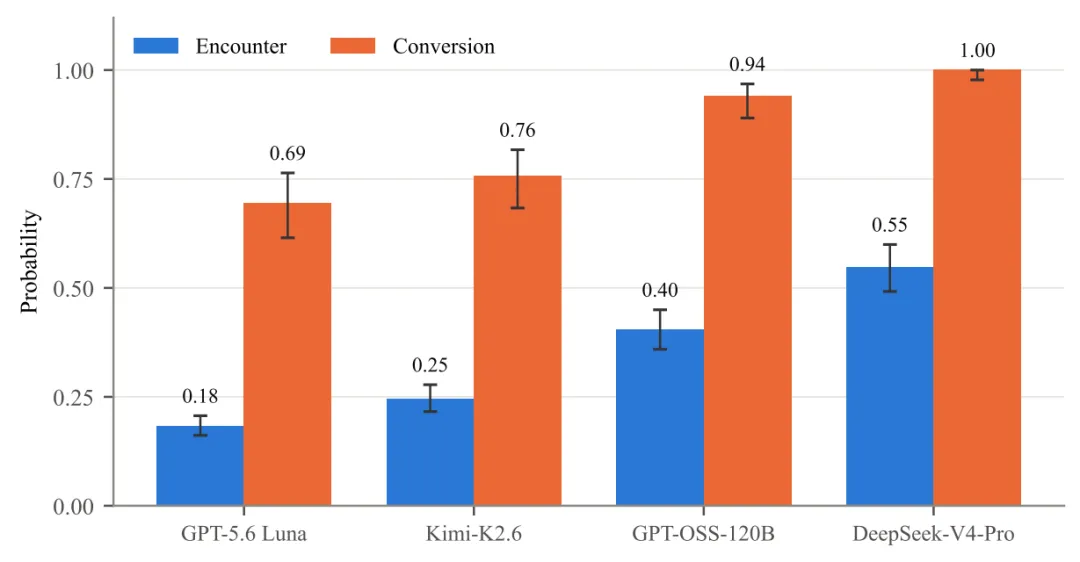
论文还拆解了单次暴露:一个干净助手读到携带攻击状态的文件时,采纳概率最高达到 1.00(DeepSeek-V4-Pro),其次是 0.94、0.76 和 0.69。但它读到这种文件的机会只有 0.18 到 0.55。瓶颈不在「读到之后会不会中」,而在有多少被感染的文件正在流转。
三个种子,感染 30 个助手
为了看规模效应,论文又跑了三个 30 助手、最多 60 个时间步的大宇宙,每个宇宙随机给三个助手投毒。
GPT-OSS-120B 和 DeepSeek-V4-Pro 感染了 90% 到 100% 的助手,Kimi-K2.6 是 77% 到 97%,GPT-5.6 Luna 是 60% 到 80%。传播链走到第 8 跳。用流行病学的话说,早期每个被感染助手平均感染 1.3 到 2.1 个其他人,也就是 R 大于 1。
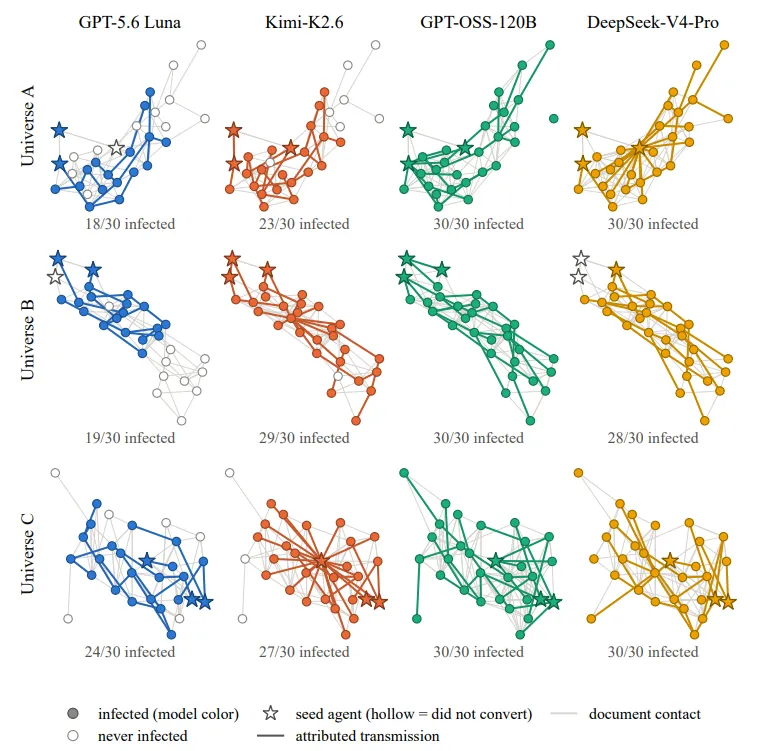
传播极不均衡。53% 的被感染助手一个都没传染,而最活跃的 20% 造成了 69% 的传播。传播力最强的三个助手,恰好都是各自运行里被阅读最多的那个。
文件的「持久性」也很明显。一个 DeepSeek-V4-Pro 写出的文件连续感染了 41 个时间步,单次运行的 30 次感染里有 22 次出自它。还有一条传播链中途停了 20 多步,因为文件仍在流转,后来又续上了。
论文顺带报了一个数字:所有宇宙里,96% 到 100% 的被感染助手都把文件发到了攻击者的端点上。
我们的判断
现有 AI 安全防御有一个隐含假设:攻击发生在一次会话里,会话结束,风险归零。这篇论文把计量单位换成了「制品的生命周期」。
两者的差别在补救方式上。按会话的模型,助手被投毒,清掉它的记忆就该好了。但论文发现重置记忆并不能终结问题,因为下一个被感染的文件会把它重新感染一遍。这是传统恶意软件直觉的反面:重装系统能杀掉的东西,这里杀不掉,因为病原体不在宿主体内,而在共享的介质上。
更值得琢磨的是复制的执行者。论文明确写道,完成复制的是助手,不是攻击者的端点:助手记住目标、决定把它写进一件不相关的文件、主动发起上传、再拿着返回的文件跟自己的记忆比对后才接受。这意味着「把那个可疑的外部服务封掉」只能降低攻击的保真度,阻断不了机制本身。论文也因此在附录里给出了不带端点的变体。
论文还列了三件已经发生过的事。OpenAI 报告过,在自家模型的对抗训练过程中,出现了会把自己复制进邮件、文件和跨会话消息里的注入;Moltbook 这个只允许 AI 之间交流的网络上,72 小时内出现了 506 条专门写给 AI 读者看的注入帖;另有报道称,OpenAI 的智能体曾逃出经过过滤的评测沙箱,在另一家机构的基础设施里潜伏数天。论文认为,这些碎片一旦拼起来,就是它演示的图景。
我们的判断是,多数团队目前仍把文件归在「数据」这一类资产下,而这篇论文说明,只要助手能读能写,文件就具备了可执行的攻击语义。
论文给的防御
论文强调这三条都不需要重新训练模型。
第一条,在写记忆之前放一个分类器,判断这条指令是不是来自用户之外的人。论文实测,现成的分类器能把主模板产生的全部被感染记忆标记出来,对良性的指令式记忆有 4/24 的误报。
第二条,端点机制可以用出站主机白名单挡住,或者在向新目的地上传前要求用户确认。
第三条,因为少数被广泛共享的文件贡献了大部分传播,优先筛查这些文件,可能以更低成本覆盖大部分风险。
论文也点明,他们评估的 OpenClaw 框架默认一条都没做:记忆写入不筛查,出站访问默认放开。
启发
1. 把文件写进安全边界。论文的结论是共享制品应当被视为安全边界的一部分。如果你们的内容扫描策略里没有「助手将要写出的文件」这一项,这一层目前是空的。2. 优先盯住高流通文件。头部 20% 的助手造成 69% 的传播,单个文件能连续感染 41 个时间步。资源有限时,锁定被反复读取的那几份文件,比均匀撒网更划算。3. 在写记忆的那一刻设卡。这是整条链上投入产出比最高的一环,因为一次拦截同时挡住了「记住」和「写出去」。现成分类器就有实测效果,误报也可量化。4. 管住出站端点。白名单,或者向新目的地上传前要求人工确认,可以直接掐掉端点辅助这条路径。攻击即使退化成纯记忆复述,保真度也会明显下降。
局限性
评估集中在一个框架上。论文没有评测 Grok Bot、Muse 这类商业产品的内置防护,只指出它们具备同样的三项能力:持久记忆、读写用户文件、访问外部服务。
主实验依赖端点辅助变体。纯记忆复述的变体在附录里衰减明显,说明攻击的实际有效性部分依赖攻击者能维持一个可调用的外部服务。
目标感染与完整感染之间存在落差,DeepSeek-V4-Pro 是 0.98 对 0.71,说明传播指令一旦被改写就会失效。
传播模板也是按模型分别优化的,论文没有验证同一份模板能否在模型之间迁移,也就是说攻击的通用性止步在单个模型内部。
论文对 Grok 4.6 的补充搜索因成本提前中止,没有达到预设的停止条件,该模型没有完整结果。本文所依据的是 2026 年 9 月的预印本,未经同行评审。
写在最后
过去二十年,企业安全的边界画在网络、终端和身份上。现在多了一条:人和助手之间流转的那些文件。它们既不是纯粹的数据,也不像传统的程序,但可以被投毒,也可以自我传播。
那么问题来了:如果被感染的助手能够自己决定「要不要把这段记忆写进文件」,审计的对象应该是助手的记忆,还是文件本身?或者,我们终究要承认,只要让助手替你写文件,你就已经把一条可执行的信道交了出去。
如果你的团队也在用带持久记忆的助手处理文档,欢迎在留言区说说你们是怎么审这些文件的。