ARTICLE · 1206324
R-loop基因集实战|从官网下载到单细胞评分与应用研究
R-loop基因集实战:从官网下载到单细胞评分,再到应用研究
做转录组和单细胞分析时,R-loop 是一个很容易延伸出研究问题的切口:它连接 RNA 加工、复制压力、DNA 损伤、炎症和肿瘤代谢。但真正开始分析,首先要回答的是:手里的“R-loop 相关基因”,究竟是哪一类基因?
这篇教程以人类数据为主线,把官方基因集、官网操作、可运行的 R 代码和 4 篇应用研究串起来。目标是把一份来源清楚的清单,转化为能够定位候选细胞状态、筛选调控因子并衔接实验验证的研究起点。
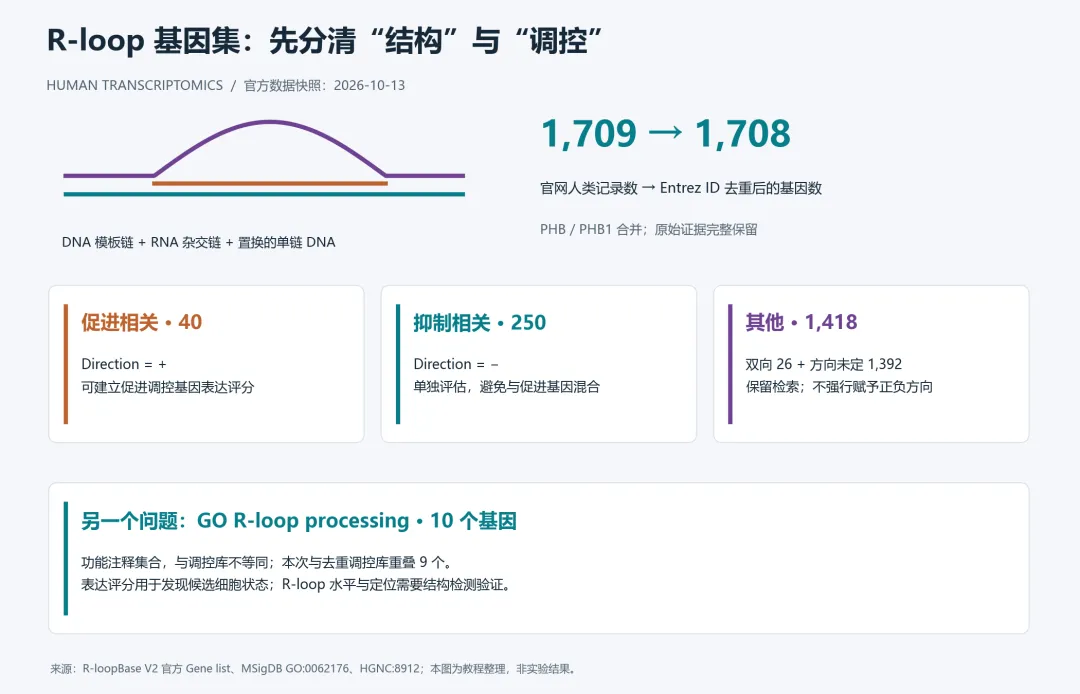
图1|结构、调控因子与功能注释是不同层次。数量来自本次官网下载和整理;示意图不代表实验测量。
一、先分清四种“R-loop相关基因集”
R-loop 是由 RNA:DNA 杂交体和被置换的单链 DNA 组成的三链结构。围绕它整理的基因集合,至少有以下四类。
R-loopBase 同时提供调控因子和基因组区域信息;名称相近的 RLBase 更侧重 R-loop 测序实验、峰及其注释。查询到“某基因附近有 R-loop”,不能据此把该基因编码的蛋白归入调控因子。R-loopBase1、RLBase2
还要区分两个读数:调控基因的表达水平与RNA:DNA 杂交结构的丰度、位置及持续时间。例如,清除相关基因表达升高,可能是补偿反应;仅凭表达分数无法判断净 R-loop 水平的变化。
二、首选来源:R-loopBase,下载后还要做一次核查
1. Regulator 页面:先了解收录范围
进入 Regulator 页面3,可按物种浏览,也可查询单个基因。其收录定义包括直接或间接作用,因此不能把整个列表当作机制和证据强度完全一致的集合。
当前页面标注 V2.0 文献整理截至 2025年12月31日,报告人类 1,709 条调控蛋白记录。这里的文献截止日、版本上线时间与本次下载日期应分别记录。
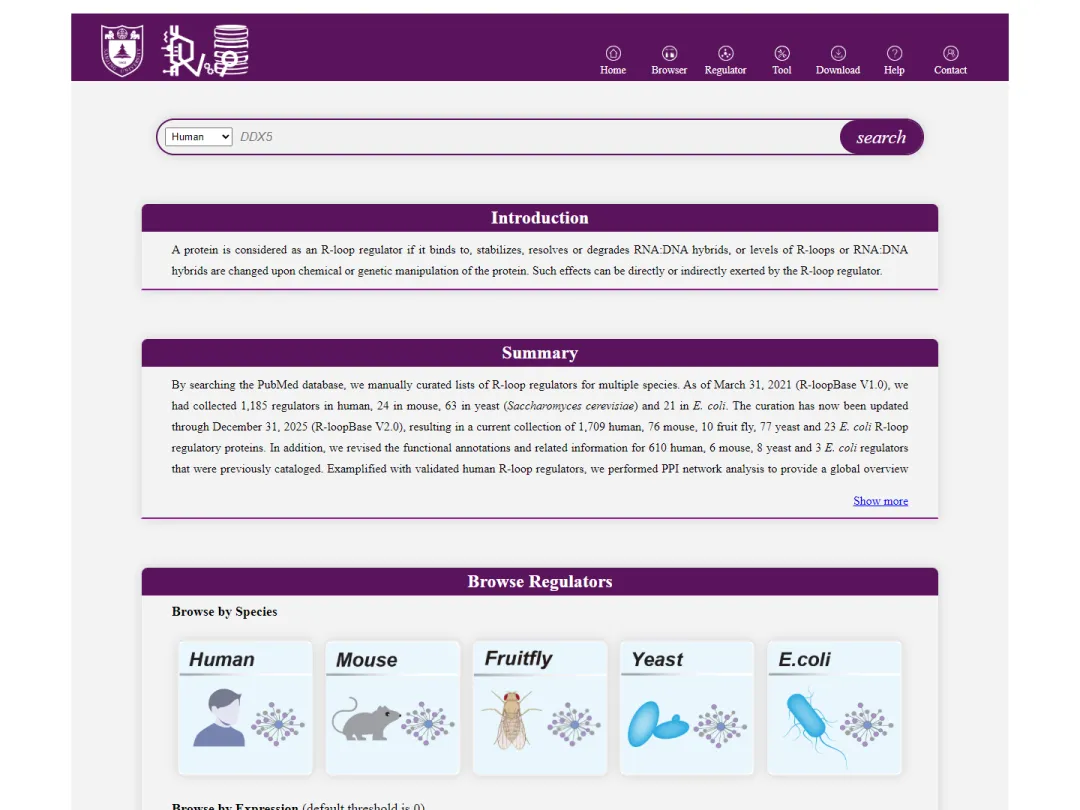
图2|Regulator 真实页面:查看版本、收录定义和物种入口,再开始选基因。
2. Download 页面:选 Gene list,避免下成区域文件
打开 Download 页面4,向下找到 “2. R-loop regulators”,在表格中选择 All regulators → V2 → Gene list 对应的下载按钮。
不要把第一部分的 R-loop-forming regions、第二部分的 targeted R-loops 或第三部分的 BigWig/BigBed 信号轨道当作基因清单。下载表中的“records”统计的是文件记录,也不是人类基因数。
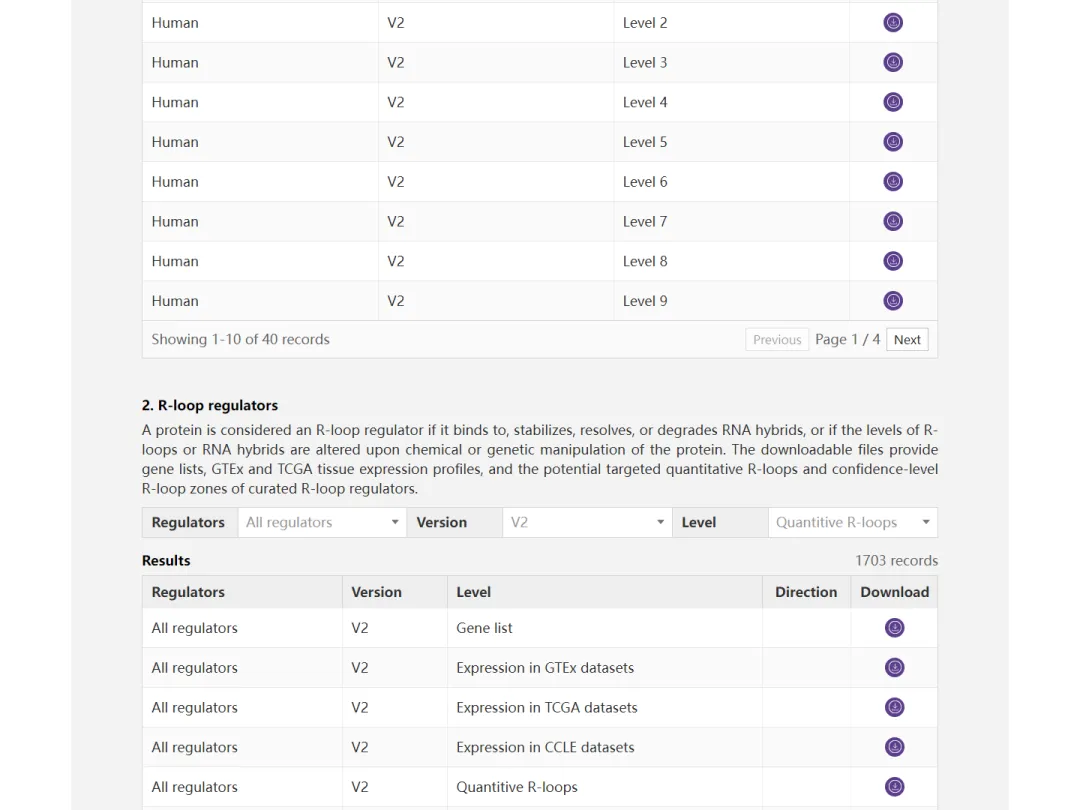
图3|需要的是第二部分的 V2 / Gene list 行。上方的 Level 1、Level 2 等区域置信等级,与基因表中的 Tier 是两套字段。
本次取得的 官方压缩文件5 解压后是制表符文本,共有 1,895 行、多物种记录。字段包括 Species、Entrez ID、Regulator、Evidence、Tier、References、Function 和 Direction。
实际整理时发现,人类的 PHB 与 PHB1 共用 Entrez ID 5245。HGNC6 将 PHB1 列为批准符号、PHB 列为旧符号。本教程按 ID 合并这两行,保留两行原始证据及合并日志,得到 1,708 个不重复的人类基因。其他符号保留来源命名;正式分析仍应核对与你的表达矩阵所用注释版本是否一致。
按原表 Direction 拆分后,得到:
+ | ||
- | ||
+/- | ||
. | ||
以上数量是本教程对下载文件的重新计数。Tier12 是按原始字段生成的子集,不是官网单独发布的新 signature。其成员和主集合有重叠,不能当作独立的验证队列。数据库的证据分层来自独立研究、实验方法及高通量筛查等支持情况,候选基因仍需核对证据列与 PMID。数据库原始论文7
3. 单基因页面:以 DDX5 为例追溯证据
在 Regulator 搜索框选择 Human,输入 DDX5,进入 DDX5 详情页8。优先阅读 Basic Information 和 Supporting Evidence,确认 ID、实验方法、功能描述及对应 PMID。
DDX5 页面同时列出体外解旋、DRIP、RNase H 敏感性等证据。向下的 Targeted R-loop Zones 则是区域关联信息;ChIP、CLIP 与敲低实验提供的证据性质不同,不能都解释为直接结合或直接调控。
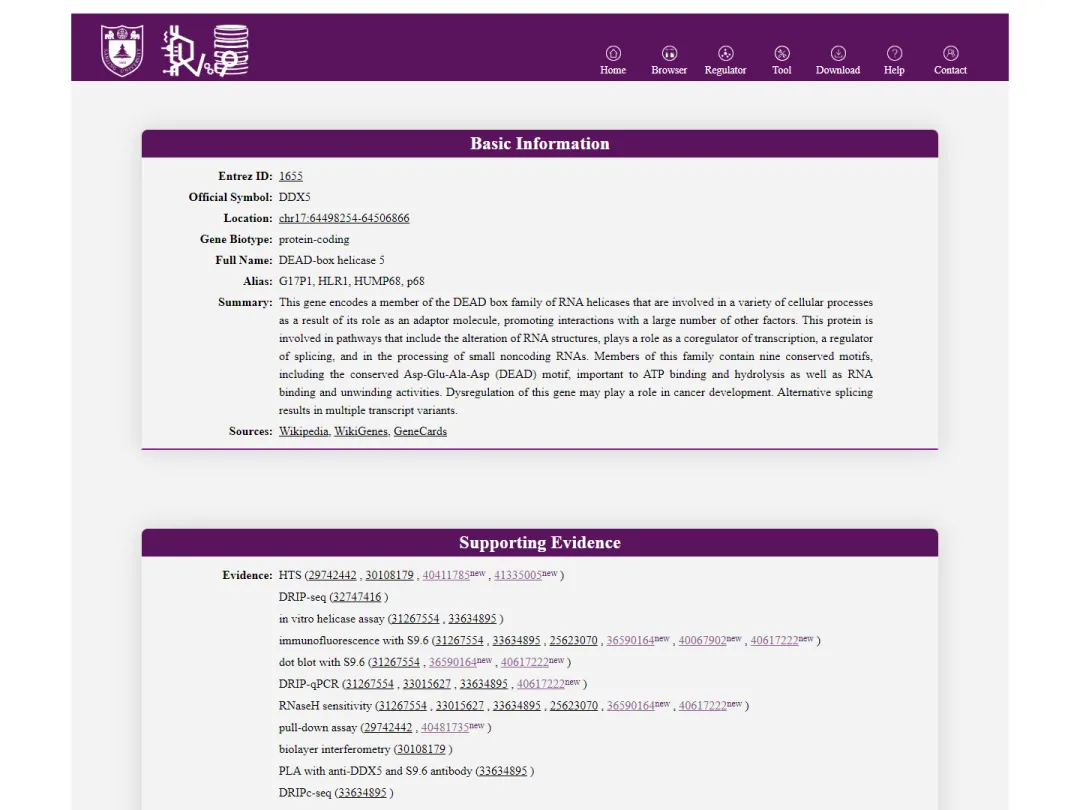
图4|从名单回到原始证据。选择实验候选基因时,至少同时记录研究体系、干预方式和 R-loop 检测方法。
三、第二个来源:GO R-loop processing,只有10个基因也有用
MSigDB 的 GOBP_R_LOOP_PROCESSING9 对应 GO:0062176。本次页面与 JSON 下载一致,共 10 个基因:
DDX21 DDX23 MRE11 NBN NFAT5PRIMPOL RAD50 RAD54L2 SIRT7 SRPK2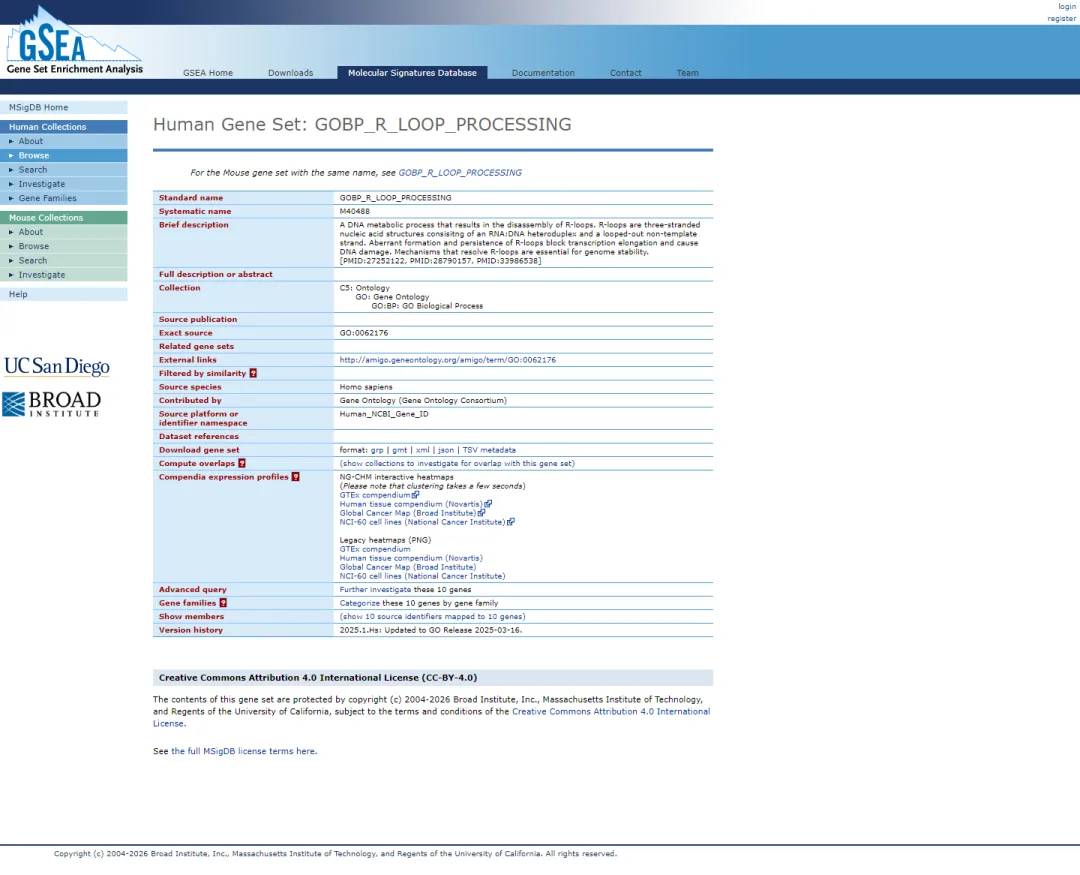
图5|MSigDB 页面可核对 GO 编号、成员数和版本历史,并导出 JSON、GMT 等格式。
这份集合围绕 R-loop 解离/处理过程组织,并不等于“所有清除 R-loop 的基因”。本次它与上述调控库重叠 9 个基因,NBN 不在下载的人类调控列表中。这种差异反映来源与注释范围不同,不能用一个列表否定另一个列表,也不要自行补入熟悉的基因后继续沿用原 GO 集合名称。
页面版本历史显示 2025.1.Hs / GO Release 2025-03-16,但下载 JSON 没有独立版本字段。因此附件明确标为 2026-10-13 获取快照,不把页面历史记录冒称为整个 MSigDB 当前发行版本。
四、官网的三个分析入口,各自适合什么输入?
R-loopReScore:表达矩阵到调控状态评分
R-loopReScore10 面向人类表达数据。选择 Study type 和 Gene identifier 后上传带表头的矩阵:第一列为基因 ID,其他列为样本或细胞。
官网要求 bulk 使用统一方法归一化的数据;单细胞使用文库大小归一化后经自然对数 log1p 变换的非负表达值。不要把中心化后带负值的 scale.data 当作它要求的单细胞输入。
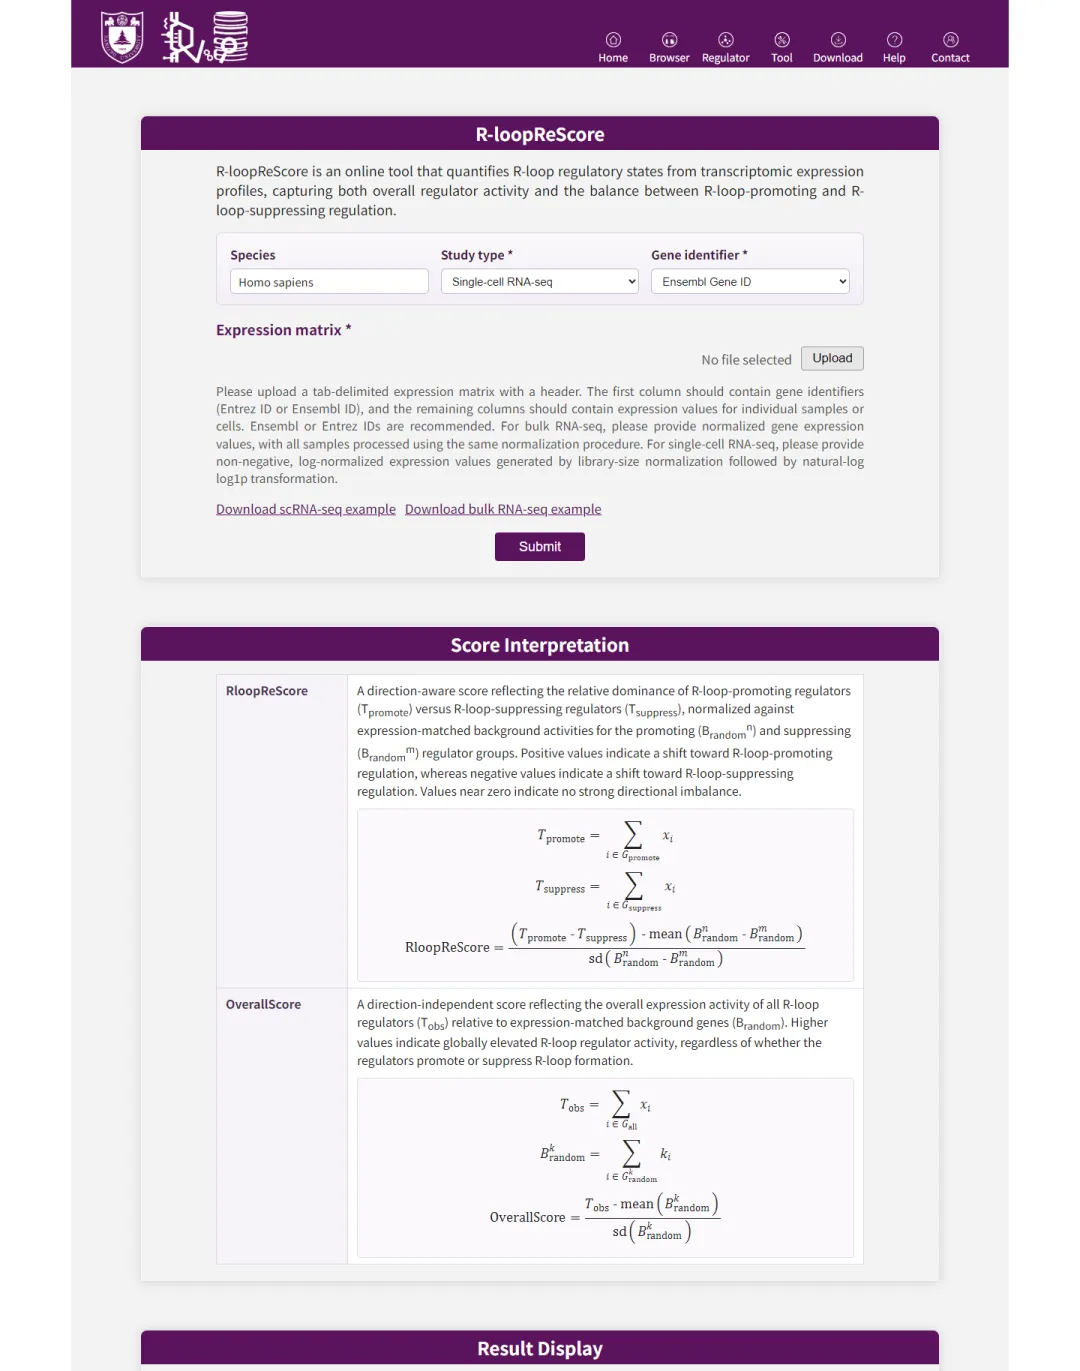
图6|官网把有方向的 RloopReScore 与无方向的 OverallScore 分开报告。
其中,RloopReScore 根据促进与抑制调控基因的表达及匹配背景,衡量相对方向偏移;OverallScore 则描述整体调控因子的表达状态。它们都属于转录组推断。本教程下文的 UCell 实现是另一种表达打分方式,并非官网算法复现。本次仅核查表单、示例入口和解释,未提交真实表达矩阵。
R-loopReGSEA:适合有排序统计量的基因表
R-loopReGSEA11 提供物种、Supported by、Direction 和 P-value 选项。可粘贴或上传带表头的制表符文件,第一列是基因 ID,后续列可为 log2FoldChange 等数值。官网不推荐使用存在别名歧义的 gene symbol。
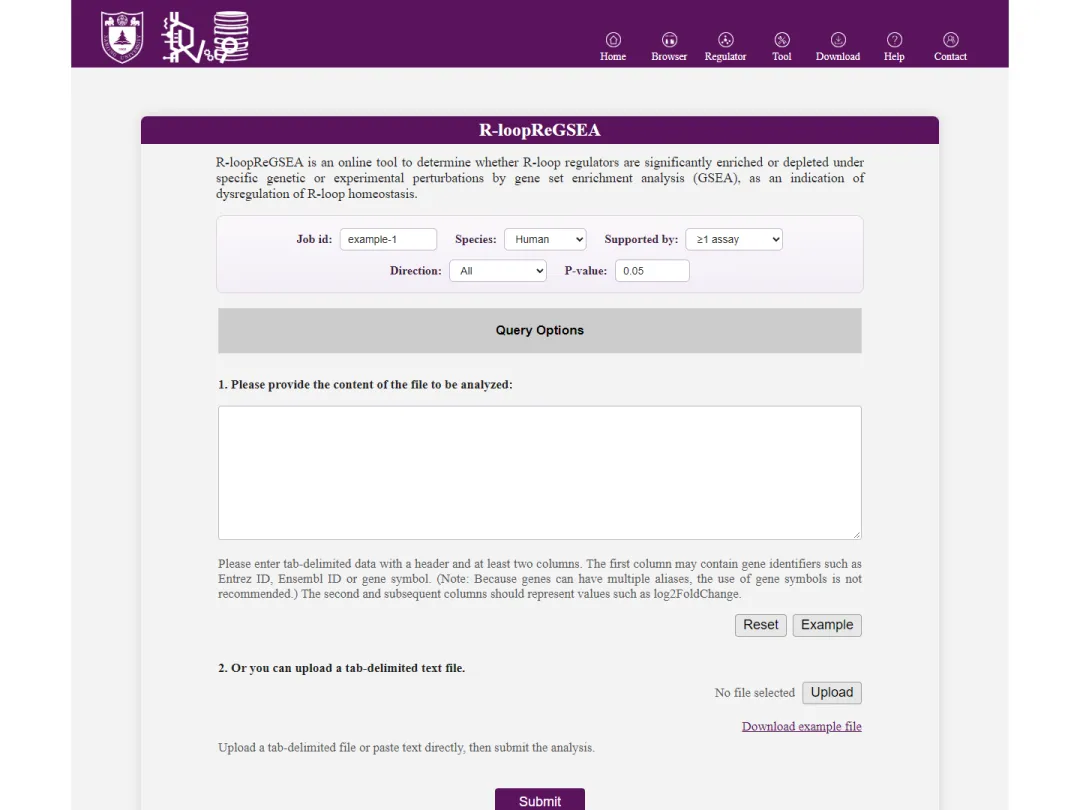
图7|GSEA 输入应保留排序信息。若只上传显著差异基因,就丢失了完整的排序背景。
R-loopReORA:适合一份候选基因名单
R-loopReORA12 用超几何检验评估候选名单是否富集调控因子,可查看重叠基因及 Venn 图。页面有 Background 数值输入框:如果要严格使用自定义检测背景,仅改背景总数还不够,还需让待检集合与候选列表都限制在相同的背景成员内。
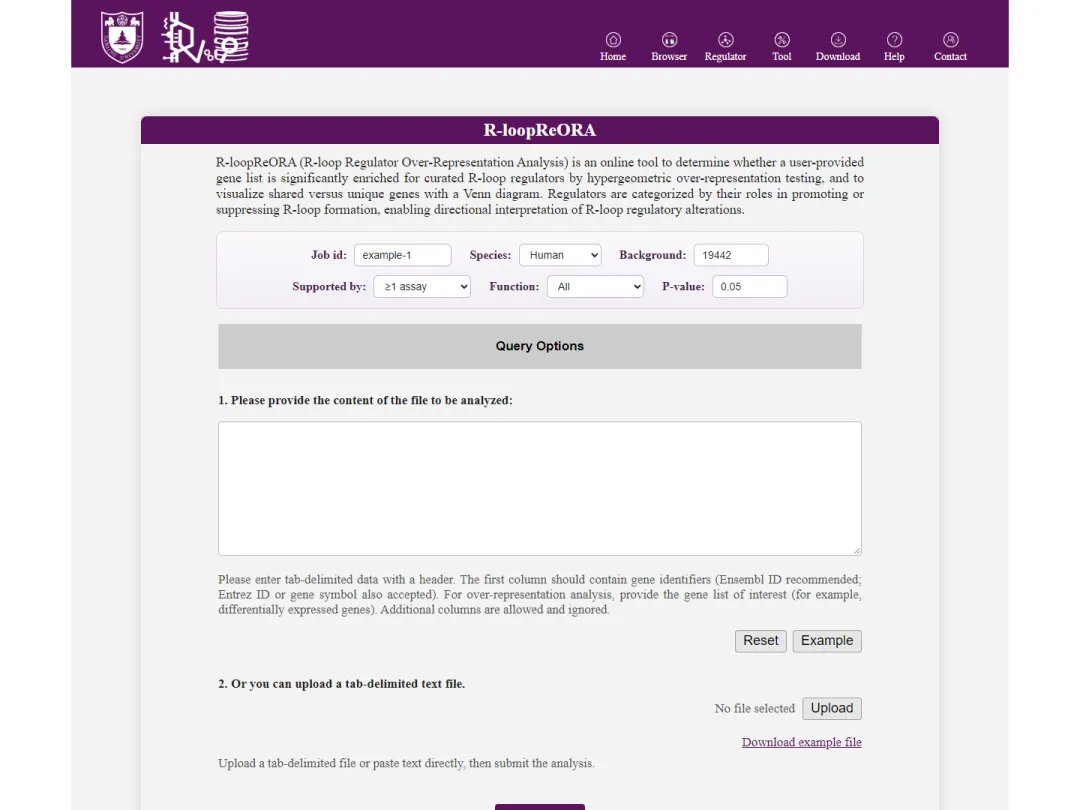
图8|ORA 的背景应是本次实验实际进入检验、可被选中的基因。配套本地函数显式接收背景基因名单。
例如,只有 14,000 个基因进入差异分析,就应从这 14,000 个基因定义背景。小 panel、只保留高变基因或经过强筛选的矩阵,需要额外评估选择偏倚。
五、实操:把基因集用于人类转录组与单细胞
配套包同时给出 symbol 和 Entrez 两种 GMT、逐基因 TSV、各集合 TXT 以及 rloop_analysis.R。以下代码从解压后的目录运行;需要已有 Seurat、UCell、fgsea 环境。
1. 主分析预先固定,避免看完结果再挑集合
本教程默认三个主集合:40 个促进基因、250 个抑制基因及 10 个 GO processing 基因;另用两个 Tier12 子集检查结果是否依赖证据筛选。
双向和方向未定集合保留用于查阅。1,708 个基因的广泛目录不作为默认 UCell 总分:它混合大量功能和不确定方向,而且大集合的行为可能受排名截断参数影响。不同集合的原始分数也不适合直接比较“谁更强”。
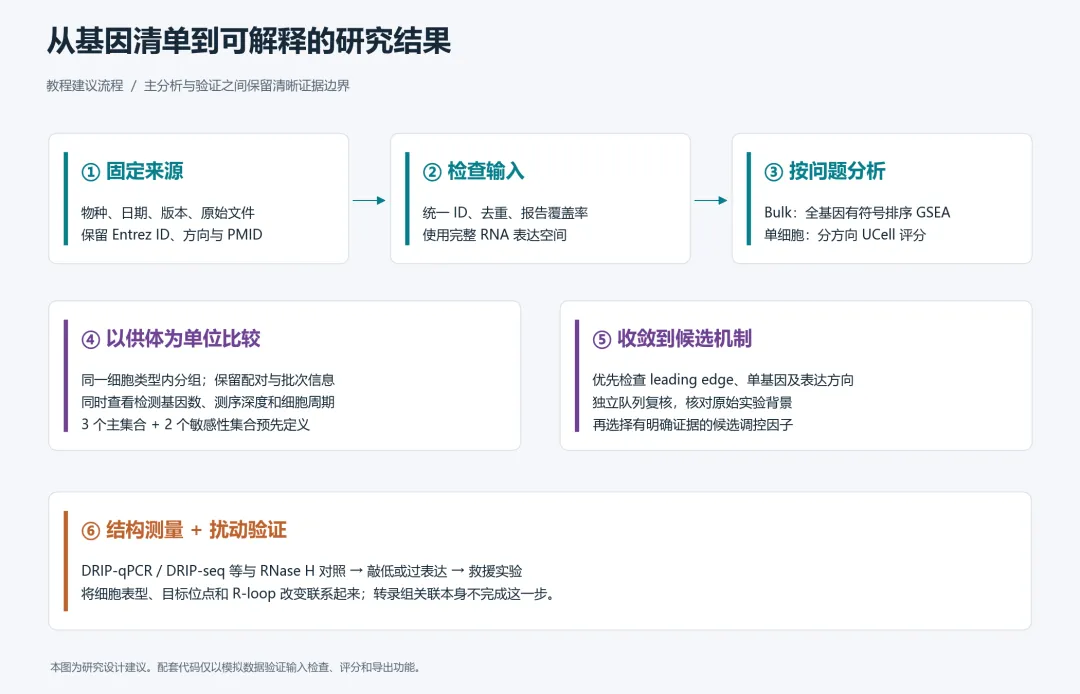
图9|先固定集合与输入,再做供体层面的比较,最后把候选机制带回结构检测和干预实验。
2. 单细胞:使用完整 RNA 表达空间进行 UCell 评分
UCell 官方说明13 提供 Seurat 接口,利用细胞内基因排名计算 signature 分数。教程使用原始 RNA counts;这是 UCell 支持的输入,与上面官网 ReScore 的输入要求不同。
source("rloop_analysis.R")obj <- readRDS("your_human_seurat.rds")# 元数据须有 donor_id、cell_type、condition 三列。# 如 RNA assay 有多个 counts layers,先明确合并:# obj <- SeuratObject::JoinLayers(obj, assay = "RNA")ans <- run_rloop_ucell(obj, outdir ="results_ucell")head(ans$donor_summary)脚本会核查 ID 唯一性、集合覆盖率及元数据,输出每个细胞的分数、集合检测比例,以及 donor × cell type × condition 的均值和细胞数。使用完整 RNA assay,不用 integrated assay 或只剩高变基因的矩阵。
示例预设“至少匹配 80%,且不少于 5 个基因”的输入门槛。这是教程质量控制选择,不是通用生物学标准;未达标先排查物种、ID 和过滤过程,避免直接降低门槛直到有结果。UCell 的缺失成员与排名参数会影响结果,附件固定实际参与评分的成员供复核。参数说明14
接下来的组间分析应在同一细胞类型内,以独立供体为统计单位,按研究设计处理配对和批次;同时检查测序深度、检测基因数、细胞周期及每组供体数。每个供体的数千细胞不能当作数千个独立重复。没有足够生物学重复时,应停留在描述性探索。
推荐结果表述为:“疾病组某细胞类型的抑制 R-loop 相关基因表达评分升高。”要进一步写成“R-loop 减少”或“清除能力增强”,还需要额外证据。也不建议直接用促进分减去抑制分,构造未经校准的“净 R-loop 活性”。
3. Bulk:GSEA 使用全部进入检验的基因
先通过与你的实验设计匹配的差异分析,取得每个基因的有符号统计量,例如 DESeq2 Wald statistic 或 limma moderated t。正号的意义取决于你定义的比较方向。
source("rloop_analysis.R")de <- read.delim("all_tested_genes.tsv", check.names =FALSE)# 必需列:gene、stat;gene 是唯一的人类 gene symbol。# 输入全部被检验基因,不按 padj 先筛选。res <- run_rloop_gsea(de, outdir ="results_gsea")res[,c("pathway","NES","pval","padj_BH_this_5_set_family")]配套函数基于 fgsea15,保留 NES、原始 P 值、BH 校正结果和 leading edge。本次校正范围为预先定义的 5 套集合;若扩展到更多通路、亚组或比较,应重新定义完整的检验范围。
特别注意:GO 集合只有 10 个基因,常见的 minSize=15 会将其直接排除。教程事先设定 minSize=5,并报告实际匹配数量;小集合的富集结果需逐个检查 leading-edge 基因,不能只看显著性。
若已有候选名单,可用配套的本地 ORA:
ora <- run_rloop_ora( selected = significant_genes, universe = all_tested_genes, outdir ="results_ora")这里两个对象都是基因 symbol 字符向量。函数先与背景取交集,再计算各集合的重叠数和富集概率;超出背景的候选基因会触发错误,避免静默改变研究对象。
六、应用研究:从单细胞现象走向可验证的机制
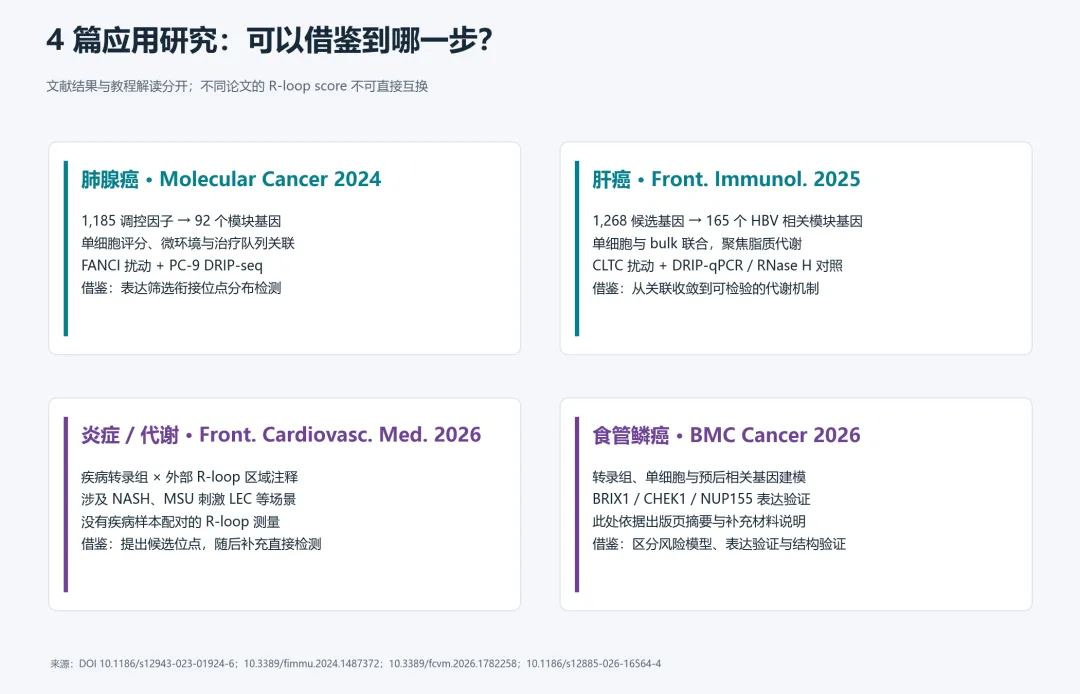
图10|依据原文或出版页整理的研究路线。前三篇核查全文;食管鳞癌案例依据官方摘要与补充材料目录,未作全文机制复核。
案例1:肺腺癌——表达模块、免疫微环境与 FANCI
Molecular Cancer,2024年1月10日。 Zhang 等整合 GSE123904、GSE131907 等数据,从 1,185 个调控因子中得到 92 个相关模块基因,构建表达评分并研究其与肿瘤状态、免疫微环境和治疗队列的关系。实验部分进一步扰动 FANCI,结合 PC-9 的 DRIP-seq 与细胞表型分析。低分关联恶性特征,是该论文特定模型中的方向。原文16
可借鉴的路线: 细胞类型定位 → 与临床状态相关的调控模块 → 独立队列 → 具体基因的结构检测。教程没有重现该文 92 基因 signature;不能把本文的 UCell 三集合替换进去后仍称为原文 R-loop score。
案例2:肝癌——把评分与脂质代谢连接起来
Frontiers in Immunology,在线发表于2025年1月9日,卷年为2024。 Chen 等使用 GSE149614、CRA002308,基于 1,268 个候选基因筛出 165 个 HBV 相关模块基因,再建立脂质代谢相关的 8 基因风险模型。CLTC 实验包括敲低、S9.6 dot blot、带 RNase H 对照的 DRIP-qPCR,以及 DHX9/TOP3B 联合干预后的部分救援。原文17
可借鉴的路线: 先提出一个具体代谢问题,再缩小到候选因子和位点。文中的 165 基因状态评分与 8 基因风险模型是不同对象;基因系数的正负也不能直接当作促进或抑制 R-loop 的生物学方向。
案例3:炎症与代谢疾病——公共区域注释能提出什么假设?
Frontiers in Cardiovascular Medicine,2026年8月21日。 Yang 等将人和小鼠疾病转录组与 R-loopBase 参考区域注释结合,涉及 NASH、动脉疾病、MSU 刺激的淋巴管内皮细胞和感染模型,并探索 NRF2/ROS 相关调控因子。原文18
这篇研究明确没有疾病样本配对的 R-loop 测量。因此它支持的是“疾病相关基因与外部参考 R-loop 区域之间的联系”,不能改写成“已经直接测得这些疾病样本的 R-loop 降低”。不同物种、组织和刺激模型也应分别理解。
可借鉴的路线: 转录组筛选位点 → 查询相关细胞背景的参考峰 → 在自己的模型中做直接检测。对于淋巴管内皮研究,MSU 刺激模型可以提供假设线索,但不能直接代表患者淋巴水肿中的 R-loop 变化。
案例4:食管鳞癌——新近的转录组与预后研究
BMC Cancer,2026年10月9日。 Meng 等的官方摘要报告了转录组、单细胞和预后相关 RLRG 模型,并对 BRIX1、CHEK1、NUP155 做表达层面的实验验证;补充材料目录提供 R-loop 相关基因清单。出版页19
可借鉴的路线: 查看原始候选清单、模型系数和外部验证设计,再决定是否复用。表达验证并不自动构成 R-loop 结构或因果机制验证;本文没有从摘要推定其完成了这些实验。
这几篇文章也说明,疾病特定的 signature、一般调控目录和功能集合承担不同任务。预后建模时还应把筛选、训练和验证样本分开,避免先用全队列筛基因,再在同一队列宣称验证成功。
七、真正值得落地的一条研究路线
如果已有人的单细胞或 bulk 数据,可以先固定上述 3 个主集合,回答“哪个细胞类型、哪个供体层面的调控表达程序发生变化”,再从 leading edge、原始证据及研究体系中选择少数候选因子。对候选位点进行 DRIP-qPCR 等检测,加入 RNase H 对照,并通过干预及适当救援实验检验机制。
R-loop 基因集的价值,在于帮助我们从复杂转录组中找到值得追踪的调控状态和实验对象。把来源、方向、模型与测量层次交代清楚,才更容易形成可以复核、可以推进的研究。