ARTICLE · 1206795
AI 重塑的新软件时代到来,高校教育的应变之策
QUOTE
AI 正在从“回答问题”走向“替人造软件、做产品”,软件开始反过来适应人,人与软件的关系正在被悄悄反转。
过去一个月,科技圈的几个信号,几乎是同一件事的不同侧面:
REA:逆向工程塞进 Coding Agent
一句自然语言就能让 Agent 拆解二进制、反编译代码、梳理执行规则,而且每个结论都附带汇编指令、调用链、字符串、截图作证据。已经有开源组织用它先逆向、再配合 AI,用纯 Rust 从零重写出了七款对标 Adobe 的工具。它真正的冲击在于:过去“闭源”是软件的一条护城河,现在任何软件都能被 AI 逆向、读懂、复现——闭源正在失去意义,所有软件终将走向开源。
Claude:上线 Dashboards 和 Motion
自然语言连上 Snowflake、BigQuery 就能生成自动刷新的看板,写代码驱动图表、图形做动画、导出 MP4,直接穿透了 BI 和动效两个赛道;
GPT-6:Intelligent UI 全面开放
模型能自主决定如何组合文字、图表、按钮、表单,边思考边生成一个可交互的回答界面,甚至当场给你生成一个账单分摊工具或一款小游戏;
微软:纳德拉发长文《The Infinite SaaS Factory》
提出要让 Copilot 成为“工作的操作系统”,并构想企业可以“无限生成”自己需要的软件;
Cloudflare:开源 Cloudflare OS
让每个非技术员工都能在自己的隔离沙箱里“手搓”个人软件,修改代码的成本趋近于零。
把这些新闻叠在一起看,一条主线浮出来了:AI 的价值,正在从“给你一个答案”,变成“给你一个能用、可交互、可验证、可迭代的产物”。而这对高校 AI 教育意味着什么?我想讲四个启示。
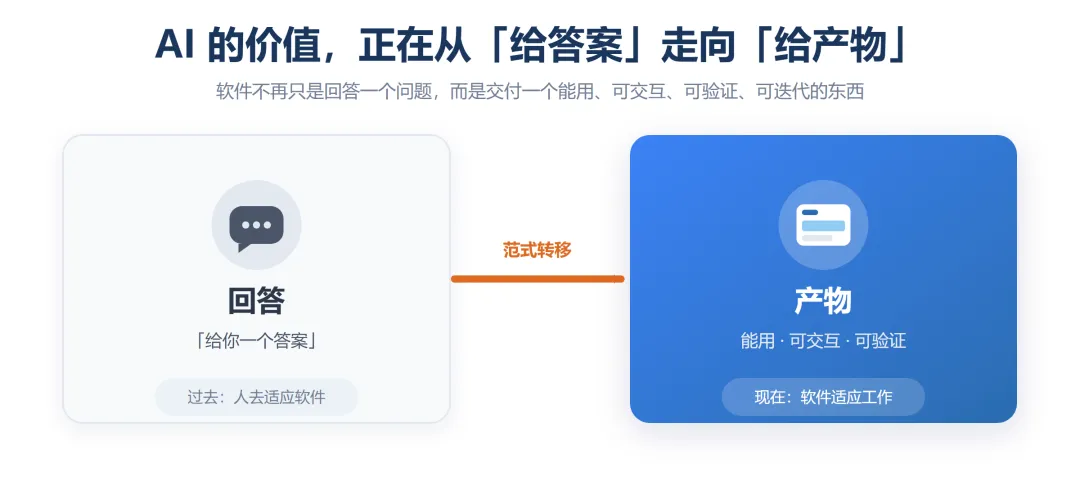
— 图1:AI 的价值,正在从「给答案」走向「给产物」
本文看点
01
从“会用 AI”到“会驾驭 AI”
02
证据驱动,最该补上的一课
03
从“学软件”到“让软件适应人”
01
PROMPTING
启示一:从“会用 AI”到“会驾驭 AI”,提问变成核心素养
过去我们教学生“会用软件”:打开 Word 排版、进 Excel 做表、上 PS 修图。但现在,GPT-6 的 Intelligent UI、Claude 的 Dashboards 和 Motion 告诉我们一件事——入口和“第一稿”正在归 AI,人要做的是提需求、定方向、不断迭代。
Claude Dashboards 里,每个数字都能点开看背后的 SQL;Claude Motion 里,动画不是视频生成模型“猜”出来的,而是代码驱动的,可编辑、可导出。这意味着未来的工作流是:人用一句话描述需求 → AI 生成第一版 → 人在关键节点做判断、做精修。
落到教学上,意味着:
提问(Prompting)要从“技巧”升级为“素养”。能把模糊的需求拆成结构化的、可验证的指令,会是比“记住某个工具怎么用”更硬的能力。
要教学生“描述目标”而不是“描述操作”。过去教“如何在 Excel 里做透视表”,未来更该教“如何让 AI 帮你把这份数据讲清楚,并且你自己能看懂它每一步做了什么”。
工具课要重新定位。如果一句 prompt + 外部连接器就能复现一个工具的核心功能,那这门课的价值就不再是“教会某个按钮”,而是“教会判断、组合、验收”。
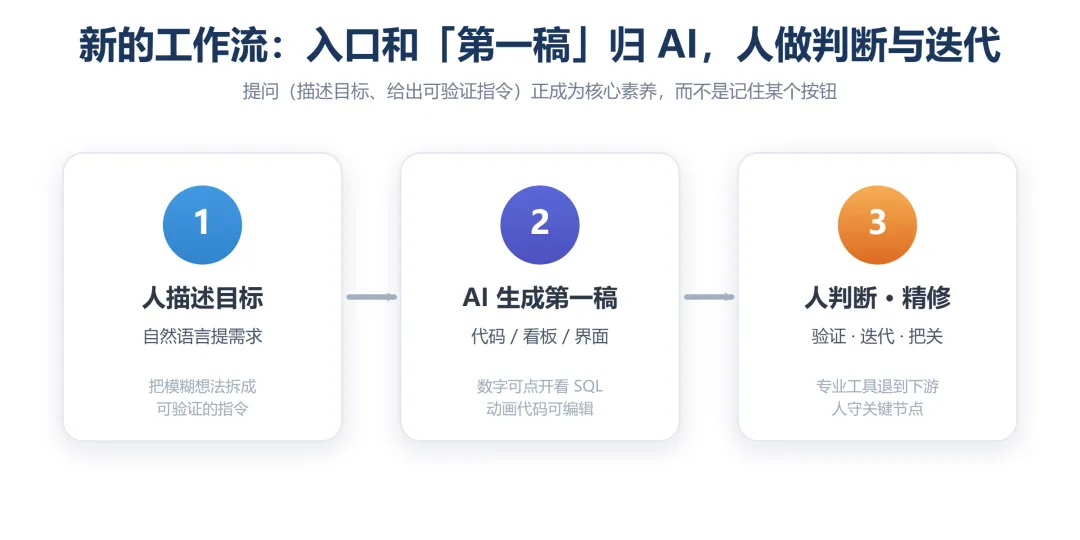
— 图2:新的工作流——入口和「第一稿」归 AI,人做判断与迭代
02
EVIDENCE
启示二:证据驱动,是 AI 时代最该补上的一课
REA 这个项目最打动我的,不是它“能逆向分析一切”的覆盖广度,而是它给自己立的规矩——结论必须附带证据和局限性。它给出的不是 AI 一句“我猜这个百分号按键是这样算的”,而是具体的汇编指令、调用链、字符串、截图。
这条规矩,恰好戳中了当前 AI 教育最大的隐患:
「学生太容易把 AI 的输出当成结论。」
纳德拉在文章里也有一个很务实的判断——“这不是要把所有工作都交给大模型”。规则明确、结果确定的地方,传统软件更快、更便宜、更可靠。这句话的反面是:凡是交给 AI 的地方,恰恰是最需要人“盯证据”的地方。
所以,高校 AI 教育最该补的一课,不是“怎么让 AI 答得更好”,而是:
如何验证一个 AI 结论是真是假(让 AI 自己给出证据链,再去核对);
如何区分“事实”和“AI 的合理推测”;
如何养成“默认存疑、证据驱动”的思维习惯。
一个学生能不能在 AI 给出漂亮答案后,追问一句“你的依据是什么、局限在哪”,可能比他会写多少种 prompt 更能决定他未来的上限。
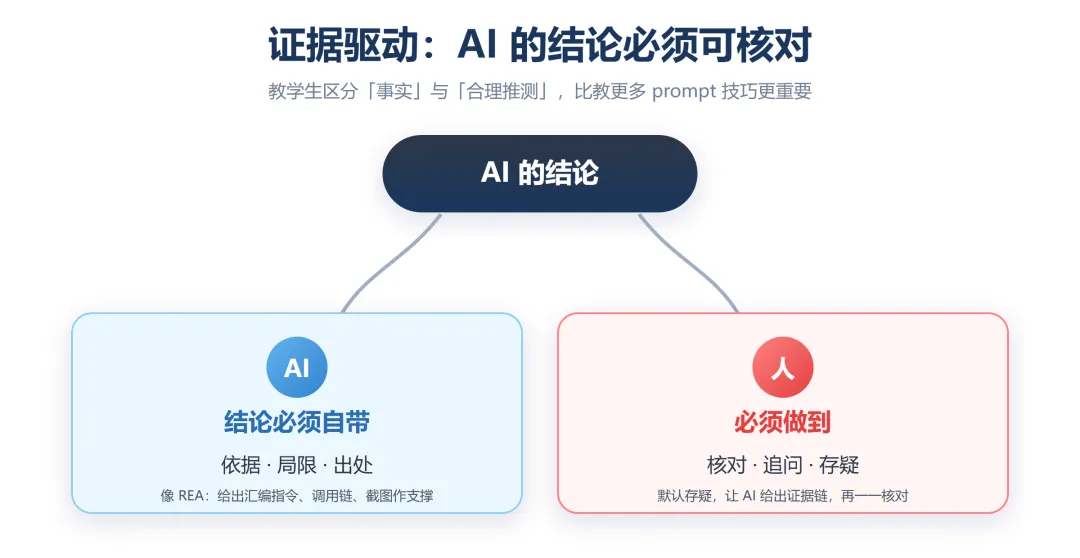
— 图3:证据驱动——AI 的结论必须可核对
03
ADAPTIVE UI
启示三:从“学软件”到“造软件”,再到“让软件适应人”
「过去人适应软件,未来软件适应工作。」
他提出了一个很清晰的两分法:员工交互的前端是 Head,背后的业务逻辑、数据、规则是 Headless。过去这些能力封装在一个个独立软件里,人要来回切换;未来 Agent 直接调用这些能力,把人从“围着软件转”里解放出来。
这给高校教育一个方向性的提示:我们培养的学生,将来面对的不再是“固定界面的软件”,而是“围绕任务动态生成的界面”。
GPT-6 的 Intelligent UI 已经在做这件事——不同问题自动选择不同的界面形式。OpenAI 那句话说得很有意味:“过去几十年,人们一直需要学习如何使用软件……未来的方向是,软件将开始主动适应人。”
这意味着几件事:
“界面操作技能”会加速贬值。今天花大量课时教学生“某个软件点哪里”,收益会越来越低。
“抽象和建模”会加速升值。能看清一个业务问题背后的数据结构、流程、规则(也就是纳德拉说的 Headless),才能把 AI 用对地方。
要有治理意识。Cloudflare OS 之所以能安全地让“人人都是开发者”,靠的是沙箱隔离和异步审批。未来学生进了企业,面对“每个部门都能自己生成应用”的局面,谁来保证数据一致、权限、安全、维护?懂治理、懂边界,会成为一种稀缺能力。
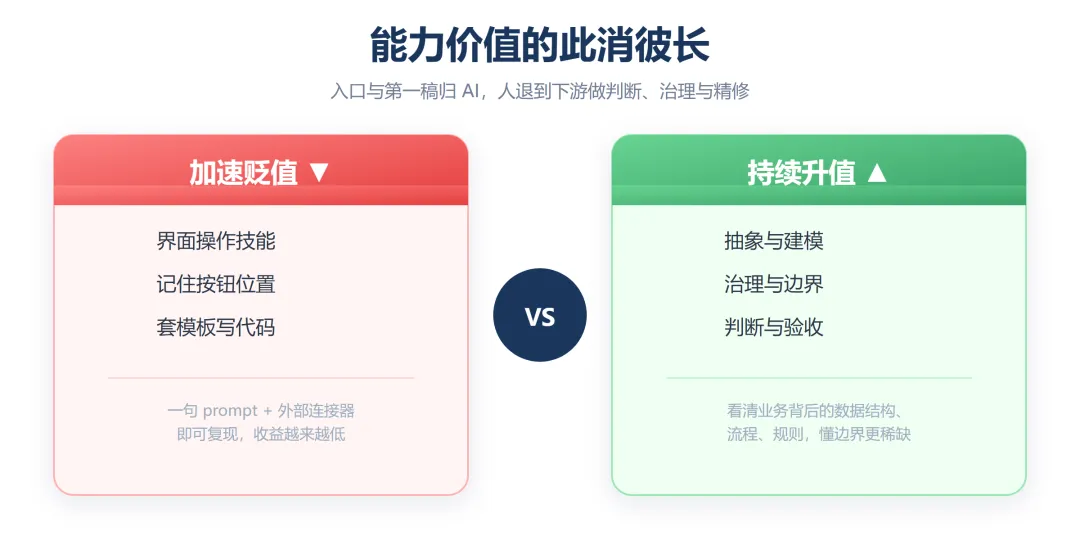
— 图4:能力价值的此消彼长
04
BUILD IT YOURSELF
启示四:造软件这么容易,学校信息化该由师生自己来
REA 让我们看到,逆向 + AI 已经能把一个闭源软件拆开、读懂、复现;Cloudflare OS 又让我们看到,非技术员工也能在沙箱里“手搓”出自己需要的软件。当“造软件”的门槛降到几乎为零,学校其实坐拥一座被忽视的富矿——师生的真实需求。
今天很多高校的信息化,走的还是“外包 + 采购”的老路:需求层层上报、预算审批、厂商排期、定制开发。业务部门提一句“想要个小工具”,往往要等上半年,最后拿到的还不一定好用。纳德拉说的“标准化软件很难覆盖每家企业的特殊流程”,放在高校同样成立——而高校最特殊、最分散的需求,恰恰是外边的厂商理解不了的:某个院系的排课小助手、实验室的设备预约、教务的某个报表、学生活动的报名统计……
但换个角度看,这些“碎片化需求”正是 AI 时代最好的教学现场:
师生最懂自己需要什么。让老师、学生自己描述需求,AI 负责生成第一稿,再迭代——这比任何虚构的课堂作业都真实。
真实项目是最好的训练。一个“帮教务处做个小工具”的真实任务,能同时练到提问、证据驱动、建模、治理,把前面几个启示串起来。
学校是天然的试验田。学生做的工具可以在校园里真跑、真用、真反馈,失败的成本趋近于零,学到的东西却是课本给不了的。
过去我们说“产学研结合”,常把“产”想成遥远的产业界。其实,学校本身就是最大的“产”——一所高校要运转,处处都需要软件。与其买现成的,不如让 AI 和师生一起,把学校的日常需求一点点“造”出来。这既是信息化建设,也是最好的 AI 教育。
∞
THE END
最后:给高校 AI 教育的五条具体建议
把上面的思考收一收,我想给出五条可以落到课程设计上的建议:
把“提问与验收”设为一门显性能力。开一门真正讲“如何给 AI 下需求、如何验收 AI 产出”的课,而不是只教工具操作。
把“证据驱动”贯穿所有 AI 相关课程。每份 AI 产出,都要学生附上“依据是什么、局限在哪、我核对了什么”,从机制上对抗“AI 说什么就是什么”。
重新定位工具课为“判断课”。与其教某个具体软件,不如教一类任务的解决思路,让学生自己决定“哪些交给 AI、哪些用确定性工具、哪些必须人来把关”(呼应纳德拉的 Token 判断)。
把“治理”纳入培养目标。当“人人都是开发者”成为现实,懂安全、懂权限、懂边界的毕业生,会比只会写 prompt 的更稀缺。
让师生参与学校信息化建设。把校园里真实的碎片化需求(排课、预约、报表、活动报名)变成课程项目,让 AI 和师生一起“造软件”。既解决学校的实际问题,又让学生在真实场景里练出真本事。
「面对更大的未知,人类依然只是刚刚出发。」
模型越来越强,AI 能做的事越来越多,但“判断力、批判性、治理意识”这些真正稀缺的东西,并没有因为 AI 变强而贬值,反而更突出了。
高校 AI 教育的使命,也许从来不是教会学生“和 AI 抢活干”,而是教会他们:
「在 AI 把路铺好之后,知道该往哪走,以及——为什么。」
而最好的起点,或许就在脚下:当“造软件”和“聊软件”一样容易,让师生从改造自己的学校开始,用 AI 把真实的问题一个个解决掉——教育这件事本身,也就跟着一起被“开源”了。