ARTICLE · 1215297
AI 圈天天说的“蒸馏”, 到底在蒸什么?
用 5W+H,把大模型时代最流行的一项“手艺”讲透
化学里的蒸馏:从浑浊的壶里,接住清澈的精华
引子:一个反常的现象
在手机上问一句“帮我把这通电话总结一下”,两秒钟出结果。
这项本领放在几年前,只有云端那个庞然大物才有——它吞下了半个互联网,参数以千亿计。而你现在口袋里这位,比它小了成百上千倍,却依然对答如流。
差距去了哪里?
答案只有两个字:蒸馏。 |
化学里的蒸馏,是从一壶浑浊的液体里提取精华:加热、汽化、冷凝,接住的酒滴清澈见底。人工智能里的蒸馏是同一件事——从一颗庞大的“大脑”里,把值得带走的东西提取出来,装进一个小得多的容器。
值得带走的是什么?不是参数,不是数据,甚至不是答案。
是分寸。
下面按What、Why、Who、When、Where、How 六问展开,把这件事从头讲到尾。
一问What:蒸的到底是什么?
先讲一位老师傅。
老字号药铺里,药方就挂在墙上,谁都能抄。可徒弟还得跟着师傅学上三年——学的是抓药的轻重、火候的深浅、看人下方的分寸。药方是“对与错”,分寸是“像与不像、该与不该”。后者写不进纸,只能传。
2015 年,“深度学习之父”杰弗里·辛顿(Geoffrey Hinton)与两位谷歌同事发表论文,把这套“传分寸”的手艺搬进了神经网络,正式命名为知识蒸馏(Knowledge Distillation)。一句话概括:让一个庞大的教师模型做示范,让一个小巧的学生模型模仿——模仿的不是答案,而是教师面对每个问题时那一瞬间的犹豫。
图1 | 师徒之间传的从来不是药方,而是分寸
软标签:藏在“犹豫”里的暗知识
神经网络判断一张图片时,输出的是一串概率,而不是一个“对”字。
拿一张猫的照片来说。标准答案只有一个字:猫。教科书上管这种答案叫硬标签——非黑即白,信息量为零。
但教师模型的判断要丰富得多:猫,0.72;老虎,0.12;狗,0.09;狐狸,0.04;汽车,0.02;石头,0.01。
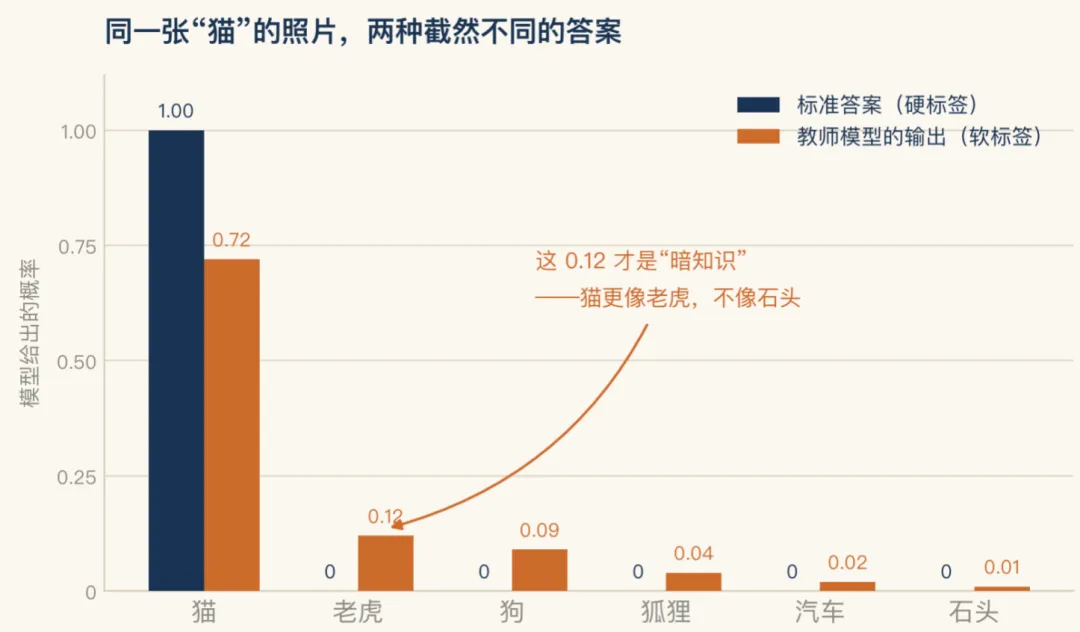
图2 | 硬标签只给“对错”,软标签给出“关系”
请注意那个0.12。它不是噪声,是这位“老师”毕生见识的残留:这张照片里的猫,确实有几分老虎的神气——猫科、毛茸茸、眼神锐利;但它和石头之间,隔着十万八千里。辛顿给这类信息起了个名字,叫暗知识(dark knowledge):答案本身说不出口、标签纸上写不下来,却实实在在藏在概率分布里。
软标签的珍贵之处:它一步就把“类与类之间的关系”教给了学生。硬标签教的是“是什么”,软标签教的是“像什么、不像什么”。后者,才是判断力。 |
温度T:让老师把话说“软”
这里有一个技术细节,也是蒸馏最巧的一笔。
神经网络输出概率之前,要先对一串原始打分(logits)做一次 softmax 变换。softmax 有个“温度”参数 T:
p = exp(z / T) / Σ exp(z / T)
T 等于 1,就是日常输出——教师说话斩钉截铁:猫,93%,别的,忽略不计。
T 调大,分布就变“软”:猫,53%;老虎,20%;狗,14%……教师的犹豫浮出水面。T 再调大,分布趋于均匀,信息反而被稀释。
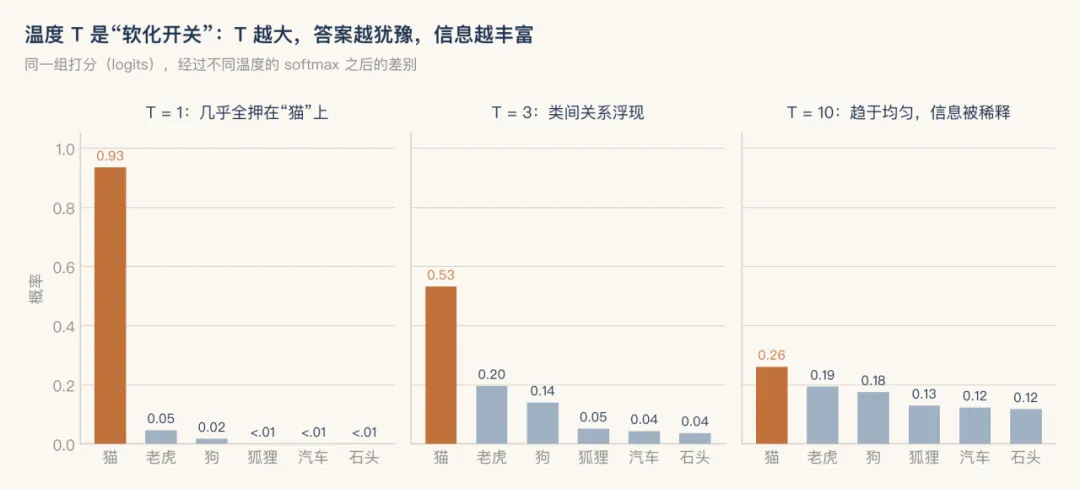
图3 | 温度是“软化开关”:训练时调大,部署时归位(程序绘制)
打个比方:老师批卷子时只勾“对”“错”,学生只能学个对错;要是老师把“为什么像错、错在哪里”一并讲出来,学生学到的是思路。蒸馏训练时把温度调大,就是要老师多说话;部署上线时再把温度调回 1,让学生像所有正常模型一样干脆作答。
师生同题共答
剩下的一半,就是一次考试:教师和学生做同一道题,各自输出概率分布,损失函数负责量出两份答案差多少,再把差距折算成梯度,回头修正学生的参数。教师自岿然不动,学生夜夜长进。
这套循环,就是蒸馏的全部骨架。
二问Why:为什么要蒸馏?
道理很朴素:大模型很好,但你“用不起”。
第一是钱。千亿参数的模型每回答一句话,都要调动庞大的算力集群。云端调用按量计费,一次几分到几毛钱,看似不贵,乘以上亿用户、乘以全天候的请求量,就是一笔天文数字。
第二是时间。请求从手机出发,到机房,再折返,一来一回几百毫秒起步。可手机输入法的联想、通话的实时转写,要求的响应是几十毫秒级。物理距离不答应。
第三是隐私。病历、聊天记录、公司合同,凭什么要上传到别人的服务器?很多判断必须留在本地完成。
第四是场景。地下车库没有信号,工厂车间没有机房,汽车座舱不能依赖网络。判断力必须能搬进这些地方。
蒸馏的答案直截了当:把“贵的能力”做成“便宜的日用品”。它从不许诺学生超过老师——通常也超不过——它追求的是另一件事:用百分之一的代价,保留九成以上的本事。至于剩下那一成,绝大多数场景用不到。 |
三问Who:这件事都有谁在做?
起头的是学术界。2006 年,里奇·卡鲁阿纳(Rich Caruana)等人在一篇题为《模型压缩》的论文里首次演示:用大模型的输出训练小模型,小模型能学到大模型的本事。2015 年辛顿给它起了名字、补上了温度机制,蒸馏从此有了自己的门派。顺带一提,辛顿因为深度学习的奠基性工作获得 2024 年诺贝尔物理学奖。
接手的是工业界。谷歌、Hugging Face、华为以及各家芯片厂商的端侧团队,把蒸馏当成日常工具:输入法、相册、语音助手背后的小模型,多数出身于这条流水线。2019 年 Hugging Face 团队的 DistilBERT 是标志性成果:参数减少 40%,推理提速 60%,性能保留约 97%——第一次让业界看到,“九成本事”是能兑现的承诺;次年华为的 TinyBERT 又把蒸馏做到了极致轻量,体积只有教师的约一成,速度却快了近十倍。
放大它的是开源社区。2023 年,斯坦福的 Alpaca 项目用 GPT 系列模型批量生成 5.2 万条指令数据,训练出 LLaMA-7B 的小型追随者,成本不过数百美元;2025 年初,DeepSeek 发布 R1 推理模型的同时,公开了蒸馏到 1.5B 到 70B 的整套小模型权重——一次蒸馏,全行业受益。
盯着它的,是规则制定者。2025 年初,海外曾就“模型输出被用于训练竞品”发生公开争执,涉及服务条款与知识产权的边界。这场争执没有标准答案,却说明了一件事:蒸馏早已不是纯技术问题,而是行业规则问题。谁在做?做的人,和盯着做的人。
四问When:二十年,一条线
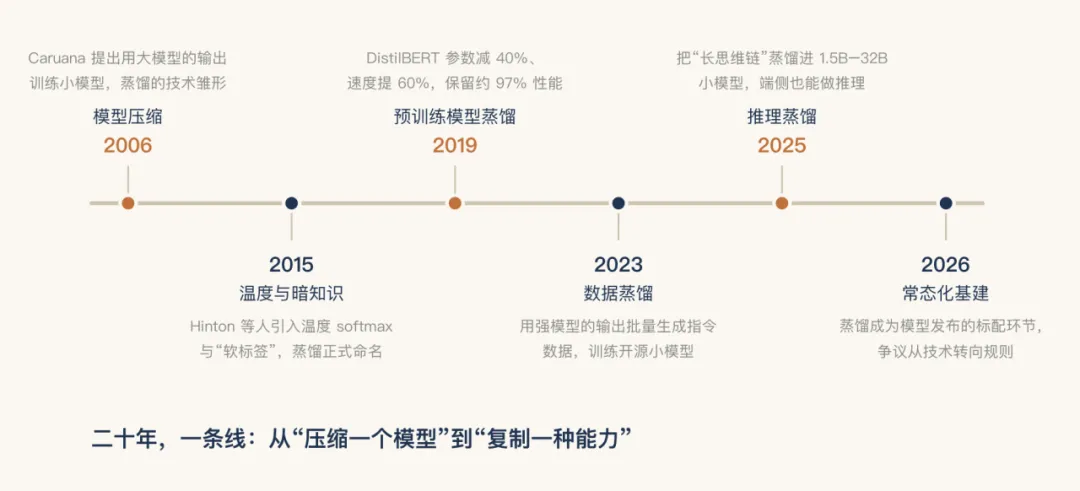
2006 年,雏形。卡鲁阿纳证明“小模型可以喝大模型的汤”,论文名字就叫《模型压缩》,彼时还没有“蒸馏”这个词。
2015 年,命名。辛顿等人补上温度与软标签两块基石,蒸馏正式成军。同一时期,FitNets 等工作把模仿对象从输出层深入到中间层。
2019 年,落地。DistilBERT 交出“小 40%、快 60%、强 97%”的成绩单,蒸馏从论文走进生产环境。
2023 年,变奏。大模型时代到来,蒸馏的主体从“概率分布”扩展到“数据本身”:用强模型的输出批量制造训练数据,去养另一个模型。Alpaca 是这一路的代表。
2025 年,跃迁。推理模型登场,蒸馏的对象变成了“思维链”——不只蒸结论,连解题的步骤、自我检查的习惯一并蒸过去。DeepSeek-R1 用 80 万条样本(60 万条推理、20 万条通用),蒸出六个规格的小模型;其中 7B 的学生模型,在 2024 年美国数学邀请赛(AIME 2024)上拿到 55.5% 的正确率,反超了此前不少体积大得多的模型。
今天,常态化。蒸馏已是模型发布流程的标配环节,争议的焦点从“能不能做”转向“按什么规则做”。
五问Where:它藏在哪些地方?
蒸馏没有存在感,因为它总在最不起眼的地方工作。
l手机里。输入法的联想词、相册的“搜一下小狗”、通话摘要、离线语音转写——这些毫秒级响应的判断,背后几乎都是蒸馏出来的小模型。
l汽车里。座舱语音助手要在隧道里照常工作,只能本地运行,只能足够小。
l键盘上。代码补全工具大多分两档:云端大模型负责难题,本地小模型负责实时提示,后者靠蒸馏养成。
l企业的内网里。医院、银行、律所不敢把数据送出内网,蒸馏过的小模型是他们用得上大模型能力的唯一途径。
l车间的摄像头上。缺陷质检、安全帽识别,几瓦功耗的边缘设备,装的正是教师模型“下放”的眼力。
判断依据只有一句话:哪里需要判断力,又装不下一个大模型,哪里就有蒸馏。 |
六问How:一次蒸馏是怎么做成的?
把六步流程走一遍,还是用那只猫举例。设想你要给手机相册做一个“宠物照片自动分类”功能:教师是云端的一个百亿参数大模型,学生是只装得下五百万参数的小模型。
第一步,选教师,定考纲。教师的判断力决定学生的上限,选型就是选血统;同时圈定任务范围——分类猫狗鸟,就别拿微积分考它。
第二步,采示范。让教师过一遍几十万张照片,把每一张的完整概率分布都记下来。这一步产出的是“软标签数据集”——注意,存的是分布,不是答案。
第三步,调温度。训练时把温度T 设为 3 到 5,让教师的判断充分软化、关系尽出(见图 3)。T 是个超参数,太大则信息稀释,太小则退化成普通模仿。
第四步,定损失。学生的每一步训练,同时比较两份差距:
总损失= α ×(与标准答案的差距)+(1 − α)× T² ×(与教师软标签的差距)
前一项叫交叉熵,管“别答错题”;后一项叫 KL 散度,管“别丢了老师的手感”。α 是两者的配比,T² 是温度带来的量级修正。一手抓对错,一手抓分寸——缺了前一项,学生学得飘;缺了后一项,学生学得死。
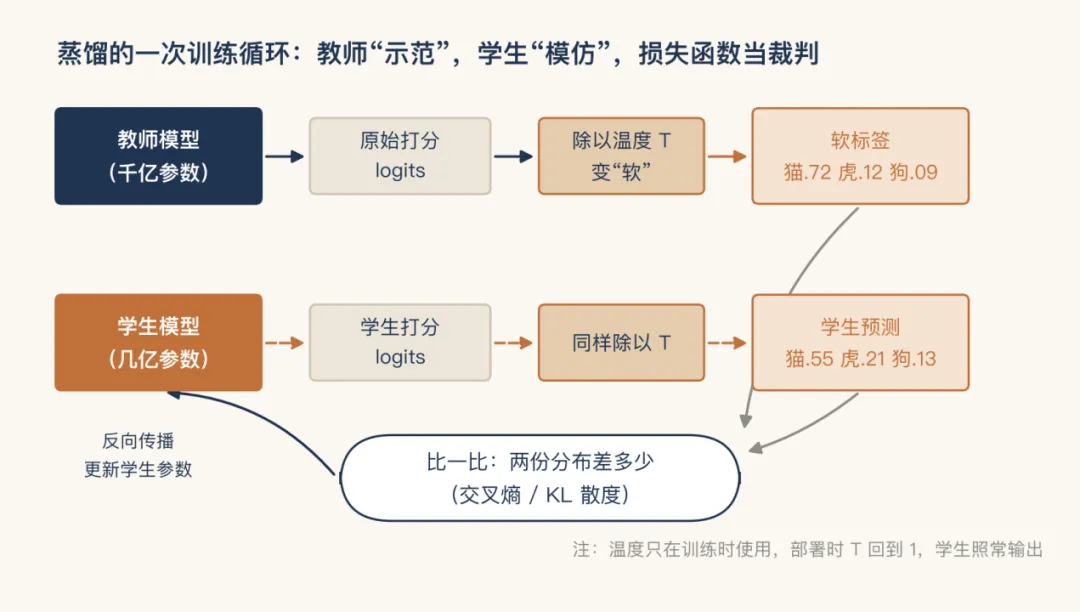
图5 | 一次训练循环:教师示范,学生模仿,损失函数当裁判
第五步,选路线。“蒸馏”一词之下,其实有三条深浅不同的路径:
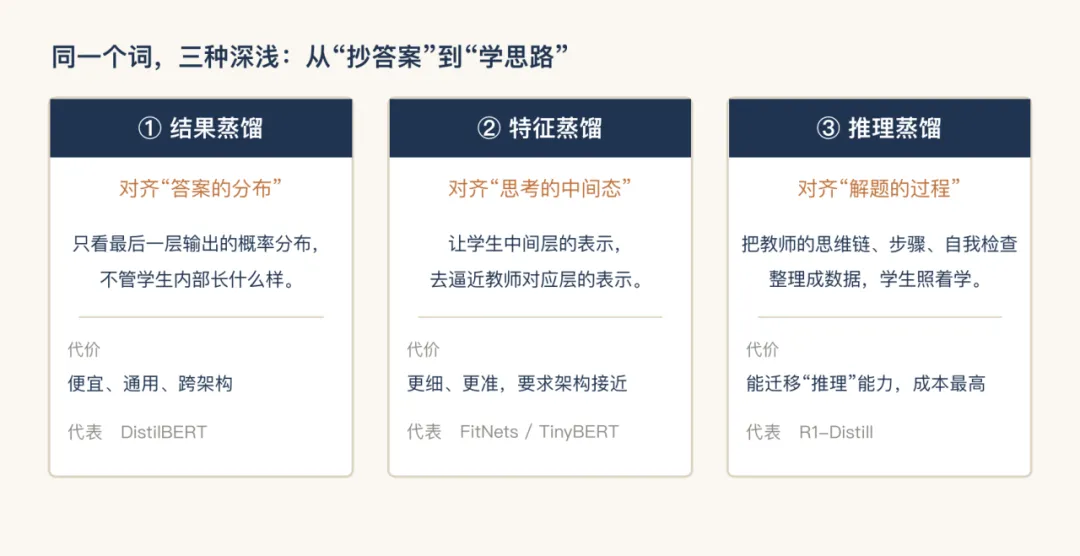
图6 | 三条路线:从“抄答案”到“学思路”
结果蒸馏最便宜,只对齐最后的输出分布;特征蒸馏更细,要求学生的中间层去逼近教师的中间层,近乎“脑成像”级别的对照;推理蒸馏最深,把教师的思维链、步骤、自我检查整理成数据让学生照着学——成本最高,但连“怎么想”都能迁移。2025 年以后,第三条路线成了主角。
第六步,部署归位。温度调回1,学生以常规方式输出;如需进一步压缩,再叠加量化(把数值精度降下来)与剪枝(把冗余连接裁掉)。蒸馏、量化、剪枝,是模型轻量化的三件套,常一起出场。
六步走完,那个五百万参数的小模型就可以装进你的手机:不联网,不耗云端算力,几十毫秒内告诉你照片里是猫、是狗,还是一只表情神似猫的拖鞋。
尾声:边界与三句提醒
蒸馏不是魔法,它的边界和它的能力一样清晰。
其一,学生的天花板是教师。蒸馏搬运的是已有的判断力,不能无中生有。教师没见过的世界,学生也照样陌生。科学前沿的突破,仍然要靠“贵的大脑”去撞墙。
其二,偏见会随精华一起蒸过来。教师的幻觉、成见、错误关联,会被软标签原样录入学生的肌肉记忆。文献里管这叫幻觉继承——学生不仅学会了老师会的,也学会了老师错信的。
其三,循环蒸馏有退化风险。2024 年《自然》杂志刊发的研究警示:当模型反复用“自己生成的数据”训练一代又一代,分布会逐渐坍缩,多样性流失——如同副本的副本,越来越模糊。蒸馏必须锚定在真实世界的数据上,否则蒸汽里接不出清水。
最后是规则问题。别人的模型输出能不能拿来做训练?服务条款、版权、竞争秩序,各执一词,悬而未决。技术跑在了共识前面,这在AI 行业不是第一次。
结语
化学里的蒸馏有种朴素的浪漫:无论壶里的酒多浑,蒸汽升腾、冷凝落下,接住的总是清澈的。
人工智能里的蒸馏拷问的,其实是同一个古老的问题——一个“大脑”里,真正值得带走的是什么?
答案未必是参数,而是分寸。 |
只是还有一个问题,值得留在这里:当学生越来越多、教师越来越少,我们是在蒸馏智慧,还是在稀释它?这个问题,恐怕要留给下一个二十年。