ARTICLE · 1217605
AIOps 实战:开发 MCP 和 Skill,让 AI 帮你查询 CMDB
一个应用部署在哪里、归谁负责、关联了哪些资源?这些信息通常保存在 CMDB 里。CMDB 是配置管理数据库,用来记录应用、主机等资源的信息,以及它们之间的关联关系。
平时查一个应用的部署位置,往往要打开 CMDB,找到对应记录,再沿着关系逐层查看。这次我把查询能力接入了 AI 助手,让这些操作可以通过对话完成。
之前的文章介绍过 MCP 和 Skill 的原理,这次把它们用在一个具体的运维场景里:用 MCP 适配层把 CMDB 的查询接口提供给 AI,再用 Skill 写清楚查询步骤和回答要求。
这次使用的两个 AI 助手客户端分别是阿里的Qoder 和 腾讯的CodeBuddy 。Agent 可以理解用户的问题、调用查询工具,再根据返回的数据组织答案。
先看一次应用部署查询
本文用 orders-demo 这个示例系统来说明查询过程。它包含 orders 和 inventory 两个应用服务。
在 Qoder 或 CodeBuddy 中,可以直接问:
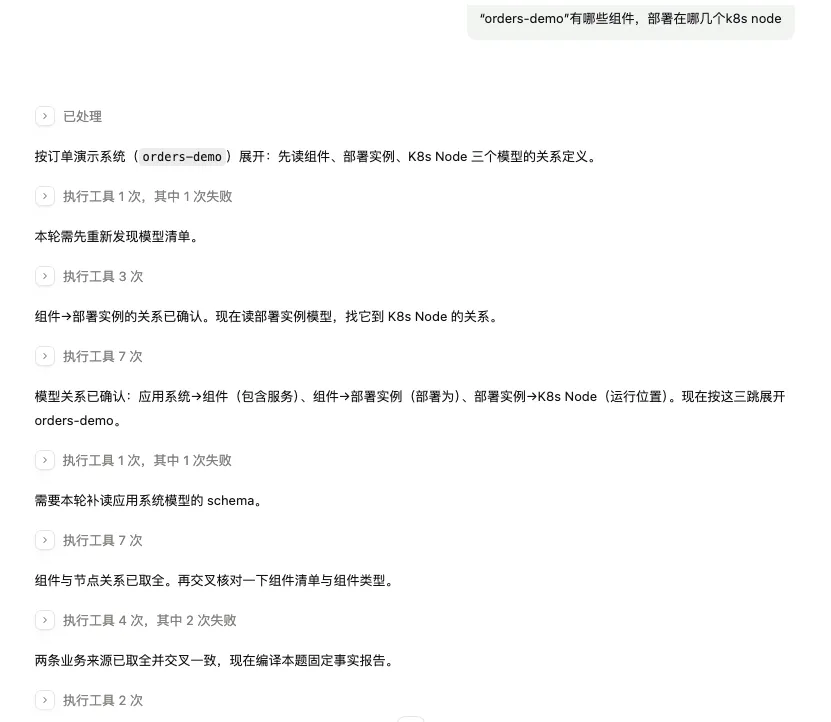
orders-demo 包含哪些应用服务,分别部署在哪个节点上?
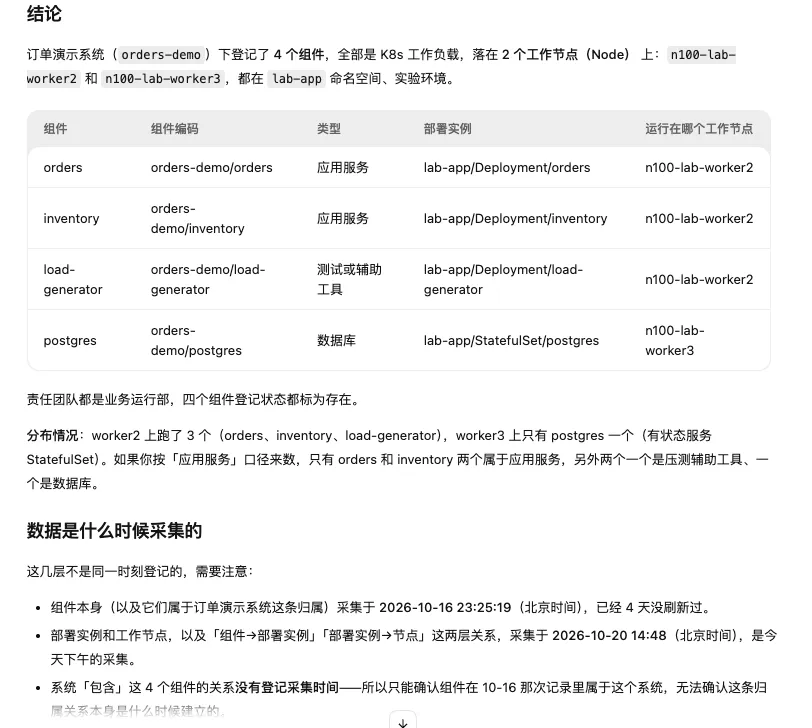
这次实验中,两个应用服务的部署位置可以整理为:
要回答这个问题,Agent 需要先找到系统包含的服务,再沿着部署关系找到运行它们的节点,最后把对应关系整理出来。
除此之外也可以查询配置项详情、统计集群节点数量,以及追踪应用关联的存储资源。这次在两个客户端中完成了相关验证,节点数量、角色、应用组成和部署位置等结果,也与 CMDB 和实际环境做了核对。
实现思路
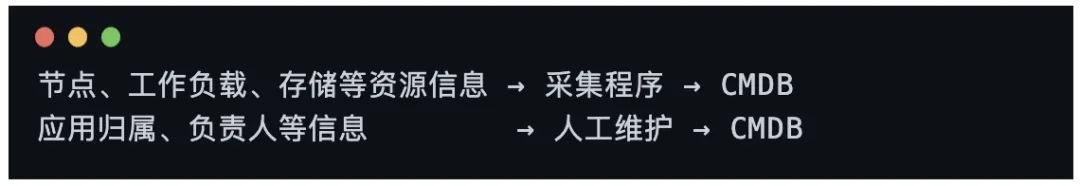
先看数据从哪里来。采集程序把节点、工作负载和存储等资源信息写入 CMDB,应用归属和负责人等信息由人工维护。
用户提问后,查询需沿着下面这条路径进行:
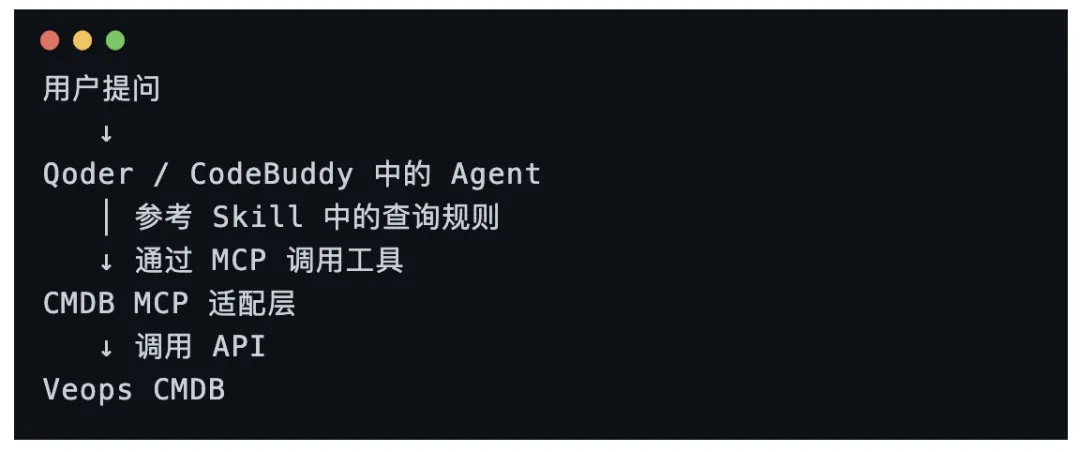
MCP 适配层负责把 CMDB 的接口转换成 Agent 可以调用的工具,执行数据查询;Skill 写明面对一个问题应该查哪些数据、沿哪些关系继续查,以及怎样组织答案。具体的工具选择和调用由 Agent 完成,查询结果再沿原路返回。
Agent 回答的依据是 CMDB 中已经登记的数据。 资源采集是否及时、关联关系是否维护完整,都会影响它能查到什么。
先准备一套实验环境
这次实验用的是一台搭载Intel N100处理器的小主机。我把这台实验主机作为本地服务器,用来运行 CMDB、Kubernetes 集群和相关实验服务。
为了在一台机器上模拟多个 Kubernetes 节点,我使用了 kind。它可以用 Docker 容器搭建本地 Kubernetes 集群。这次搭了1个控制节点(control-plane)和3个工作节点(worker)。
与本文查询过程直接相关的环境信息如下:
n100-lab,运行示例应用 | |
orders 和 inventory 等应用组件运行在 Kubernetes 的 lab-app 命名空间中,可以把它理解为这组实验资源所在的逻辑分组。这两个业务服务都部署在工作节点 n100-lab-worker2 上。
订单演示系统的部署架构
orders-demo (订单系统)除了 orders 和 inventory 两个业务服务,它还包括 PostgreSQL 数据库和用于产生实验流量的 load-generator。四个组件都部署在 n100-lab 集群的 lab-app 命名空间中。
下面按“系统 → 组件 → 部署单元 → 节点 → 集群”展示它们的对应关系:
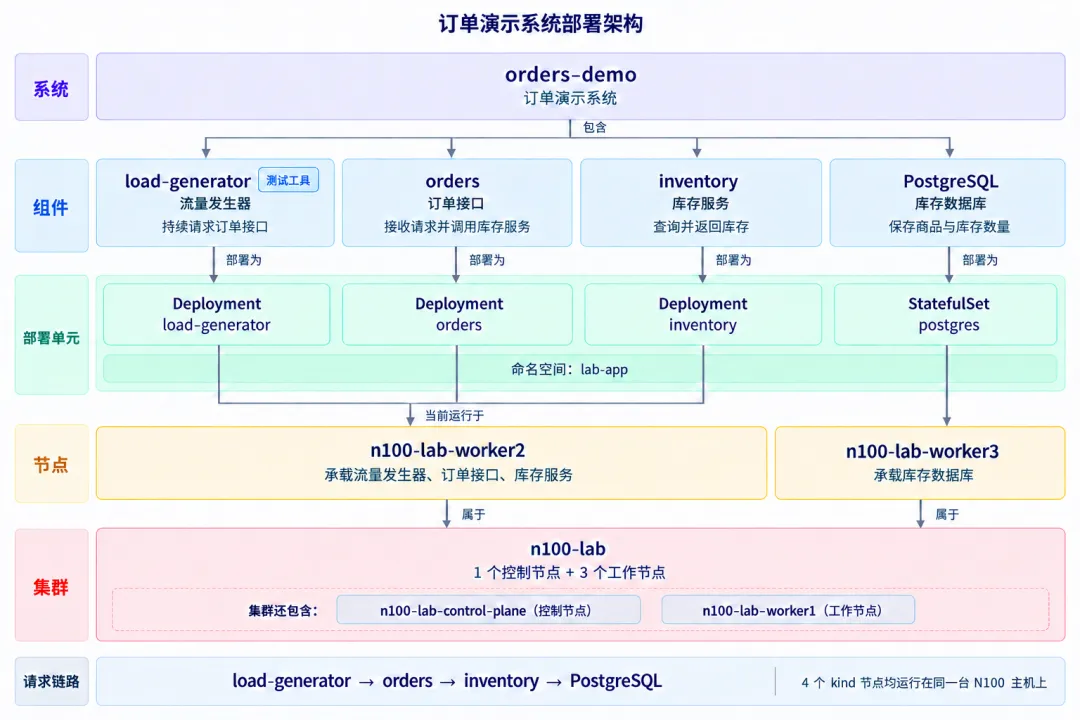
图中的“组件”表示系统里承担一项职责的逻辑对象,“部署单元”表示这个组件在集群里的一份具体部署,对应后文 CMDB 中的“部署实例”。这里使用了三个 Deployment 和一个 StatefulSet,它们管理实际运行的 Pod。
orders | /orders 请求,调用 inventory 查询库存,再将结果组织成响应。 |
inventory | inventory 表读取商品编号与库存数量,并返回给 orders。 |
inventory 提供数据查询;在集群中对应 StatefulSet/postgres。 | |
load-generator | orders,持续产生实验流量,便于观察请求指标、应用日志和调用链;它是本实验的测试工具。 |
一条演示请求会沿着 load-generator → orders → inventory → PostgreSQL 这条链路执行,查询结果再逐层返回。
orders、inventory 和 load-generator 部署在 n100-lab-worker2,PostgreSQL 部署在 n100-lab-worker3。集群还包含 n100-lab-control-plane 控制节点和 n100-lab-worker1 工作节点,worker1工作节点主要部署以后实验用的“监、管、控”运维系统,这里不展开。
先把配置数据和配置关系采集到CMDB
这次使用的 Veops CMDB是一个开源项目,提供模型管理、配置项管理和关系查询能力,也有对应的 API,方便在它之上开发 MCP 适配层。
这里有三个概念,用 orders-demo 就能说明白:
• 模型是资源的类别,例如“应用系统”“应用服务”“主机”。 • 配置项是某个类别里的一条具体记录,例如应用系统 orders-demo、应用服务orders。• 关系说明这些记录如何关联,例如 orders-demo包含orders服务,服务再关联部署实例和运行节点。
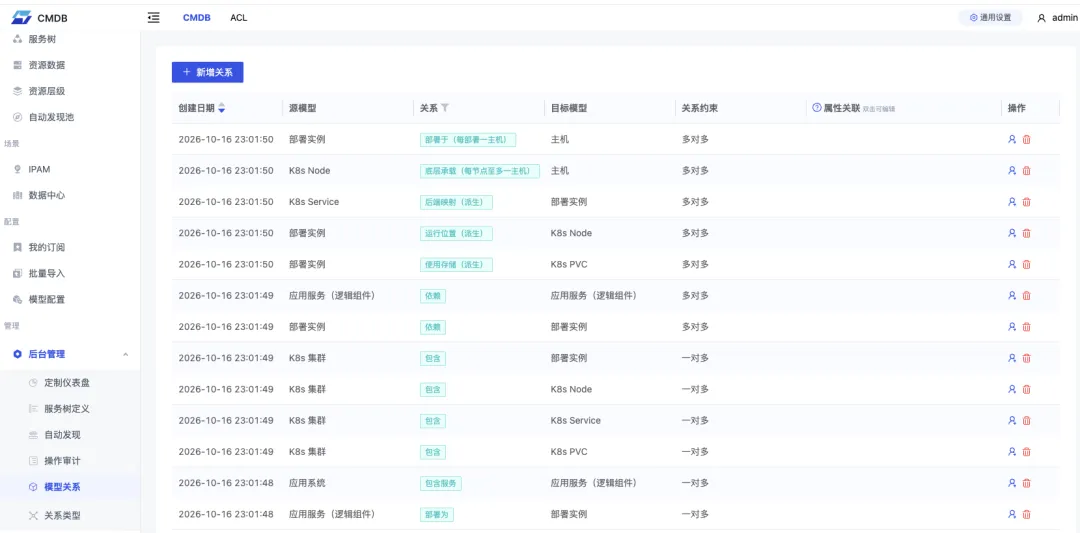
我在 CMDB 中设计了八类模型:应用系统、应用服务、部署实例、主机、K8s 集群、K8s Node、K8s Service 和 K8s PVC。
同时也设计好配置项之间的关系,就可以沿着应用逐步找到承载它的资源:
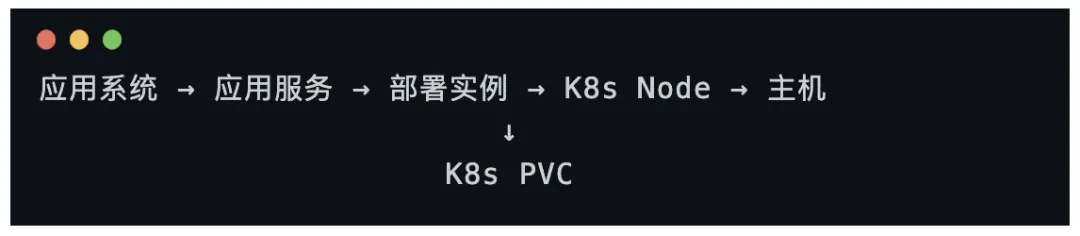
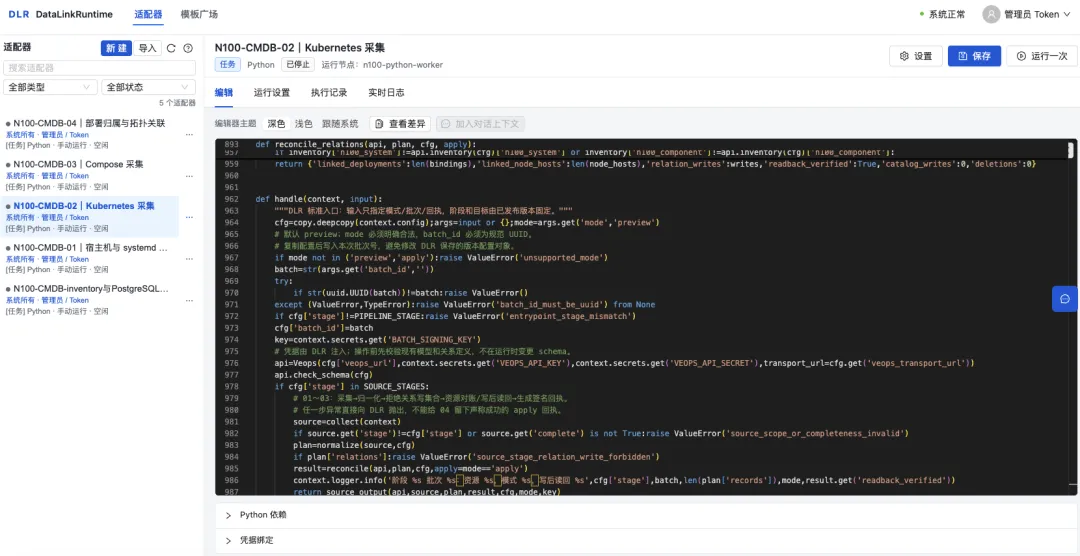
使用自研的AI采集器,对接k8s接口采集数据和关系,然后对接Veops接口存入。
还有一些靠自动采集不到的,如系统与应用服务、应用服务之间的关系,配置项中的责任部门、责任人等信息。
在生产环境中以上信息通常需要对接ITSM等外部系统获取,为了方便这里采用人工输入补全。
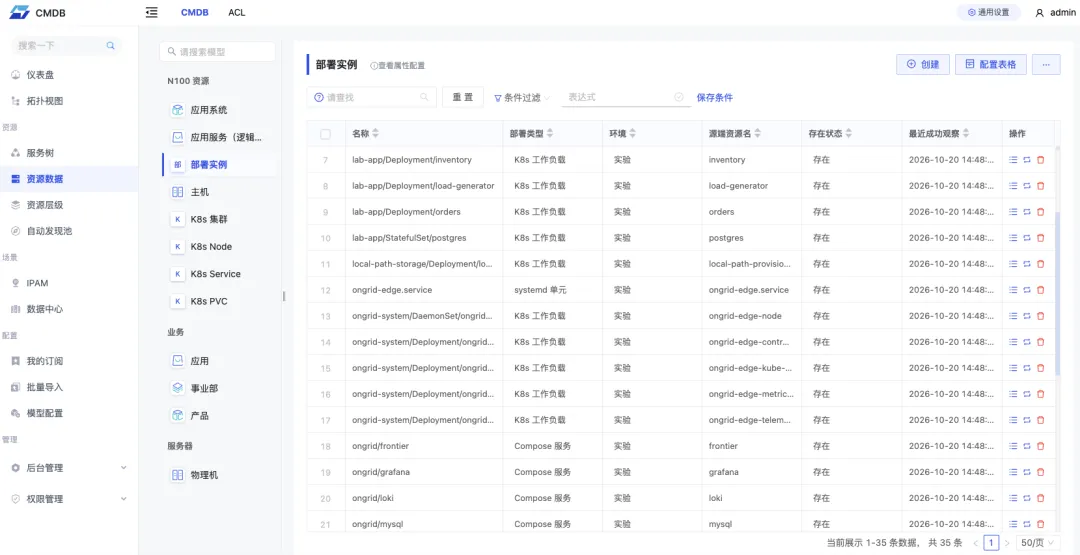
开发实现适配层
开发适配层之前,我先让 coding agent阅读 Veops 的 API 文档,并对照当前部署版本的源码,确认模型、属性、配置项和关系接口的用法。
设计主要围绕几个问题展开:查询CMDB都有哪些场景,对应的API需要什么参数,agent如何读懂配置模型,以及怎样处理鉴权、分页、统计和关联查询。
随后使用OpenSpec整理需求和验收条件,再分步实现。比如“查询全部部署实例”需要处理分页,“统计各类部署的数量”需要明确分组字段和总数,这些要求也对应后面的测试用例。
这次开发的 MCP 适配层使用 TypeScript 和 MCP SDK,通过 Streamable HTTP 提供服务,客户端通过 HTTP 连接调用。
MCP 适配层负责实际查数。 它接收agent的工具调用请求,将查询条件转换成 Veops API 请求,处理鉴权、分页和结果整理,再把数据返回给 Agent。
本次开发了六个只读工具:
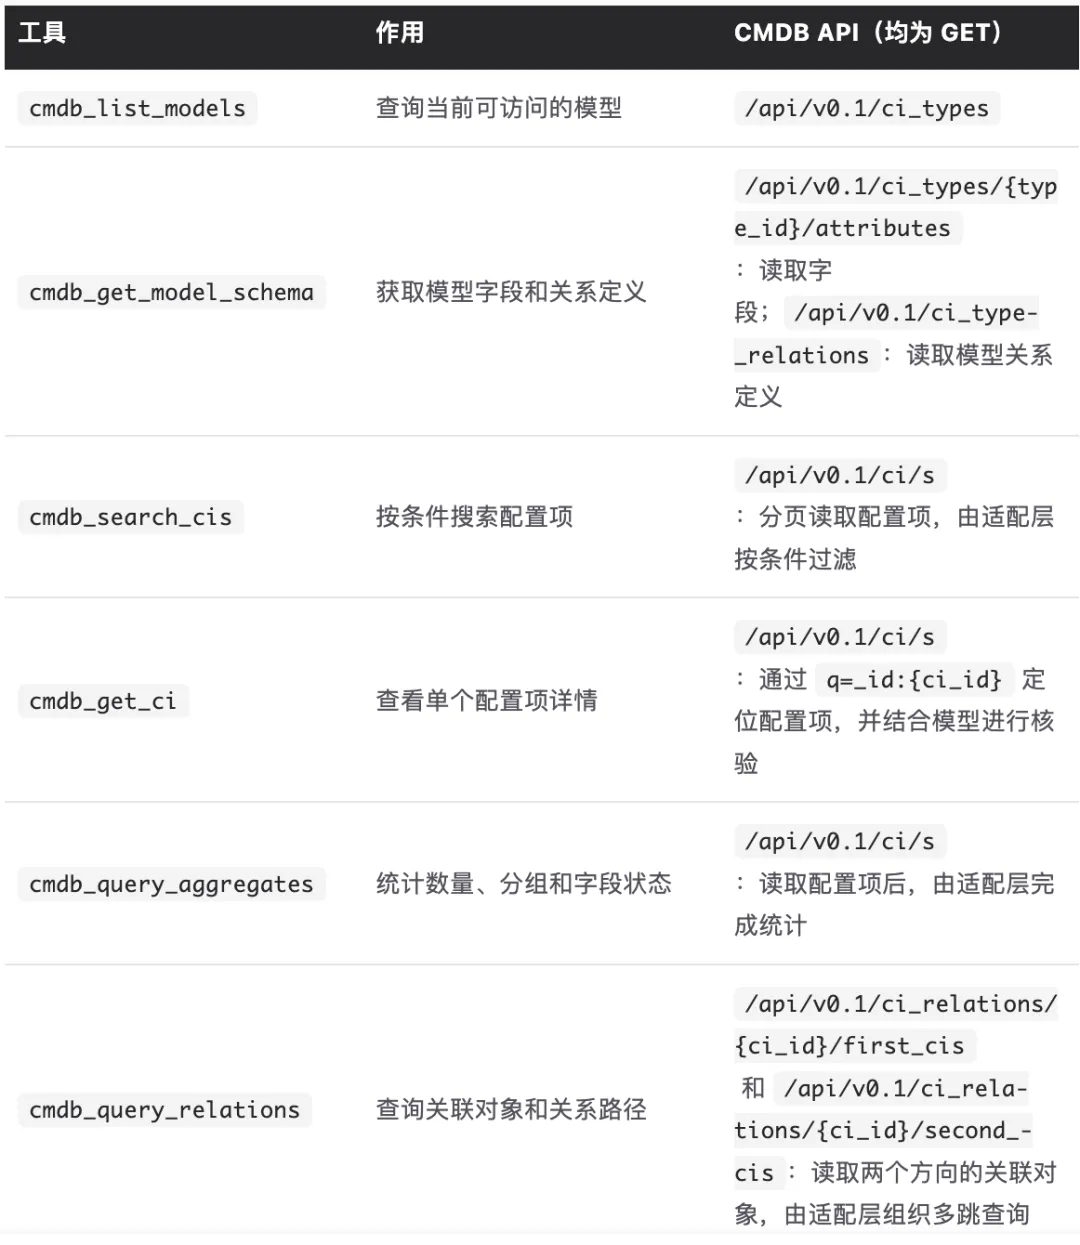
数量统计、关系去重等适合确定性处理的工作,由程序完成。Agent 根据返回的数据解释结果,不要让agent对着一大段文本重新做抽取和计算,这样既省token又降低因AI幻觉导致的计算错误。
接口侧使用专门的只读账号,客户端通过查询令牌访问 MCP 服务。
接入 Qoder 和 CodeBuddy
适配层部署后,根据各家的配置文档,让Qoder 和 CodeBuddy 连接同一个 MCP 服务。
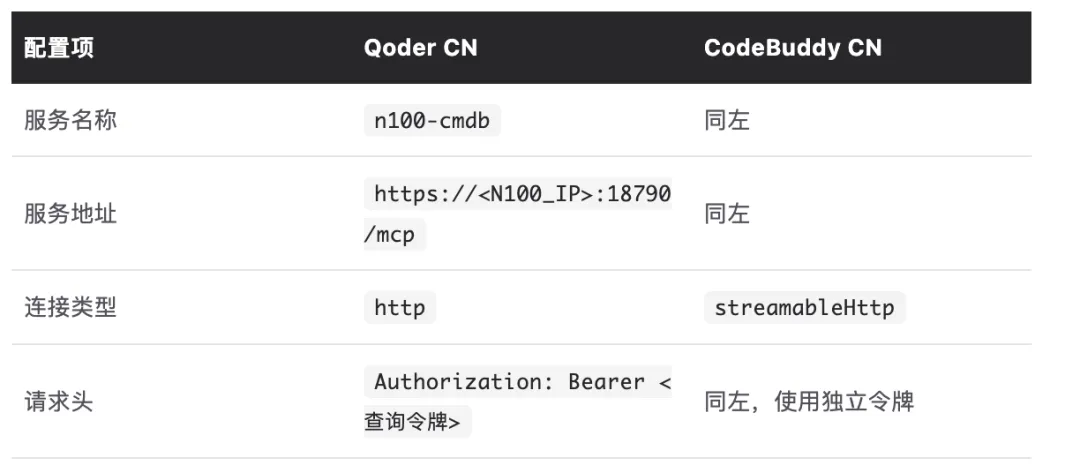
配置好服务地址、令牌和证书信任后,客户端就能发现这六个工具。
我分别在两个客户端中测试了模型查询、字段读取、配置项搜索、统计和关系查询,并通过请求 ID 对照服务端日志,确认调用经过了 MCP 适配层,数据来自 Veops。
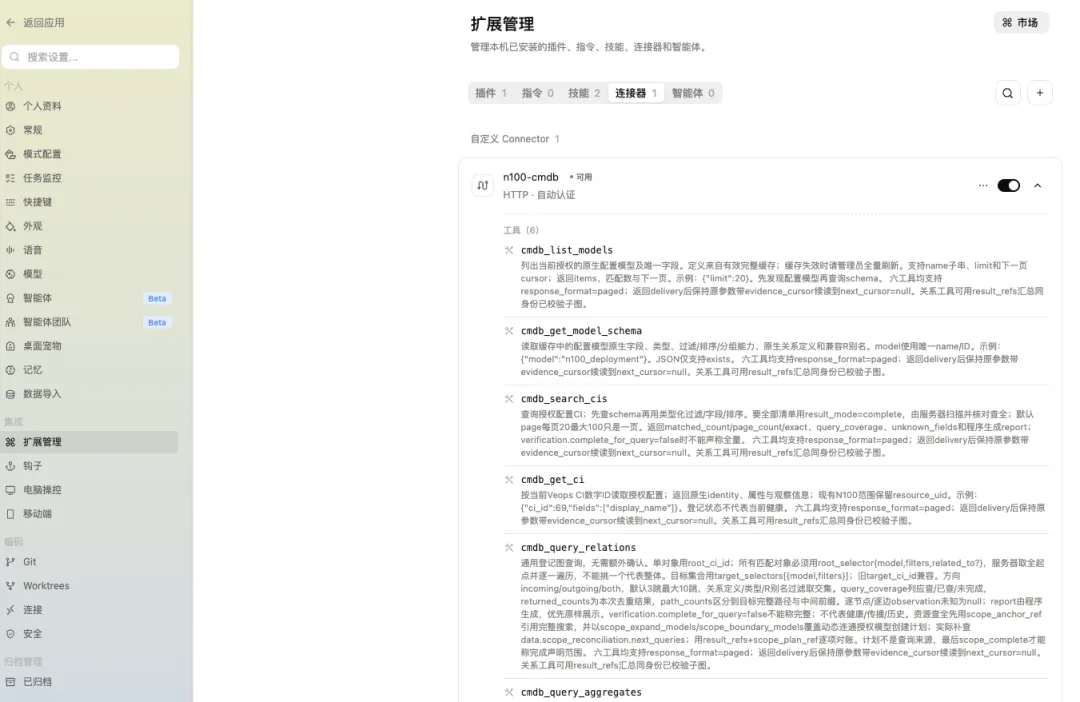
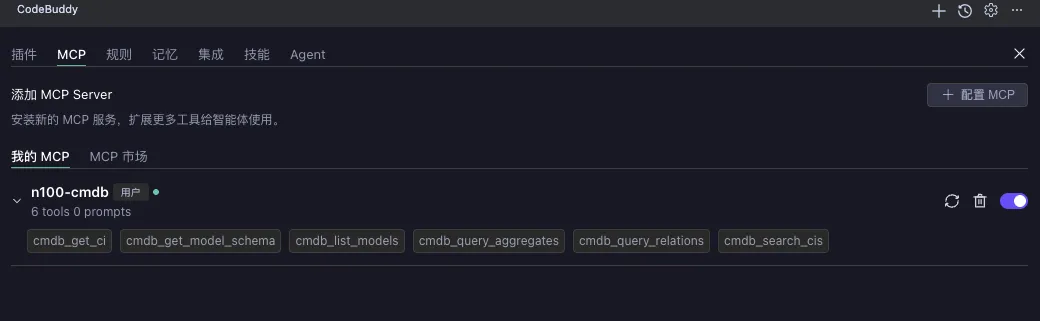
到这一步,Agent 已经可以调用 CMDB。接下来要规定的是:面对一个用户问题,它应该怎样选择工具、组织查询,并把结果说清楚。
例如,用户问:
“集群有几个节点”,Agent 可以调用 cmdb_query_aggregates 聚合统计工具,统计节点数量,汇总答案。
“分别是什么节点”,Agent 可以调用 cmdb_search_cis 配置项搜索工具,查询节点列表及相关属性。格式化输出。
“某个应用部署在哪里”,Agent 可以调用 cmdb_query_relations 关系查询工具,沿着“应用服务 → 部署实例 → K8s Node”的关系,找到应用实际运行的节点。画出部署路径。
开发CMDB 查询Skill
我根据上面的场景设计了 cmdb-query Skill。
Skill 负责把用户的问题组织成查询步骤。 它告诉 Agent 什么时候使用这些工具、调用顺序是什么、需要查到哪一层,以及回答时应该保留哪些信息。
以“orders-demo 包含哪些应用服务,分别部署在哪里”为例,查询流程可以整理为:
1. 读取应用系统、应用服务和部署实例的模型定义。 2. 找到 orders-demo对应的配置项。3. 查询它关联的全部应用服务。 4. 沿着每个服务找到部署实例,再查询对应的 Kubernetes Node。 5. 按“服务—部署实例—节点”的对应关系组织答案。
用户只需要提出问题,模型和字段发现、关系追踪等操作由 Agent 按照 Skill 执行。
Skill 中的一部分规则总结如下:
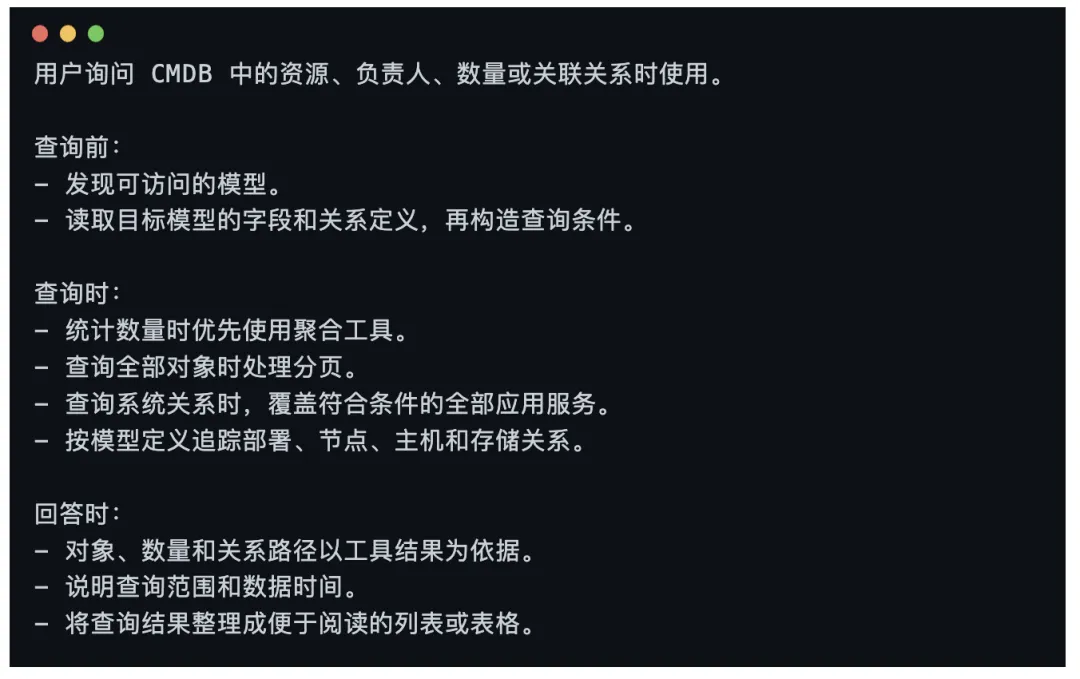
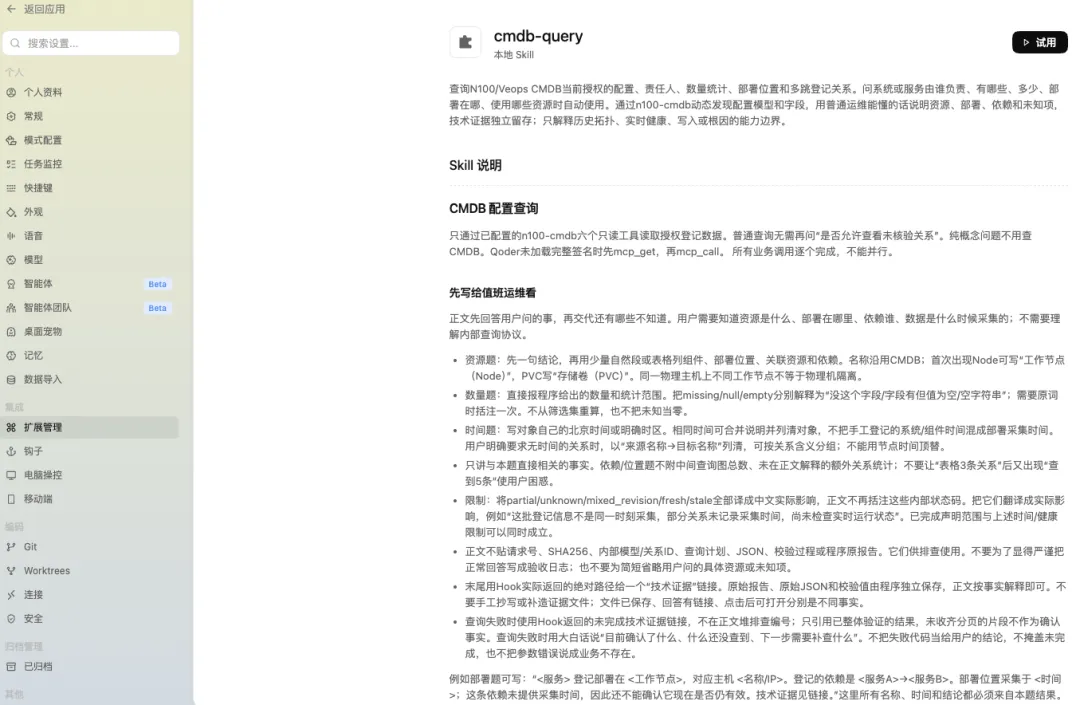
这里就能看出 MCP 和 Skill 的分工。
MCP 提供“查模型、查配置项、做统计、查关系”的工具;Skill 说明一个问题需要组合哪些工具,以及如何使用返回结果。比如“部署在哪里”可能要经过多次关系查询,Skill 把这套查询方法交给 Agent,MCP 完成每一步的数据读取。
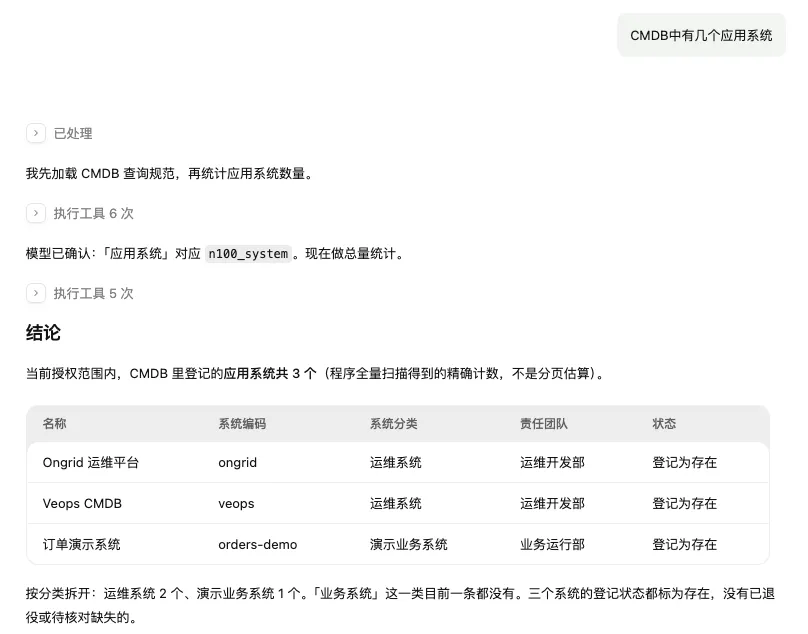
用真实环境验证查询结果
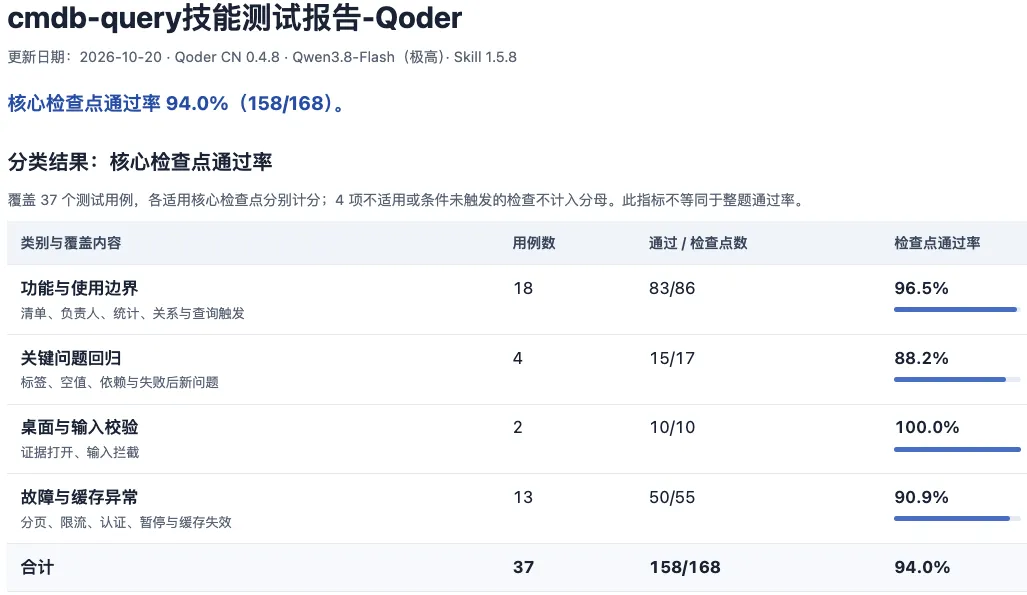
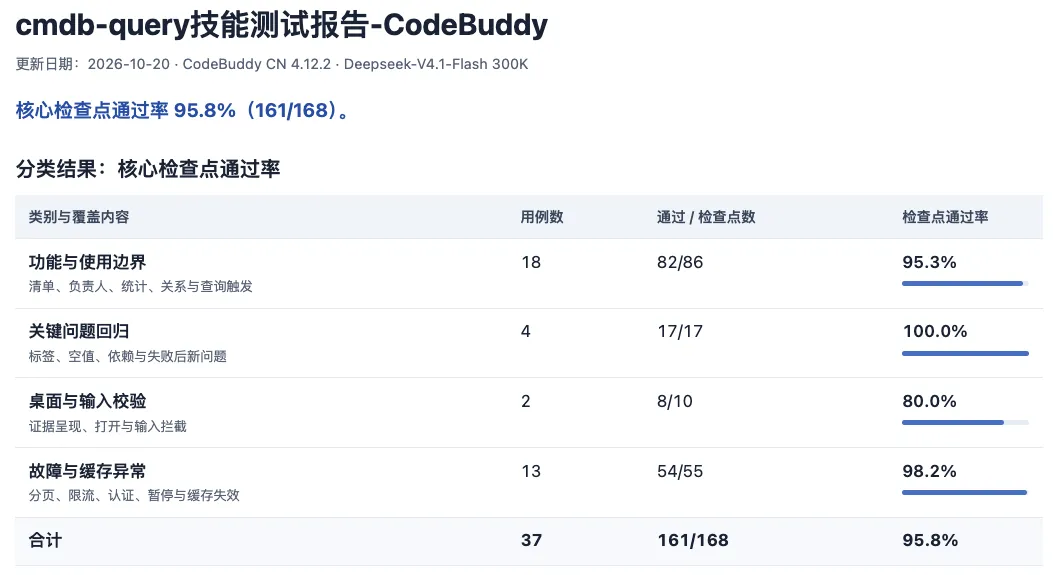
完成 MCP 和 Skill 开发后,我设计了一组自然语言测试问题,使用codex作为测试agent,控制 Qoder 和 CodeBuddy 执行端到端验证。
codex会根据查询结果,到CMDB比对原始数据,记录测试结果。
最终我会让codex出一份测试报告,给出测试通过率,针对失败项分析MCP和Skill的改进点。修改意见则可以作为下一轮OpenSpec变更的输入。
下一步计划:支撑告警影响范围分析
CMDB 查询接入后,我接下来想做的是把它用到告警处理中。
例如,agent收到某个 Kubernetes Node 的告警时,先通过 CMDB 找到节点对应的配置项,再查询它承载的部署实例、关联的应用服务和所属系统,整理出需要关注的业务及负责人。
设想的“影响分析Skill”流程如下:
告警信息 ↓识别 CMDB 中的节点 ↓查询关联的部署实例 ↓找到应用服务、所属系统和负责人 ↓结合运行状态分析影响现有 MCP 工具可以承担其中的配置和关系查询。后续再制作告警分析 Skill,规定如何识别告警对象、沿哪些关系查询,以及如何汇总影响范围。
再进一步就是根因分析了:运行状态(指标、日志、链路)或 工单(变更、演练)则也可以开发MCP Server,让agent接入。agent分析这些实时数据用来判断是什么原因导致的告警。
总结
从这次实践看,运维 Agent 已经有了落地的可能。
Agent 对现实环境的工具调用可按后果的可恢复程度分为三个层级:
1、只读/幂等调用(无状态变更,可安全重试),如查询数据库、读取文件、调用只读 GET 接口、检索日志/指标、列出目录等;
2、可逆/可补偿调用(状态可被精确撤销,或可通过补偿动作在业务语义上对冲),如配置变更后回滚、发布失败后回滚、临时扩容后缩容、流量切回原集群等;
3、不可逆调用(会永久改变真实环境,无法自动恢复,可能造成严重后果),如永久删除生产数据、直接修改生产数据库结构、不可撤销的权限/网络变更、对外发送通知、触发物理设备动作等。
Coding Agent 可以通过“编码—测试—优化”反复迭代,属于第一类和第二类,现在已经逐渐成熟落地了。
生产运维中可以从告警排查、根因分析、处置建议等第一类开始,主要是一些只读与分析场景。
AIOps 的落地顺序,取决于现实允许它怎样试错。