ARTICLE · 1217615
扫描版 PDF 复制不了文字?用 Umi-OCR 在电脑上批量提取
扫描版 PDF 复制不了文字?用 Umi-OCR 在电脑上批量提取收到几十页扫描资料,想复制几段文字,鼠标怎么拖都选不中。 对着屏幕一行行抄,费时间,还容易把姓名、金额和日期抄错。 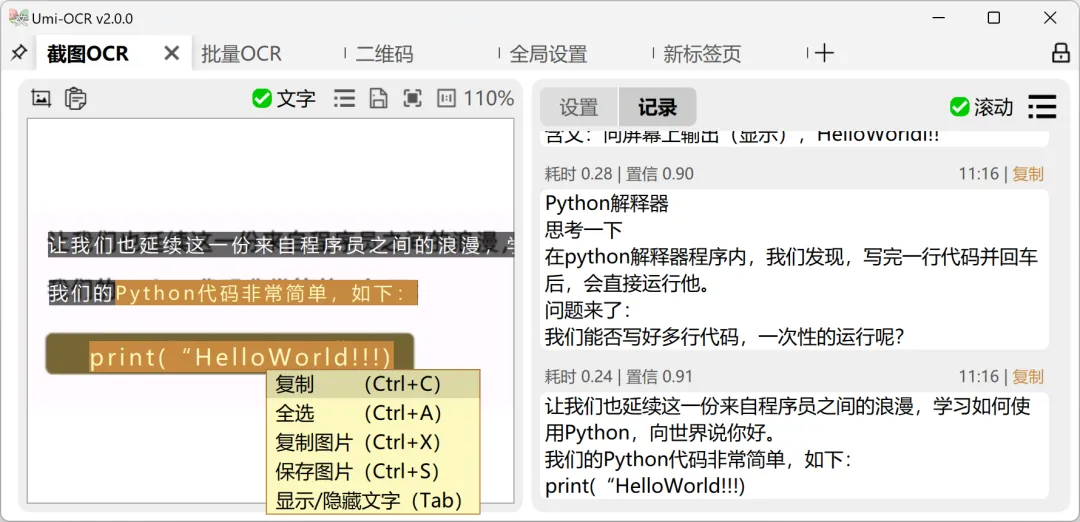
把图片里的字变成可以复制的文字 Umi-OCR 可以处理图片和扫描版 PDF,也支持一次导入多个文件。识别在电脑本地完成,不需要先把资料上传到在线网站。 基本信息 版本:v2.1.5 系统:Windows x64、Linux x64 macOS:暂无原生版本 价格:免费开源 安装:Windows 版据官方说明,下载后解压即可使用 识别结果可以保存为文字,也可以为扫描版 PDF 增加可搜索的文字层。 表格目前主要保存为 CSV;公式识别需要额外安装官方 Pix2Text 插件;手写和潦草字迹可能识别不准。 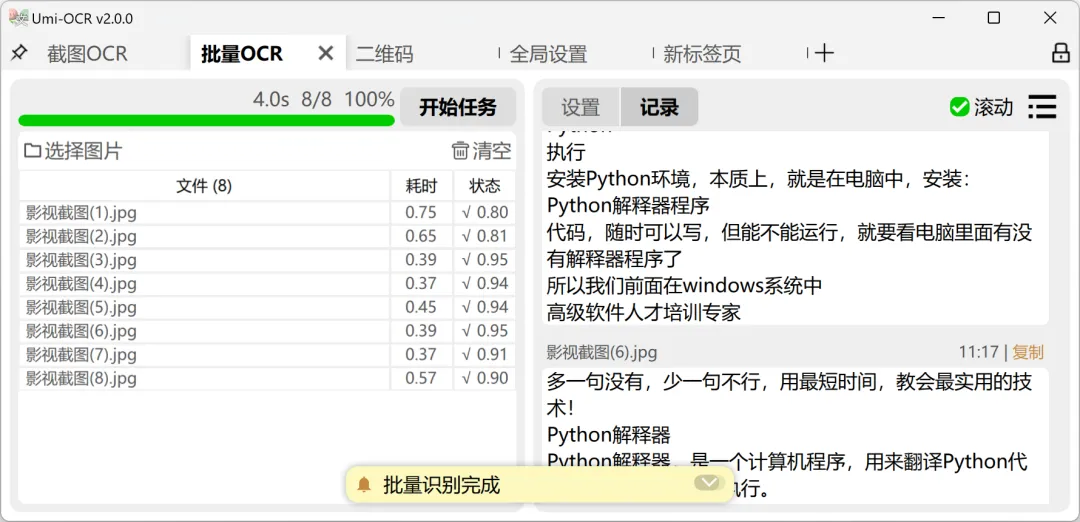
去哪里获取
需要下载或查看完整教程,点击文末「阅读原文」。
想看下一期是什么工具,可以留言告诉我。