ARTICLE · 1222995
你每天在 Excel 里判 R/S,其实就是在编程——只差把它写下来
Day 01 |《你每天在 Excel 里判 R/S,其实就是在编程——只差把它写下来》|AMR-AI-Lab 连载
编程不是换个职业,是把你每天都在做的判断,写成机器也能执行的规则。今天用一张药敏表,20 分钟跑通第一段 Python。
一、从你最熟的那张表说起
早上八点,LIS 系统里躺着一张表:6 株铜绿假单胞菌,三种抗生素,每个格子一个 MIC 值。
要做的事只有三件:看进来、判成 S / I / R(敏感 / 中介 / 耐药)、画一张图。
这件事做了几百遍。今天换个做法——用 Python 做一遍。
先立三条规矩:
脚本里所有 MIC 都是教学构造值,不是真实测定结果; 今天全程没有 AI——连载第一天先不谈 AI,地基不打牢,后面每一层都会塌; 文中每个数字,要么来自脚本实测,要么标注了来源和日期。
二、四个概念,先用生活例子讲透
1. 变量:一张可以撕下来重贴的标签
mic = 0.5,不是把 0.5 装进一个叫 mic 的盒子,而是把一张写着 "mic" 的标签,贴到 0.5 这个值上。
▼ 示例·可复制
mic = 0.5 # 现在是数字 mic = "0.5" # 下一秒换成文字,也没人拦你好处是随手就改;代价是——贴错了没人当场提醒,直到拿它做运算(比如拿 "0.5" 去比大小)那一刻才报错。
🧪 检验人视角:同一列 Excel 混进 0.5 和 "0.5",肉眼看差不多,要计算时才出事。
2. dict(字典):一本通讯录
给一堆值起名字,按名字取——就像通讯录,名字是键,电话是值:
{"meropenem": 0.5} # Python 的 dict先记住一个坑:Python 的 dict 不能用点号取值,必须写 d["meropenem"],写 d.meropenem 直接报错。
3. f-string:外卖订单的备注栏
外卖下单时在备注栏写"辣度__、不要香菜[]"——那两个空是留给你的。f-string 干的是同一件事:
▼ 示例·三行一起复制
name = "Pa-01" # 先随手赋个值,不然下面那行会报 NameError mic = 0.5 f"菌株 {name} 的美罗培南 MIC 是 {mic}"前面那个 f,作用是"把变量塞进这句话里"。想自己试,三行一起复制——只抄最后一行会报 name 没定义。
4. 列表推导式:全班成绩一次筛完
把全班 90 分以上的分数抄成新名单(名单上只有分数、没有名字),传统写法"翻名册 → 挨个看 → 抄下来"三步;列表推导式一行干完筛选 + 收集:
▼ 示例·可复制
mics = [0.5, 1, 4, 8, 16] # 先准备一组 MIC,不然下面会报 mics 没定义 high = [m for m in mics if m > 2] # 把 >2 的全挑出来Python 不是一套新思维——它是把你已经会的东西,换了一套更少的标点符号。
三、动手:6 株铜绿,20 分钟,一张图
第零步:先把环境装好(别跳过)
pip install numpy==1.26.4 pandas==2.2.2 matplotlib==3.8.4没装 pandas 就抄 import pandas as pd,会直接报 ModuleNotFoundError——新手流失,十有八九卡在这儿。版本号与项目 requirements 完全一致;完整环境(conda、Jupyter、国内镜像源)见项目 ENVIRONMENT 文档。
第一步:把表搬进内存
(本章代码均摘自脚本 day01_first_python.py,逐字一致)
▼ 可复制
from pathlib import Path # 标准库:跨平台路径,≈ 电脑里的资源管理器,不用手拼 '/' 或 '\' import pandas as pd # 表格库:DataFrame ≈ 内存里可编程的 Excel import matplotlib.pyplot as plt # 绘图库:Figure ≈ 一块画布,Axes ≈ 画布上的一张图 OUTPUT_DIR = Path(__file__).resolve().parent.parent / "outputs" # 相对脚本自身定位:在哪个目录跑都能找到 outputs/ OUTPUT_DIR.mkdir(parents=True, exist_ok=True) # 目录不存在就建,≈ mkdir -p,目录已存在也不报错 # 教学构造数据(非真实测定值):6 株铜绿假单胞菌 × 3 种药物,MIC 单位 ug/mL(= mg/L) strains = [ # 列表 ≈ 一串排好序的值;每个元素是一个键值对 {"strain": "Pa-01", "meropenem": 0.5, "ciprofloxacin": 0.25, "tobramycin": 1 }, {"strain": "Pa-02", "meropenem": 1, "ciprofloxacin": 0.5, "tobramycin": 2 }, {"strain": "Pa-03", "meropenem": 4, "ciprofloxacin": 1, "tobramycin": 4 }, {"strain": "Pa-04", "meropenem": 8, "ciprofloxacin": 2, "tobramycin": 8 }, {"strain": "Pa-05", "meropenem": 16, "ciprofloxacin": 4, "tobramycin": 16}, {"strain": "Pa-06", "meropenem": 2, "ciprofloxacin": 0.125, "tobramycin": 2 }, ]pandas(读"胖达斯")是 Python 里处理表格的库,DataFrame ≈ 内存里一张可以被代码操控的 Excel。对应关系:一个 DataFrame = 一张 sheet;一列 = 竖着的一列,能整列一起运算;索引 = 每一行的名字。
光有列表还不算"表",这两行把它拼成 DataFrame 并打印:
df = pd.DataFrame(strains).set_index("strain") # 菌株编号当索引,≈ Excel 里把首列设为行标题 print("=== MIC (ug/mL) ===\n", df)索引被设成了 "Pa-01" 这种菌株编号——不一定是 1、2、3。
0.125 不是随手写的。MIC 是倍比稀释序列——0.125 / 0.25 / 0.5 / 1 / 2 / 4 / 8 / 16,每次翻一倍。写成 0.12,做药敏的人一眼就知道没做过。
🧪 检验人视角:strains 就是你在 LIS 里导出时最常见的 JSON 数组——列表里套字典。
第二步:把折点变成规则
⚠️ 关于折点(请读一遍)
下文数值取自 CLSI M100-Ed34(2024),仅作教学演示:美罗培南 S≤2 / I=4 / R≥8;环丙沙星 S≤0.5 / I=1 / R≥2;妥布霉素 S≤1 / I=2 / R≥4。
⏰ M100 每年更新,用时请再查最新版。真实案例:妥布霉素对铜绿假单胞菌的折点,自 M100-Ed33(2023)起从旧的 S≤4 / R≥16 下调为 S≤1 / R≥4(变更由 CLSI 官方 AST Newsletter 2023 公布)。还在用老折点,同一株菌可能从 S 判成 R。
EUCAST 是另一套体系,数值与 CLSI 不同,两者不可混用——认准一套用到底。
先写折点和判读函数:
# CLSI M100 折点(铜绿假单胞菌,MIC ug/mL):(S 上限, I 上限),超过 I 上限即 R # ⏰ 用时再查最新版 CLSI M100 / EUCAST —— 折点每年更新,妥布霉素已于 M100-Ed33(2023) 下调 BREAKPOINTS = {"meropenem": (2, 4), "ciprofloxacin": (0.5, 1), "tobramycin": (1, 2)} def interpret(mic, s_max, i_max): # 函数:把"心里有数"变成"代码里写死" if mic <= s_max: return "S" if mic <= i_max: return "I" return "R"interpret 很好懂:≤ S 上限判 S,≤ I 上限判 I,再超就是 R。然后一行判完全部三种药:
calls = {d: [interpret(v, *BREAKPOINTS[d]) for v in df[d]] for d in df.columns} # 字典推导式:一次判完全部三种药 print("\n=== S/I/R 判读 ===\n", pd.DataFrame(calls, index=df.index))这行读作:外层数"哪种药",内层数"这列里每个 MIC",逐个套进 interpret,收成一张新表。
跑完,终端吐出这张表——脚本实测输出:
=== S/I/R 判读 === meropenem ciprofloxacin tobramycin strain Pa-01 S S S Pa-02 S S I Pa-03 I I R Pa-04 R R R Pa-05 R R R Pa-06 S S I盯住 Pa-02 和 Pa-06 的妥布霉素:MIC 都是 2,判成 I(中介)——不是 S 也不是 R:S 上限是 1,2 超过了它;I 上限是 2,2 刚好卡在里面。
这个"I"是最容易被忽略、临床上最头疼的一格。所以画图时 I 必须是独立的第三种颜色——表里写 I、图上标红,同行一秒看穿。
💡 今天的核心思想:把你脑子里的判断,变成代码里写死的规则。逻辑一个字没变,只是第一次被装进了一个能复用、能核对、能交给别人的地方。
第三步:画出来
▼ 可复制
# 只画美罗培南:三种药折点不同(MEM 2/4 vs CIP 0.5/1 vs TOB 1/2),混在一根轴上画折线会误导读者 s_max, i_max = BREAKPOINTS["meropenem"] # 拆包赋值 ≈ 一次取两个返回值 COLORS = {"S": "#1f77b4", "I": "#f39c12", "R": "#d62728"} # 蓝=敏感 橙=中介 红=耐药 colors = [COLORS[c] for c in calls["meropenem"]] # 列表推导式 ≈ 一次完成筛选 + 收集 plt.figure(figsize=(8, 4.5)) # 画布尺寸(英寸) plt.bar(df.index, df["meropenem"], color=colors) # 柱子:x=菌株 y=MIC,按判读结果上色 plt.axhline(s_max, ls="--", c="gray", lw=1) # 灰虚线 = S 上限 plt.axhline(i_max * 2, ls="--", c="black", lw=1) # 黑虚线 = R 下限(本文三种药均为 I 上限的下一个稀释档) plt.text(0.02, s_max * 1.15, "S <= 2", fontsize=8) plt.text(0.02, i_max * 2 * 1.15, "R >= 8", fontsize=8) plt.yscale("log") # 对数轴:MIC 是倍比稀释,线性轴会把低值压成零 plt.ylabel("MIC (ug/mL, log scale)") # 图上用英文 + ASCII 单位:中文字形缺失会变方块 plt.title("P. aeruginosa: meropenem MIC (blue=S, amber=I, red=R)") plt.tight_layout() # 自动收紧边距,省得标签被裁掉 out_png = OUTPUT_DIR / "day01_mic_bar.png" plt.savefig(out_png, dpi=200) # dpi=200 → 1600x900,公众号正文够用且加载快跑完看到六根柱子,三色:蓝 S、橙 I、红 R。两条虚线分清:灰虚线 = S 上限 2,黑虚线 = R 下限 8,中间那段就是 I。图表必须跟着判读走,不能另立标准。
两个细节:
- 为什么用对数轴
:MIC 是倍比稀释,线性轴会把 0.5 和 1 压得几乎一样高; - 为什么图上写英文
:matplotlib 默认不带中文字体,硬写中文会变一排"□□□",解法在项目 ENVIRONMENT 文档。
(单位:本文统一 µg/mL,CLSI 惯用;EUCAST 惯用 mg/L,1 mg/L = 1 µg/mL,数值一样、写法不同。)
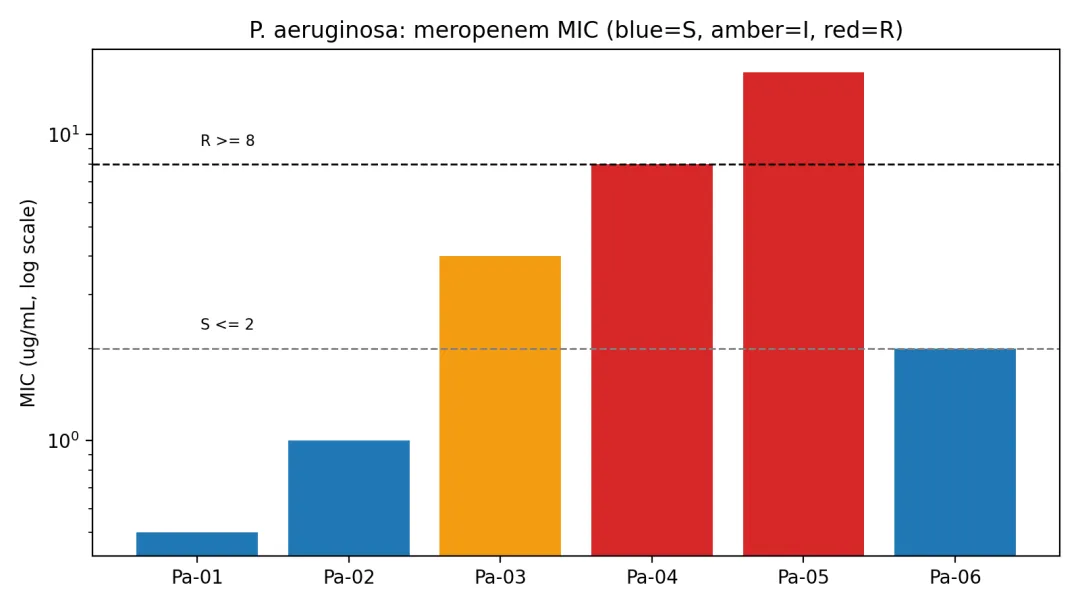
6 株铜绿假单胞菌的美罗培南 MIC(教学构造值)虚线为美罗培南折点(S≤2 / R≥8),环丙沙星与妥布霉素折点不同、未画出;蓝=S 橙=I 红=R;单位 µg/mL
四、这个类比在哪里不成立(诚实框)
"DataFrame ≈ Excel"前面 80% 的情况好用,但这三处它会突然不像:
- 合并单元格
:Excel 里一格跨三行很常见,读进 DataFrame 只有第一行有值,其余全空; - 一列最好同一种类型
:混进"未做"两个字,整列会变成文字,后面算不动; - 没有 Ctrl+Z
:代码里很多操作执行即生效,改错了只能重跑。
还有一句实话:"规则写下来"不等于"数据干净"。从 LIS 导出 600 行,代码基本不用改,但你多半得先花十分钟收拾表头——"株号"还是"strain"?有没有合并单元格?混没混"未做"?脏活干完,规则才能跑。后面专门拿一天讲。
五、今天学到了什么
一句话:判 R/S 的规则一旦写进代码,6 株和 6 万株跑的是同一条规则。
为什么先练这三板斧——读进来 → 算 → 画出来?因为几乎所有 AI 都长在这副骨架上:特征工程、模型评估,还是"把一段序列变成一串数字"——这事儿第 11 天才展开——都逃不出这三步。也提前说清:往后每多一个新概念,中间那步"算"更复杂、也更挑数据,你要盯的反而变多——更复杂的算法,可能在你没看见的地方把答案背下来,而不是真的学会了判断。
六、明日预告 + 今日术语卡
明日预告(Day 02):《AI 只看两样东西:你手里的证据,和你要的那个答案》。
术语卡
今日自检
把菌株从 6 株加到 10 株,看判读表和图自己跟着变; 把第三步里画的药换成头孢他啶——得动三处:① 给数据表补一列 CAZ 的 MIC;② 给 BREAKPOINTS补一条它的折点;③ 把画图那几行的药名换掉。折点自己去最新版 CLSI M100 查,别抄本文的,也别凭记忆里的老值;跑一遍 python code/day01_first_python.py,看outputs/下是不是多出day01_mic_bar.png。
有这个文件,才说明今天是真跑通了——而不只是看懂了。看懂和跑通之间,差着一整个数量级。
做不到也没关系——卡在哪一步,评论区留言,那正是明天要讲的地方。
今日打卡:把你跑出来的第一张图截图发评论区。评论区的问题,周三会统一挑几个来答。
(本文 MIC 数值为教学构造值,非真实测定结果;折点取自 CLSI M100-Ed34(2024)仅作教学演示——⏰ M100 每年更新,EUCAST 为另一套体系、两者不可混用,用时请再查最新版。)
— 完 · 明天见 —