ARTICLE · 1227135
AI编程工具终于能共享记忆了!Beacon让Claude、Codex、Cursor不再各自为战
从软件开发过程中,AI 编程工具有一个很现实的问题:每个 Agent 都在独立工作,历史经验很难复用。
你在 Cursor 里纠正过的代码问题,Claude Code 不一定知道;你在 Codex 里积累的开发 Skill,也不会自动同步到其他工具。
换一个 Agent,可能又得重新解释项目架构、开发规范、启动命令和踩过的坑。
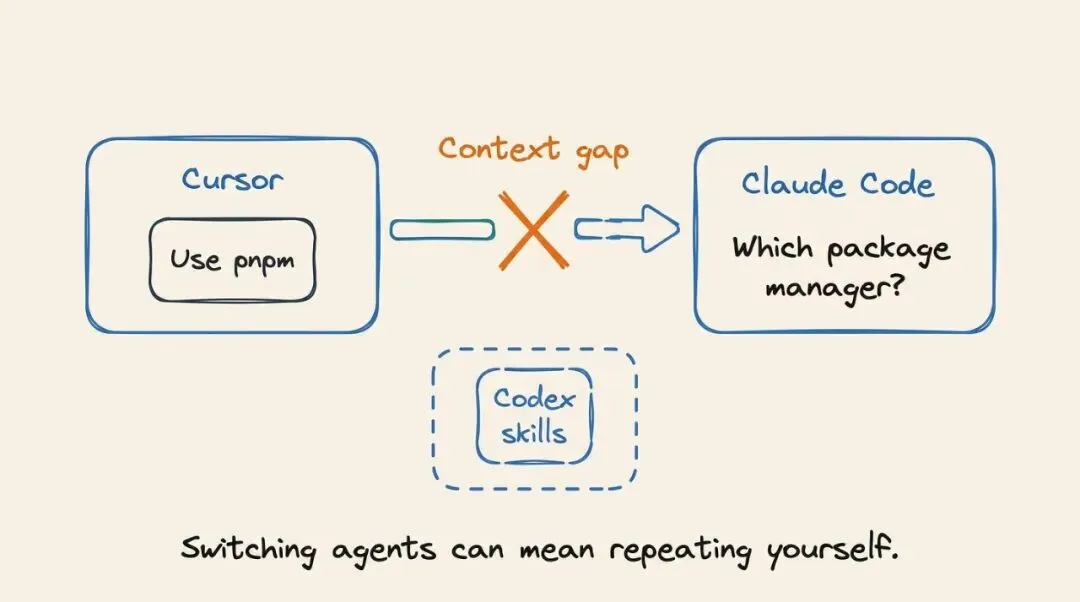
Asymptote Labs 开源的 Beacon,就是想解决这个问题。它相当于给 Claude Code、Codex、Cursor 等 AI 编程工具增加一个共享的记忆层,让不同 Agent 能够读取过去的开发记录、复用工作经验,并逐步沉淀成可重复使用的技能。
项目地址:GitHub - Asymptote-Labs/agent-beacon
一、Beacon 的核心思路:给 AI 编程工具建立统一记忆
Beacon 并不是另一个代码生成模型,而是一个连接不同 Coding Agent 的基础设施组件。
它试图把过去分散在各个工具中的开发过程,统一收集、整理和检索。
从架构上看,可以理解为:
Claude Code ─┐Cursor ─┤Codex ─┤其他 Agent ─┘↓Beacon 记忆层↓开发记录 / 历史上下文 / Skills↓新的 Coding Agent
这样一来,开发者不必每次切换工具都从零开始交代背景。
二、从工程实现看,Beacon 有哪些值得关注的能力?
1. 统一采集 20+ 种 Coding Agent 的开发活动
Beacon 通过 OpenTelemetry、Agent Hooks 和本地 Session 文件等方式,采集不同编程工具的运行记录。
不同 Agent 的数据格式不一样,Beacon 会尝试将它们转换成统一的结构。
工程价值: 如果你同时使用 Claude Code、Cursor 和 Codex,就有机会在一个统一的记忆系统中检索开发过程,而不必分别翻查每个工具的历史会话。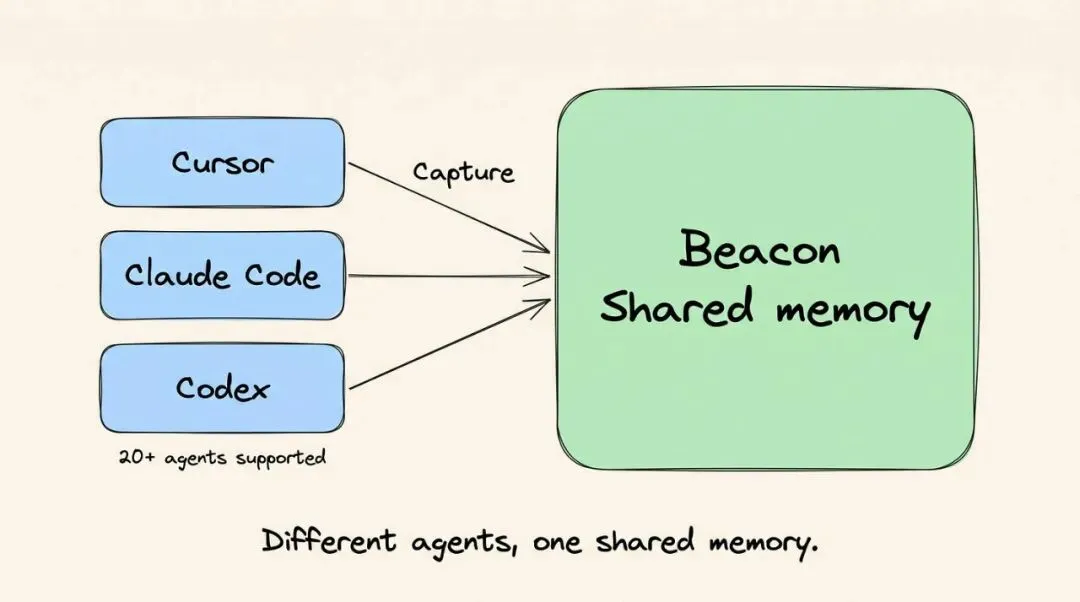
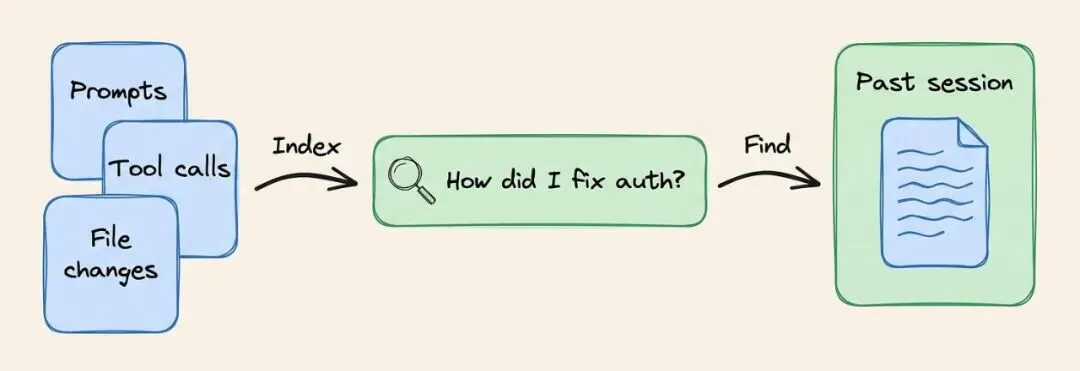
2. 把 Coding Agent 的历史操作变成可检索数据
传统的 AI 编程会话结束后,很多上下文就散落在聊天记录中。
Beacon 希望将 Prompt、工具调用、命令执行、文件变更和 Agent 响应等信息,整理为结构化的开发轨迹。
这样做的意义是:
回溯某个功能是怎么实现的。 查找之前解决过的相似问题。 让新会话能够快速获取相关上下文。 减少重复解释项目背景的工作。
不过,记录历史操作不等于自动理解所有项目逻辑。实际效果仍取决于采集范围、数据质量和检索机制。
3. 跨 Agent 接续任务,减少上下文丢失
这是我认为 Beacon 比较实用的一个场景。
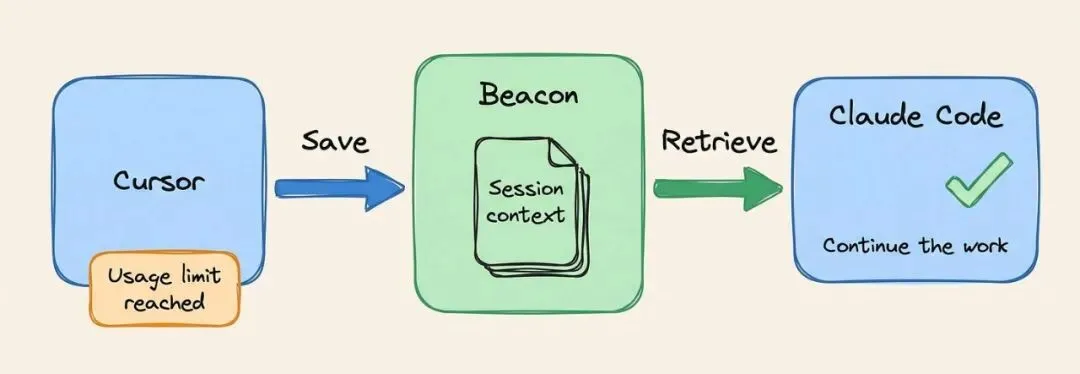
假设你在 Cursor 中开发一个前端功能,已经完成组件设计和部分代码,但遇到了使用限制,需要切换到 Claude Code。
传统方式是:重新打开项目、解释当前进度、说明改动位置,再让新 Agent 接手。
Beacon 的思路是检索上一段开发记录,将相关上下文交给新的 Agent。
例如:
继续上一个 Cursor 会话中的前端开发任务。先读取之前的实现记录、当前改动和遗留问题,再继续完成剩余工作。
需要注意,Beacon 提供的是上下文检索和衔接能力,并不意味着不同 Agent 能够无条件、无错误地恢复所有运行状态。
4. 从重复开发流程中提取 Skill
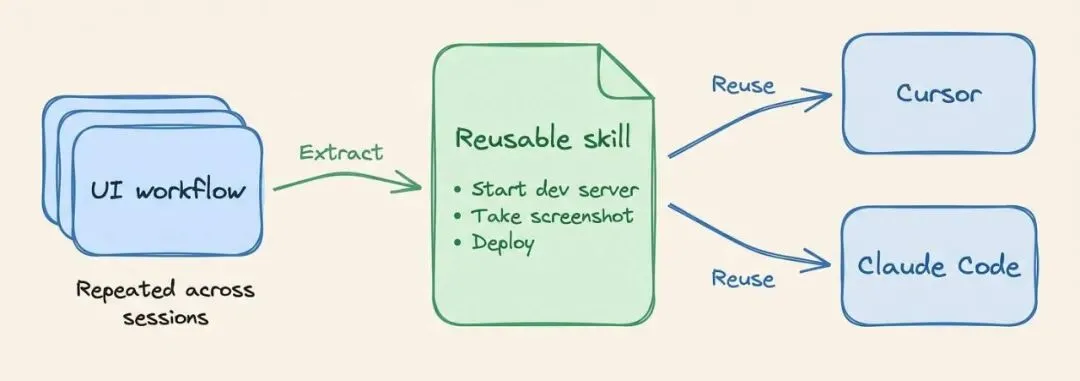
Beacon 还尝试将开发过程中的重复操作沉淀为可复用的技能。
例如,一个前端开发流程反复包含:
启动开发服务器。 修改页面组件。 截取页面截图。 检查布局和样式。 执行部署命令。
如果这些步骤在历史会话中反复出现,Beacon 可以尝试识别并生成对应的 Skill。
这意味着,开发者可以先通过 Agent 完成任务,再逐步把稳定的操作流程固化下来,让后续 Agent 复用。
但从工程实践看,自动生成的 Skill 仍然需要人工审查。尤其是涉及生产部署、数据库修改和权限操作的步骤,不应该未经验证就直接复用。
5. 分析 Skill 的真实使用情况
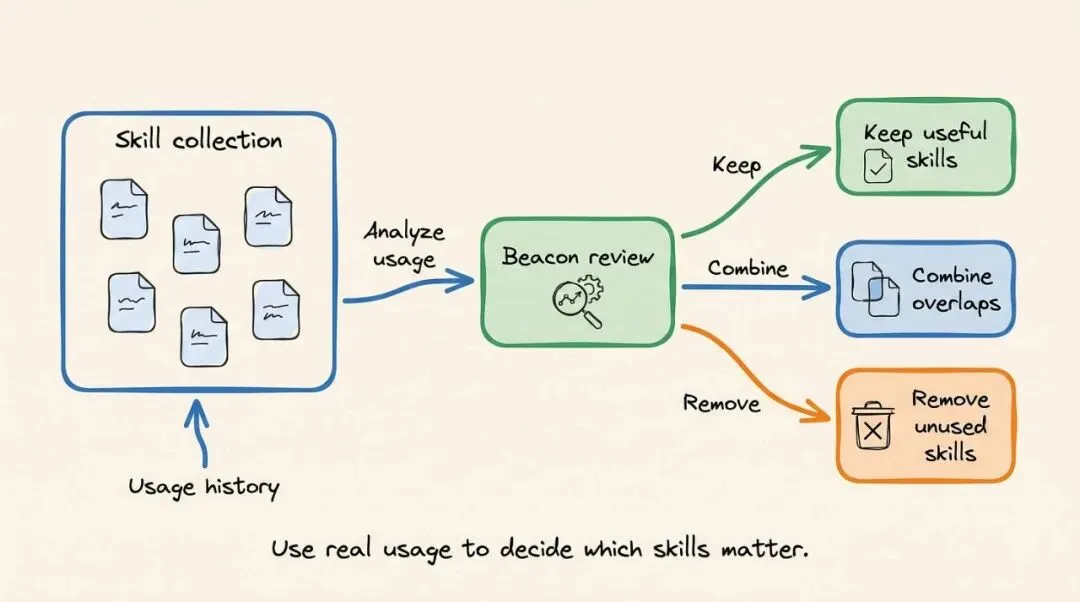
很多开发者会不断积累 Skill,最后形成几十甚至上百个文件。
问题在于:Skill 数量增加,并不代表 Agent 能力一定提升。
Beacon 提供的思路是分析历史使用记录,识别哪些 Skill 经常被调用、哪些很少使用,以及哪些内容存在重复。
这样可以帮助开发者整理技能库,合并重复流程,减少不必要的上下文负担。
6. 跨 Agent 的安全规则与风险检测
从安全工程角度看,Beacon 还有一个值得关注的方向:统一审计不同 Coding Agent 的操作行为。
例如,开发过程中可能出现这样的风险链路:
Agent 读取敏感凭证↓获取数据库密码↓向外部模型或网络发送请求↓敏感信息可能泄露
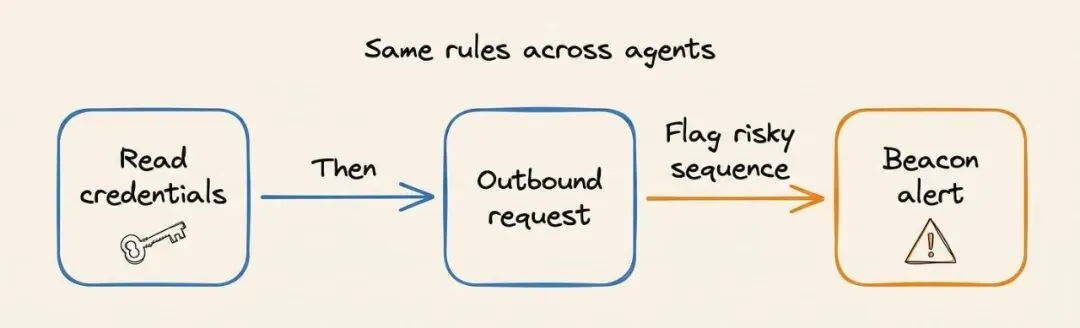 Beacon 宣称提供多种检测规则,用于识别潜在的风险行为。
AI 编程工具的安全问题不仅是代码漏洞,还包括凭证暴露、工具权限和数据外传风险。
需要强调: 检测规则只能帮助发现问题,并不能替代凭证管理、最小权限、网络隔离和安全审计。
三、如何部署?适合什么样的开发团队?
Beacon 是开源项目,文章介绍了两种使用方式:
本地部署: 将开发记录和记忆保存在自己的机器上,更适合关注数据隐私、希望自主控制开发环境的工程师。 云端服务: 使用 Beacon Cloud,减少自行维护记忆服务的工作量。具体的数据存储和隐私策略,需要以服务当前文档为准。
对于开发者来说,可以先在个人项目中测试,观察它是否真的改善了跨 Agent 协作效率,再考虑团队级使用。
四、工程师怎么看 Beacon?
我认为 Beacon 的价值不只是“让 AI 记住更多东西”,而是尝试建立一套跨工具的开发经验管理机制。
过去我们写代码,会把技术方案、架构决策、部署流程和故障排查记录到文档里。
现在 Coding Agent 也开始产生大量开发轨迹,如果能够把这些轨迹转化为结构化、可检索、可复用的知识,确实有机会减少重复劳动。
但也有几个问题值得继续观察:
历史记录过多后,检索准确率是否会下降? 自动生成的 Skill 是否可靠,能否避免错误经验被反复复用? 本地记忆如何处理密钥、用户数据和生产环境信息? 跨 Agent 共享上下文时,能否正确识别项目版本和当前代码状态?
总结:Beacon 不是要取代 Claude Code、Codex 或 Cursor,而是尝试让这些工具不再各自为战。
对于每天使用多个 AI 编程工具的工程师,它值得研究的核心是:如何采集开发过程、管理 Agent 记忆、提取可复用技能,以及建立跨工具的安全审计机制。
项目地址:Asymptote-Labs/agent-beacon