一、 全局鸟瞰: AI 算力底座的“八大模块”全景地图
当超大规模云厂商宣布投入百亿美元建设新一代 AI 数据中心时,这笔资本开支( CapEx )并非只流向 GPU 一家,而是沿着物理制造与机房交付链条,分配到了八个环环相扣的产业模块中:
| | | |
|---|
| 模块 1 :上游半导体母机与制造封装 | EDA 设计软件与 IP 、晶圆代工、 CoWoS 先进封装、光刻/刻蚀/薄膜沉积/量测/测试设备 | TSM 、 ASML 、 AMAT 、 LRCX 、 KLAC 、 SNPS 、 CDNS 、 ARM 、 TER | 全产业链物理源头: 2nm 制程演进与 HBM 多层堆叠拉动设备检测强度;台积电 CoWoS 产能直接决定全行业出货上限 |
| 模块 2 :计算芯片层(算力心脏) | 通用 GPU 、定制化 ASIC ( XPU )、服务器调度 CPU | | 占机房硬件投入约 45%–55%:正经历从“训练端通用 GPU 占据主导”向“推理端云厂定制 ASIC 分流”的价值迁徙 |
| 模块 3 :存储与显存层(破内存墙) | HBM 高带宽内存、大容量企业级固态硬盘( eSSD )、全闪存系统、近线机械硬盘( HDD ) | MU (美光); WDC 、 STX (机械硬盘); PSTG (全闪存系统);及韩股 SK 海力士、三星 | 占机房硬件投入约 12%–18%:攻克大模型推理“显存带宽受限”瓶颈,承载海量训练语料与 RAG 热数据吞吐 |
| 模块 4 :高速网络与光铜互连(破通信墙) | 800G/1.6T 光模块与光芯片、硅光与 CPO 、 AI 以太网交换机与交换芯片、机柜内有源铜缆( AEC/DAC )、板级 Retimer 芯片 | COHR 、 LITE 、 FN (光通信); ANET 、 AVGO 、 CSCO (交换机); CRDO 、 ALAB 、 APH (铜缆与连接芯片) | 占机房硬件投入约 10%–15%:集群突破万卡后通信延迟成为头号瓶颈,机柜内铜连接与跨机柜光通信同步爆发 |
| 模块 5 :供电芯片、 PCB 与整机集成 | 芯片级垂直供电( PMIC )、高频超低损耗覆铜板/PCB 、 AI 服务器整机 ODM/OEM | MPWR 、 VICR (电源芯片); DELL 、 SMCI 、 HPE (服务器整机) | 整机集成与板级支撑:单颗芯片电流破千安培倒逼垂直供电芯片升级;液冷整机柜推动组装复杂度跃升 |
| 模块 6 :机房温控与液冷散热(破功耗墙) | 液冷冷板( Cold Plate )、快接头( UQD )、歧管、冷量分配单元( CDU )、室外冷水机组 | VRT (维谛)、 MOD 、 NVT 、 JCI 、 TT | 占机房基建投入约 8%–12%:单机柜功率突破 100kW 后,传统风冷越来越难满足高密度机柜需求,全液冷从可选变为强制标配 |
| 模块 7 :电力基建、输配电与表后能源 | 机房 UPS/高压直流配电、高压电网变压器、燃气轮机、固体氧化物燃料电池、核电独立发电商( IPP ) | ETN (伊顿)、 GEV (燃气轮机/电网)、 BE (燃料电池)、 CEG 、 VST 、 TLN (核电) | 占机房基建投入约 15%–20%:解决北美电网老化、并网排队 3–5 年与高压变压器短缺的终极物理交付卡点 |
| 模块 8 :下游算力买方与机房地产 | 四大超大规模云厂商( CSP )、新兴算力租赁商( NeoCloud )、数据中心地产( REITs ) | MSFT 、 GOOGL 、 AMZN 、 META 、 ORCL ; CRWV 、 NBIS ; EQIX 、 DLR | 资金总水源与物理收租方:云大厂用经营现金流买单; NeoCloud 靠抵押融资扩产; REITs 垄断核心都市圈带电机架 |
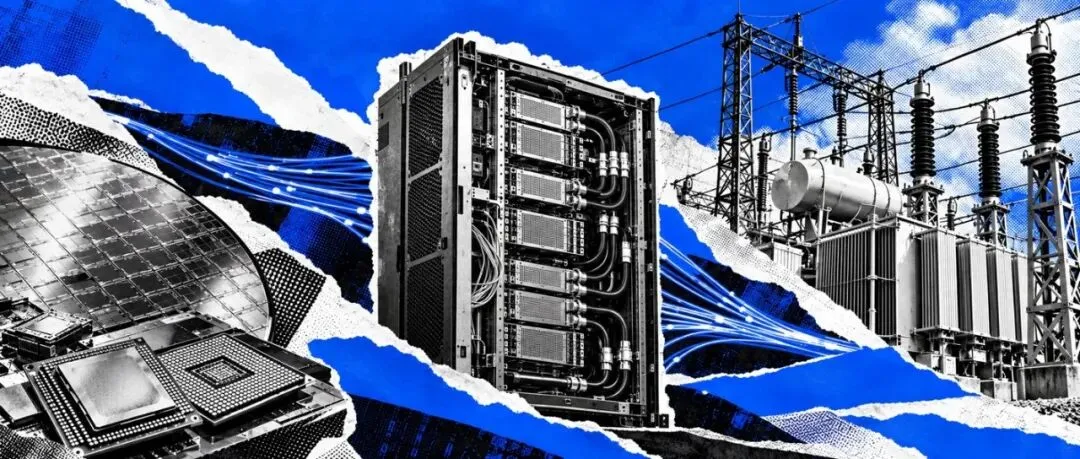
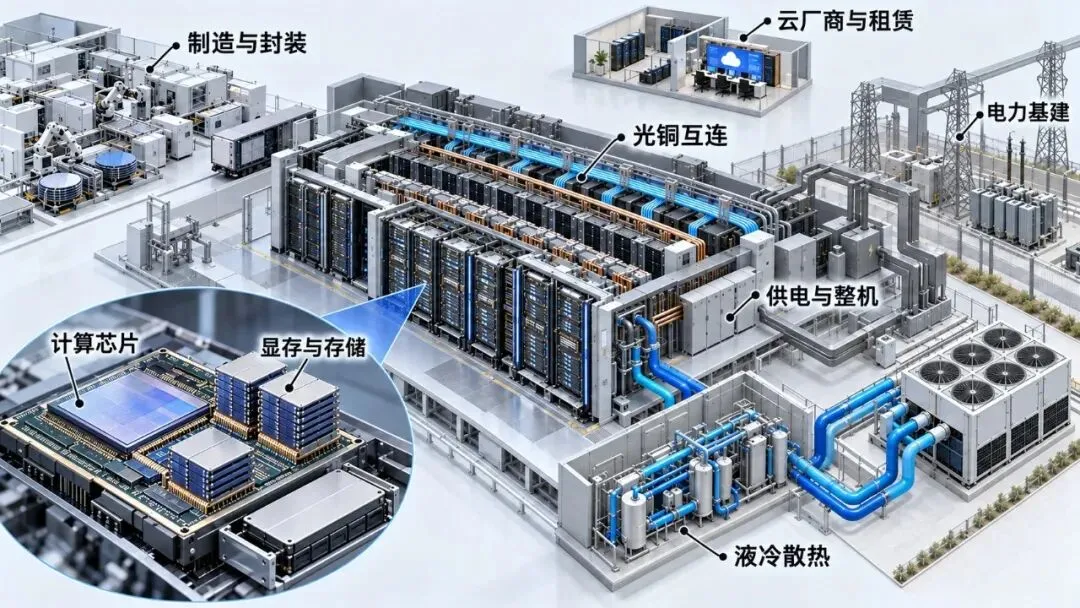 图 1 : AI 算力基础设施八模块示意。
二、 模块 1 & 模块 2 :从半导体母机、台积电封装到计算芯片的代际博弈
模块 1 :上游半导体母机与制造封装——算力大厦的“收税人”与“单点锁喉”
在讨论哪家芯片公司能赢之前,产业链最上游站着两类“不管谁赢都必须交过路费”的垄断者,以及一个关乎全行业生死的制造瓶颈:
1.EDA 设计软件与底层架构 IP ( SNPS 、 CDNS 、 ARM ): EDA (电子设计自动化)被称为芯片行业的“工业母机”。在 AI 时代,不仅英伟达和 AMD 以每年一代的速度迭代 GPU ,微软、谷歌、 Meta 、亚马逊也在全面自研定制芯片。设计芯片的团队越多、制程越先进,向 Synopsys 和 Cadence 采购全流程设计软件与验证工具的订阅费用就越高。2.晶圆制造设备、量测与测试机( ASML 、 AMAT 、 LRCX 、 KLAC 、 TER ): AI 芯片在物理制造端正面临双重极限挑战: * 逻辑制程向 2nm GAA 与背面供电演进:当晶体管微缩进入 2nm 阶段,传统的 FinFET 结构被全环绕栅极( GAA )取代,并引入背面供电( Backside Power Delivery )技术,这使刻蚀与原子层沉积( AMAT 、 LRCX )的工艺步骤大幅增加。 * 良率量测与后端测试强度翻倍:一颗顶级 AI 芯片由逻辑核心与多颗 12 层/16 层堆叠的 HBM 显存封装而成,任何微米级的颗粒缺陷都会导致整颗昂贵的芯片报废。因此,晶圆过程控制与缺陷检测龙头( KLAC )以及高复杂度芯片测试机龙头(泰瑞达 TER 、爱德万测试)的设备需求弹性甚至高于普通晶圆厂扩产。3.台积电( TSM )的“硅盾”单点风险与 CoWoS 产能天花板: 穿透美股数十万亿美元市值的科技巨头看制造端,全球几乎 100% 的顶尖 AI 算力芯片(无论是 GPU 还是定制 ASIC ),其先进制程晶圆代工( 3nm/2nm )与 CoWoS 先进封装全部集中在台积电一家手中。 * 全行业出货量的真实上限:很多时候 AI 服务器交不出货,不是芯片设计不出来,而是将 GPU 与 HBM 拼接到硅中介层上的 CoWoS 先进封装产能不足。跟踪台积电每年的 CoWoS 扩产节奏,就是跟踪全行业 AI 硬件的出货天花板。 * 极强的向下游提价权与地缘尾部风险:由于没有任何实质性替代者,台积电能够顺畅地将海外建厂的高成本转嫁给芯片设计巨头;但与此同时,这种极度的地理集中度也意味着任何地缘摩擦升级都会成为整个美股 AI 板块的系统性尾部风险。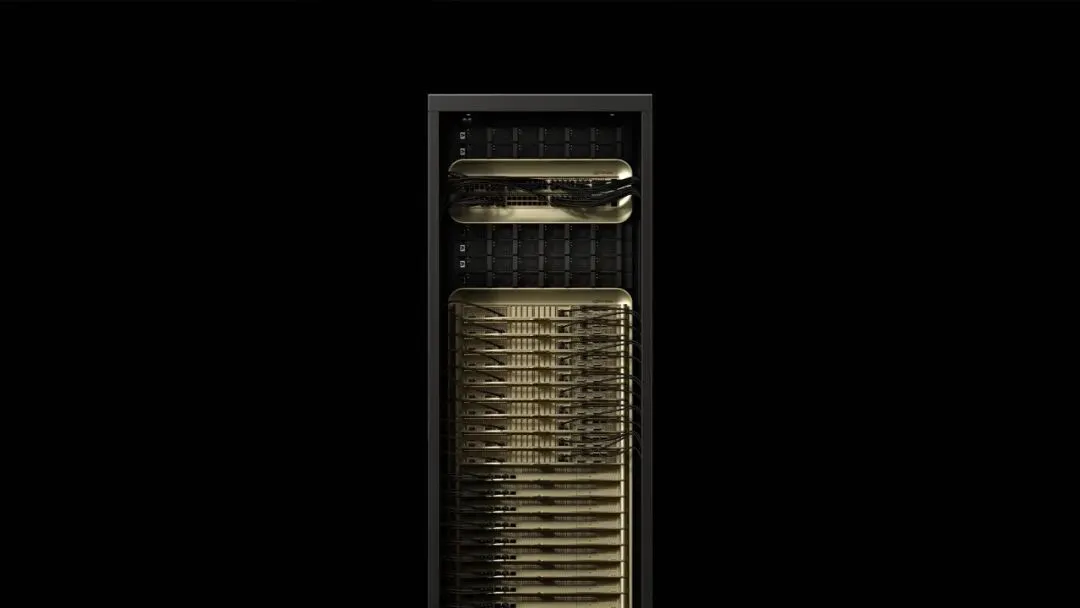 图 2 : Blackwell Ultra 机架产品。来源: NVIDIA 。
模块 2 :计算芯片层——训练看通用 GPU ,推理看定制 ASIC
当晶圆与封装出厂后,就进入了价值量占比最高(约占数据中心硬件成本一半)的计算芯片层。当前这一层的核心主线是从“训练( Training )”向“推理( Inference )”的结构性迁移:
•预训练阶段(通用 GPU 占据主导):在基础大模型研发阶段,算法架构快速变化,开发者极度依赖通用性强、算子生态成熟的编程环境。英伟达( NVDA )凭借深耕十余年的 CUDA 软件生态与机柜级系统整合能力,占据了绝大部分训练芯片市场,并维持着 70% 以上的惊人毛利率。•大规模商业化推理阶段(定制 ASIC 加速分流):当模型定型并每天处理数十亿次搜索、对话、短视频推荐请求时,云大厂最关心的指标变成了“单次 Token 推理的电费与折旧成本”。如果全部使用昂贵的通用 GPU 做推理,云厂商的利润率将被严重侵蚀。因此,云大厂纷纷联合定制芯片设计霸主(博通 AVGO 、 Marvell MRVL),加速放量专门针对自家模型裁剪优化的 ASIC 推理芯片(如谷歌 TPU 、亚马逊 Trainium 、 Meta MTIA )。•实战分工逻辑:通用 GPU 赚的是“全行业算力军备竞赛与生态溢价”的钱;而定制 ASIC 赚的是“推理需求反超训练、云巨头内部降本增效”的结构性替代的钱。三、 模块 3 & 模块 4 :存储与高速光铜互连——攻克“内存墙”与“通信墙”
如果只有强大的计算芯片,数据搬运和交换的速度跟不上,昂贵的 GPU 就会有一半以上的时间处于“空转等待数据”的状态。这就引出了解决“内存墙( Memory Wall )”的模块 3 ,以及解决“通信墙( Communication Wall )”的模块 4 。
模块 3 :存储与显存层——HBM 、企业级 SSD 与强周期铁律
大模型推理本质上是一个不断从显存中读取数千亿个权重参数的过程( Memory-bound )。显存容量和带宽直接决定了单卡能跑多大的模型、每秒能吐出多少个 Token :
1.HBM (高带宽内存)的商业模式质变: 传统 DRAM 内存是标准化的现货大宗商品;而 HBM 需要将 8 层、 12 层乃至 16 层 DRAM 晶圆垂直堆叠,通过硅通孔( TSV )与 GPU 封装为一体。由于堆叠良率门槛极高且严重消耗晶圆产能, HBM 采取了存储史上罕见的“提前一年锁定产能配额与合约价格”的定制模式。在美光( MU )、 SK 海力士与三星三大原厂中,谁能在新一代 HBM 堆叠良率与能效比上率先通过核心 GPU 厂商认证,谁就能攫取最高的利润份额。2.大容量企业级固态硬盘( eSSD )与近线存储: 在芯片外部,海量多模态训练语料的清洗、训练检查点( Checkpoints )高频读写,以及推理端检索增强生成( RAG )对庞大外部知识库的实时调用,推动高密度 QLC 企业级 SSD 、全闪存系统( PSTG 等)与大容量数据中心机械硬盘( WDC 、 STX )同步进入涨价周期。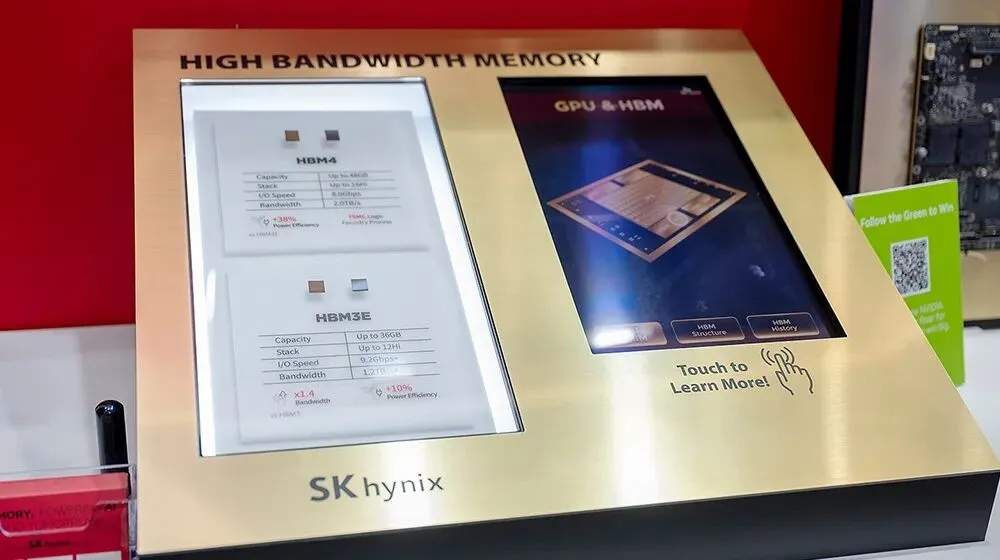 图 3 : HBM4 与 HBM3E 展品。来源: SK 海力士。
3.存储股的周期防坑铁律: 尽管有 AI 加持,存储原厂终究是重资产、高折旧的强周期行业。投资存储股必须克服人性直觉——当行业处于亏损去库存、各大原厂削减资本开支、静态市盈率( PE )高企甚至为负时,往往是周期底部买点;而当全行业毛利率创下历史新高、各家宣布斥资数百亿扩建晶圆厂、且静态 PE 跌至 8–10 倍看似“极其便宜”时,往往就是产能过剩前夜的周期顶点。
模块 4 :高速网络与光铜互连层——为什么光模块、铜缆与交换机弹性最大?
当算力集群从一万张卡扩展到十万张、甚至百万张卡时,卡与卡、机柜与机柜之间每秒需要同步海量的梯度参数。为了消除通信延迟,现代 AI 数据中心演化出了“板内—机柜内—跨机柜—交换网”四级互连体系,孕育了多个高毛利细分龙头:
| | | |
|---|
| 1. 服务器主板内(厘米级) | PCIe / CXL 信号重定时器( Retimer )与智能连接芯片 | 随 PCIe 5.0/6.0 速率翻倍,电信号在主板上跑十几厘米就会严重失真,必须加装 Retimer 芯片将信号放大整形,单台 AI 服务器用量成倍增加 | Astera Labs (ALAB) |
| 2. 机柜内部互连( Scale-Up , 1–3 米) | 无源高速铜缆( DAC )与有源电缆( AEC ) | “铜进光退”经济学:在塞满 72 颗 GPU 的超节点整机柜内,短距离用高速铜缆替代光模块,成本仅为光模块的 1/5 ,且近乎零功耗、零过热故障 | 安费诺 (APH , DAC 背板霸主)、Credo (CRDO , AEC 有源铜缆龙头) |
| 3. 跨机柜与跨机房( Scale-Out ,数米至数公里) | 800G / 1.6T 高速光模块、上游激光器光芯片( EML/CW )、硅光与 CPO | 距离超过 3 米后铜线衰减过大,必须用光模块进行光电转换;迭代周期从 4 年缩短至 1.5 年;美股真壁垒在上游磷化铟光芯片与 DSP 电芯片 | Coherent (COHR)、Lumentum (LITE)、Fabrinet (FN)、 AVGO 、 MRVL |
| 4. 集群网络交换层(万卡组网枢纽) | 顶级交换芯片( Tomahawk/Jericho )、 AI 以太网交换机、 InfiniBand 交换机 | 以太网反攻 InfiniBand:云巨头为打破英伟达专有网络绑定,全力推进超高速开放以太网标准,带动高端交换芯片与交换机放量 | 博通 (AVGO)、Arista Networks (ANET)、思科 (CSCO) |
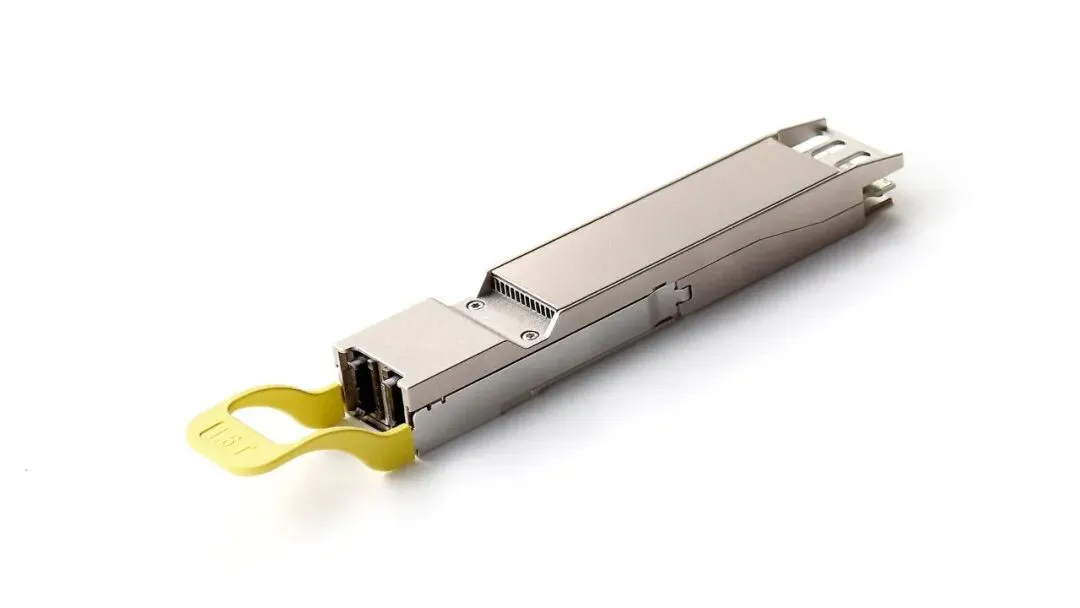 图 4 : 1.6T-DR8 硅光模块。来源: Coherent 。
重点深挖:看懂光模块产业链的“微笑曲线”与技术路线之争 很多投资者关注光模块,但必须分清“下游组装”与“上游芯片”的壁垒差异: * 上游光芯片与电芯片(利润大头与真正卡点):一颗 800G 或 1.6T 光模块中,成本占比最高的是负责发光的高速 EML 激光器芯片 / CW 连续波激光器(依赖稀缺的磷化铟 InP 晶圆产能,由 Coherent 、 Lumentum 及日系厂商主导)和负责信号处理的 DSP 电芯片(由 Marvell 、博通垄断)。每当光模块升级换代,最先出现缺货涨价的永远是上游光芯片。 * 从传统可插拔走向硅光( Silicon Photonics )与 CPO (共封装光学): * 硅光方案:利用成熟的硅基 CMOS 工艺制造光调制器,绕开紧缺的 EML 芯片,正在 800G/1.6T 时代快速提升渗透率。 * CPO (共封装光学):当速率迈向 1.6T/3.2T 时,传统插在交换机面板上的光模块自身功耗和发热已逼近物理极限。 CPO 直接把光引擎与交换芯片(或 GPU )封装在同一块基板上,缩短电信号传输距离并大幅降低功耗——这是未来 2–3 年重塑光通信竞争格局的最大技术奇点。
四、 模块 5 & 模块 6 :供电芯片、整机集成与液冷散热——攻克“功耗墙”
当计算芯片、存储和互连模块就位后,要把它们装进一台物理机柜并全负荷运转,马上会撞上严酷的电学与热学极限。
模块 5 :供电芯片( PMIC )、高频 PCB 与服务器整机集成( ODM/OEM )
1.千安培电流下的“芯片级垂直供电”( MPWR 、 Vicor ): 早期服务器芯片功耗仅 200W–300W ,而新一代旗舰 AI 芯片功耗已飙升至 1000W–1400W 以上。由于芯片内部核心工作电压不到 1 伏特( V ),根据功率公式( P = U × I ),流经单颗 GPU 的瞬时电流高达惊人的 1000 安培以上! 传统的“主板侧面供电”在走线过程中会产生巨大的电能损耗与发热,因此必须升级为紧贴芯片背面或底部的高密度多相电源管理芯片( PMIC )与垂直供电( Vertical Power Delivery )架构。单颗 AI 芯片配套的电源芯片价值量因此翻了数倍,成就了模拟电源芯片龙头的高毛利增长。2.高频超低损耗覆铜板( CCL )与高多层 PCB: 为了承载 224G 速率的电信号传输而不失真, AI 服务器主板与交换机背板必须采用昂贵的超低损耗树脂材料与高阶 HDI 工艺。3.AI 服务器整机集成商( DELL 、 SMCI 、 HPE 及台系 ODM )的估值辨析: 整机厂商负责将 GPU 、液冷管路、电源模块与铜缆组装成单台重达上千斤的超节点机柜。这一环节在算力建设初期营收爆发极快,但必须清醒认识到:服务器组装处于硬件微笑曲线的最底端,缺乏底层核心芯片知识产权,毛利率普遍只有 8%–15%。一旦行业供需缓解,极易陷入抢份额的价格战。选股时应重点考量其企业级/主权级客户粘性与全栈服务溢价,而非单纯看营收规模。模块 6 :机房温控与液冷散热层——单机柜突破 100kW 后的强制革命
散热从过去的“机房附属品”跃升为核心主线,源于一条铁律:传统空气冷却(风冷)的物理极限在单机柜 30kW–50kW 左右;而新一代高密度 AI 整机柜的功率直接跃升至 100kW–130kW ,下一代更是指向 200kW 以上。
由于液体的导热能力是空气的二十多倍,全液冷( Liquid Cooling )已从“可选项”变成新建 AI 数据中心的“强制准入证”。温控产业链按物理位置分为三层,壁垒高低迥异:
•第一层:芯片与服务器内部(二次侧组件——冷板 Cold Plate 、快接头 UQD 、机柜歧管 Manifold ): 直接贴合在 GPU 表面吸热并连接液体管路。虽然初期因防漏液认证严苛而享有高毛利,但随着云大厂为了降本积极引入第二、第三供应商,标准化零部件后期面临较大的降价压力。•第二层:机房冷量分配枢纽(一二次侧交界——CDU 冷量分配单元): CDU 是整套液冷系统的“心脏与大脑”,负责精准调节冷却液的流速、压力、过滤与热交换,防止机房结露或漏液。这一环节需要深厚的流体工程经验与控制软件积累。•第三层:室外冷源设备与全球工程维保网络(一次侧——大型冷水机组 Chillers 、冷却塔): 为什么美股机构格外青睐 维谛技术( Vertiv, VRT )、Modine (MOD)、特灵科技 (TT) 等温控巨头?因为云大厂不敢把价值数亿美元的算力集群交给没有全球售后能力的作坊式小厂。“机房级 CDU + 室外大型冷机 + 覆盖全球的数千名现场维保工程师网络”,才是温控赛道真正的长期复利护城河。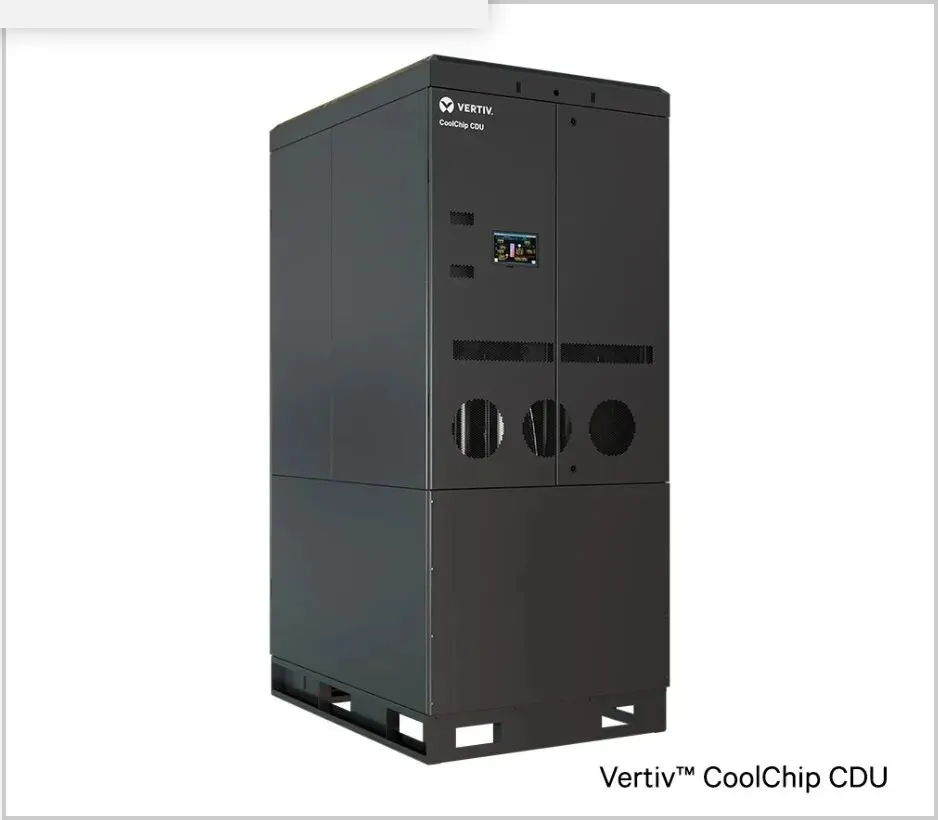 图 5 : CoolChip CDU 。来源: Vertiv 。
五、 模块 7 & 模块 8 :美国电力基建与下游买单人——攻克“缺电墙”与商业化闭环
当整机柜组装完毕、液冷系统就绪,运到美国的数据中心园区准备开机时,整个产业链撞上了当前最硬的一堵墙——没电。
模块 7 :电力基建、输配电与表后能源——从“缺芯片”到“缺变压器与核电”
在美国建设一座吉瓦( GW )级别的超大规模 AI 数据中心园区,正面临三重物理死结,这也催生了美股公用事业与工业板块罕见的成长股行情:
1.电网并网排队( Interconnection Queue )与变压器长周期缺口: 美国跨州电网基础设施严重老化且区域割裂,新建大型数据中心申请接入公共电网的排队审批周期普遍长达 3 至 5 年。即便拿到批文,变电站所需的大型高压变压器与中低压开关柜(伊顿 ETN、GE Vernova GEV 等主导)全球产能严重不足,交付周期长达 2 至 4 年。2.远期方案:抢签核电独立发电商( IPP )长协( PPA ): AI 数据中心需要一年 365 天、每天 24 小时不间断的稳定基荷电源(风电、光伏因间歇性无法独立支撑),同时科技巨头又背负着严苛的零碳排放承诺。因此,拥有现成核电站的独立发电商(Constellation Energy CEG 、 Vistra VST 、 Talen Energy TLN)成了香饽饽——云大厂纷纷以高于市场电价的溢价签署长达 15–20 年的独家购电协议,甚至出资推动退役核电站重启,并提前布局小型模块化核反应堆( SMR )。3.近期救急方案:重型燃气轮机与燃料电池“表后直供”: 由于核电审批与新建周期漫长,为了在 1–2 年内让机房快速通电,越来越多的数据中心选择绕开缓慢的公共电网,在园区内直接采购天然气重型燃气轮机( GE Vernova GEV )或固体氧化物燃料电池( Bloom Energy BE )进行现场独立发电( Behind-the-meter ),同时配套大型柴油发电机组(康明斯 CMI)与不间断电源( UPS )作为兜底。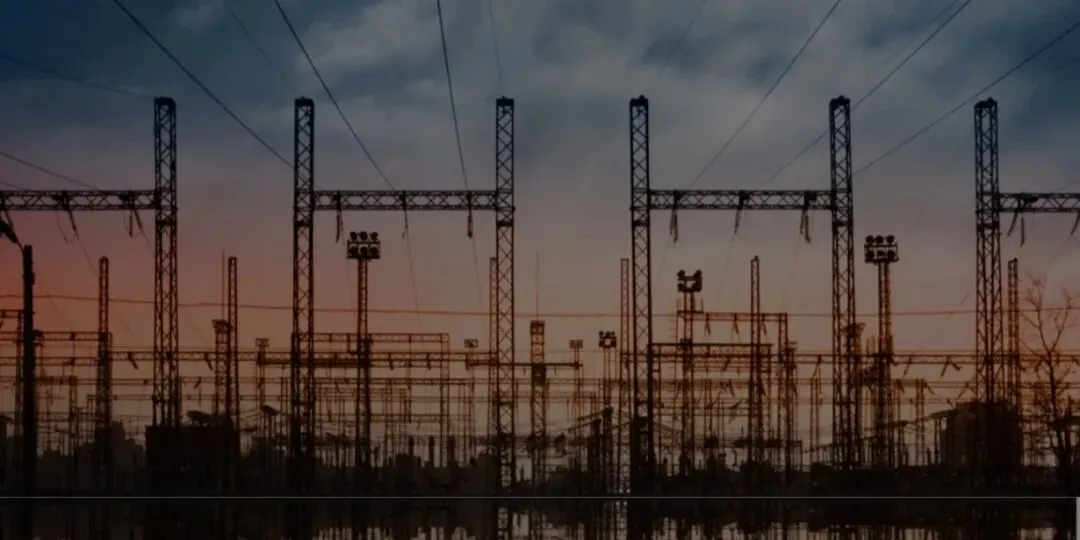 图 6 :户外变电站。来源:美国能源部。
模块 8 :下游算力买方与数据中心地产——谁在出钱,谁在收租?
整条硬件链条的最后一环,也是决定所有上游厂商订单可持续性的总阀门,由三类角色构成:
1.四大超大规模云厂商( CSP : MSFT 、 GOOGL 、 AMZN 、 META )及甲骨文( ORCL ): 它们贡献了全行业一半以上的算力采购额。评估它们的投资逻辑,核心看“CapEx 投入如何转化为增量收入( ROI )”的三条变现路径: * IaaS 层(直接租算力):在 AWS 、 Azure 、 GCP 上把算力租给外部企业,体现在云业务收入增速及 RPO (剩余履约价值)的攀升。 * PaaS/SaaS 层(软件加价):将 Copilot 与智能体嵌入办公软件、数据库与开发工具,提高单用户平均收入( ARPU )。 * 原生业务提效:用 AI 重构广告推荐引擎提升广告转化率,或替代内部研发与客服人力。2.新兴算力租赁商( NeoCloud : CoreWeave 、 Nebius 等): 专门囤积顶级 GPU 集群并打包租给大模型公司和科技大厂的“算力二房东”,具备极高的业绩弹性,但也背负着极高的债务杠杆(详见下节财务排雷)。3.数据中心地产( Data Center REITs : Equinix EQIX 、 Digital Realty DLR ): 随着 AI 应用进入低延迟推理阶段,算力机房不能只建在偏远荒漠,必须紧贴纽约、北弗吉尼亚、硅谷等核心人口与金融中心。在这些一线都市圈,土地、环评牌照与现成电网容量极度稀缺,手握核心地段“带电机架”的 REITs 成了稳坐钓鱼台的收租公,续租价差与租金回报率持续走高。六、 财务排雷显微镜:穿透“循环融资”与“延长折旧年限”的会计幻觉
顺着模块 1 到模块 8 梳理完产业全貌后,实战投资者必须保持最后一份清醒:在算力狂飙期,财报上的高增长有相当一部分被金融杠杆与会计估计调整放大了。以下两个雷区必须时刻监测:
1. 解剖“循环融资( Vendor Financing )”的杠杆闭环
在 AI 硬件订单中,除了四大云大厂使用自身充沛的经营现金流买单外,以算力租赁商( NeoCloud )和 AI 初创公司为代表的第二大买盘,运转着一套精巧的“资金内循环”:
1.第一步(巨头注资背书):上游芯片巨头或云大厂向某家 NeoCloud 或 AI 初创公司进行股权投资,并签署优先供货或长协租约。2.第二步( GPU 抵押借高息私募债): NeoCloud 拿着巨头背书和手头的 GPU 采购权,将 GPU 作为核心抵押品,向华尔街私募信贷机构( Private Credit )借出数十亿乃至上百亿美元的高息贷款。3.第三步(资金回流确认当期收入): NeoCloud 用融来的钱全额采购上游的 GPU 、光模块、交换机与液冷服务器——上游硬件巨头成功把“对外股权投资款”和“华尔街债务杠杆”,变成了自己利润表上高达 70% 毛利率的当期营业收入。
这条链条什么时候会断裂?
核心盯住“旧款 GPU 的每小时算力租金与二手残值”。一旦芯片快速迭代导致上一代芯片租金大幅跳水,作为债务抵押品的旧款 GPU 资产价值就会严重缩水;此时若下游 AI 初创公司因融不到钱而停止续租,高杠杆的 NeoCloud 就会面临现金流断裂与债务违约,进而瞬间砍掉上游硬件订单,并在市场上抛售二手算力引发价格踩踏。
2. 看穿“延长服务器折旧年限”的利润表时间差
在会计准则下,云大厂每年上千亿美元的硬件采购( CapEx )不会在当年立刻计入成本,而是作为固定资产,在未来数年内按季度分摊为折旧费用( Depreciation )扣减利润。
过去几年,微软、谷歌、亚马逊、 Meta 等巨头不约而同地将服务器与网络设备的会计折旧年限从 3–4 年统一延长至 5–6 年:
| | | |
|---|
| 1000 亿美元硬件的年折旧费用 | | | 账面每年凭空多出 166 亿美元的营业利润,短期 EPS 被大幅美化 |
| 芯片的经济寿命 vs. 会计寿命 | 契合 AI 芯片与光模块 1.5–2 年迭代一代、 3 年后能效比落后的现实 | | 若第 4 年旧款芯片因电费过高失去推理性价比而被提前淘汰,公司将被迫计提巨额资产减值损失 |
| 远期利润表压力 | | 前期利润虚高,后三年多层历史 CapEx 折旧叠加 | 一旦未来某年云收入增速放缓,前期累积的数千亿固定资产将迎来吞噬利润的“折旧洪峰” |
七、 AI 算力底座八大模块实战跟踪仪表盘
最后,我们将整篇八大模块的景气度验证与风险排雷,浓缩为一张拿来即用的财报季核验总表:
| | |
|---|
| 模块 1 :半导体母机与制造封装 | 台积电 CoWoS 扩产计划持续上修、 2nm 与 HBM 良率检测/测试设备订单创纪录 | 下游芯片厂砍减 CoWoS 预订配额、晶圆厂推迟设备资本开支、地缘摩擦升级 |
| 模块 2 :计算芯片( GPU/ASIC ) | 新架构整机柜按期放量、数据中心毛利率稳守 70%+、云厂定制 ASIC 量产加速 | 毛利率连续两季下滑、应收账款天数( DSO )异常拉长、 NeoCloud 客户融资受阻 |
| 模块 3 :存储与显存( HBM/eSSD ) | 下一年度 HBM 产能被提前包销完毕、企业级 SSD 合约价环比持续上涨 | 存储原厂宣布激进新建晶圆厂、现货价格滞涨转跌、静态 PE 跌至个位数伴随极度狂热 |
| 模块 4 :高速网络与光铜互连 | 1.6T 光模块放量超预期、磷化铟激光器光芯片紧缺、 AI 以太网交换机与 AEC/Retimer 份额提升 | 光模块组装端爆发价格战拖累毛利率、 CPO 等技术路线突变淘汰存量方案 |
| 模块 5 :供电芯片、 PCB 与服务器 | 单芯片功耗攀升带动垂直供电 PMIC 单机价值翻倍、液冷整机柜交付顺畅 | 服务器整机厂存货积压、组装毛利率因恶性代工竞争跌破历史警戒线 |
| 模块 6 :机房温控与液冷散热 | 机房级 CDU 与冷水机组在手订单( Backlog )同比高增、交付排期延长 | 二供/三供大量涌入冷板与快接头环节引发价格战、出现重大机房漏液停机事故 |
| 模块 7 :电力基建与表后能源 | 核电/燃气发电商签署高溢价数据中心长协( PPA )、高压变压器与燃料电池订单饱满 | 能源监管机构叫停电厂“表后直供”模式、缺电导致数据中心大面积延期上架 |
| 模块 8 :云厂商、 NeoCloud 与 REITs | 云业务 RPO (剩余履约价值)增速快于营收增速、核心都市圈带电机架租金连涨 | 云大厂自由现金流大幅恶化被迫下调 CapEx 指引、旧款 GPU 算力每小时租金跳水 |