ARTICLE · 1228654
让AI参与13万次因子搜索之后:LLM真的能发现新的Alpha吗?
如果让AI读懂行情、提出公式,再根据回测结果不断修改,它能否找到我们尚未发现的股票收益规律?
沿着东吴证券《AI因子挖掘的双路径实践与Skill沉淀》的公开框架,我们开展独立研究:让大语言模型参与公式搜索、编写因子函数,再与传统算法和神经网络模型比较。
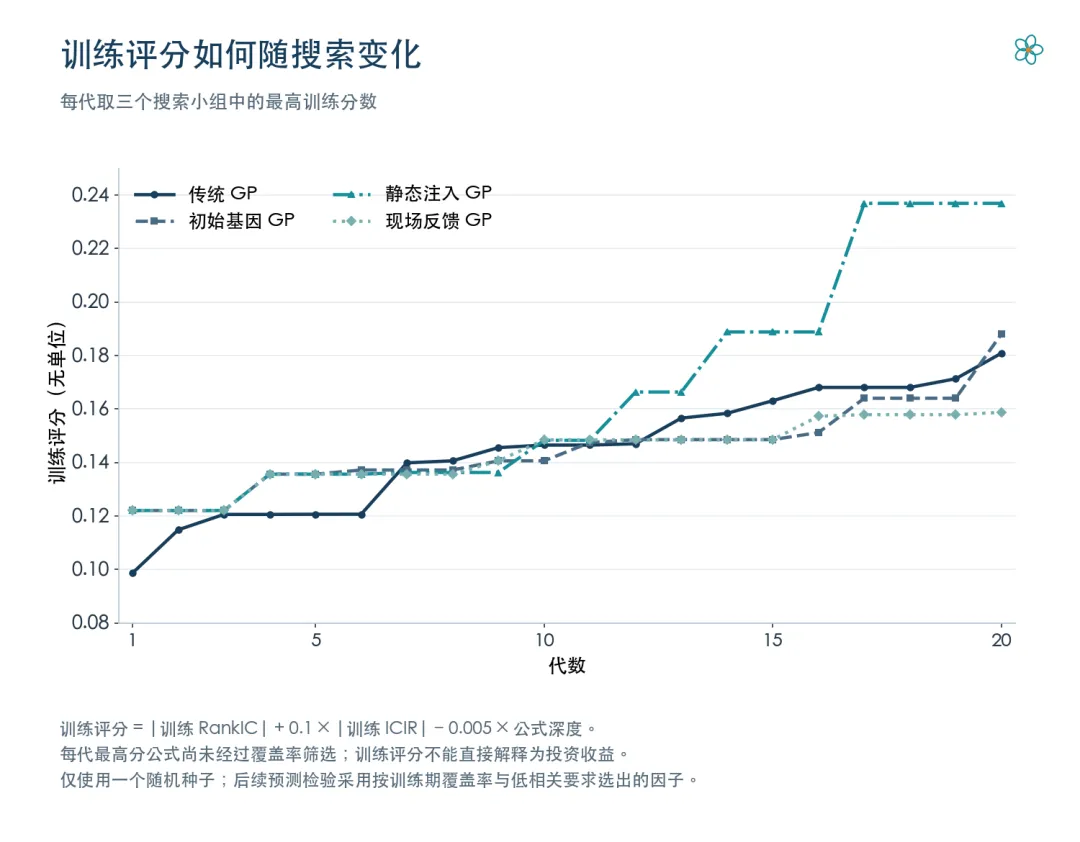
四组遗传编程实验累计尝试133,711条表达式。这是各组内部去重后的合计,包含传统算法的公式、失败表达式和跨组重复,并非LLM独立提出了13万个因子。反馈组中,Codex提出90条表达式,89条进入后续进化;函数式路线另检验了两轮、18个提案。
结果未显示LLM相对传统遗传编程的独立增量优势。一些单看很强的因子,加入传统变量控制后明显减弱;一些更严谨的修改,也没有带来预测提升。
更多公式意味着更多新规律,还是对已知信息的重复表达?这是这轮研究最想回答的问题。
一、为什么让LLM参与因子挖掘?
因子是给股票打分的规则。例如,把过去20日跌得较多的股票排在前面,观察此后是否更容易反弹,这叫短期反转。再将价格、成交量、波动和换手率组合起来,就能得到更复杂的规则。
传统遗传编程(GP)会让公式不断“繁殖”:保留历史分数较高的公式,交换其中一段结构,再随机修改算子或参数,反复迭代。它擅长大量尝试,却不一定理解表达式的金融含义。只要训练分数够高,单位混乱、分母接近零、仅对少数股票有效的公式,也可能被保留下来。
LLM可能先提出有金融依据的假设,再翻译成公式。例如,高开后持续回落与低开后逐步反弹,可能对应不同的交易行为;同样上涨5%,在低波动和高波动股票上,含义也不同。
这些知识能否改善搜索?“解释合理”和“提供新的预测信息”,需要分别回答。
二、如何区分LLM和传统算法的贡献?
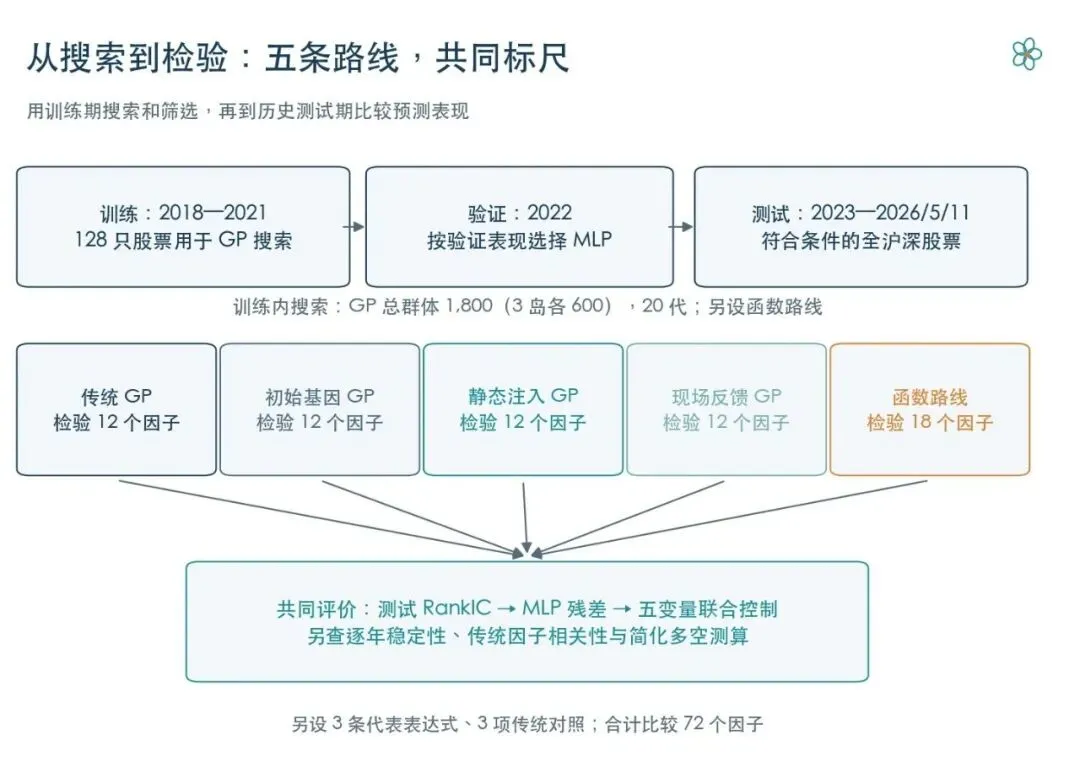
我们设置四组GP实验,逐步加入金融知识和LLM参与,并单独考察直接编写函数的路线。
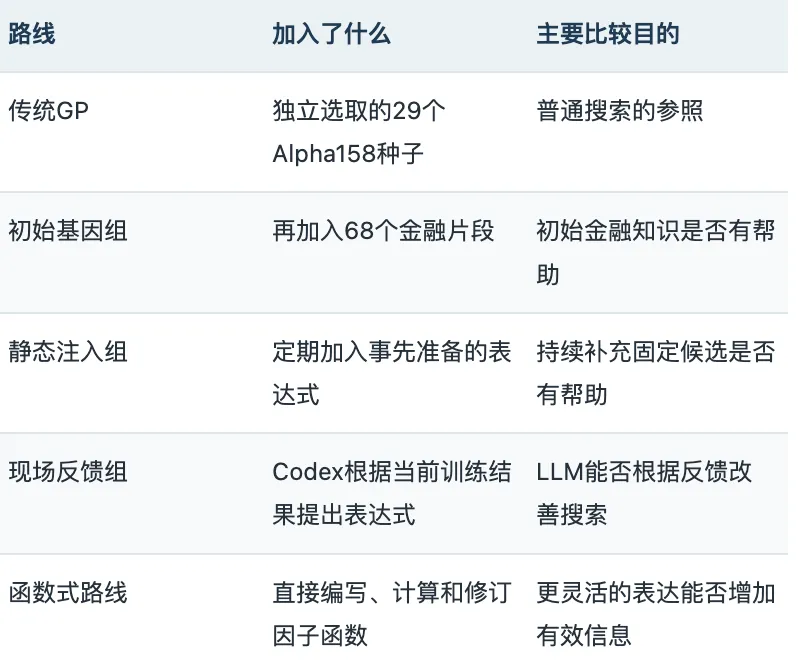
“岛”是相对独立的搜索小组,每组600个公式,每4代交换优秀个体。两种注入实验每3代、每岛补充5个表达式。68个金融片段由17类机制和4组窗口构成,供算法组合,不等于68种独立收益来源。现场反馈组共进行18轮提案。
研究使用沪深股票的日频价格、成交量、成交额、市值和换手率,覆盖2267个交易日,累计涉及5433只股票,各日可用数量不同。2017年用于滚动指标预热,2018—2021年用于搜索和训练,2022年用于验证,2023年至2026年5月11日用于历史测试。各阶段交界处剔除尚未走满5日观察期的收益标签,因子正向还是反向使用,也只由训练期确定。
主要预测目标是从当天收盘到未来第5个交易日收盘的收益。交易分析则从下一交易日开盘买入,避免用收盘后才能得到的完整信号,假设自己已经按当天收盘价成交。
我们还用158个Alpha158特征训练多层感知机(MLP),即一个小型神经网络。它经过64、32个节点的两个中间层,给出综合预测分数。模型训练5轮,每轮约340.7万条样本,按2022年的验证表现选择模型。另设弹性网模型作辅助参考,但仅覆盖36个测试日期。
三、LLM究竟提高了多少RankIC?
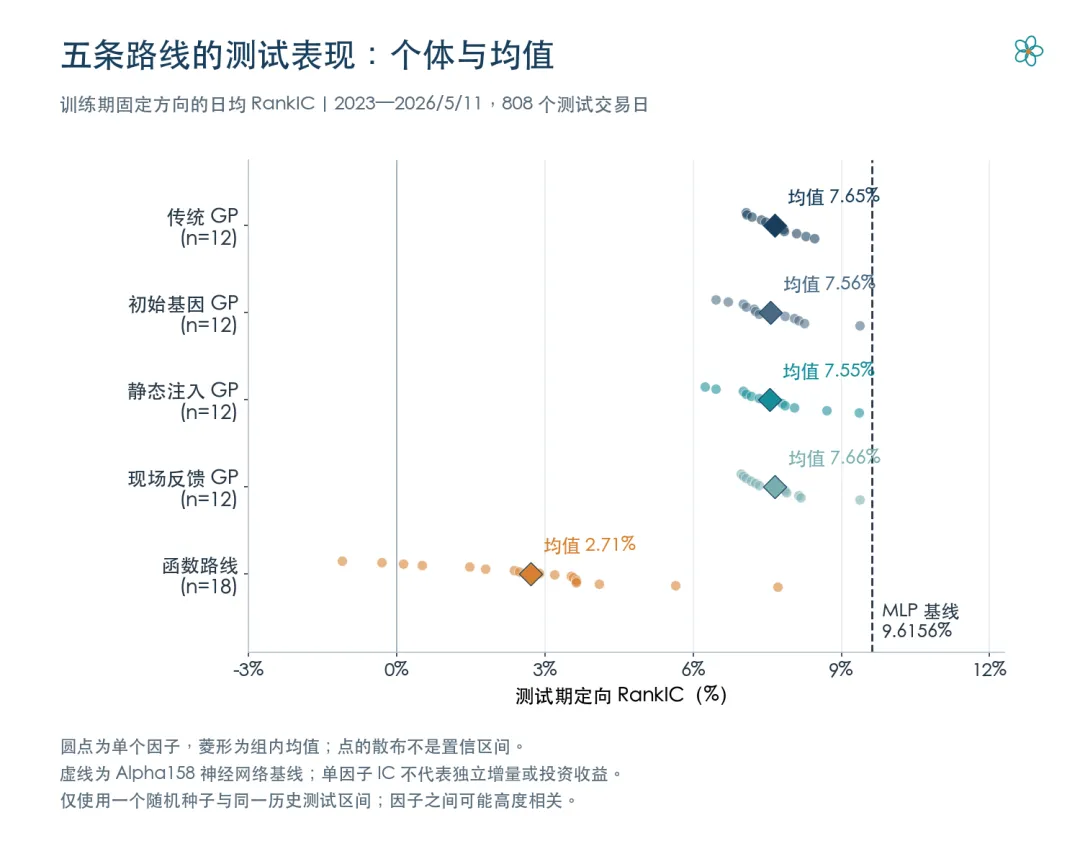
RankIC衡量排序能力:每天分别按因子分数和未来收益给股票排序,计算两种排名的相关程度。7.65%表示相关系数约0.0765,实际收益和预测正确率需另外计算。
我们按训练期覆盖率和因子间相关性筛选,每个GP组保留12个因子;再加上3个研报代表式、3个传统对照和18个函数,统一检验72个因子及两个预测基线。下文结果针对这些因子,不能代表全部搜索公式。
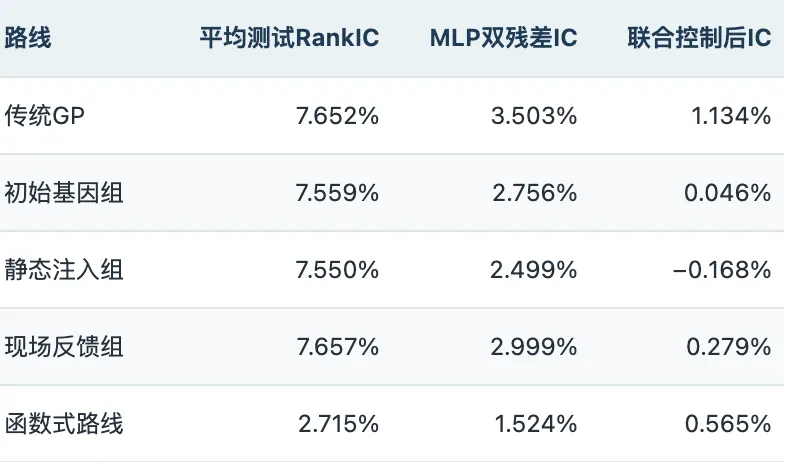
表2|各列均先计算单个入围因子的统计量,再在组内取均值,不代表组合收益。后两列检验基线模型和传统信息之外的剩余关联,方法见下一节。
现场反馈组平均RankIC比传统GP高约0.005个百分点,差距很小;剔除MLP能解释的部分后,反而低约0.504个百分点。Alpha158MLP自身的测试RankIC为9.616%。这轮实验没有提供LLM增量优势的证据。
一个随机种子、不同实际计算量的比较,不足以判定胜负或证明LLM普遍无效。
看一个具体公式,比只看平均数更直观。研报代表因子CANDLE_SHADOW_P3可以写成:
日内收益 = (收盘价 - 开盘价) / 开盘价相对上影线 = (最高价 - max(开盘价, 收盘价)) / 开盘价因子 = EMA((日内收益 + 相对上影线) ** 3, 20)
两部分相加后取三次方,再做指数移动平均,让近期权重更高。20日为本研究窗口,公开材料未能确认原窗口。
乍看之下,它结合了“日内上涨”和“冲高回落”。但不妨用两只假想股票算一遍:甲股开盘10元、收盘10.2元、最高10.4元,两部分相加为2%+2%=4%;乙股开盘10元,收盘和最高都为10.4元,相加为4%+0%=4%。
两种走势的上影线不同,送入后续计算的数值却相同。原因是,当收盘不低于开盘时,这两项相加恰好等于“最高价/开盘价−1”。公式名称中的“影线”,并不意味着它能单独识别影线压力。
它在测试期的原始RankIC为−8.896%。由于训练期已确定反向使用,按训练方向计算后为+8.896%。这个表现值得研究,但还不能说明它发现了传统模型不知道的规律。
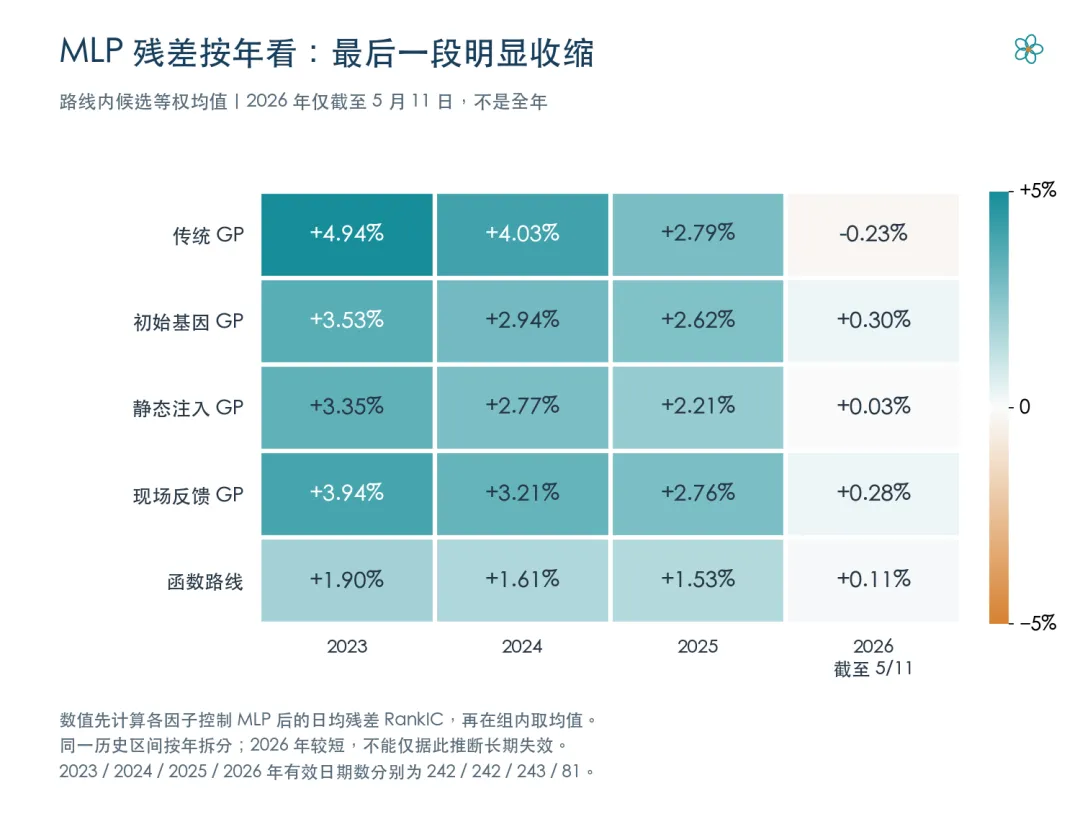
稳定性同样重要。2026年截至5月11日,传统GP的平均MLP残差IC降至−0.226%,现场反馈组为0.275%,函数组为0.111%。这段时间较短,尚不足以断言长期失效,但全期较高的平均值已经不能完整反映最近阶段的表现。
四、复杂表达式提供了多少新信息?
假设一个新因子总在挑最近下跌、波动较低的股票,而原模型本来就在做相似判断。两者都可能有不错的RankIC,但把新因子加入模型,未必能增加多少信息。
为此,我们使用双残差检验:先分别估计因子和未来收益中,能够被当天MLP分数线性解释的部分,再比较两边剩下的数值是否仍然相关。它回答的是“排除已有模型的线性解释后,还剩多少关联”,并非将两个IC简单相减。
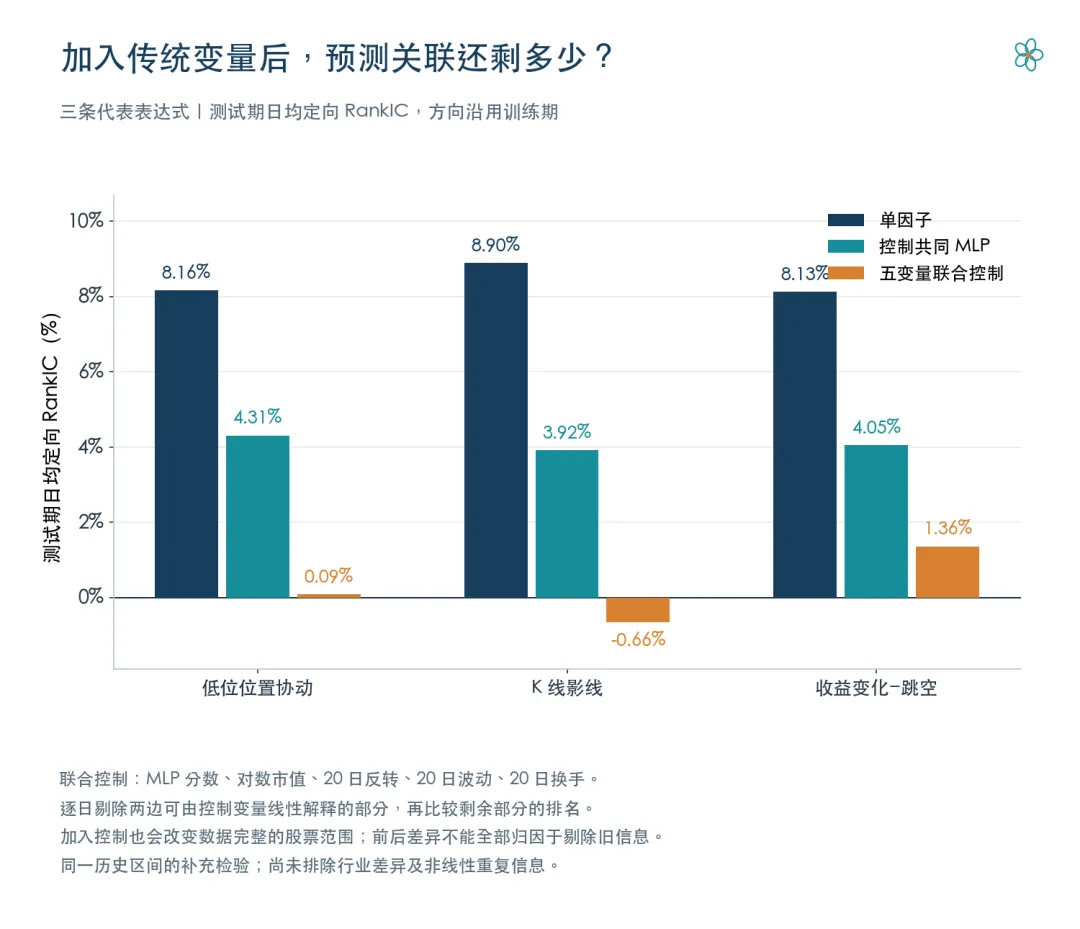
随后,我们再同时加入市值、20日反转、20日波动和20日换手,检查剩余关联是否还在。这里的未来收益只用于事后统计,不会成为投资时可以提前使用的特征。
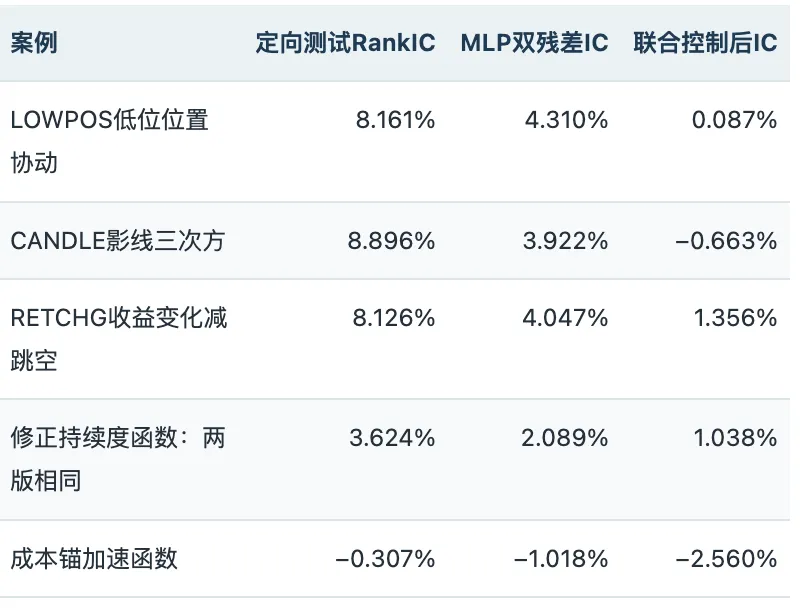
表3|前三项为研报代表表达式,后两项为本研究设计的函数。所有结果沿用训练方向;联合控制分析不用于反过来生成公式或调整方向。
LOWPOS单独的RankIC达到8.161%,加入联合控制后仅剩0.087%,对应t统计量约0.19;CANDLE则转为负值。RETCHG仍保留正关联,可以继续研究,但目前还不能排除其他风险暴露、非线性重复和交易限制。
检验只剔除所列变量的线性解释,加入变量还会改变数据完整的股票范围。因此,前后差异不能全部解释为“剔除了旧信息”,剩余IC也不能直接认定为独立Alpha。
再看一次实际修改。“修正持续度”函数先识别隔夜涨跌与日内涨跌方向相反的情形,再结合修正是否持续,以及近期振幅是否收缩。初版的核心写法是:
修正值 = np.where(隔夜收益 * 日内收益 < 0, 日内收益, 0)
问题在于,收益缺失时,条件判断也会落到“否则为0”。但零表示确实观察到了没有修正,缺失表示根本无法判断。于是我们将它改为:
有效 = np.isfinite(隔夜收益) & np.isfinite(日内收益)修正值 = np.where( 有效, np.where(隔夜收益 * 日内收益 < 0, 日内收益, 0), np.nan)
这个修改更准确地区分了“没有发生”和“无法观察”。不过,逐项比较最终因子值,两版结果完全一致,测试RankIC同为3.624%,MLP残差IC同为2.089%。修改改善了代码含义,没有改善预测。我们原先预期该信号正向有效,训练结果却要求反向使用,金融解释也必须接受数据检验。
现场反馈组还有一次更明显的公式改写。令r为每日收益,旧式可以简写为:
旧式 = 成交量 × 换手率 / sqrt(过去10日平均r)新式 = sign(过去10日平均r) × log(1 + abs(过去10日平均r) / (过去20日r的标准差 + 极小正数))
旧式将不同单位混在一起,而且平均收益为负时,实数范围内无法开平方。新式保留涨跌方向,用波动率衡量趋势强弱,再通过对数压缩极端值。
在包括预热期的搜索数据中,能够算出有限值的比例由48.7%提高至97.8%,可计算IC的日期从806天增至968天。但训练期原始IC绝对值由10.63%降至2.27%。两式可用样本不同,不能据此直接比较预测强弱;它至少说明,计算更完整并不保证训练分数更高。两式均未入围后续大范围测试,因此尚不能判断改写是否提高了测试表现。
“成本锚加速”则是一个负例:以5日和20日成交量加权价格作为成本参考线,用真实波幅统一尺度,观察两线差距是否加速,再削弱高换手时的信号。思路可以解释,按训练方向计算的测试IC却为−0.307%。如果看到负值后再翻转方向,同一段历史便参与了第二次选择。
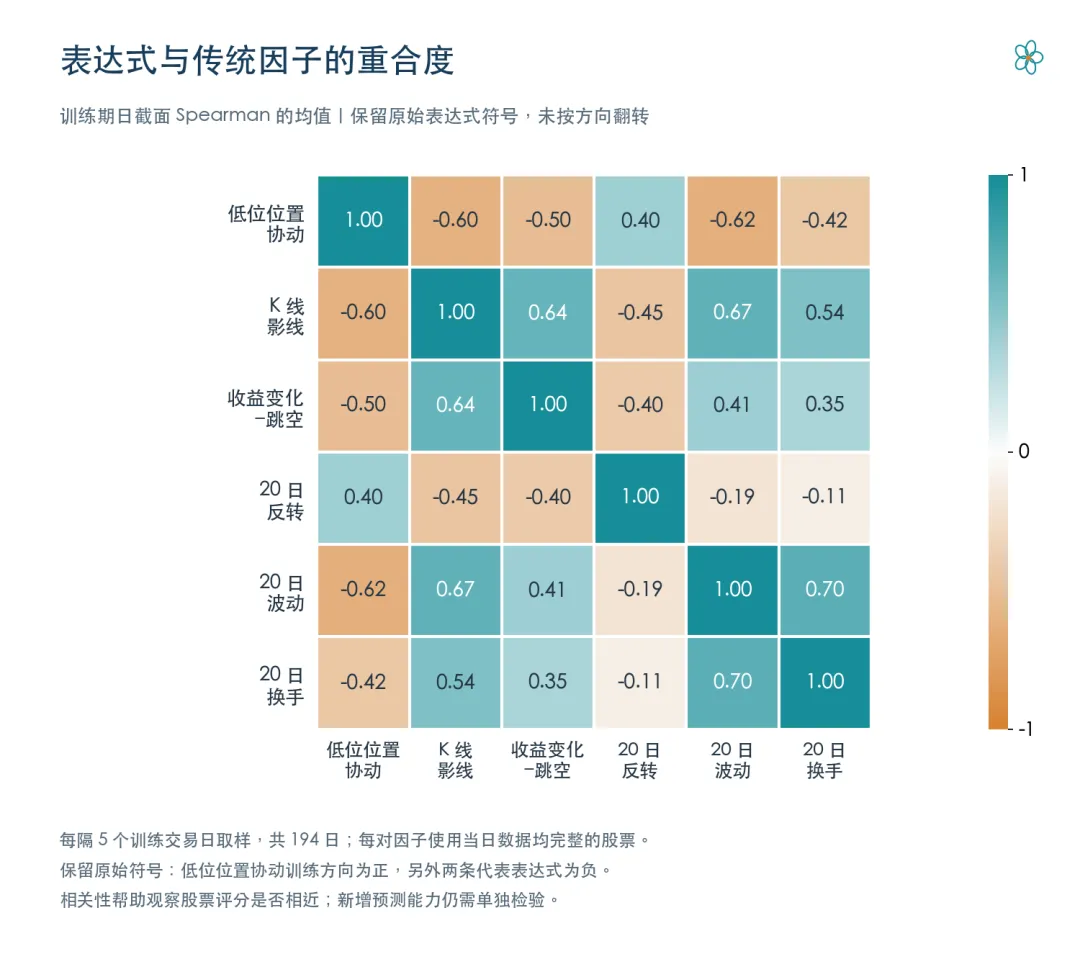
公式数量还会夸大信息的丰富程度。四组GP的入围公式、研报代表式和传统对照合计54条,去掉完全相同的公式后只有43种。不同公式之间,也可能仍在表达相近的反转或波动逻辑。
五、大规模自动因子挖掘的边界在哪里?
首先,搜索会忠实追随我们给出的目标。本研究主要奖励原始RankIC和ICIR,并惩罚公式深度。ICIR是IC均值与日间标准差之比,用来描述预测关联的稳定程度。这个目标没有直接奖励强基线之外的独立信息,算法便可能反复找到成熟规律的复杂变体。
覆盖率筛选也会影响结果。我们曾先取训练分数前500名,再检查覆盖率,发现只对少量股票有效的高分公式挤占了筛选范围。调整后,先排除不可能满足覆盖率的公式,再要求训练覆盖至少80%、平均绝对日相关低于0.90,门槛并未放宽。更严格的逐日覆盖评分只在60个体、3代的小规模实验中检验,本文1800个体、20代的结果尚不能代表该规则下的表现。
其次,搜索次数越多,越需要警惕偶然性。十多万次尝试足以产生历史上漂亮的公式,即使做多重检验,也不能凭一个随机种子、一次时间划分和128只搜索股票排除选择偏差。本文采用按时间划分的历史测试,后续仍需在研究方案确定之后,用尚未参与研究的新日期检验。
第三,数据口径会改变公式含义。本研究99.146%的换手记录采用普通换手率,与研报所用自由流通换手率不完全一致;历史数据是否全部能在当时取得,仍未完全核实,也未排除行业差异的影响。这些限制会影响因子比较和复现程度。
最后,预测关联必须经过交易检验。我们按下一交易日开盘入场、第5个交易日收盘退出,分别考察5、10、20bps的单边费用。10bps相当于0.1%。在数据完整的持有批次中,单边10bps时,各路线平均长短组合净收益均为负。
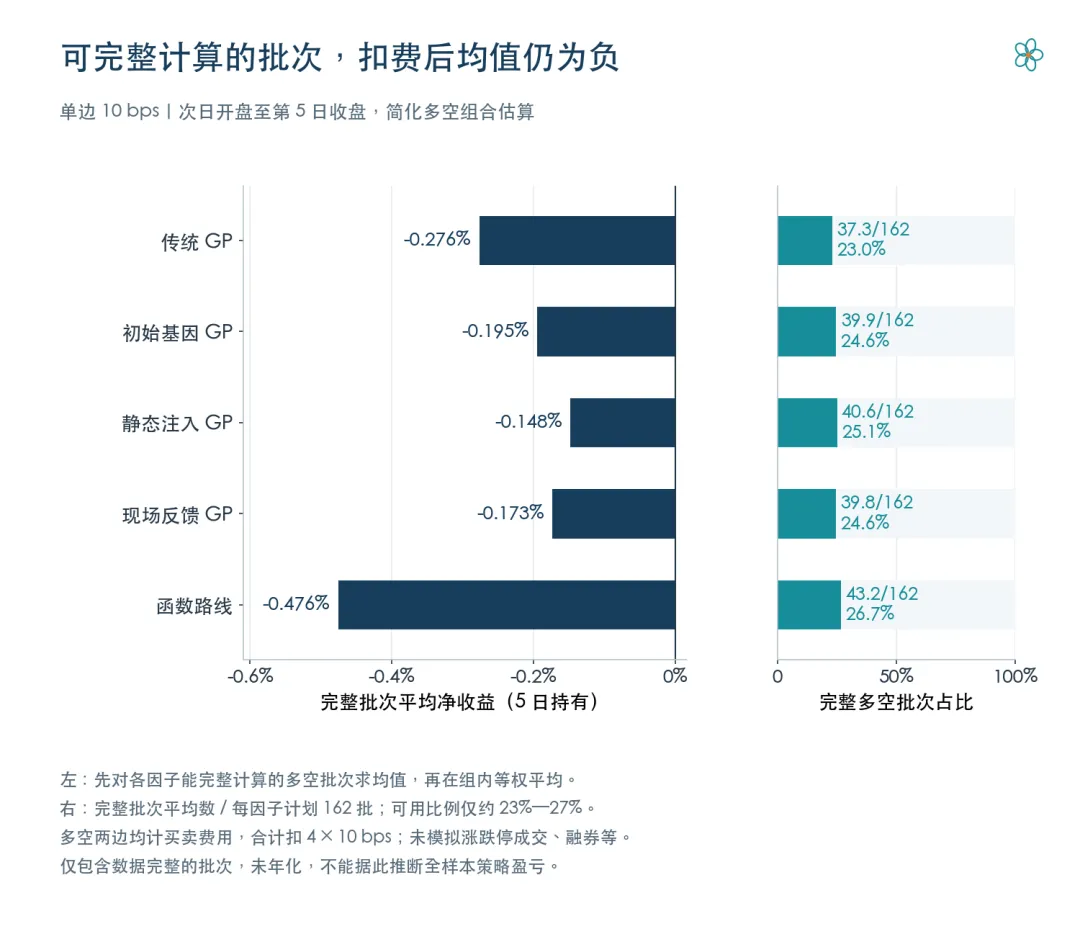
这一结果还不能推广到完整策略。每个因子计划162个持有批次,传统GP平均只有37.3个批次能观察全部多空成员的收益,现场反馈组为39.8个,函数组为43.2个。只要有成员收益缺失,我们就不计算该批次,没有重新挑股票或补零,因此可用批次仅约23%—27%。
负均值提醒我们交易成本可能侵蚀信号,但较低的数据完整比例,也限制了对全样本盈亏的判断。涨跌停能否成交、能否借到股票、资金如何连续持有,以及策略能容纳多少资金,都还需要进一步研究。
这些发现也改变了我们下一轮的研究顺序:明确预测目标与数据定义,检查公式覆盖多少股票,再检验已有模型之外的增量;修改公式时,比较样本变化与预测变化;最后判断成本和成交约束是否允许获利。
LLM已经能够帮助研究者提出假设、表达机制和修改公式,但本轮实验没有显示,它因此比传统GP找到了更多独立Alpha。下一步需要更直接地以独立增量作为搜索目标,扩大有代表性的搜索样本,并通过多随机种子、新日期和更完整的交易检验,判断它的表达能力能否转化为投资价值。