ARTICLE · 1233118
AI 的投入产出账,到底该怎么算
2025 年 7 月,研究机构 METR 发布了一项随机对照实验的结果[1]。16 位资深开发者,在自己平均参与了 5 年的成熟开源项目里完成了 246 个真实任务,每个任务随机决定允许还是禁止使用 AI。开始之前,他们预计 AI 能让自己快 24%,经济学和机器学习领域的专家给出的预测更乐观,分别是快 39% 和 38%,但实测下来,用了 AI 的任务反而多花了 19% 的时间。更耐人寻味的是,做完之后,这些开发者仍然认为 AI 让自己快了 20%。
企业层面的情况也相去不远,MIT NANDA 项目 2025 年发布的报告称,在其研究的组织中,95% 没有从生成式 AI 项目中获得可衡量的回报[2]。这只是一项样本有限的初步研究,并不代表所有企业 AI 项目的失败率,但"用了不少,却说不清赚了没有"的状态,想必很多人并不陌生。
1、模型调用成本只是这笔账的零头
先看看得见的模型订阅成本,随着大模型领域中的工程优化技术的发展,主流模型的降价幅度均超过60%。
真正的成本藏在看不见的地方,大致可以分为四项:(1)交代成本,即把背景、材料和自己的判断讲清楚、交给 AI 所花的时间;(2)检验成本,即判断 AI 交回来的东西对不对、好不好所花的时间;(3)学习成本,即学会用一个工具、摸清它的脾气所花的时间;(4)返工成本,即发现问题之后推倒重来所花的时间。
以我用 Claude Code 开发英语口语练习小程序的经历为例。需求来来回回改了好几版,好在功能不复杂,交代成本尚可接受。同时,功能验收虽然很快,但要找出模型做得不好的地方,只能靠自己实际去用。整个过程中最耗时间的,是一个和 AI 无关的问题:开发者账号注册成了小游戏的类型,为了排查这个问题,前后花了很长时间。因此,个人用 AI 的成本,大头在时间,而且这些时间也并不全花在 AI 身上,为了将任务背景完完全全地交代给AI,才是最大的那一笔。
2、收益有两种,能力扩展常被低估
成本之外,收益也需要分开来看,一方面是省时间,原本两小时的事情一小时做完,可以按工时计算。另一方面是能力扩展,做到了以前做不到的事情,这种收益没法按工时计算。
那个小程序就属于后者,我不具备编程能力,没有 AI,这件事根本做不成,讨论它节省了多少时间并没有意义。从这个角度看,前面花在交代、检验和排查上的时间,换来的是一项原本不存在的能力,这笔账怎么算都划算。但是,也正因为能力扩展的收益无法量化,它在讨论"AI 有没有提效"时常被忽略,而对个人来说,它恰恰可能是最值钱的那一部分。即便在 METR 那项整体变慢的实验里,开发者也反映,AI 在他们不熟悉的问题上帮助很大,有人第一次写 Git hooks,估计没有 AI 的话要多花 3 个小时;论文作者也特别提醒,这一结果与"小型新项目、陌生代码库里 AI 能显著提速"并不矛盾[1]。
3、交代成本的高低,取决于关键输入是否已经存在、能否说清
交代成本常被理解为"要给 AI 多少材料",但从我自己的几次经历来看,材料的多少并不是关键,关键在于这件事真正需要的那部分输入,是否已经存在于我这里,以及能否被说清楚。按这两个条件,大致可以分出三种情况。
第一种,关键输入现成,而且说得清。给孩子写生态保护的演讲稿就是这样。这篇稿子真正需要的,是孩子在这个领域的实践、体会和感想,这些都是现成的事实,只要整理出来交给模型就行。前期交代虽然花了不少时间,但模型在这些材料的基础上给出了几个相当惊艳的切入点,最后定下的题目是"大自然中的道法课堂"。从提炼角度这件事来看,恰好又是 AI 擅长的部分,因此这笔交代成本花得很值。
第二种,关键输入存在,但说不出口。METR 的论文里有很典型的描述。开发者反映,AI 用不上他们脑子里那些没写下来的项目知识,就像一个新来的贡献者,连该在哪里改都找不准;有人举例说,为了兼容旧版本必须保留某一行代码,可这种信息"很难交代给模型"[1]。知识明明在开发者那里,却藏在多年的经验里,要逐条说清楚,成本高到不如自己动手。
第三种,关键输入还不存在。我让 AI 写过一份工作汇报,可动笔之前,我自己对这项工作该怎么总结、重点放在哪里,原本就没有多少思路。AI 写出来的东西缺少背景,更缺少对工作的判断和取舍,来回对话花了不少时间,最后还是自己动手完成。回头看,问题并不在于我交代得不够,而在于判断本身还没有形成,自然无从交代。这类任务交给 AI,得到的只能是正确的废话。
因此,交代成本高并不可怕,第一种情况下多花些时间往往是值得的。真正让人用亏的是后两种:知识说不出口的,要靠平时一点点把它变成说得出口的;判断还没形成的,该做的是先把事情想清楚,而不是指望 AI 替自己想。
4、检验成本:功能好验,体验难验
回头再看 METR 的实验,论文作者在 21 个可能的影响因素中,认定有 5 个很可能导致了变慢,其中最直接的一个,正是检验成本[1]。开发者只接受了不到 44% 的 AI 生成内容,即便接受了,75% 的人仍会逐行阅读,56% 的人表示经常需要大改;从录屏来看,约 9% 的时间花在审查和清理 AI 的输出上,有人先用 AI 折腾了一个多小时,最后全部撤销,自己动手。与此同时,写代码、查资料的时间减少了,写提示词、等待生成、审查结果的时间却多了出来。
另外几个因素同样指向前面的框架:这些开发者平均有 5 年经验、约 1,500 次提交,在自己越熟悉的任务上变慢得越明显;项目平均有 10 年历史、超过 110 万行代码,AI 在这样的大型复杂环境里表现更差;再加上前面说的隐性知识,以及开发者对 AI 效用的过度乐观。生成的那一刻很快,检验和修正的时间却在不知不觉中累加进去,这也解释了他们为什么事后仍然"觉得"自己快了。
生成很快、检验很慢,而被记住的往往只有前者。
把交代成本和检验成本放在一起,就得到了一个判断框架,如图 所示。
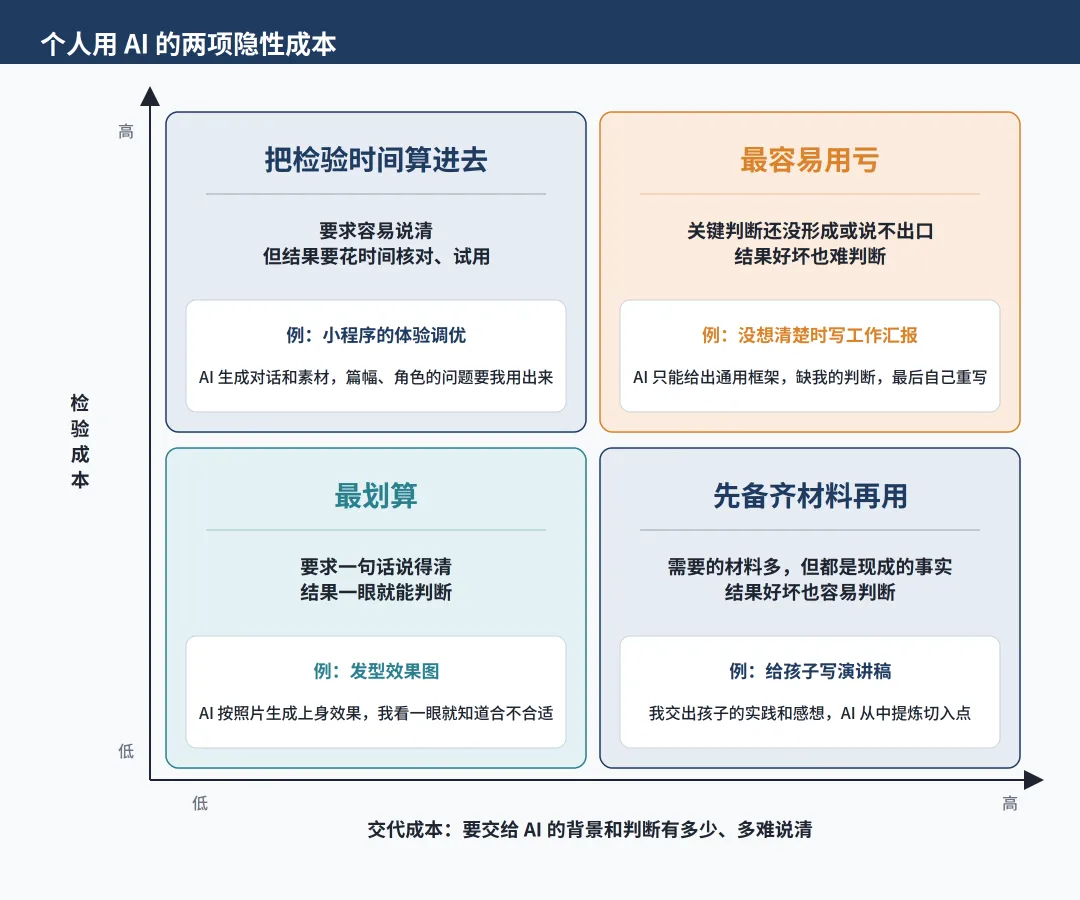
左下角是最划算的一类,要求一句话就能说清,结果一眼就能判断,比如让 AI 按照片生成发型效果图,我看一眼就知道合不合适。右下角的任务需要的材料多,但都是现成的事实,结果也容易判断,先把材料备齐再交给 AI 即可,给孩子写演讲稿就是这样。左上角的任务要求容易说清,但结果要花时间核对和试用,比如小程序的体验调优,篇幅、角色这类问题只能靠我自己用出来,因此要把检验的时间算进收益里。右上角最容易用亏,关键判断还没形成或者说不出口,结果好坏也难以判断,在自己还没想清楚的时候让 AI 写工作汇报,便属于此类。
当然,这个框架有一个前提,就是 AI 在这件事上确实能带来增量。对于自己已经非常熟练的事情,增量本身就有限,两项成本稍高一些,就很容易得不偿失。METR 的数据正好说明了这一点,开发者对任务越熟悉,用 AI 反而越慢,而在陌生的问题上,AI 的帮助就明显得多。
5、落到个人 Agent,关键是意图捕捉和检验标准
把这笔账再往前推一步,就落到了个人 Agent 的设计上。两项隐性成本之所以高,说到底是因为 AI 既不清楚我真正想要什么,也不知道怎样才算做好。所以,无论是自己搭建一个 Agent,还是挑选一款 Agent 类的应用,最关键的都是两个要素:意图捕捉和检验标准。
意图捕捉对应的是交代成本,一个好的个人 Agent,不该等着用户把所有背景一次讲完,而是能在过程中主动追问,把用户的偏好和过往的判断沉淀下来,下一次直接调用。当然,意图捕捉的前提是意图已经存在。像工作汇报那样,连我自己都还没有形成判断,再好的追问也捕捉不到什么;而对于 METR 实验里那种藏在经验中的知识,主动追问和持续沉淀,恰恰是把它一点点捞出来的办法。
检验标准对应的是检验成本,能写成明确规则的,尽量写成规则,让 AI 自己去核对,写不成规则的,至少给出清楚的标准和几个样例。很多时候,要求本身并不需要改变,只要换成一个 AI 自己能够核对的形式,结果就会稳定得多。
一旦检验标准足够明确,AI 就可以在"生成、检验、修正"的循环里自我迭代,不再需要人在每一步介入。编程和数学证明就是最典型的例子。代码能否运行、测试能否通过,环境会给出确定的反馈,同时,数学证明一旦写成 Lean 这样的形式化语言,对错就可以由机器严格校验。2024 年,DeepMind 的 AlphaProof 和 AlphaGeometry 2 在国际数学奥林匹克竞赛中解出了 6 道题中的 4 道,达到银牌水平,其中 AlphaProof 正是在 Lean 中训练自己完成证明的,只是题目仍需人工先翻译成形式化语言[3]。
6、放到企业,同样的两个要素要上升到组织层面
同样的账放到企业里,每一项都会被放大。一方面,从意图捕捉的角度来看,个人要交代的是自己的背景和判断,企业要交代的则是整套流程、规则和业务知识,而这些往往散落在不同部门、不同员工的经验里。另一方面,从检验标准的角度来看,个人检验的是一份结果,企业要建立的则是验收、兜底和担责的整套机制。
我在 ICT 行业做技术规划时,面对 AI 投入的取舍,用的是按场景分级的方法:一方面区分高价值和低价值的场景,另一方面区分可容错和强刚性的场景,再把 AI 投入优先放在高价值、容错空间又相对充足的场景上。现在回头看,"可容错还是强刚性",对应的正是检验标准能否写清、出了错能否兜底。这也与之前讨论过的电力进入工厂的历史相呼应。生产率的提升,要等到组织围绕新动力完成重构,在此之前,企业经历的往往是只见成本、不见回报的过渡期。
7、对转型的启示:把说不出口的变成说得出口,把做得好写成标准
如果说划不划算取决于意图能否被捕捉、结果能否被检验,那么无论是个人转型成 AI-native 的员工,还是企业转向 AI-native 的组织,要做的事情其实是同一件:持续降低这两项成本。
对个人而言,至少有三件事值得现在就开始做。(1)把说不出口的知识变成说得出口的,把没想清楚的事情先想清楚。前者需要平时就有意识地把自己的判断依据、做事偏好和常用方法写下来,沉淀成 AI 可以反复调用的材料,比如个人知识库,或者固化下来的 Skill;后者则提醒自己,AI 可以帮忙梳理和追问,但判断要由自己先形成。(2)把"做得好"写成标准。对自己最常做的几类工作,给出明确的验收标准和几个好的样例,这样 AI 才能在循环里自我修正,而不是每一轮都等着我来判断。同时也要看到,随着检验标准明确的工作被越来越快地替代,能够定义意图、写清标准的人,价值反而会更加凸显,这或许正是个人转型真正的方向。某种程度这也是需要每个人都按照管理思维来工作,而不是执行的思维。(3)把 AI 优先用在能力扩展上。与其在自己本来就熟练的事情上抠效率,不如用它去做以前做不到的事;同时,对省下的时间要有真实的记录,而不是凭感觉,。
对企业而言,逻辑是一样的,只是要上升到组织层面。一方面,要把散落在部门和员工经验里的流程、规则和业务知识显性化,变成系统可以调用的知识资产,这是组织层面的意图捕捉。另一方面,要建立验收和兜底的机制,并且按场景分级的思路,优先在检验标准明确、容错空间相对充足的高价值场景上落地,跑通之后再逐步扩展。此外,企业还需要对过渡期有清醒的预期,用真实的业务指标来衡量回报,而不是用"大家都在用"来证明价值,毕竟电力进入工厂,也是在组织完成重构之后才真正兑现了生产率。
作者提示:个人观点,仅供参考
参考文献
[1] Joel Becker, Nate Rush, Elizabeth Barnes, David Rein. Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity.
[2] MIT NANDA, The GenAI Divide: State of AI in Business 2025