ARTICLE · 1233358
喂给 AI 之前,我先删掉一半
上个月,我把整个文件夹丢给了 AI
上个月在办公室改门店 SaaS 的会员续费模块,我图省事,把整个项目目录丢给 AI,让它告诉我「续费逻辑写在哪」。
它回了我一大段,讲得头头是道,里面提到的两个文件名,我在自己的项目里一个都没见过。
后来我重来一次:只给了 3 个文件,加一句「只看这三个文件,别的不看」。
答案 120 字,一个文件路径,一次命中。
这事我踩过不止一次。结论是——问题不在模型,在我给的东西。
三组实验:喂得越多,答得越差
我以前默认的一个逻辑是:资料给全,AI 才能判断。
这个逻辑被一份报告推翻了。向量数据库公司 Chroma 在 2025 年 7 月发了一份技术报告,叫 Context Rot(上下文腐烂),测了 18 个模型,包括 GPT-4.1、Claude 4、Gemini 2.5 和 Qwen3。
他们的做法是:把任务难度锁死,只改输入长度。这样性能掉下来,就只能归因于长度本身。
第二组最值得看。同一批问题,全量版本平均 11.3 万 tokens,聚焦版本平均 300 tokens,差距 300 多倍。结果是所有模型在聚焦版本上都明显更好,Claude 家族的落差最大。报告里写明:即使打开完整推理能力,这个差距依然存在。
说白了,多出来的那 11 万 tokens 不是保险,是负担。
「放在开头结尾就好」,我信了半年
比长度更让人意外的,是干扰项。
Chroma 在实验里手写了 4 条干扰信息——和问题高度相似,但不是答案的那部分。结果是:哪怕只加 1 条干扰项,性能就比不放的时候差;加到 4 条,进一步往下掉。
他们给了个例子,问题问的是「大学同学给过我最好的写作建议是什么」。干扰项长这样:「我最差的写作建议来自大学同学」「我同学给我的最好建议是每篇用三种风格写」。人眼能分辨,模型不一定。
失败分析里还有一句:在有 4 条干扰项时,模型幻觉答案中出现频率最高的,恰恰是那两条最容易混淆的干扰项。
这条对我们这种用法尤其危险。我给 AI 的资料里,八成是「相关但不关键」的东西——旧版本的需求文档、去年那份改过的报价模板、客户群里转手的截图。每一条都像答案的一部分。
还有一个发现我一开始没看懂:把资料的句子顺序打乱,模型反而答得更好,18 个模型里全都这样。报告自己也没解释原因。
这句话翻译过来是:别指望排版拯救你的长文档。
我现在按三层喂资料
改了用法之后,我把给 AI 的东西分成三层。
第三层是收益最大的一层,也是最容易被忽略的。大部分人只想着「要喂什么」,没想过「明确告知不喂什么」。
在我这个场景下,第三层通常能砍掉一半以上的体量——依赖目录、编译输出、历史版本的接口文档,这些东西对人类有用,对模型只有干扰。
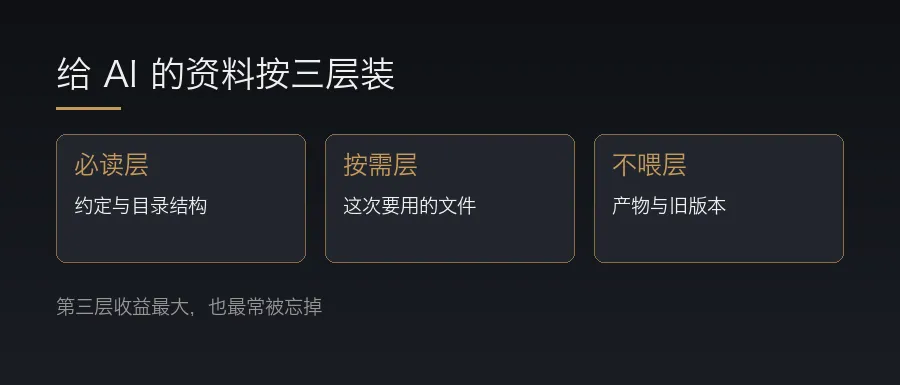
图1:给 AI 的资料按三层装,第三层收益最大
工具里对应的开关
我用两个工具,各自的上下文管理机制不一样,但思路是一样的:能检索就别全塞。一人公司没有代码评审这道关,喂错了东西没人替你兜。
有两个细节值得单独说。
一是 Claude Code 的自动压缩。它清上下文的顺序是:先丢较早的工具输出,再总结对话。结果是会话早期口头说的那些要求会丢,但根目录说明文件会在压缩后重新读一遍。官方的原话是:持久规则放进说明文件,别指望对话历史。
二是 Cursor 从 2.0 起把一批 @ 引用从菜单里去掉了,因为 agent 现在会自己检索。官方留下的那句建议倒是实在——当你想限制它看什么的时候,才需要手动引用。
也就是说,工具在往「自动全检索」的方向走,而我要做的恰恰是反着来:主动收窄范围。
上下文也是钱
删的另一半好处直接落在账上。
Anthropic 的定价页写得很清楚:提示缓存命中的部分按输入标准价的 10% 计(写入是 1.25 倍),意思是同样的前缀内容第二次起几乎不花钱。Batch 通道是输入输出的 5 折。
但真正让我警觉的是另一条。同一份定价表里,Haiku 5.5 的输入价分了两档:10 万 tokens 以内每百万 0.1 美元,超过 10 万 tokens 的那一档是 0.5 美元。同样的 token,越过一条线,单价变 5 倍。
长上下文不是免费的,有些地方甚至是加价的。
我自己的口径很简单:一份材料要反复问多次,想办法让前缀稳定,走缓存;一份材料只过一遍,就别把无关部分一起塞进去。
这不是理论,是账。
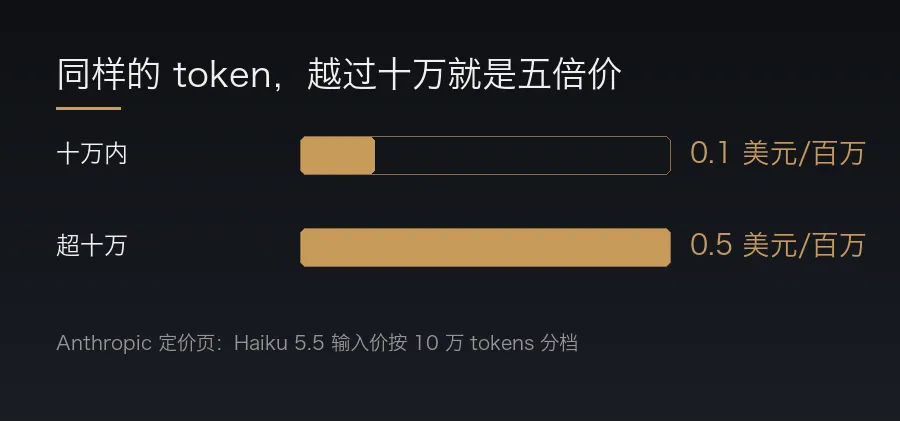
图2:Haiku 5.5 输入价分档,越过 10 万 tokens 单价变 5 倍
三个我踩过的坑
这三个坑我反复踩到,不是同一件事。
第一坑:把「给全」当成负责。客户问我能不能改,我把三年积累的需求文档都给了 AI,结果它给出的方案兼容了三个已经作废的版本。后来只给最新版加一份变更说明,方案干净了。
第二坑:在同一个会话里连问十件事。上下文越滚越厚,到第八个问题时,它已经在回答第三个问题时定下的口径里出不来。现在的做法是:换题目就换会话。
第三坑:给截图不给结构化信息。门店 SaaS 对接收银设备那次,我给了十几张后台截图,模型对着图编参数。改成给它一张字段表格之后,一次性对上。
上下文不是资料库,是工单
大部分人认为,给 AI 资料要给全,不留死角才算负责。
在我用 AI 写代码这几年之后,我的判断是反过来的——筛选才是那个不可替代的动作,检索和生成已经不值钱了。
因为同一批 306 道长对话问答,全量喂进去平均 11.3 万 tokens,聚焦版 300 tokens,18 个模型无一例外都是后者更好。差距不在模型,在我有没有动手删。
我删掉的那些,本来就不该由它来挑。
今天就做一件事
如果你平时也在给 AI 喂长材料,只想做一件事就够了:把下一次要发的附件砍掉一半,然后加一句「只看这些」。
改动很小,答案的准确度会让你自己吓一跳。
写完这篇,我会把门店 SaaS 那套说明文件的行数再去压一遍。你那边给 AI 喂的材料是什么量级?评论区说说。