ARTICLE · 1244301
PDF 转 Markdown:15 页 14 秒,公式能复制
★简括|这篇讲:我用 MinerU 在本地把一篇 15 页英文论文(编号公式 10 个、复杂表格 2 张、插图 5 张)转成 Markdown,实测了耗时、公式能不能直接编译、表格结构保不保得住,以及它跟pdftotext 的差距。
给你:能照着跑的命令、一组可以复算的数字、一张"该不该用"的决策表。读多久:约 8 分钟。口径:Windows 11 / RTX 4060 Laptop 8GB / MinerU 4.0.10,2026-10-23 本机实测。
01 起因:截图存论文,等于没存
我读论文有个坏习惯:看到有用的公式,截图;看到关键表格,截图。一年下来截图文件夹几千张,真要写东西的时候,还得一张张翻回去看,而且一个字都复制不出来。
这个痛点有三个层次,不是一回事:
下面这张图是我这次抽同一篇论文的结果,左边是 pdftotext抽出来的:公式的分子分母全散开了,表格的上标 10^19掉到了上一行。右边是这次要测的 MinerU。
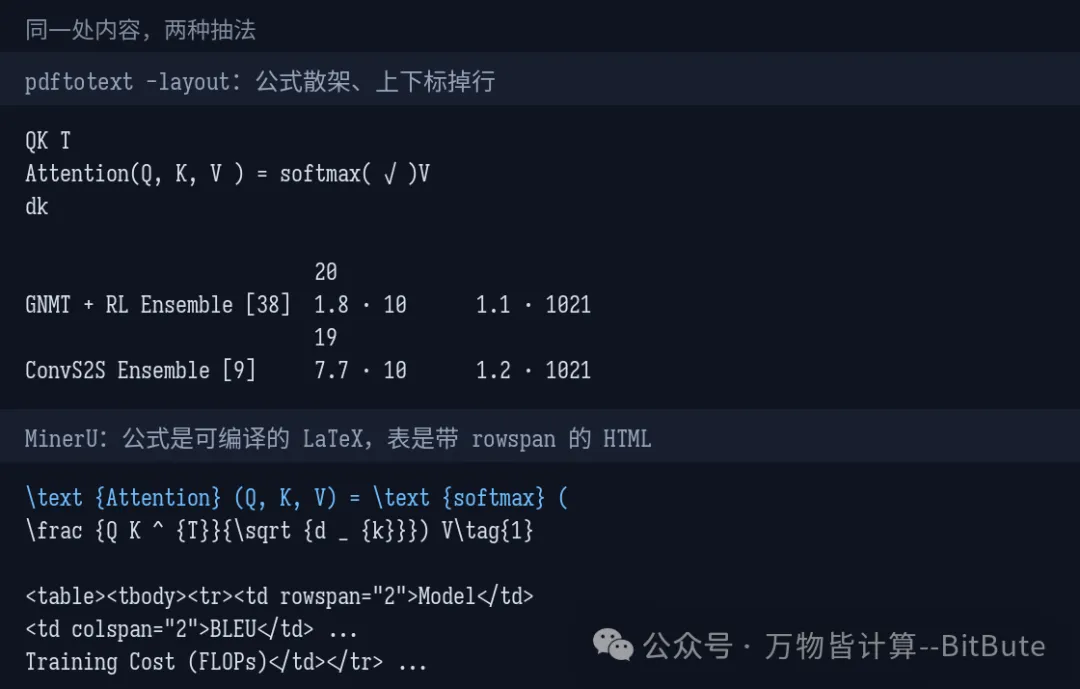
所以这次我不测"能不能转",而是测三件更要紧的事:公式能不能直接编译、表格是不是真结构、慢在哪里。
02 实测:15 页,14 秒
测试对象是一篇公开的 arXiv 论文(1706.03762,15 页,2.2 MB,双栏)。这台机器是 RTX 4060 Laptop(8 GB 显存),跑的是 standard 档:
| 14.0 s | 54.3 s | |
attn.md,1.1 MB | ||
| 10 个 | ||
| 2 张,输出为 HTML | ||
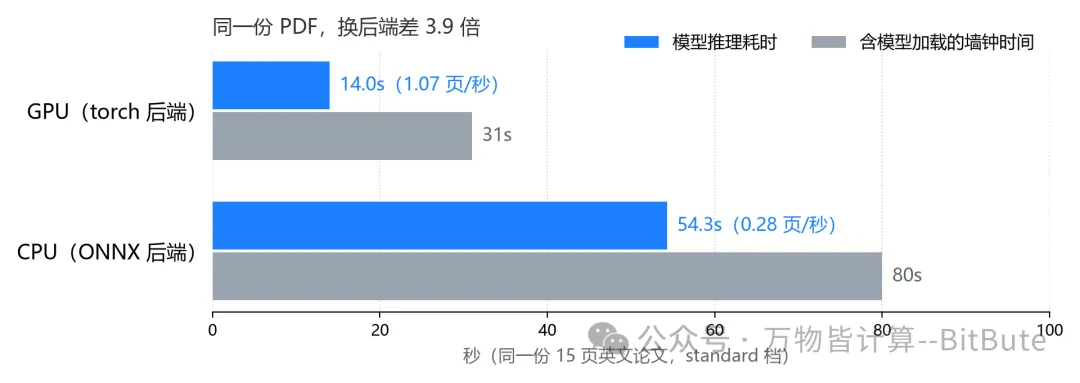
两个数字都有前提,不然会被当成普遍结论。第一,3.9 倍不是固定值:我 10 月初在一份 18 页中文论文上测,GPU 54 秒、CPU 402 秒,差了 7.4 倍。差别在于那份文件图多、公式密,小模型(版面检测、公式识别、OCR)工作量大,而 CPU 后端卡的正是这些。文件越“花”,倍数越难看。
第二,这 14 秒不含装环境。 第一次跑要下模型——我用du -sh ~/.mineru/models 量了一下,本地缓存 2.8 GB(2026-10-23);之后模型在本地,冷启动还要十几秒加载。也就是说:转一篇论文是 14 秒,但开一次程序是 30 秒。
输出是个单文件:图片不走 images/目录,直接 base64 内嵌。好处是拷走一个文件就是全部;坏处是 md 变 1.1 MB,某些编辑器打开会卡,也不适合直接进 Git。
03 公式:抠出来能直接编译
这是我最在意的一项,所以用了最笨的验证办法:把 md 里的公式原样复制进一个 .tex 文件,用 XeLaTeX 编译,看它出不出得来。
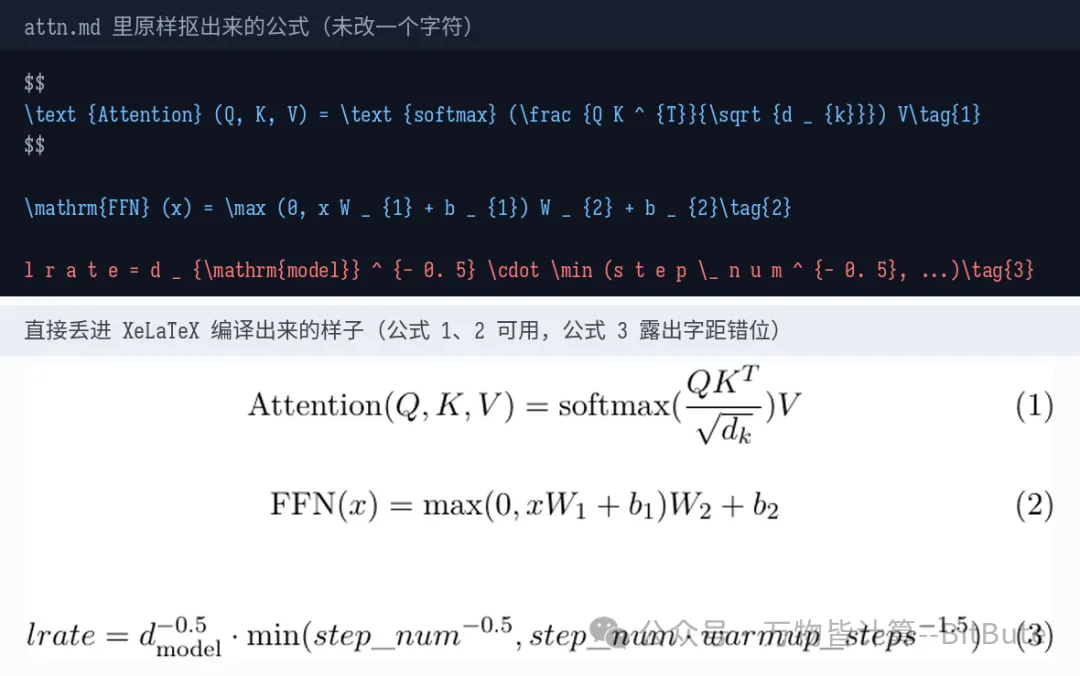
三条公式里,前两条(注意力、前馈网络)编译后和原论文几乎一样:分式、根号、上下标、正体函数名都在。第三条翻车了——l r a t e被拆成单个字母并排,step_num 变成了斜体变量。原因是 PDF 里那行字的字符间距被逐个记录,抽取时按"每个字符都是独立文本"理解,于是把lrate 拆成了 l r a t e。
这种错不是公式识别错,是字符层信息就长这样,只能靠后处理(把连续单字母合并)修。我这次的 10 个公式里,2 个有这类毛病,其余 8 个可用。
行内公式的保留度值得单独说:正文里 700 多处 $d_k$这种都被包成了 LaTeX。做笔记时这一点比块公式更有用——你复制一整段话,符号不会丢。
04 表格和图:结构保住了
表格是最容易"看起来对、其实错"的部分。用pdftotext -layout抽出来的表格,肉眼看着还行,但它只是空格对齐:
20GNMT + RL Ensemble [38] 1.8 · 10 1.1 · 1021 19ConvS2S Ensemble [9] 7.7 · 10 1.2 · 1021上标 10^19 掉到了上一行,3.3 · 和10^18 被拆到两处。这种文本粘进 Excel 是一堆错列。
MinerU 那边输出的是 HTML 表格,rowspan/colspan 都在:
<table><tbody><tr><td rowspan="2">Model</td><td colspan="2">BLEU</td><td colspan="2">Training Cost (FLOPs)</td></tr><tr><td>EN-DE</td><td>EN-FR</td>…这意味着粘进 Markdown 编辑器、Typora、甚至网页里,合并单元格都还在,能直接当数据用。
三种抽法摆在一张表里看,差别就很直观(同一篇 15 页论文,本机实测):
pdftotext -layout | ||||
| 可编译的 LaTeX | HTML 表格 |
插图是整页裁出来的位图(公式图、架构图都在里面),清晰度跟原 PDF 一致——因为它就是原页的一部分,没做重绘。
05 装它:命令三行,坑两条
MinerU 是开源的(GitHub 8.2 万星,2026-10-23 查得),许可证是 Apache-2.0 加附加条款:商用免费,但月活超过 1 亿或月收入超过 2000 万美元要单独授权。个人和小团队不用管这条。
# 用独立的虚拟环境,别装进系统 Python(会污染 torch)python -m venv pdfenv && source pdfenv/bin/activate # Windows: pdfenv\Scripts\activatepip install -U "mineru" # 不要装 mineru[full],见下面坑 1# 转一篇MINERU_MODEL_SOURCE=modelscope \mineru parse paper.pdf -o out --tier standard两条 Windows 坑我都是撞过才知道:别装mineru[full](依赖的推理引擎没有 Windows 轮子,装到一半就报错,装基础版会自动退到 llama.cpp,一样吃显卡);模型下载源改成魔搭(默认拉 HuggingFace,国内基本卡死)。
档位也别乱换——这是我手里两台机器、两种文件类型的实测(standard 为质量档):
口径:那组数据 2026-10-03 在另一台机器(同为 4060 Laptop 8GB)上跑同一份中文论文得到;本文第二节的 14 秒是今天这份 15 页英文论文。两组合在一起看,结论是文件越“花”(图多、扫描、公式密),CPU 与小模型的劣势越明显。
06 它错在哪:三个我遇到的
lratel r a t e;step_num变斜体 | ||
<small><span>块,堆在段落结尾 | ||
multiplicativemulti plicative |
这三类错误有个共同点:都在字符层,不在语义层。所以拿它做“检索 + 粗读 + 喂给 AI”完全够用;拿它做“逐字引用”就得自己再过一遍。
再来一个实际用法,转完就可以直接检索公式了:
# 在转好的 md 里找一个符号出现在哪些论文、哪一段grep -rn '\\frac { Q K' out/*.mdgrep -rn 'softmax' out/*.md | head07 什么时候别用
比上面的优点更值得看的是三条红线:
\tag{1}只是文本不是交叉引用;写综述要标“第 5 页式 (12)”还得翻 PDF | |
pdftotext |
第二条是我在 8 GB 显存的笔记本上折腾它的最主要原因:不上传、不联网,全是本地算(本文实测机器:RTX 4060 Laptop 8 GB / Windows 11,2026-10-23)。
08 该不该用:一张表
| 用 | ||
| 用 | ||
| 用 | ||
pdftotext | ||
如果你在上面打了三个以上“用”,这套东西值得花半小时装一次;如果一年读五篇,直接复制粘贴更快。
一句话总结
MinerU 的价值不是"把 PDF 转成文字"——那件事十年前就能做;而是把公式变成可编译的 LaTeX、把表格变成带结构的 HTML、把扫描件变成有文字层的文本,并且全程在你自己的硬盘上。它的错误集中在字符层(间距、断词、脚注),做检索和粗读时几乎无感,做逐字引用时得自己复核。
如果你每个月要读十篇以上的论文,这套东西值得花半小时装一次;如果一年读五篇,直接复制粘贴更快。
# 三条命令记住就够mineru parse paper.pdf -o out --tier standard # 转一篇mineru parse papers/ -o out --tier standard # 转一个目录open out/paper.md # 结果是一份 md + 内嵌图片脚本与模板自取:后台发「pdf2md」,给你我这次用的批量脚本(断点续跑、已转过的自动跳过、转完自动修脚注块),以及一份 15 页论文的完整输出样例(含 10 个公式与 2 张表),可以直接拿去对比效果。
说明:本文的耗时、体积、公式编译结果都是在本机跑出来的真实数据,可复算。个人观点,仅供参考。