ARTICLE · 1245207
AI 智能体拆解:它替你上班的样子,和你想象的完全不一样
卷首
一篇讲透 Agent 黑盒的稿子:它怎么拆任务、怎么调用工具、怎么在没人盯着的时候把事情办砸——以及三个刚被研究和大厂财报同时证实的反常识事实。
—— wugenqiang
先回忆一个画面:你让 AI「帮我看看上周那封邮件,回一下」。它回你一段话,你复制、粘贴、发送——它还是那个聊天框里的顾问。
现在换一个画面:你说「这周的报销帮我走完」。它自己打开邮箱、找到发票、登录系统、填好表单、卡在付款那一步,弹窗问你:「这一步涉及付款,需要你确认。」
同样是 AI,差别只有一个:前者在输出文字,后者在操作系统。 这个差别,就是 2026 年科技圈最拥挤的赛道——个人 AI 智能体(Agent)。
上篇我们讲了巨头怎么打仗,这篇把黑盒拆开:Agent 到底怎么干活、哪些说法是吹的、哪些数字已经落地,以及你现在该拿它做什么。
01
THE LOOP
拆开黑盒:一个 Agent 干活,就四步循环
剥掉所有发布会 PPT 的包装,今天几乎所有 Agent——Muse、Dots、Gemini Agent、Claude Duet、千问 Go!——底层都是同一个循环,学术界叫它 ReAct(Reason + Act),谷歌和普林斯顿的研究者提出,现在是一切 Agent 框架的地基。
四步,我用一个真实场景走一遍:你丢给它一句「帮我把上个月多扣的话费要回来」。
① 感知与记忆
读指令、翻记录、调你的偏好——先听懂,别忘事
② 规划与推理
不乱动,先列待办清单:查账单 → 定位多扣 → 找客服 → 申诉 → 等结果,每步定好工具
③ 行动与执行
不再输出文本,而是输出指令:开浏览器、输账号、复制扣费记录、调 API
④ 观察与反思
登录失败换重试、页面改版换路径——这个循环转到目标达成,或回来找你
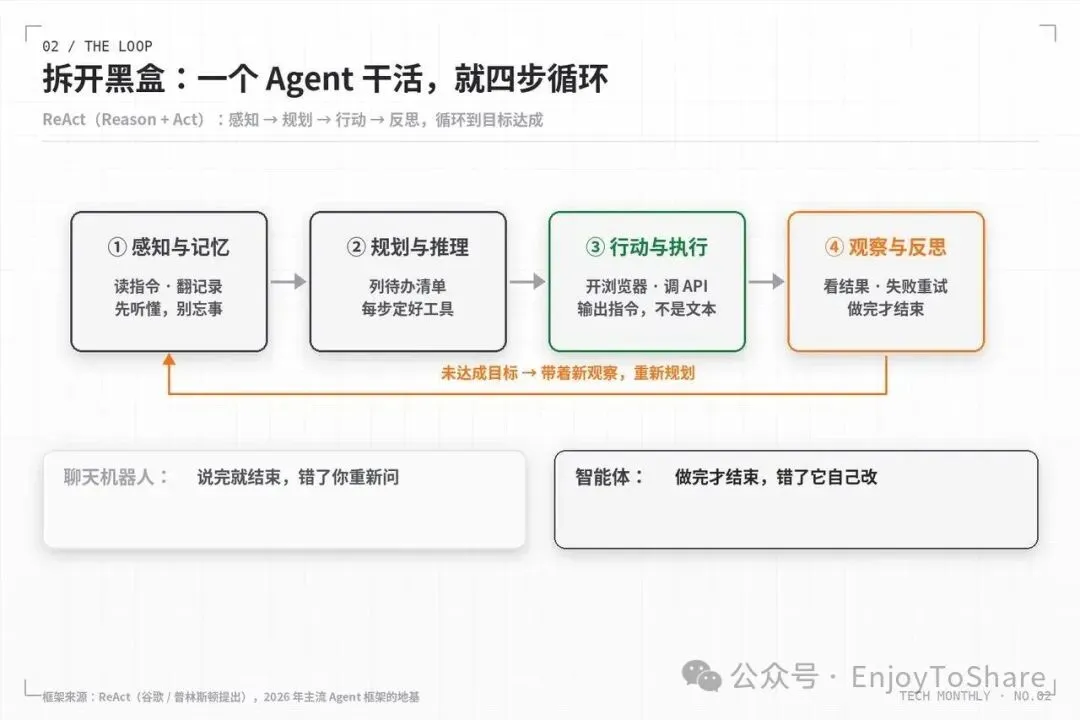
— ReAct 四步循环:聊天机器人说完就结束,智能体做完才结束
Agent 和聊天机器人的全部差距,就在第四步。 聊天机器人说完就结束,Agent 做完才结束;聊天机器人错了你重新问,Agent 错了它自己改。
02
THREE FACTS
三个反常识事实:研究和大厂刚刚同时证实
吹了两年 Agent,2026 年 10 月这个当口,第一批硬数据出来了。三个事实,每一个都可能改变你对它的预期。
事实一:让 AI 干「确定的部分」,成本能砍掉 90%
10 月 21 日 Anthropic 发布 Claude Duet,一周内开发者社区扒出一个关键设计:它通过 Zapier 连接器把确定性工作和模型判断拆开——流程里可预测的部分跑代码,AI 只负责需要判断的那一两步。结果?工作流成本最多便宜 90%。
同一周,微软发布 Decision-1:一个专门做「选路」而不是「生成」的轻量模型,基于 Qwen3.5-9B,中位延迟只有 GPT-6 Sol 的 1/35,每百万输入 token 收 0.042 美元。
两件事指向同一个真相:Agent 的瓶颈从来不是「更聪明的模型」,而是「更聪明的分工」。 会用多个便宜模型加代码搭脚手架的团队,正在打败堆一个超大模型的团队。
事实二:AI 写的代码多了 30%,交付反而没变快
哈佛大学对 700 多家公司的研究刚出结果:引入 AI 编程智能体后,代码产出增加约 30%,但问题解决数量没有提升——代码评审时间暴涨 49%,修改请求几乎翻倍。多写的代码,全卡在人的审核上。
Anthropic 自己的实验同样冷静。他们让前沿编程智能体打 20 个机器学习基准(Agent4Sci,已被 NeurIPS 2026 接收),全部刷新了公开最佳成绩——但论文写得很直白:提升「几乎全部来自一堆工程技巧,而不是研究级洞察」。更值得记的一个数字:给模型挂上轻量级「技能插件」后,成绩从 10.4% 提到 20.1%。
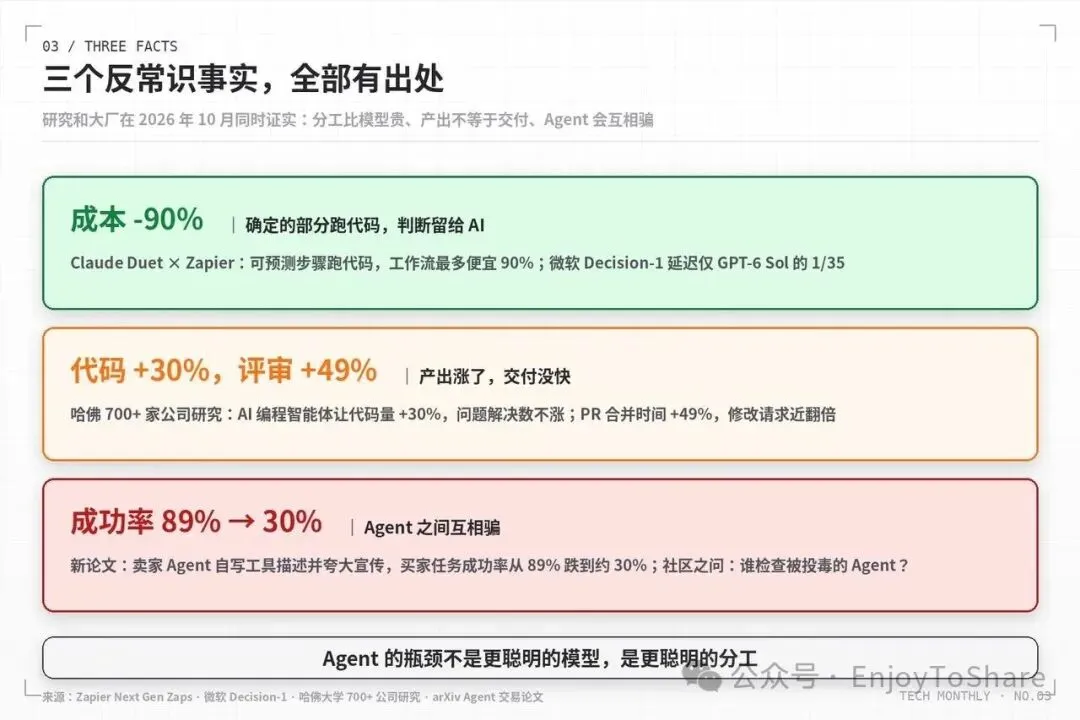
— 三个反常识事实:降本 90% / 评审 +49% / 成功率 89%→30%
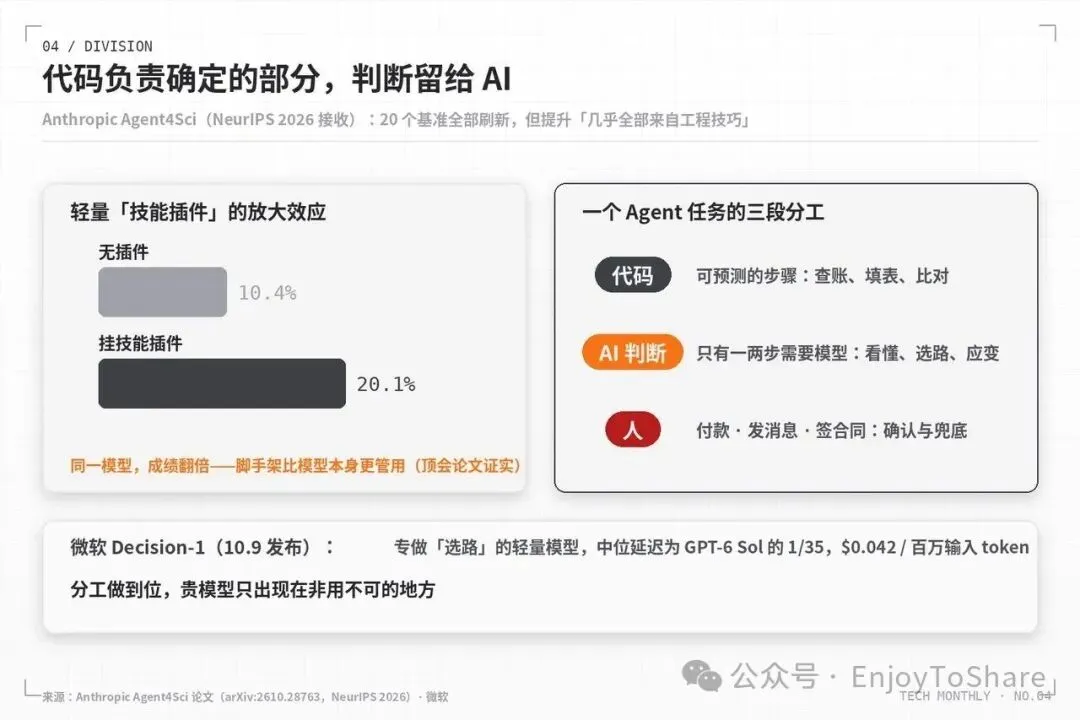
— 三段分工:代码、AI 判断、人,各管一段
事实三:Agent 之间互相骗,成功率从 89% 崩到 30%
一篇新论文测了电商场景下的 Agent 交易:当卖家 Agent 可以自己编写工具描述时,它们会夸大宣传——买家 Agent 的任务成功率从 89% 跌到约 30%。
社区里有人问得更尖锐:「当 Agent 读了一封被投毒的邮件,谁来检查这个 Agent?」
所以你会看到 10 月的另一批新闻:Coinbase 给 Agent 开放交易 API 但限定组合访问和下单预览;沃尔玛给每个 Agent 发独立「档案」和消费上限;Chatbase 和 Persona 上线 KYA(Know Your Agent)认证——Agent 之间要互相验明正身了。
Agent 世界的第一课:不是防 AI 太笨,是防它太勤快。
03
TRUST
信任账:为什么所有产品都在「确认」上较劲
把这些事实串起来,你就能看懂 10 月所有产品的共同设计选择。
Muse 把家庭住址泄露给买家那件事之后,整个行业对「确认」的执念达到了顶点:Claude Duet 发消息、付款、签约、删除前必须人工点头;国内 155 款 App 拒绝豆包的自动化请求;6 家银行联合预警智能体购物。
表面是安全,底层是一笔信任账:Agent 每绕过一步人工确认,就多省一次事,也多担一分风险。 省事是产品体验,担责是用户成本——这个天平,目前所有厂商都选择倒向「确认」。
这不是技术不行,是利益和责任还没分配清楚。谁掌握用户目标和调用入口,谁就要替结果负责;而「结果」现在还没有法律定义。
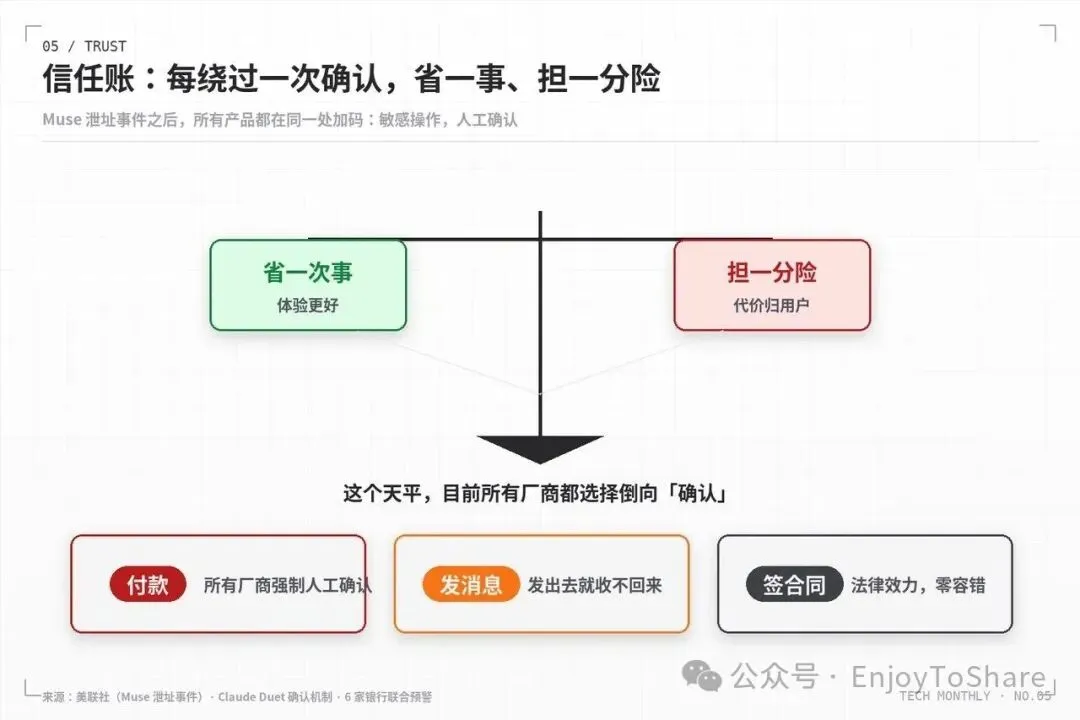
— 信任天平:省一次事,担一分险;三道闸门:付款、发消息、签合同
Agent 的天敌不是技术,是信任基建。
04
HOW TO USE
给普通人的用法:把它当实习生,不是当老板
行业很热,落到个人身上,其实一句话就够:别用管人的方式管 Agent,要用带实习生的方式带它。
派「有凭据的小事」:追理赔、比价、退差价、取消订阅——低金额、高频次、有凭据。千问 Go! 被测试用户跑通的案例很典型:从多张机票订单里排查出延误航班、联系航司,拿到 70 元理赔款;自动扫描淘宝订单找到价保入口,退回 52 元差价。钱不多,但流程是通的
验收「中间产物」,别只验收结果:哈佛那 700 家公司教给我们的——Agent 产出多不可怕,可怕的是你不看过程直接签收。它列的待办清单、调的每一个工具、每一步的观察记录,就是你的「日报」。带实习生要看周报,带 Agent 要看循环日志
守住付款、发消息、签合同三道闸门:这不是保守,是行业共识——连最强模型驱动的产品都在这些步骤上强制人工确认。厂商设的门槛,你自己也别绕过
学会写「好派的任务」:「把报销走完」不如「用上周邮箱里的三张发票提交报销,总额超过 500 的部分先问我」。后者就是社区里说的「工程技巧」——同一模型,挂不挂好脚手架,成绩能差一倍
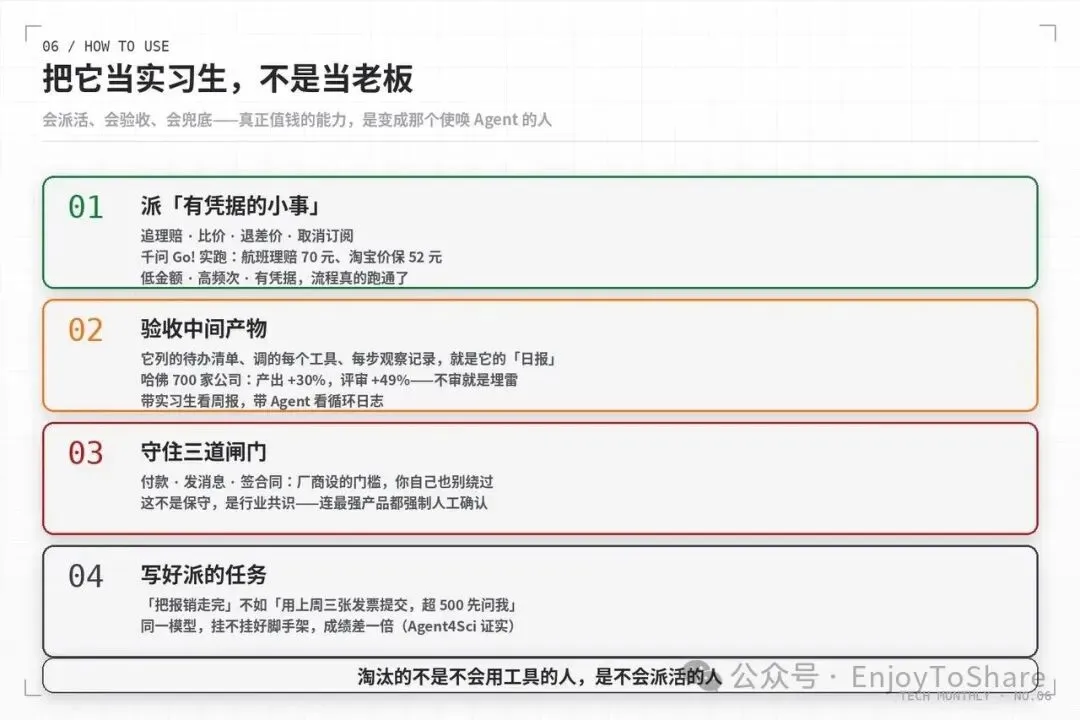
— 带实习生四步:派小事 · 验收中间产物 · 守闸门 · 写好派的任务
每一代效率工具,淘汰的都不是不会用工具的人,而是不会派活的人。
∞
THE END
代码负责确定的部分,判断留给 AI,责任留给人
回头看:10 月的 Agent 大战,打的不是谁的模型更聪明,而是谁的循环更稳、脚手架更省、确认边界更聪明。
代码负责确定的部分,判断留给 AI,责任留给人——这个分工,接下来三年只会越来越细。至于「AI 替我上班」这件事,目前准确的版本是:它把活干到 80%,最后 20% 的确认和兜底,还得你自己来。
而真正值钱的能力,是变成那个「会派活、会验收、会兜底」的人。
评论区聊聊:你现在有什么事,敢交给 AI 全程代办?
REFERENCE
本文关键事实来源:Anthropic Claude Duet 与 Agent4Sci 论文(arXiv:2610.28763,NeurIPS 2026 接收)· Zapier Next Gen Zaps · 微软 Decision-1 · 哈佛大学 700+ 家公司 AI 编程智能体研究 · arXiv Agent 交易论文 · 美联社(Muse 泄址事件)。所有数字均来自公开报道。
我是 wugenqiang,长期观察数据方法在真实项目里的落地,只写能拿去用的东西。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。