ARTICLE · 1247500
AI Infra 早报|OpenClaw 把并发失败改成排队等待
📅 2026-10-24
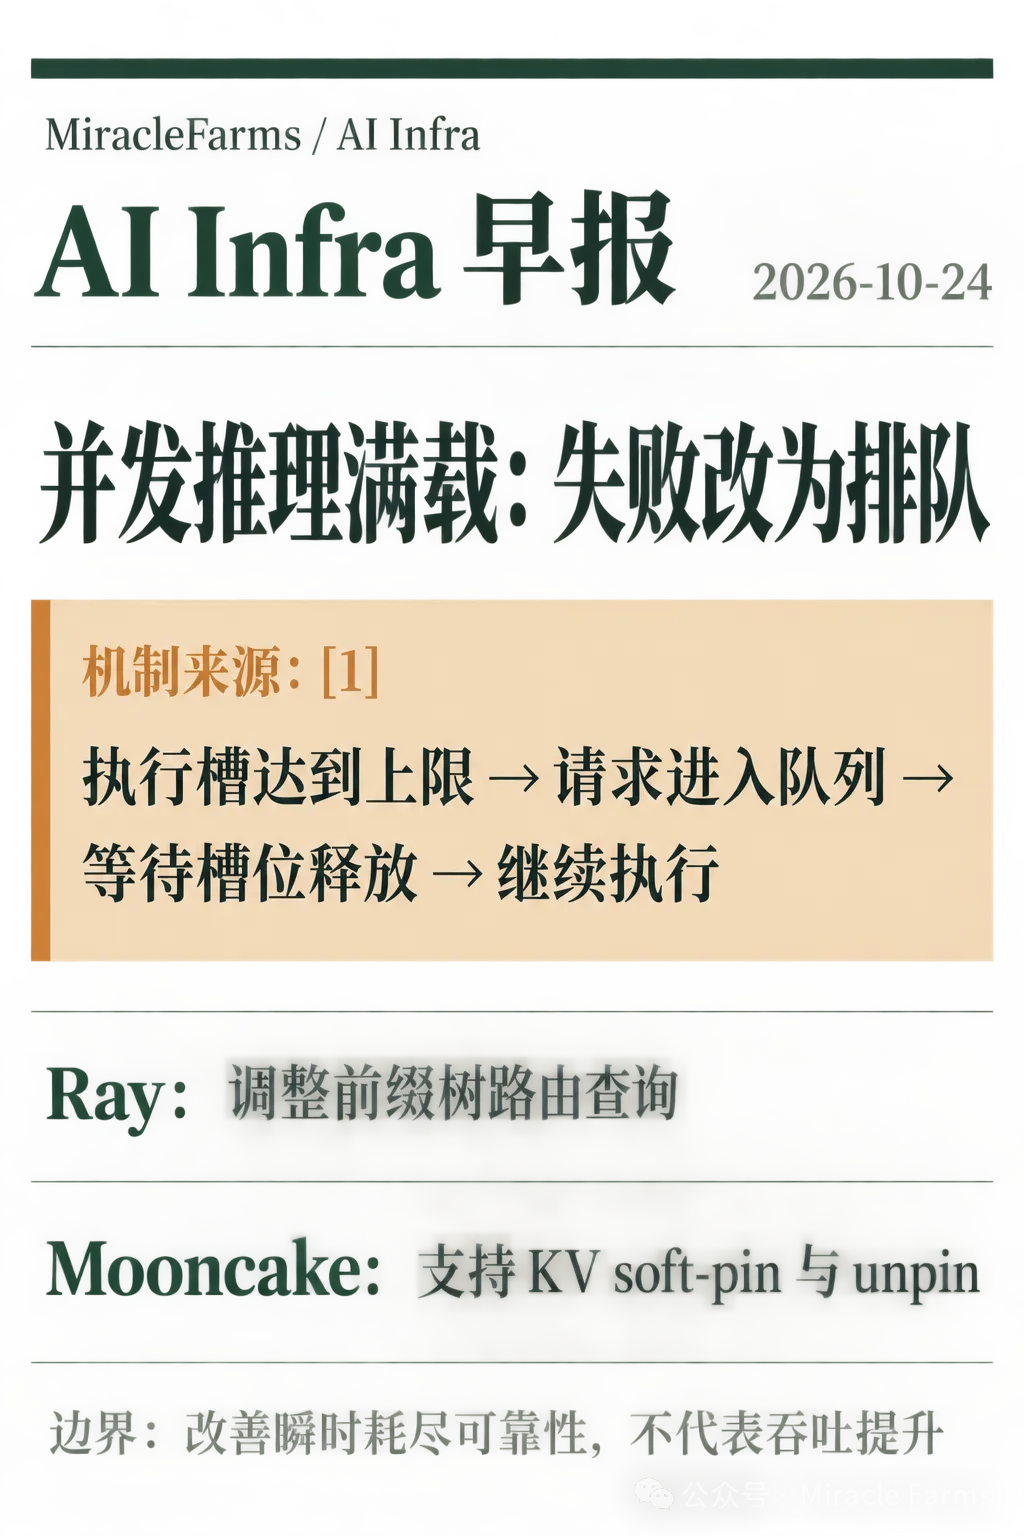
当多个 Agent 同时调用本地推理时,容量用尽不一定只能失败。今天的变化值得关注,因为 OpenClaw 正在把这类瞬时并发问题改成可观察的等待。
先看三条信号
Agent|已合并。 OpenClaw PR #181895 让达到本地推理并发上限的请求进入排队,具体队列上限、超时和公平性策略仍未说明。[1]
推理路由|已合并。 Ray PR #66671 调整前缀缓存路由,目标是不再让前缀树查询同步阻塞路由事件循环;异步实现和正式 release 尚未说明。[2]
KV Cache|已合并。 Mooncake PR #4858 增加对已有 KV 对象的 soft-pin 和 unpin 控制,命中率、容量收益及 release 状态仍待验证。[3]
只展开一件事:并发推理达到上限后,为什么要排队
多 Agent turn 同时运行时,Gateway 需要限制顶层推理执行单元的数量。原来的处理方式是容量用尽就记录错误,让当前 turn 直接失败。短时并发峰值因此会被用户感知为一次失败,即使稍后可能已有执行单元完成并释放资源。
OpenClaw 这次已合并的改动,把资源不足时的动作换成排队。这里的“推理根”可以理解为一个父会话下受并发限制管理的顶层执行单元;“排队”则意味着请求先等待可用槽位,再继续执行。它改善的是容量瞬时耗尽时的可靠性,当前材料没有证明吞吐量或平均延迟已经提升。 [1]
这其实是把失败边界向后移动:请求失败率可能下降,但等待时间会进入用户体验。如果队列没有明确的超时、容量和公平性策略,高峰期请求可能从快速失败变成长时间等待,尾延迟也可能上升。来源只确认了排队行为,尚未给出这些运行规则,因此不能把它写成完整的生产级调度方案。
对使用 OpenClaw Codex app-server harness 的多 Agent 工作流来说,下一步要看的不是“是否已经排队”,而是排队后是否真的减少了 inference-root failure,以及等待时间是否超过任务可接受的超时。系统的监控重点也会从失败日志扩展到队列长度、等待时长和超时率。
接下来关注
后续 release 是否收录这项改动,以及高并发下排队等待时间和失败率如何变化,将决定它对真实 Agent 工作流的意义。Ray 需要观察路由事件循环等待时间,Mooncake 则要看 soft-pin 是否在提高复用率的同时带来过高的容量占用。已合并不等于已经完成生产验证。
一句话结论:OpenClaw 把并发耗尽从立即失败改成等待,但队列规则和真实收益仍待验证。
更多完整证据和技术细节,请点击文末“阅读原文”。
参考
[1] OpenClaw PR #181895:https://github.com/openclaw/openclaw/pull/181895
[2] Ray PR #66671:https://github.com/ray-project/ray/pull/66671
[3] Mooncake PR #4858:https://github.com/kvcache-ai/Mooncake/pull/4858
Less hype · more systems.
MiracleFarms · BRIEF · DAILY