ARTICLE · 1248094
64%,AI 自我改进剩下的最后一格
本文是「ROBO PULSE」论文精读系列。每期拆一篇具身智能与 AI 前沿论文,先看懂,再判断。
Anthropic 把一个科幻问题放上了秤。过去三十年,关于「AI 会不会自己造出更强的 AI」,正反双方吵了几千个回合,谁也拿不出证据。相信的人说指数曲线终将兑现,怀疑的人说还早得很。2026 年,Anthropic Institute 的两位署名者 Jack Clark 与 Marina Favaro 换了一条路子,不辩论,直接把自家公司里 AI 干活的全部数据摊开,逐项给出比例和速度。这份报告的名字叫《When AI builds itself》,数据截至 2026 年 5 月,9 月又更新了一次。
先交代说话人的位置。Jack Clark 是 Anthropic 联合创始人,2016 到 2020 年在 OpenAI 做政策总监,2020 年参与创立 Anthropic,既管研究议程也管对外传播。Favaro 是 Institute 研究员,本行是 AI 安全治理与国际军控,文末拿中导条约类比 AI 治理,正是她的专业。两位都来自数据出具方,这一点记住,后文要反复用到。
报告里有一句话值得抄下来。原文说,「我们还没到那一步,递归自我改进并非必然,但它到来的速度,可能比大多数机构的准备更快。」这不是预言,是提醒。
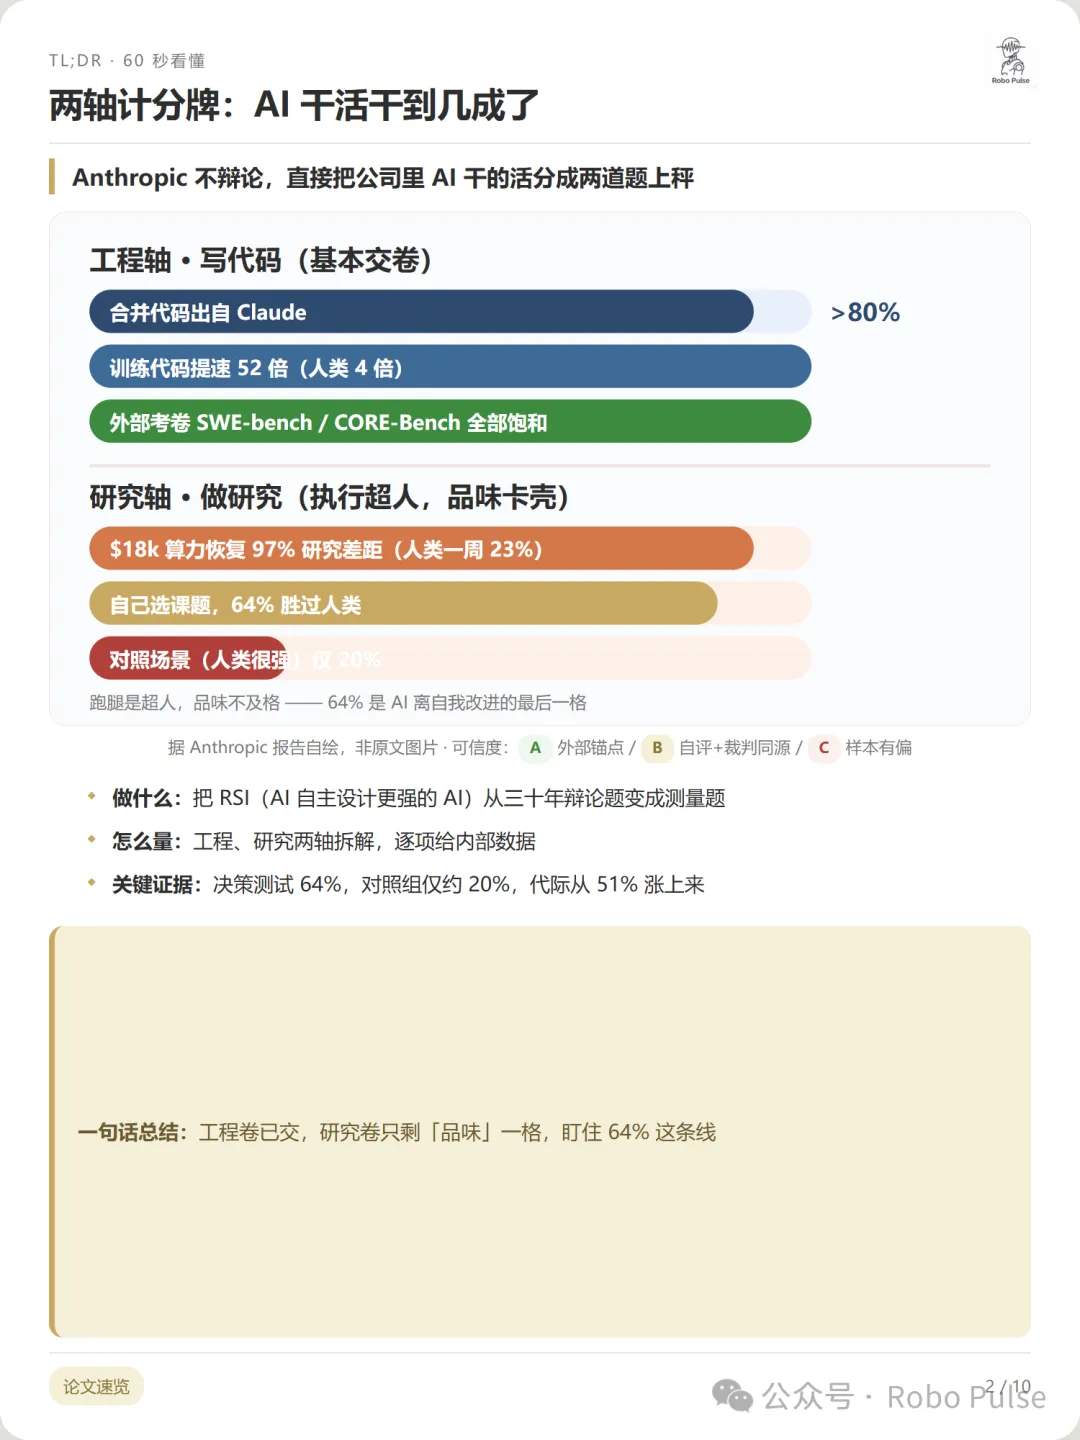 图1|AI 自我改进的两轴计分牌(据 Anthropic 报告自绘)
一、什么叫「AI 自己造自己」
行话叫 RSI,递归自我改进,定义只有一句话,AI 系统能完全自主设计并开发自己的后继者。通俗地讲,学徒自己带出比自己更强的师傅,一代比一代强,进步速度从此由 AI 决定。这句话听起来还像科幻,但拆开看它的两个必要条件,会发现条件之一已经成立了。条件一是 AI 能干完研发流程里的活,条件二是 AI 能自己决定干什么活。这份报告做的事,就是给这两个条件分别打分。
先看条件一的历史。2021 年到 2023 年,Anthropic 的工程师还在手敲每一行代码。2023 到 2025 年,大家用聊天机器人问问题,把答案片段贴进项目。2025 年,AI 已经能一次写完整个文件。现在,Claude 可以自主运行代码,还能把一个几小时的任务委托给另一个 AI。原报告画了一条演进线,线的尽头是那个还没发生的场景,Claude 改进 Claude。
五年前这还是哲学课的题目。现在,Anthropic 把它拆成了两道可以打分的题,一道叫工程,写代码、搭基础设施、跑训练;一道叫研究,选题、设计实验、解读结果。两道题的分数,差得有点离谱。
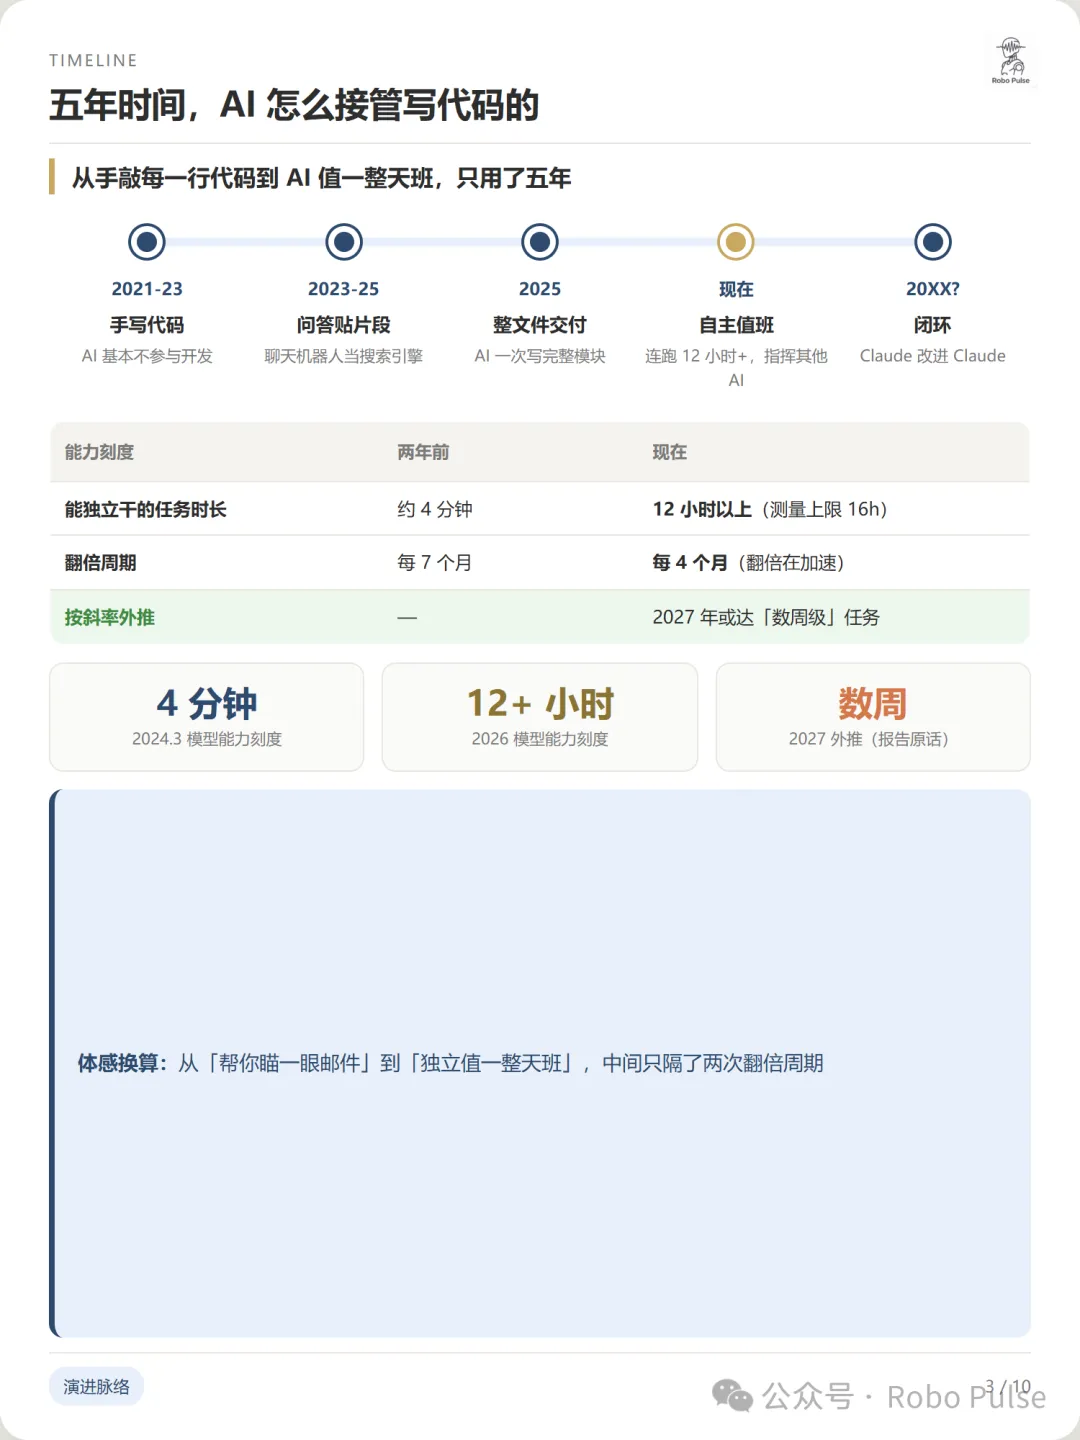 图2|AI 接管写代码的五年演进(据 Anthropic 报告自绘)
二、工程账,八成代码已经易主
第一道题的答卷,三个数字。
第一个数字,80%。Anthropic 统计了公司代码库里被合并进主干的代码有多少出自 Claude。2026 年 5 月,这个比例超过八成。而在他们的 AI 编程工具 Claude Code 发布之前,也就是 2025 年 2 月之前,这个数字还是个位数。打个比方,一个团队的新同事,一年多时间从打杂干到了承担八成工作量。工程师的整体产出也水涨船高,2026 年二季度交付的代码量是 2024 年的 8 倍。
第二个数字,52 倍。同一个优化训练代码的任务,人类工程师提速约 4 倍,耗时 4 到 8 小时;最新模型提速 52 倍。你一整天的工作,它几分钟交卷。一年前的模型在同一道题上只能提速 3 倍,一年 17 倍的斜率,就是「翻倍在加速」四个字的具体模样。
第三个数字最容易被忽略。一次数万个训练任务集体崩溃,人类工程师通常要排查 2 到 3 天,Claude 用了约 2 小时,病根是一个冷门的调试开关。2026 年 4 月它一次性交付 800 多个修复,把一类 API 错误的发生率压到原来的千分之一,人类团队估计这需要 4 年。还有复盘能力,让 Claude 事后复查 claude.ai 的历史事故,它能揪出其中约三分之一的问题。
自家的数字可能自夸,外部考卷可以交叉验证。学界常用的两块试金石,SWE-bench 考真实软件问题,两年内从个位数得分做到饱和;CORE-Bench 考复现科研计算,从 2024 年的约 20% 到 15 个月后饱和。更值得盯的是速度本身,AI 能独立完成的任务时长每 4 个月翻一倍,一年前这个翻倍周期还是 7 个月。换算成体感,2024 年初的模型只能干 4 分钟的活,帮你瞄一眼邮件;现在的模型能连续干 12 小时以上,独立值一整天班。原报告按这个斜率推算,2027 年可能出现能独立干几周任务的 AI。
工程这一摊,AI 已经交卷。但 Anthropic 自己发现了一个新麻烦,代码生成太快,人类审查不过来了。瓶颈开始搬家。
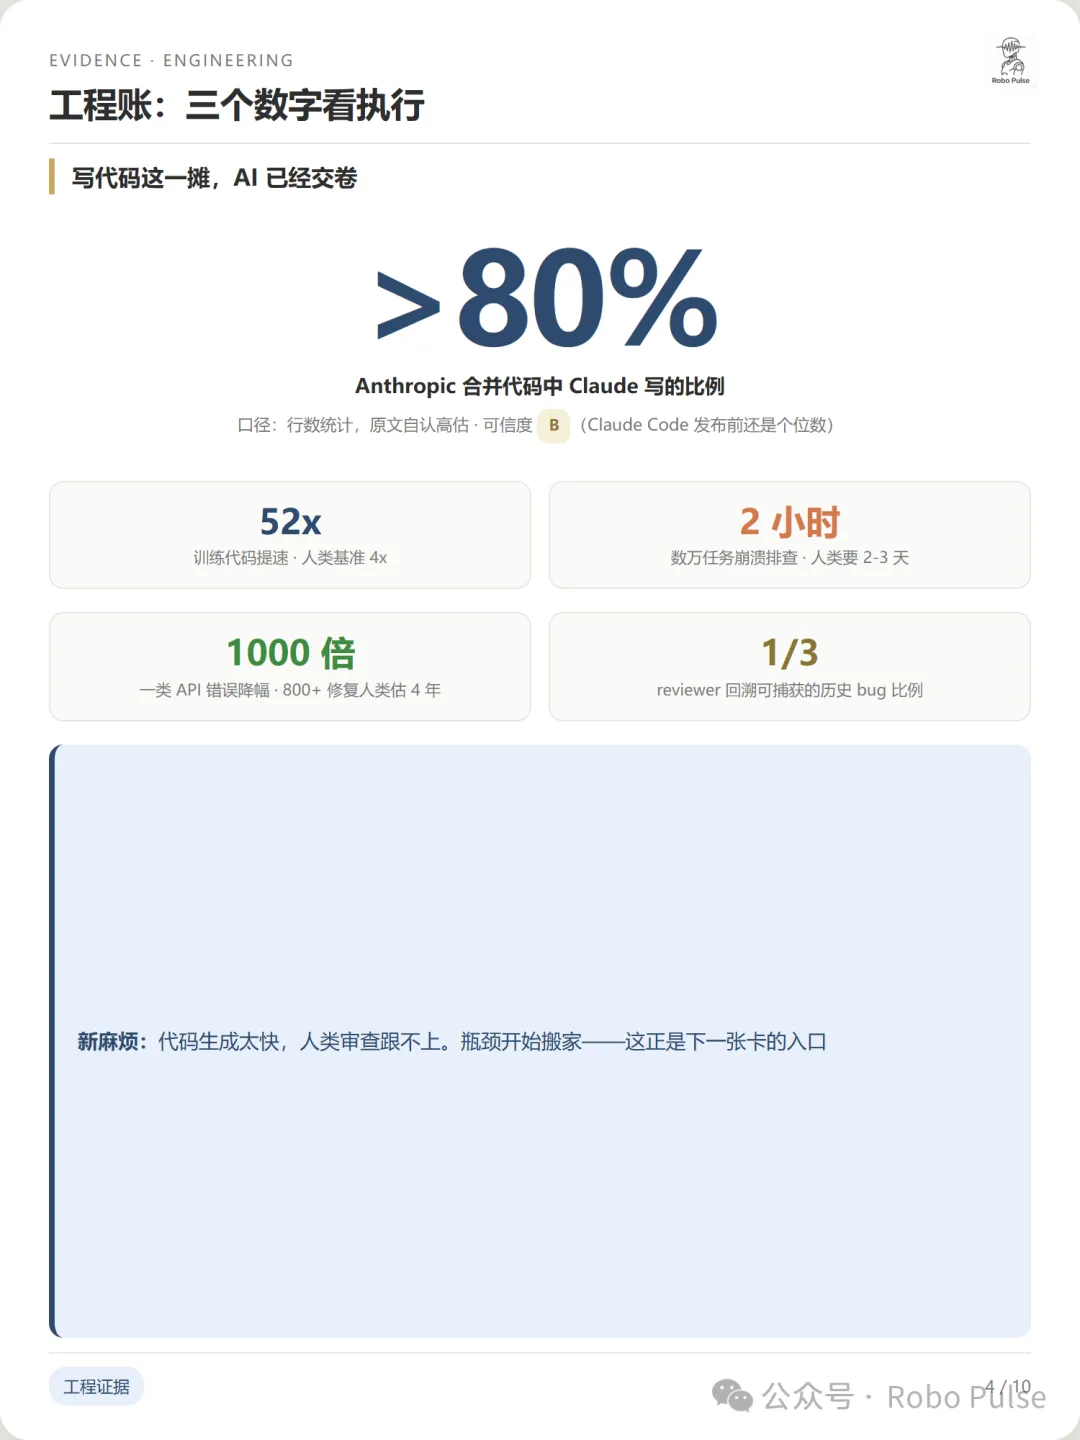 图3|工程账:三个数字看执行(据 Anthropic 报告自绘)
三、研究账,跑腿是超人,品味不及格
第二道题更有意思,Anthropic 又拆成了两问。
第一问,按别人定好的方案做实验,行不行。答案已经写在上面的 52 倍里。还有一组更颠覆的实验,行话叫 weak-to-strong,让 AI 接手一个开放研究课题。两个人类研究员干一周,只恢复了 23% 的性能差距;换成 AI 系统跑累计 800 小时,恢复了 97%,总成本约 1.8 万美元算力,一台顶配笔记本电脑的钱。这个数字的产业含义可能被严重低估,它意味着用 AI 自动做研究的门槛,第一次降到了个人可负担的水平。高校实验室、小团队、独立研究者,都雇得起一群 AI 研究员了。
第二问才是全文的题眼。让 AI 自己决定做什么实验,行不行。
Anthropic 设计了一个「下一步决策测试」,在 129 个人类研究员实际绕过弯路的时刻,让 AI 选下一步该做什么。AI 选对了 64%,上一代模型只有 51%,代际进步是真实的。听着不错?换成人类已经很擅长的场景,对照组 127 题,AI 只有约 20% 的情况比人类选得更好。
翻译成人话,跑腿已经是超人了,但「什么值得做」的品味,还差一大截。这个差距有个行话叫 research taste,研究品味。同一堆数据,有人能挑出好问题,有人只是瞎忙;同样的实验结果,有人读出线索,有人读出死胡同。这种品味,目前还是人类研究员最后的阵地。现状的分工其实已经定型,代码质量持平之后,人类工程师停止写代码,只做审查;审查被 AI 部分接管之后,人类退守选题与验收。每一轮收缩,人类都退到更靠判断力的位置上。
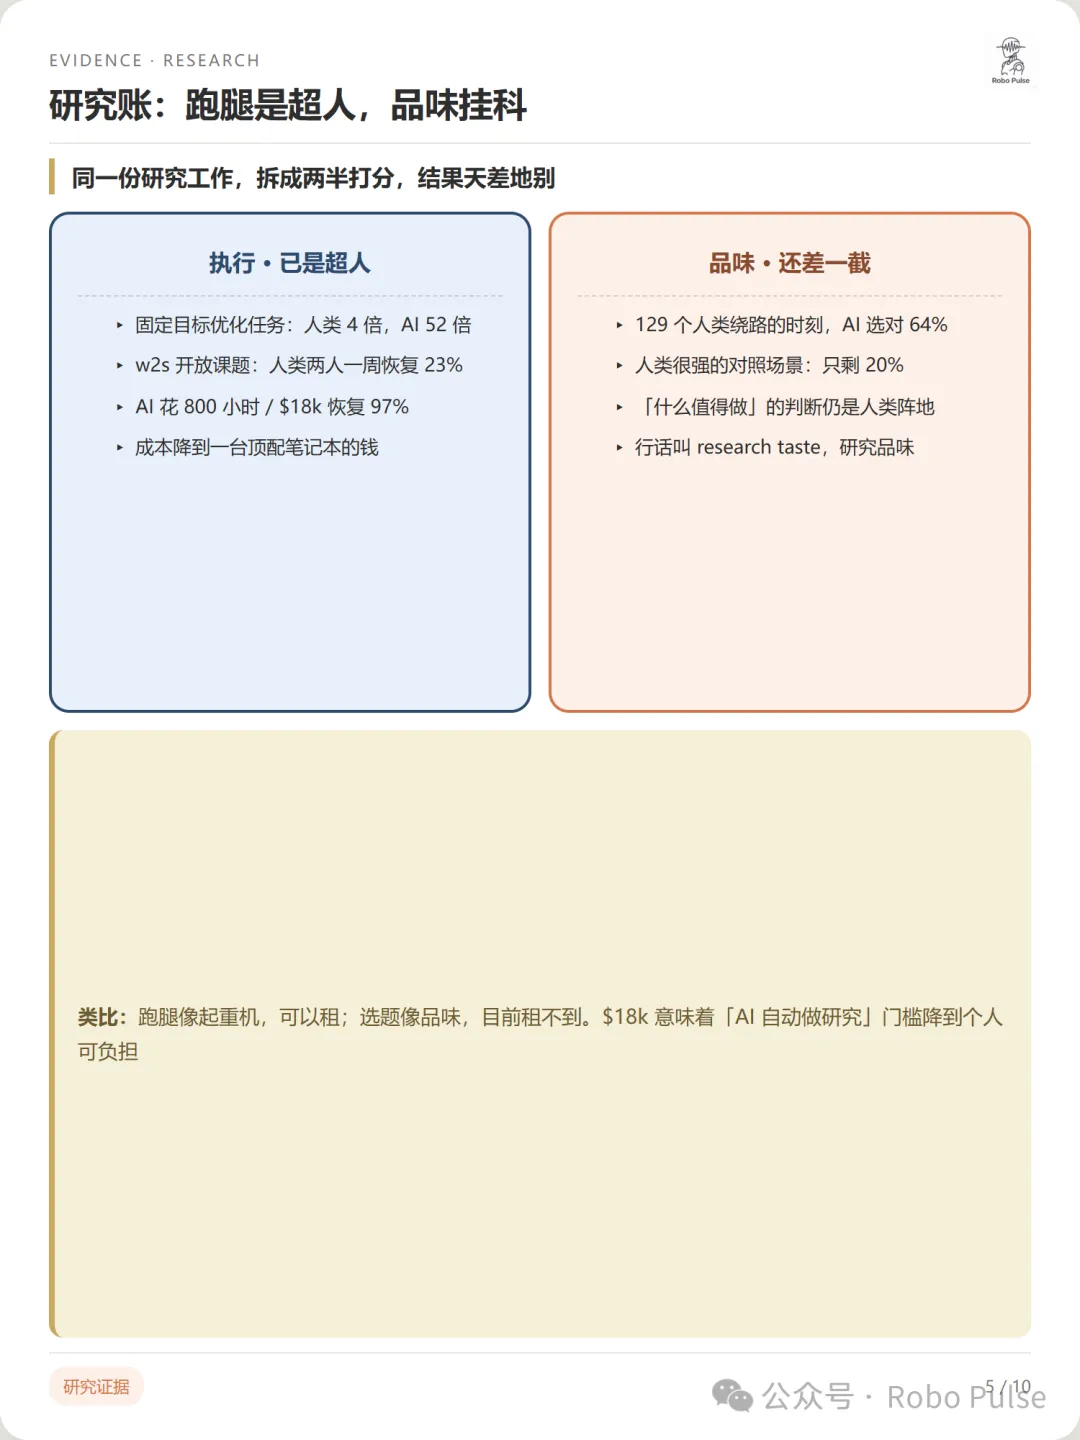 图4|研究账:执行 vs 品味(据 Anthropic 报告自绘)
四、这些数字能信几成
读到这里,需要停下来补一课口径。上面每一条都是 Anthropic 自己量自己,裁判还是自家人,账本不能全信,也不能全不信。办法是把每个数字的量法搞清楚。
代码占比 80%,按行数统计,原文自己脚注承认行数天然高估真实贡献。开放任务成功率 76%,由 Claude 当裁判判定,无需人类纠正才算成功,评估器和选手是同一家人。9 月更新里这个数字跳到了 91%,而最陡的跃升恰好发生在 2026 年 3 月新模型接入内部之后,进步是真的,但仪表盘和产品节奏是联动的,这点要留心。决策胜率 64%,考题故意挑人类绕弯路的时刻,样本有偏,对照组的表现暴露了这一点。8 倍产出,来自 130 名员工的问卷自评,Anthropic 自己都认为偏高。w2s 实验,尚未迁移到生产规模模型。任务时长翻倍,引用外部机构 METR 的研究,全场最硬的一根。
滤镜总结成三句话。方向可信,外部考卷与内部数据指向一致。幅度打折,全部内部数字出自利益相关方。时点留心,数据披露与产品发布节奏联动。
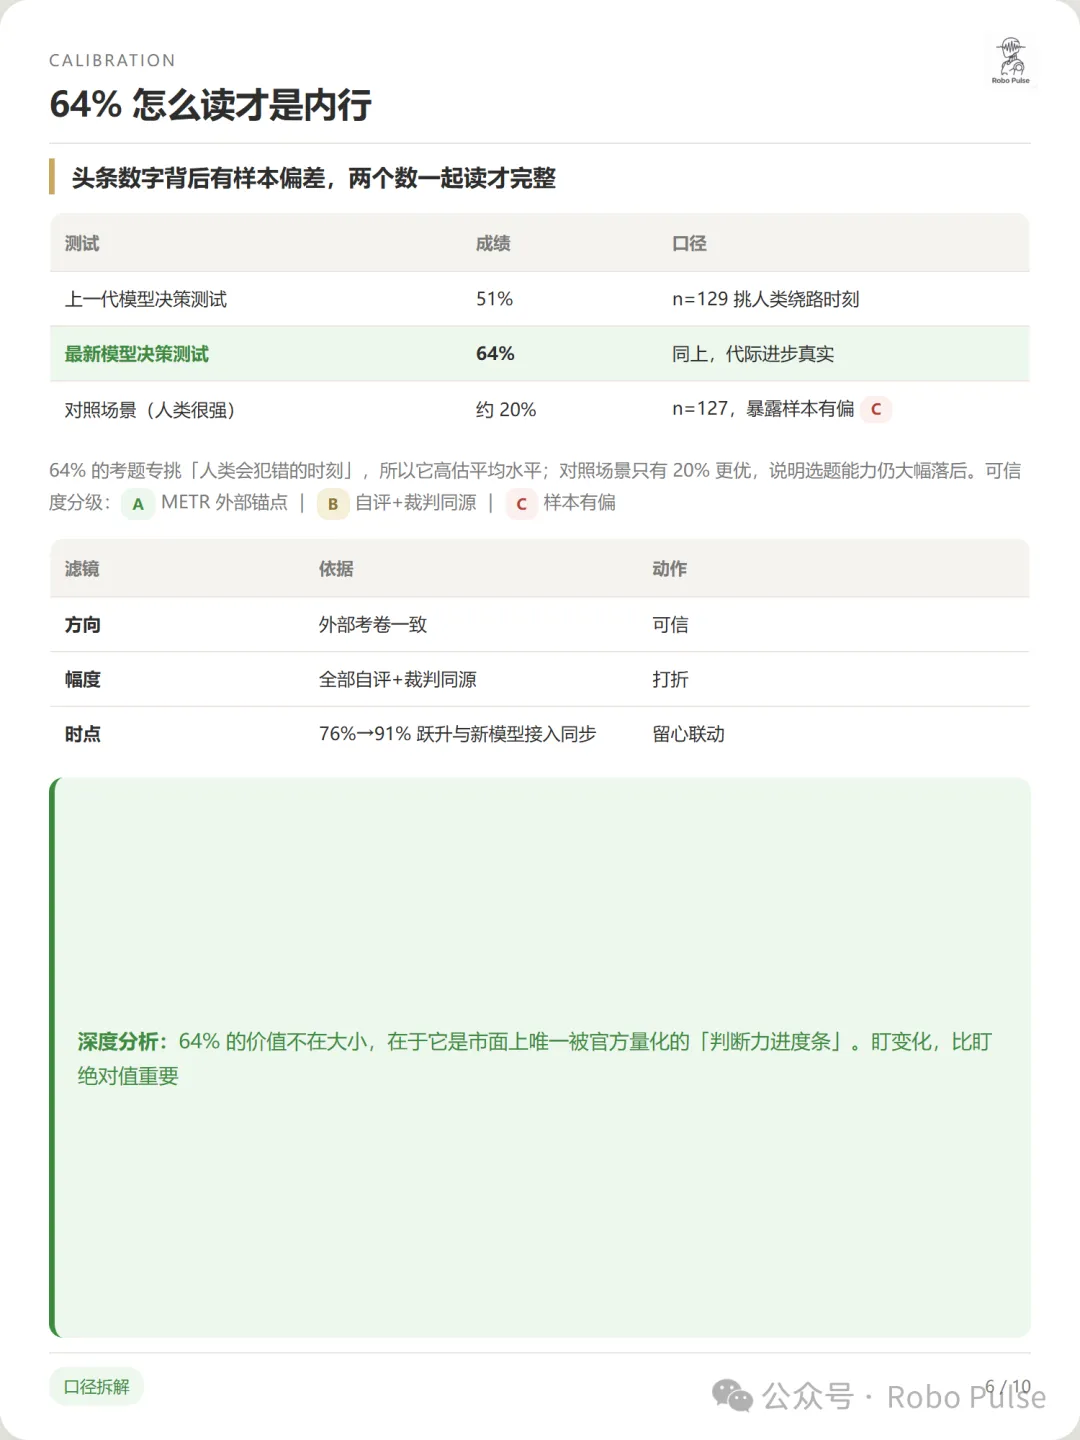 图5|64% 的正确读法与可信度分级(据 Anthropic 报告自绘)
还有一个反向证据值得单独说。报告专门写了反方观点,怀疑者认为选题恰恰是科研里最关键的一步,没有品味的 Claude 再能干,也只是个听话的助手。作者的回应分两层。第一层,AI 的进步历史大多是放大、修错、重试的笨功夫,而这恰好是 AI 最擅长的。第二层,就算人类最后只保留个位数的方向决定权,也足以构成复利加速。报告还留了一句激进解读,研究品味,可能只是又一个 AI 暂时做不好的能力而已。注意,这是推演,没有实验支撑,也是全文立场最软的一块。
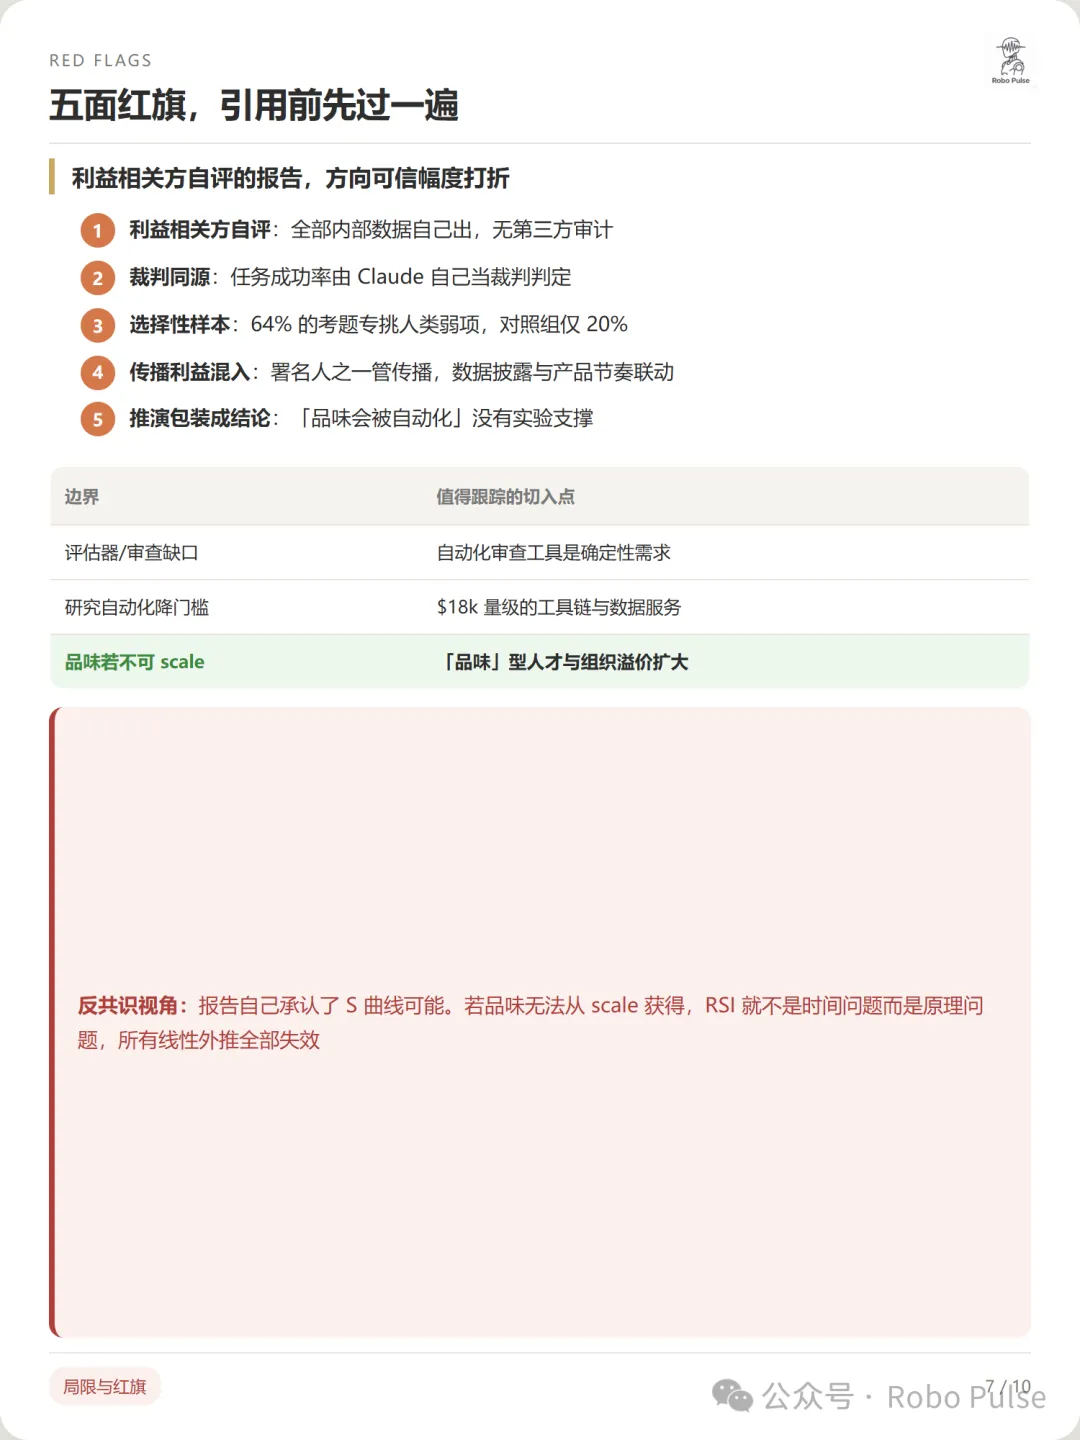 图6|引用这份报告前要过的五面红旗(据 Anthropic 报告自绘)
五、接下来的三种剧本
报告没有下结论,给了三个剧本。三个剧本的排列本身就是一种表态,作者把「继续快进」放在叙事中心,把「急刹车」写成可能的例外。
剧本一,急刹车。能力增长撞上 S 曲线停下来。但即便冻结在今天的能力上,影响也已经开始兑现。Anthropic 内部的安全项目 Glasswing 上线第一周就筛出超过一万个高危漏洞;一家 100 人的公司能干过去 1000 人的活。假如真的停下来,原因可能也在于换架构或者供应链,与「AI 不行」关系不大。
剧本二,复利加速,作者叙事的中心。人类定方向,AI 干活,100 人的公司做过去 1 到 10 万人的工作。人类的价值收窄到出题和验收。顺这条线推一步,组织与组织之间的差距也会被重新定义。阿姆达尔定律说整体提速受限于最慢的一环,放在研发流程里,代码写快了瓶颈搬到审查,审查自动化了瓶颈搬到选题,选题也自动化了瓶颈再搬到算力和物理世界。每一环的自动化都不会消除瓶颈,只会移动它。所以剧本二里组织的核心竞争力只剩一件事,发现瓶颈、修掉瓶颈的速度。这个判断对所有用 AI 的组织都成立,实验室、公司、投资机构,无一例外。
剧本三,完全 RSI。进步速度只由算力和算法效率决定。作者诚实地标出了两个压缩不了的物理瓶颈,新药要过临床试验,政策要过立法,这些环节 AI 再聪明也快不起来。
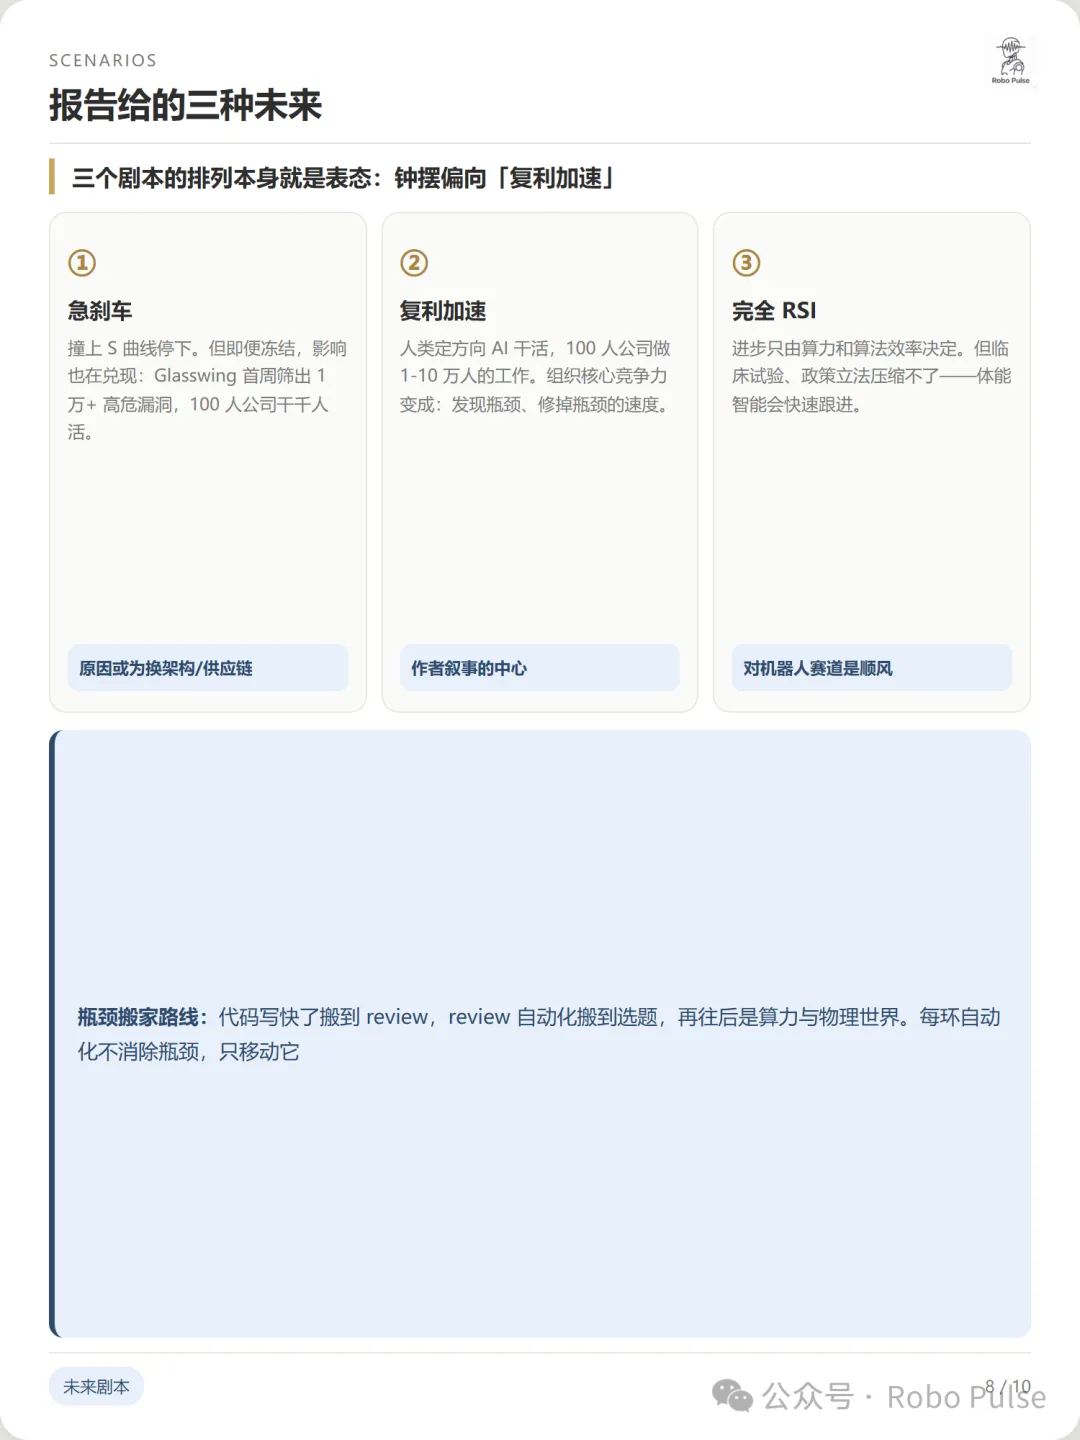 图7|报告给的三种未来(据 Anthropic 报告自绘)
六、产业对照,三条路线一幅图
把视线从 Anthropic 内部移开,看整个行业在做什么,会发现一个共识正在形成,大家争的已经从「会不会」,变成了「先从哪条路来」。以下三路信源来自我的知识库交叉检索,信源层级不同,分开标注。
第一路,技术侧。前 OpenAI 研究副总裁 Lilian Weng 今年 7 月写过一篇 Harness Engineering,核心论点是 RSI 的钥匙在 harness 和评估器,也就是给 AI 搭的脚手架和判断 AI 干得好不好的裁判,模型本身反而成了瓶颈。这与 Anthropic 的数据意外咬合,报告里 review 果然成了新瓶颈,评估器的地位直线上升。信源层级,技术长文。
第二路,创业侧。前阿里达摩院自动驾驶负责人田渊栋创办的 Neolabs,把 Physical RSI 当创业主线,主张在物理世界做机器人侧的自进化回路,设计、制造、收集数据、迭代改进,让机器人在真实世界里滚出自己的数据飞轮,公司估值已到 46.5 亿美元量级。Anthropic 报告的第三个剧本明确写道,判断力一旦被自动化,瓶颈将转移到算力和物理世界,体能智能会快速跟进。数字侧的进度条每推一格,物理侧的时钟就拨快一分。信源层级,一手访谈纪要。
第三路,学术侧。一篇 79 页的论文把 RSI 拆成五层阶梯,论证自进化是爬楼梯而不是跳崖,与 Anthropic 的渐进主义姿态互证。另外在知识库的一篇访谈里,某 AI 独角兽的华裔创始人给出了几乎相同的判断,AI 可以稍微自我改进,主要进步仍然来自人。信源层级,学术论文与一手访谈。
三条路线拼出同一幅图。稀缺的资源正在从「会写代码的人」,转移到「会出好题的人」和「能验证结果真伪的评估器」。这解释了为什么自动化审查工具和验证基础设施是确定性需求,Anthropic 的 reviewer 已经能捕获三分之一的历史事故,而审查跟不上生成速度的缺口只会越拉越大。
七、投资的哑铃,两端重中间轻
最后谈钱。这份报告对投资决策的价值不在数字,在分界线。它把一个模糊的宏大叙事切成了两个可以分别下注、分别验证的命题,执行力可自动化,已验证;判断力可自动化,待验证,并且有了 64% 这个可跟踪的计时器。
张磊在《价值》里有一个哑铃理论,原文说产业变革有两条同时发生的主线,「哑铃一端是新经济领域的创新渗透」,另一端是传统企业的创新转型。用在这条赛道上,形状恰好吻合。哑铃的一端是高赔率的拐点事件,RSI 的直接兑现者基本都在一级市场的头部 lab,二级市场早已定价。另一端是确定性的卖铲人,评估器、审查工具、验证基础设施、算力。最危险的是哑铃中间,那些讲「用 AI 自动做研发」故事的应用公司,头部 lab 把执行成本打到 52 分之一的时候,他们的效率溢价最先被抽干。
时机上,霍华德·马克斯《投资最重要的事》里的第二层次思维是个好尺子,他说这类思维「不仅问会发生什么,还要问结果的分布范围是什么、我判断的概率多大、共识是什么、我的预期与共识差多远」。用这个尺子量,市场第一层的认知是 AI 能写代码,这部分没有预期差;但「判断力是唯一变量」这个结构化判断尚未被充分定价。
赔率结构上,塔勒布在《黑天鹅》里把这类资产归入极端斯坦,原文的定义是「个体能够对整体产生不成比例的影响,最典型的成员要么是巨人要么是侏儒」,赢家通吃,历史跳跃发展。极端斯坦里的配置动作,塔勒布给的答案是杠铃策略,原话是「用更为专业的术语,可以称之为凸性组合」,大仓位放确定性一端,小仓位押非线性事件。落到这条赛道,即使 AI 停步,审查和验证的需求也在,卖铲人不受损;一旦拐点确认,凸性端吃到非线性回报。
还有《价值》里一个更贴切的择时概念,傻瓜窗口。原文说,在机会窗口之前,「还有一个傻瓜窗口,投资人普遍觉得你的商业模式非常不靠谱、非常傻的时段」,企业借此积累壁垒,接下来是拐点和陡变。判断力自动化眼下就在这样一个窗口里。张磊给硬科技投资人的动作建议是盯住拐点的前置指标,通用性是否在提升、单位任务成本是否在下降、真实场景部署是否在扩大。换算到本报告,前置指标就是下一节的三条。
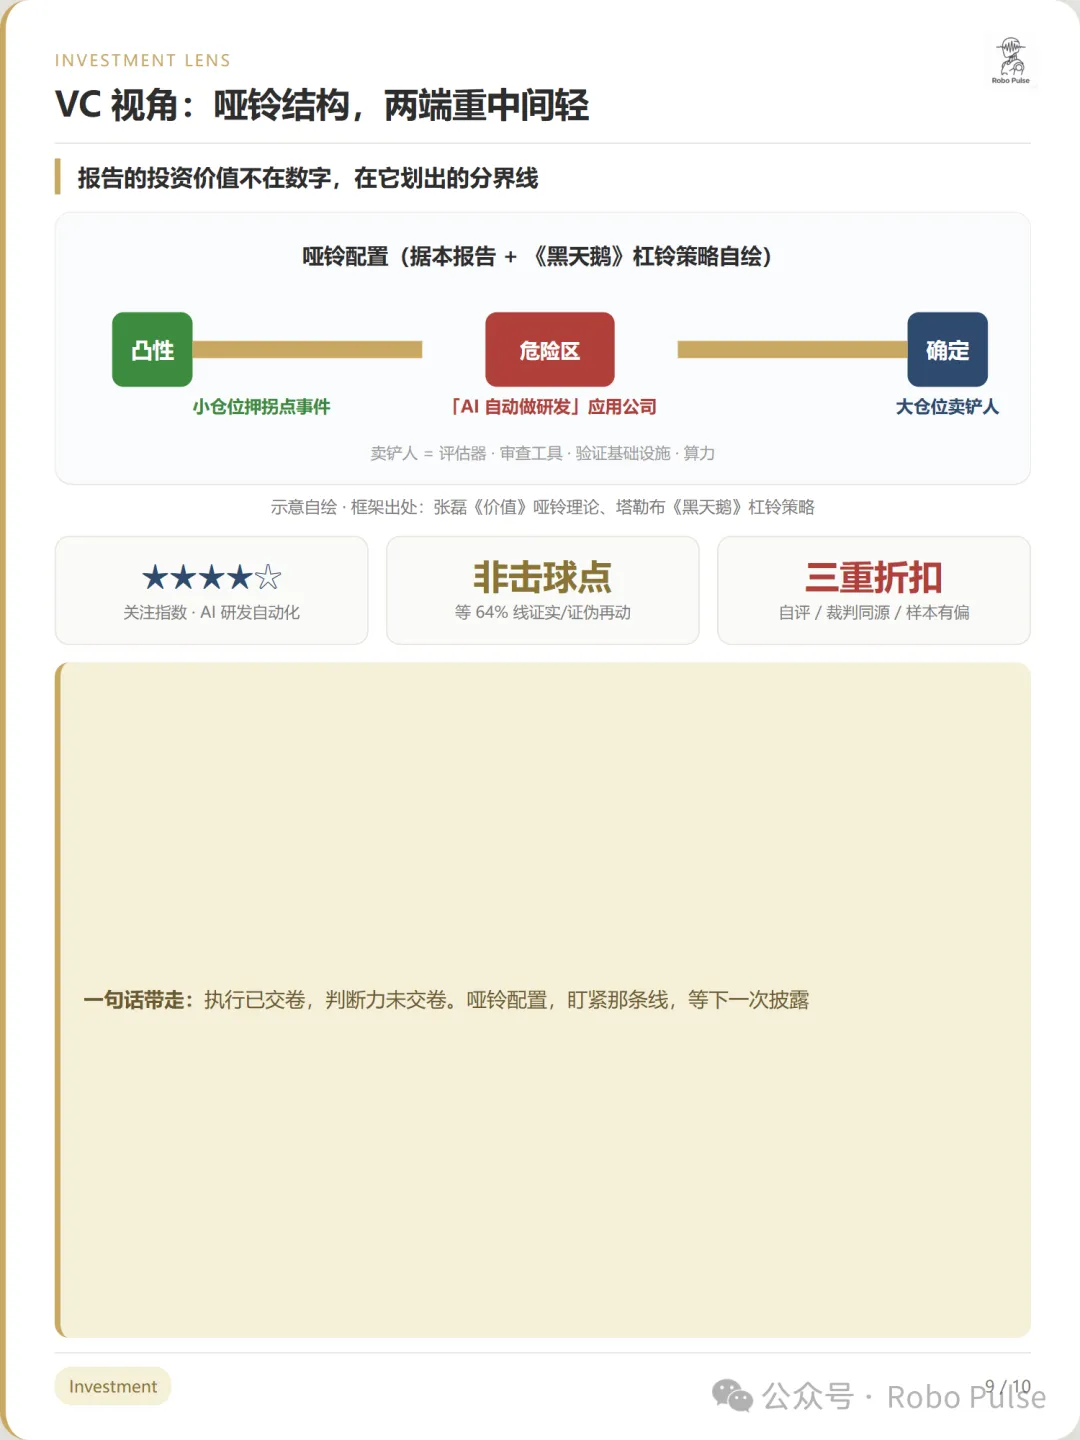 图8|哑铃配置示意(据本报告与《黑天鹅》杠铃策略自绘)
八、对答案,三个可以验证的信号
把判断写成可证伪的形式,欢迎一年后回来对答案。
信号一,决策胜率。64% 是当前唯一被官方量化的判断力进度条,下一次报告如果推到 80% 以上,拐点临近,哑铃凸性端的仓位信号。
信号二,翻倍周期。任务时长翻倍从 7 个月缩到 4 个月,如果继续缩短,研发支出的凸性确认,卖铲人受益。
信号三,Physical RSI 的首个公开数据。机器人侧的自进化回路一旦被验证,具身智能硬件公司的价值重估就到了,这是我的主赛道,名单已经列好。
最后留一个问题。你认为研究品味这种东西,是 scale 出来的,还是长在人身上的?评论区说说你的判断,我们用下一次 Anthropic 报告的数字见分晓。
(全文完。原文链接 https://www.anthropic.com/institute/recursive-self-improvement)
扫码添加作者微信,一起跟踪具身智能与人形机器人前沿。