ARTICLE · 1253690
两百页的 PDF 问AI之前该怎么做
两百页的 PDF 拖进去之前 · 先看它有没有文字层
塞得进去和读得对是两件事,第一道关口在文件自己身上。
token 算术、文字层、表格、中间塌陷
EDITOR'S NOTE
开篇塞得进去和读得对是两件事。两百页的文件,第一道关口在文件自己身上。
两百页的年报,直接拖进 Claude 的对话框,多半会被拒掉。模型没有偷懒,这道坎先出在算术上。官方文档写得明白,单次请求最多一百页,一百万上下文的模型才能放宽到六百页。两百页的文件为什么过不去,往下算就清楚了。
01
PART
先算一笔 token 的账
每一页按图和字两份算
Claude 读 PDF 的方式,官方文档写得很直白。每一页先转成一张图,再把那一页的文字抽出来,图和字一起递给模型。所以每一页要按两份开销算,文字一份,图片一份。文字部分每页一千五到三千 token,看页面密不密,图片另算。
按一页一千五到三千算,两百页就是三十万到六十万 token。一百万上下文的模型塞得下,二十万上下文的连门都进不去,这就是单次一百页这条线的来历。
同一个文件交给 Gemini,账完全是另一本。Google 的文档写的是每页两百五十八个 token,因为它默认不把整页渲染成图,省掉的是图片那份开销。两百页在这边是五万多,在那边是三十万起步,差出六到十二倍。原因在读法,两边喂给模型的东西本来就不一样。
网页应用里还藏着一条线。Claude 的应用允许单文件一千页,但超过一百页之后,后面那些页只按文字处理,图和表格看不见,界面不提示。四百页的报告传上去,字它读得到,图它看不见,问到图表里的内容,它给不出有依据的回答,而且回答得照样很自信。
有人在同一份十二页的纯文字报告上做过对照,十五个模型汇总下来,按文件传给 Claude 要两万七千多 token,把文字提出来粘过去只要六千上下。文件里没有图没有表的时候,多花的钱全花在把页面渲染成图这件事上,而模型看那几张图没有任何收益。
预算也好估。页数乘一千五到三千,是官方给的文字口径,图片那份再加,剩下的留给你要问的问题。超出预算的部分别硬塞,先提文本。
02
PART
文件里可能根本没有字
一行 Python 就能判断
PDF 本质是一份排版结果的存档,它记住的是每个字符画在哪个坐标上。有的文件从生成那一刻起就没有文字层,扫描件最典型,整本在提取文字的接口眼里就是一叠图片。
判断这个不用装一堆东西,pypdf 几行就够。
pip install pypdf
python -c "from pypdf import PdfReader; r=PdfReader('report.pdf'); print([(i+1,len(p.extract_text() or '')) for i,p in enumerate(r.pages)])"
前置条件是装了 Python 3,pypdf 用 pip 装一下就行。输出是每一页的字符数,整页为零的那几页就是扫描页。有字的页把文本提出来再喂,比传整个文件便宜得多,也干净得多。
不过字提出来了,只代表字在,不代表结构在。坏掉的结构,多半坏在表格上。
03
PART
表格才是分水岭
九亿参数的模型排在了前面
PDF 里的表格没有行列的概念,只有一堆字符坐标和几条线。人眼看是表格,接口拿到的只是一堆散落的字,谁在哪一行哪一列,全靠猜。
文档解析这块有个公开基准 OmniDocBench,OpenDataLab 维护,指标叫 TEDS,专门比较抽出来的表格结构和原件差多少,列错一格扣得比认错一个字狠得多。表格这一项的榜单上有个反常识的结果。
排第一的 PaddleOCR-VL-1.6,参数量只有九亿,得分 94.76。开源里做文档解析的 MinerU2.5-Pro 也只有十二亿参数,得分 93.42。Gemini 3 Flash 得 89.29,GPT-5.2 得 82.95,都排在它们后面。开源里另一个常见的 Marker 只有 65.77,比所有商用接口都低一大截。
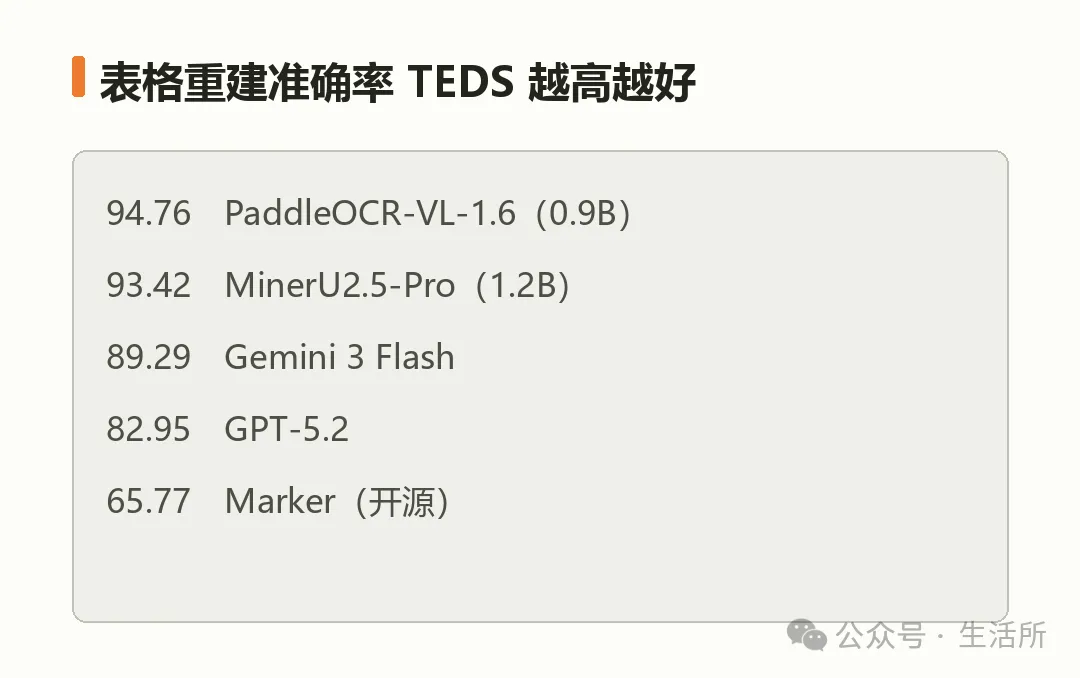
还有个小细节,Gemini 3 Flash 的表格分比 Gemini 3 Pro 还高一点。贵的那个不保证更准。
差距出在训练目标上。那批小模型是专门练把页面变回结构的,表格进去,出来的是带行列的 HTML。对话模型读 PDF 是在看图说话,表格画得越密,猜的成分越大。还有一个大模型最吃亏的场景,表格一跨页,上下两半各成一张,读图的模型拼不回去,专用工具反而会自动接上。
表格密集的文档,先过解析层再进对话窗口 财务报告、体检报告、扫描的合同都算。直接丢给大模型读图,还不如一个九亿参数的开源小模型,差五分往上,钱花得更多。
04
PART
塞进去了,也未必读得到中间
窗口大小是另一回事
就算全塞进去了,事情也没完。
Adobe Research 做过一个叫 NoLiMa 的测试,把问题和答案之间的关键词重合去掉,模型只能靠理解,没法靠搜关键词。十三个宣称支持长上下文的模型,大部分在上下文涨到三万二 token 的时候,成绩掉到短文本的一半以下。三万二,连它们自己宣传的窗口都不到十分之一。
斯坦福那篇 Lost in the middle 画的曲线是 U 形,模型对开头和结尾记得牢,中间那一段注意力明显往下掉。两百页的文件,你问的那个数要是正好在第一百页附近,它就坐在谷底。
这两条加在一起是一个提醒,窗口数字说的是能塞多少,塞进去之后用不用得上是另一回事。一百页的东西分五次喂,比一次全塞稳。
05
PART
我现在的分流
按页型决定怎么给
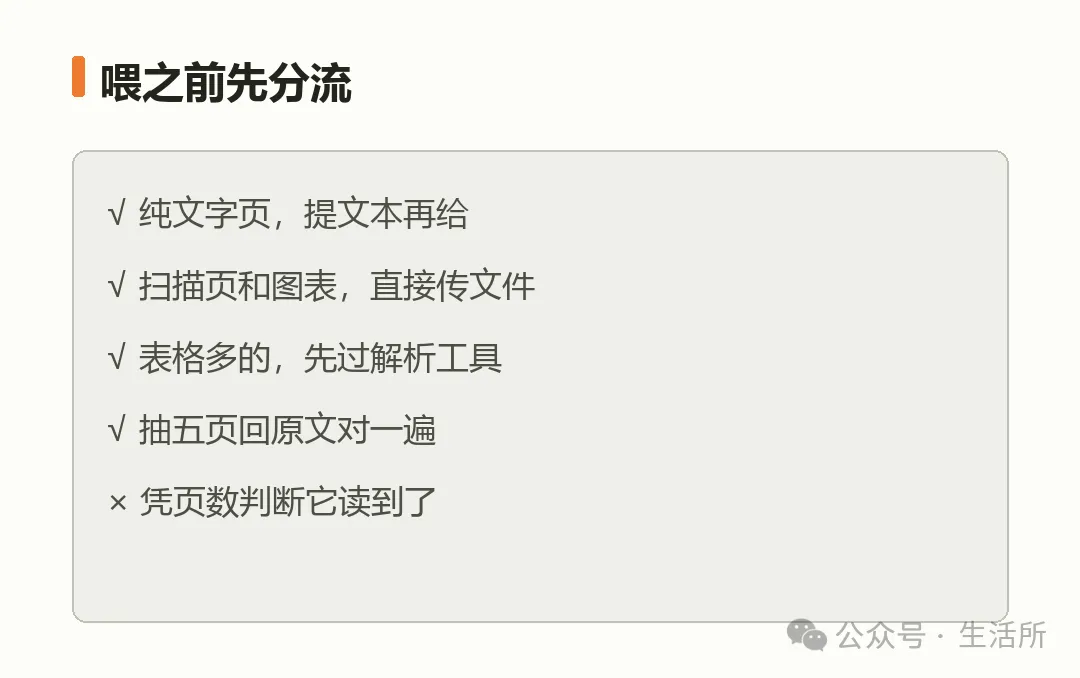
现在的做法很朴素,传之前先问一句,这份文件里最要紧的信息长什么样。
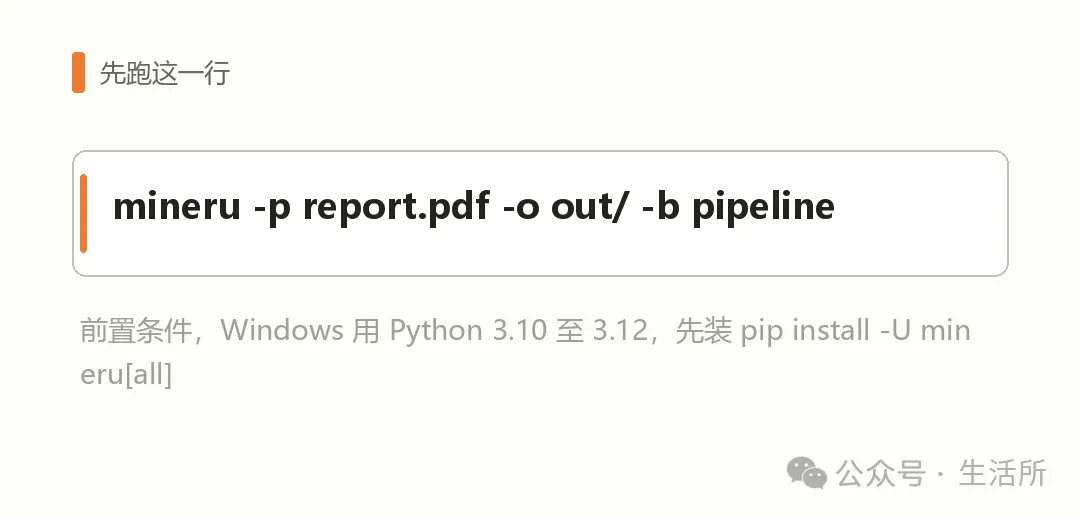
纯文字的页,提了文本再给。扫描页和图表页,直接传文件,让模型看图。表格多的,先过解析工具。MinerU 是开源里省心的一个,两条后端,pipeline 纯 CPU 就能跑,带 GPU 的机器走 vlm 后端,表格和公式转成结构化输出,跨页表格还会自动拼起来。
pip install -U "mineru[all]"
mineru -p report.pdf -o out/ -b pipeline
前置条件有两个。Windows 上 ray 不支持 Python 3.13,装 3.10 到 3.12。pipeline 后端不要 GPU,速度慢一些,显存够八 GB 的卡可以把 -b pipeline 去掉,让它走 vlm。跑完 out 目录里是 Markdown 和按阅读顺序排的 JSON,表格是 HTML。喂模型用 Markdown,核对结构看 HTML。
那份 JSON 值得单独说一句。每个区块都标了类型和页码,文字、表格、公式、图片各是各的,处理长文件的时候,想按页投喂、想先把所有表格拎出来看一遍,都靠它,不用自己再写识别逻辑。
最后一步谁也躲不掉。抽五页,把抽出来的字和原页对着看一遍,再挑两三个关键数字回原文搜。表格多看一眼行列数,错行的表格往往先在列数上露馅,抽出来的表格在浏览器里打开,列头一行齐不齐,扫一眼就知道。
///
END
结语
钱花在解析层更划算
两百页这个需求,最值钱的投入在解析这一层,不在最后那个窗口更大的模型上。窗口大小是厂商之间的竞赛,你的问题往往就十几个字。
喂进去的东西干不干净,比窗口大多少更决定答案对不对。下次拖文件之前,先花一分钟看看它有没有文字层,表格值不值得过一遍解析工具,这一分钟省下来的,是之后来回核对的一下午。
塞得进去和读得对,中间隔着解析这一层
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见
THANKS FOR READING