ARTICLE · 1254042
API 到底是什么?为什么不同的软件可以通过接口实现数据互通?
API 到底是什么?为什么不同的软件可以通过接口实现数据互通?你有没有想过一个问题: 为什么在电商平台下单后,订单信息能自动传到物流系统?为什么企业的 CRM、ERP、财务软件明明来自不同厂商,却可以共享客户、订单和库存数据? 这些软件可能使用不同的编程语言,数据库结构也完全不同,但依然能够相互通信。 背后一个重要的技术,就是 API(应用程序编程接口)。 如今,API 已经成为企业系统集成、数据同步和业务自动化的重要基础。 但很多人只知道“通过 API 可以获取数据”,对于接口究竟怎么工作、不同系统为什么能够互通,以及实际对接时需要解决哪些问题,仍然缺乏系统理解。 
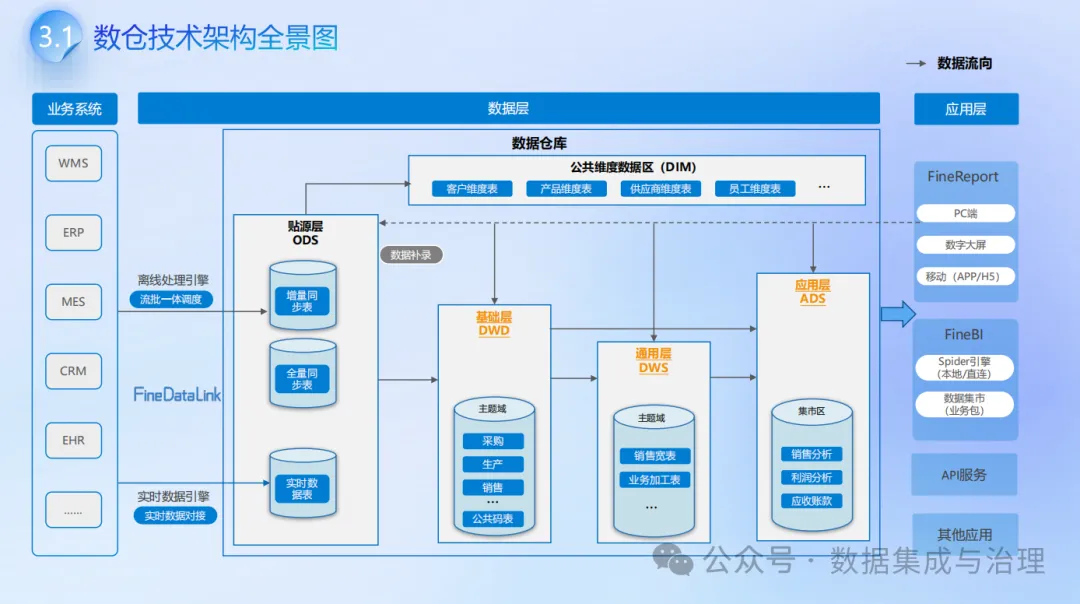
想进一步学习企业数据集成的朋友,也可以参考这份《数据仓库建设解决方案》,结合多源数据接入、接口调用、数据同步等实际场景,梳理从数据获取到加工、共享的完整链路,对理解 API 在企业中的应用会更有帮助。 需要自取:https://s.fanruan.com/ahhl0 

一、API 到底是什么?先理解它的本质 
API,全称 Application Programming Interface,中文叫应用程序编程接口。 简单来说,API 是软件向外部开放的一套调用规则,让其他程序能够按照约定获取数据或使用某项功能。 可以把它理解成餐厅的点餐流程。 顾客不用进入厨房,也不需要知道厨师怎么做菜,只需要按照菜单下单。 厨房接到订单后完成制作,再把菜品送出来。 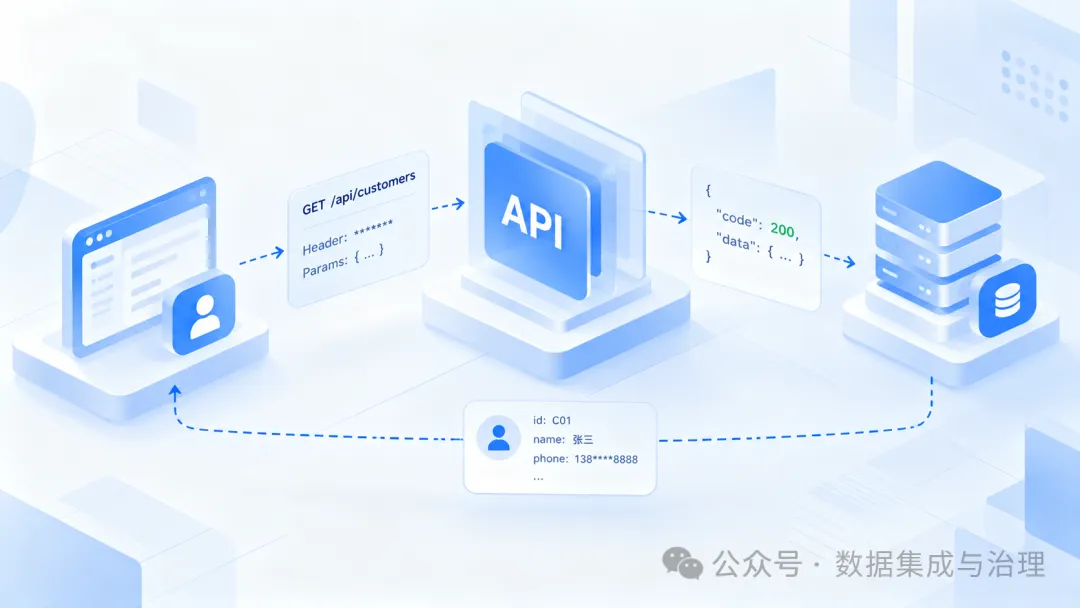
对应到软件系统: 例如,企业需要从第三方 CRM 获取客户资料。 CRM 不一定允许外部直接访问数据库,但可以开放客户查询 API。只要调用方提供正确的参数和身份凭证,就能获取授权范围内的数据。 实际对接这类系统时,通常需要解决接口地址、请求参数、认证方式以及数据写入位置等问题。 这些操作也可以通过 FineDataLink 5.0 串联起来:先配置 API 数据源,完成接口请求,再将返回的客户信息同步到目标数据库。 即使第三方系统没有开放数据库连接,也能通过接口建立数据传输链路,减少为每个系统单独开发取数程序的工作。 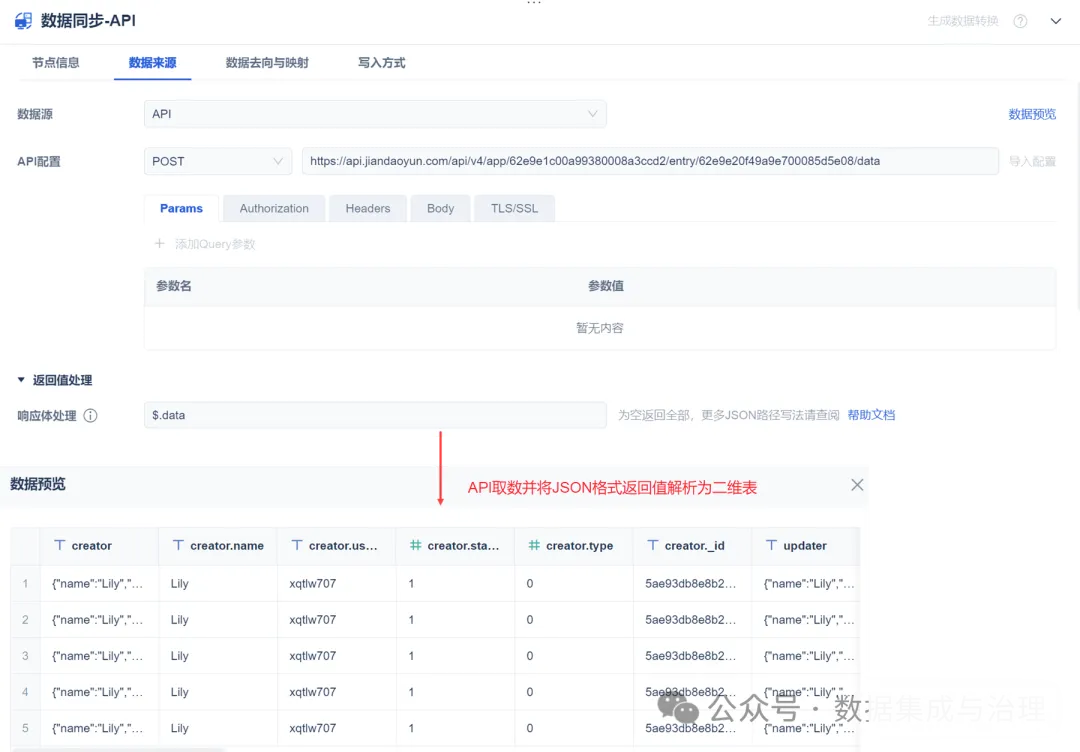
需要注意,API 并不局限于网络接口,操作系统和程序库也存在 API。本文讨论的是企业数据集成中最常见的 Web API。 
二、一次 API 调用,到底经历了什么? 
理解 API,最重要的是弄清两个概念: Request(请求)和 Response(响应)。 假设企业想获取某天的订单,可以发送: 一次完整请求通常涉及四个要素。 例如: 它相当于服务方提供的入口。 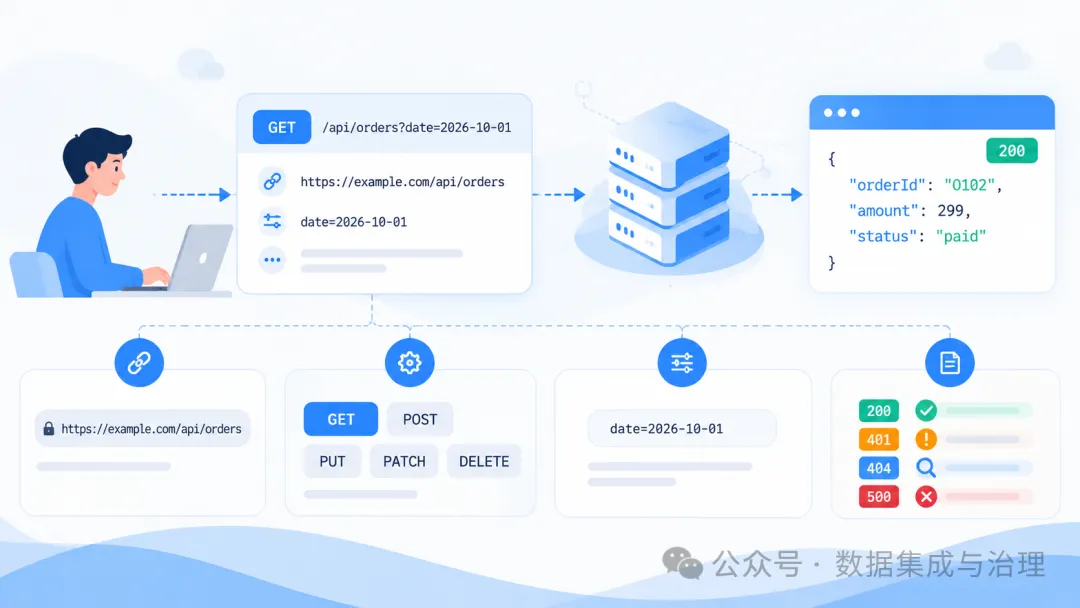
HTTP 接口常见的方法包括:
具体操作仍以接口设计为准。 例如: 表示查询指定日期的订单。 参数可以放在 URL、请求头或请求体中,具体取决于接口约定。 服务端完成身份验证、数据查询后,通常会返回 JSON: 调用方解析后,就知道订单 O102 的金额为299元,状态为已支付。 HTTP 状态码还能告诉调用方请求的处理情况。 例如200通常表示请求成功,401表示缺少有效身份认证,404表示资源不存在,500表示服务器内部错误。 不过,HTTP 请求成功,不代表业务一定成功。 有些接口即使返回200,也可能在响应体里通过业务状态码提示操作失败,需要结合两者判断。 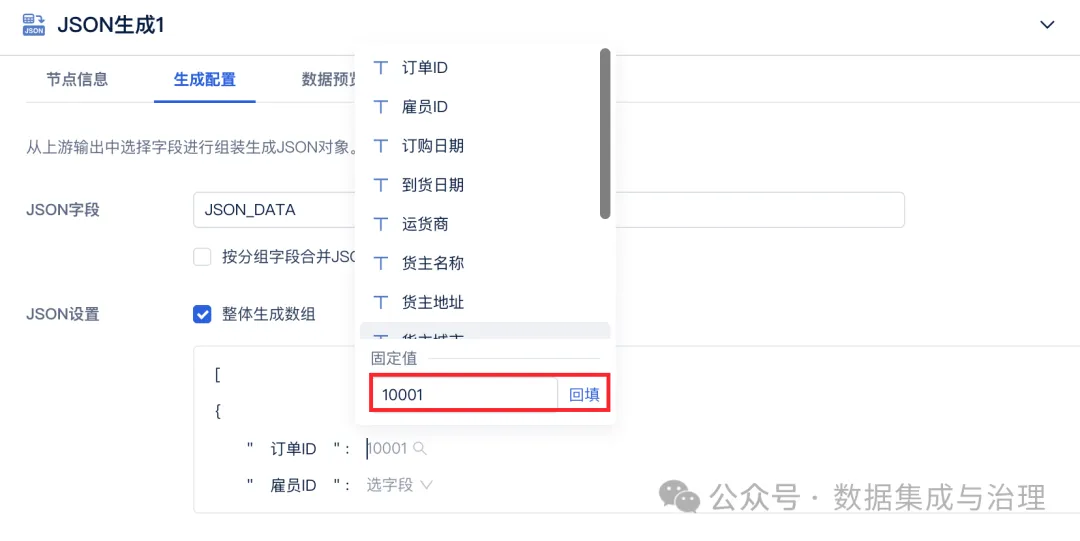

三、为什么不同软件可以通过 API 互通? 
核心原因在于: 不同系统不需要使用相同的技术,只需要遵守共同的通信协议和接口约定。 例如: A 系统使用 Java,数据库是 MySQL。 只要 A 对外提供符合约定的 HTTP API,B 就可以发送请求,再按照返回格式解析数据。 这里实际上解决了两个问题。 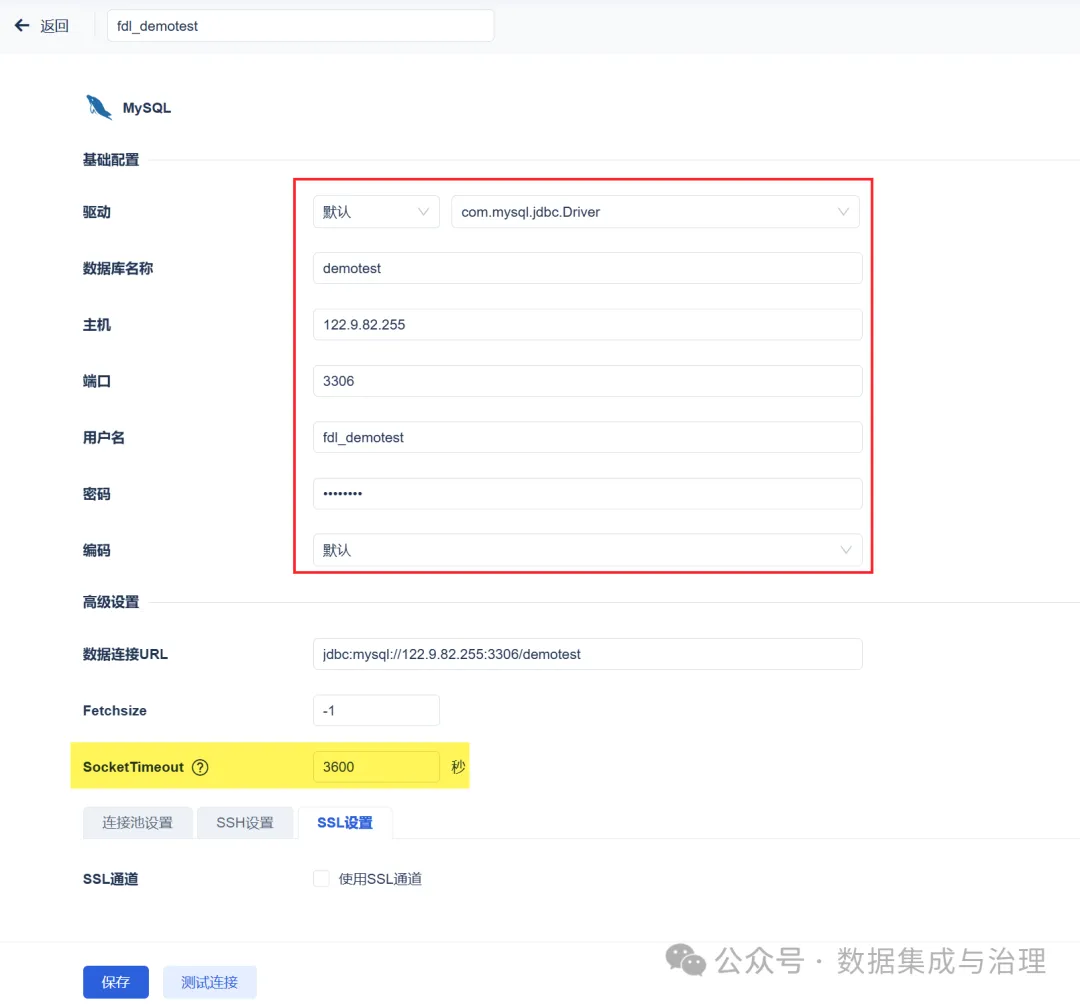
HTTP 规定了请求和响应如何传输,JSON 等数据格式则提供了双方能够理解的数据结构。 A 系统即使更换数据库,只要接口规则保持兼容,B 系统通常就不需要跟着修改内部逻辑。 但这里还有一个容易忽略的问题: 技术上能传递数据,不代表业务上能直接使用。 例如: A 系统使用 customer_id 表示客户编号。 即使接口调用成功,两边仍然需要明确字段对应关系。 更复杂的情况是,两个系统对于“有效订单”的定义可能完全不同。 因此,企业真正的数据互通通常要经历: 接口调用 → 数据解析 → 字段映射 → 业务口径统一 → 目标端写入。 这也是为什么企业拿到 API 返回的数据后,往往还要经过一轮整理。 例如,从 CRM 获取客户资料后,需要将客户编号、创建时间、客户状态映射到内部客户表。 通过 FineDataLink 5.0 配置字段对应关系,再把处理后的数据写入目标端,就能将接口取数与数据库同步衔接起来。 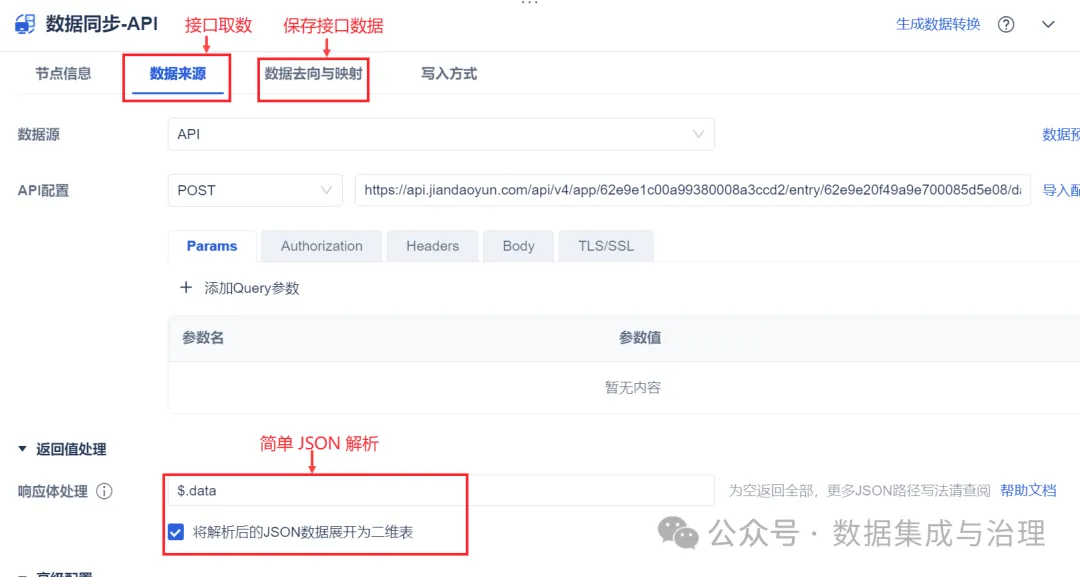
但字段名称统一只是基础,业务含义也必须提前确认。否则即使同步任务运行成功,不同系统的数据仍然可能无法正确关联。 
四、有了 API,是不是就能实现实时同步? 
不一定。 API 提供了访问数据的能力,但什么时候获取数据、更新频率有多高,取决于具体的同步机制。 企业常见的接口集成方式主要有三种。 系统 B 每隔5分钟请求一次系统 A,获取最新订单。 这种方式实现简单,但存在一定延迟。如果请求太频繁,还可能触发接口限流。 订单支付成功后,系统 A 主动向系统 B 的接收地址发送通知。 它减少了反复查询的开销,但需要处理消息丢失、重复推送和事件乱序等问题。 接口支持通过更新时间、业务ID或游标,只获取上次同步以后发生变化的数据。 例如每次只读取最近修改过的订单,避免重复下载全部历史数据。 实际调用还经常遇到分页问题。 假设接口每次最多返回1000条订单,企业需要获取10万条,就必须连续请求多个页面。 如果分页过程中源数据持续变化,简单使用页码或偏移量可能导致重复、遗漏。条件允许时,可以优先选择稳定排序和游标分页。 面对这样的接口,如果完全依靠代码开发,就要自己处理分页循环、请求间隔和定时执行。 换成 FineDataLink 5.0 的 API 输入,可以根据对方接口的规则配置页码、偏移量或游标分页,并控制请求频率,再配合定时调度周期性拉取数据。 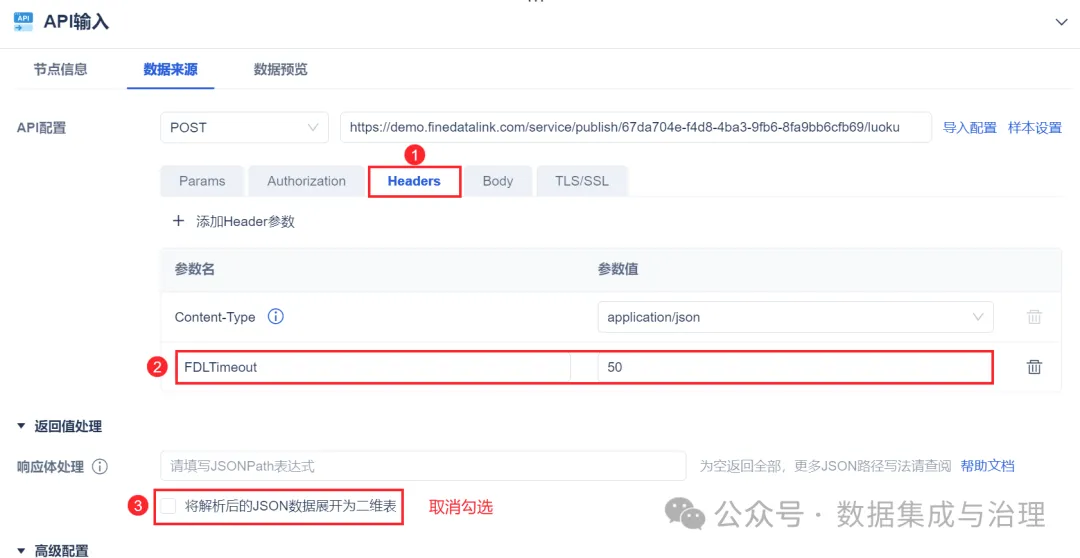
不过,分页配置只是解决了如何连续取数。增量水位、异常重试和历史数据补偿仍要单独考虑,尤其需要确认源端接口是否能返回删除事件。 
五、API 能获取数据,为什么企业还需要数据加工? 
真实项目中,接口调用成功通常只是开始。 假设企业从订单 API 获取以下数据: 这是一条包含嵌套对象和数组的 JSON。 如果目标数据库需要保存订单、客户和商品明细,就不能简单地把整个 JSON 当作一条普通记录写入。 至少需要完成三项处理。 提取 对于一笔订单包含多件商品的情况,还要区分订单表和订单明细表的记录粒度。 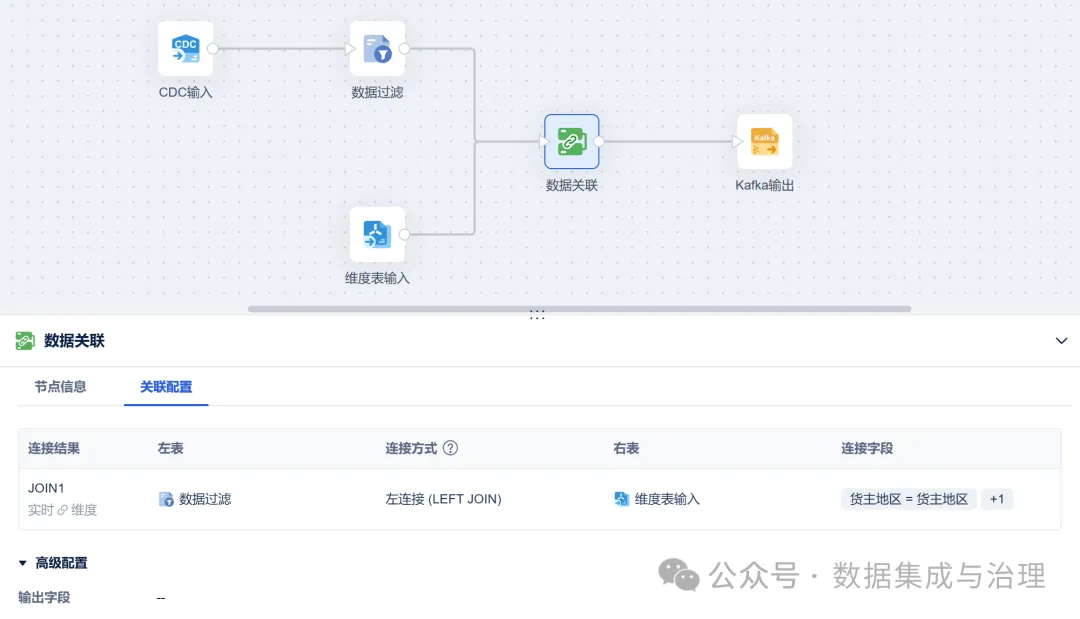
统一日期格式、金额单位、字段名称和空值处理规则。 例如,一个接口返回的金额单位是元,另一个返回的是分,如果不转换,汇总结果可能相差100倍。 按照订单ID识别重复数据。 如果接口会返回历史订单的最新状态,还需要决定已有记录是覆盖、更新,还是保留多个版本。 这些处理如果分散在不同脚本里,后续接口结构一变化,维护起来就比较麻烦。 例如,通过 FineDataLink 5.0 的 API 输入算子获取订单响应后,可以继续连接 JSON 解析、字段处理等算子,将嵌套的客户信息和商品明细展开,再按目标表结构进行加工和输出。 从接口请求到数据整理,可以放在一条任务链路中完成。后面如果需要调整字段映射或补充清洗逻辑,也能沿着数据处理流程定位对应环节。 当然,工具能够处理数据格式,却无法自行确定所有业务含义。订单状态、客户分类等口径,仍然需要业务人员参与确认。 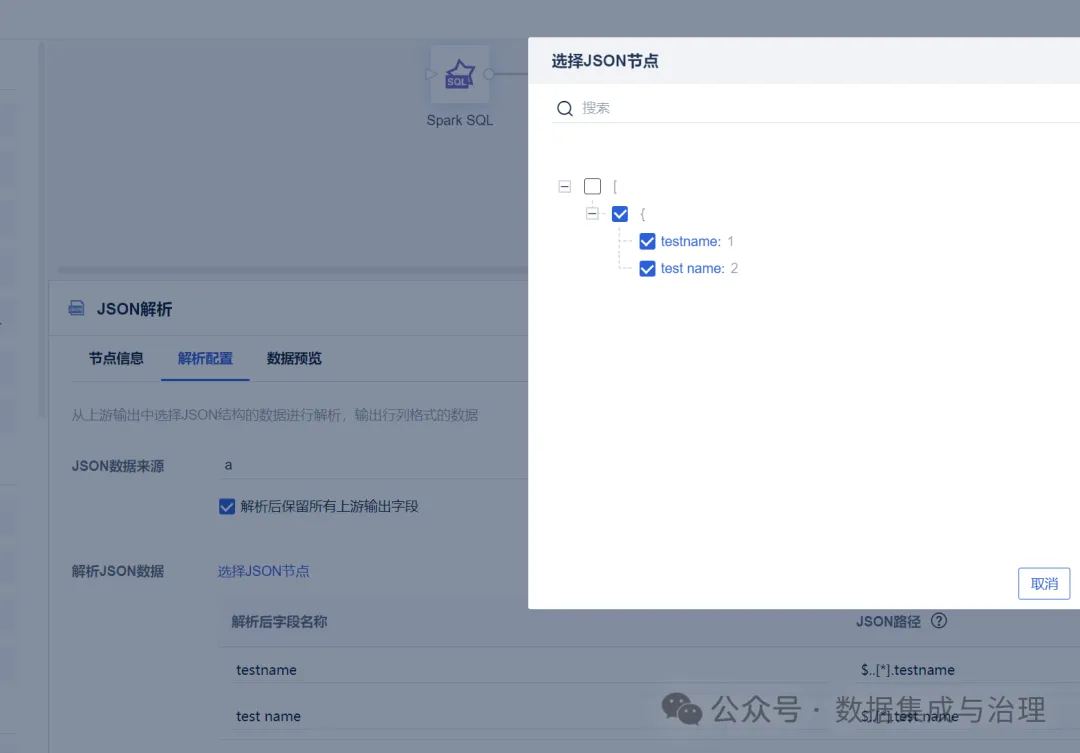

六、企业做 API 对接,最容易踩哪些坑? 
很多接口在测试阶段正常,一旦进入生产环境,就可能频繁出现问题。 主要需要关注以下五点。 常见方式包括 API Key、Token、OAuth 2.0 等。 不能把密钥直接暴露在公开代码或日志中,还需要关注有效期、权限范围和凭证更新。 第三方接口可能限制每分钟调用次数。 超过限制后,通常需要根据响应提示调整频率,而不能无限重试。 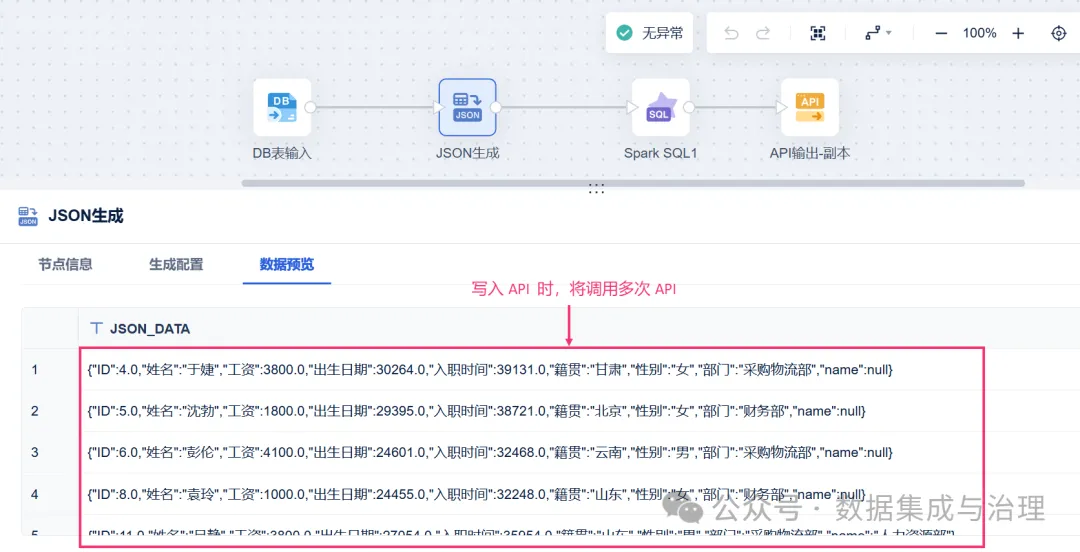
一次请求可能因为网络波动或服务端负载过高而失败。 需要合理设置超时时间,并区分临时故障与永久错误。 查询操作重复执行通常问题不大,但创建订单、提交付款等操作重复执行,可能产生额外业务记录。 因此,涉及写操作时,需要结合业务唯一键或幂等机制控制重复。 如果第三方突然修改字段、认证方式或数据格式,下游程序就可能报错。 所以,上线前最好建立接口版本管理、运行日志和异常告警。 拿常见的 Token 认证来说,有些接口的访问凭证会定期过期。如果每次都人工获取并修改参数,长期运行就很容易出问题。 可以把获取 Token 也设计成任务流程的一部分: 先调用认证接口,取得新的 Token,再把它传给后面的数据请求。FineDataLink 5.0 的参数赋值与参数引用机制,就能把前一步获取的信息继续用于后续节点。 同时,定时任务还可以结合执行日志、失败重试和异常通知,及时发现连接超时、认证失败等问题。 但要注意,重试策略需要区分操作类型。对于可能产生业务副作用的写请求,重复执行前必须确认接口是否支持幂等处理。 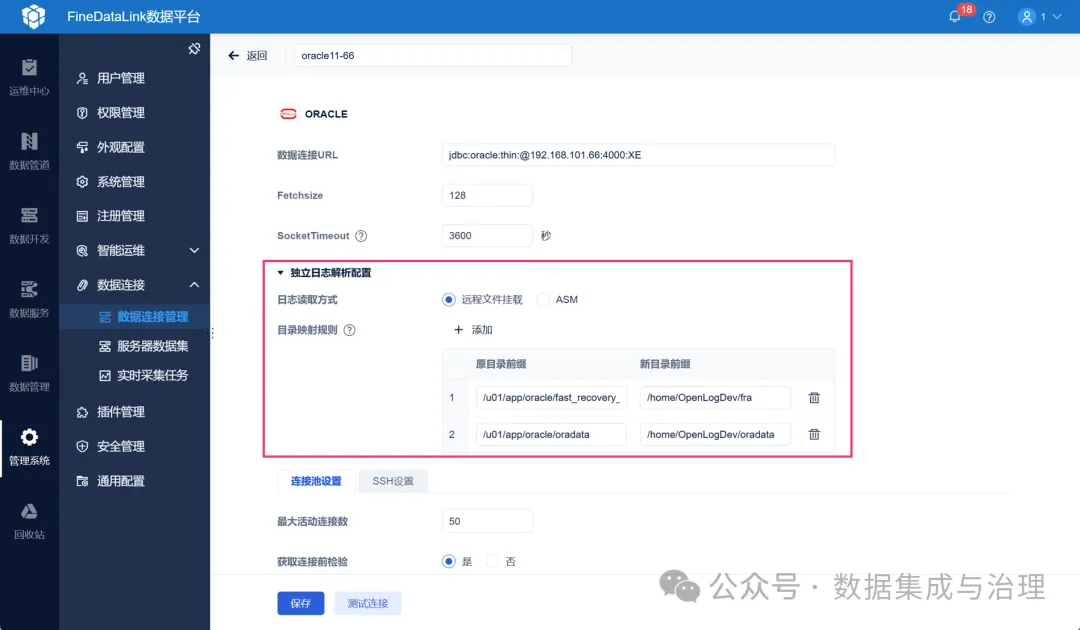

七、API 不仅能获取数据,还能把数据开放出去 
前面讨论的是调用别人的 API。 但企业还经常遇到反过来的需求: 已经整合好的数据,怎样共享给其他业务系统? 例如,企业把 ERP、CRM 和订单数据统一加工后,希望客服系统、营销系统都能使用同一份客户信息。 如果每接入一个新系统,就单独开发一次数据库查询逻辑,后期维护成本会不断增加。 更合理的方式,是将经过治理的数据封装为标准 API。 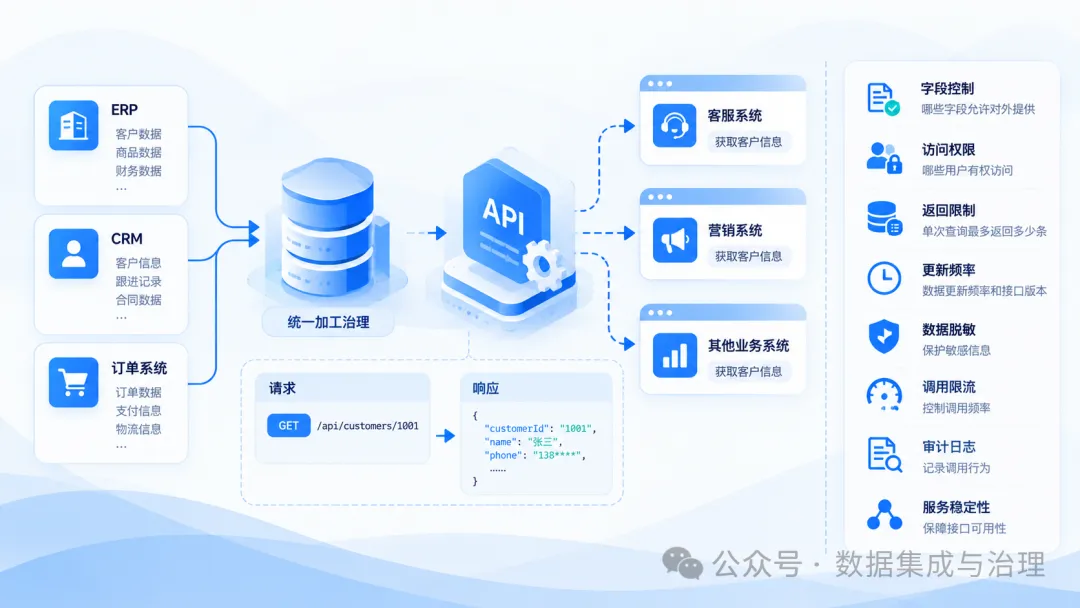
例如: 外部系统提供客户编号,服务端核验权限后,返回允许查询的客户信息。 这种方式能够减少系统之间对底层数据库结构的直接依赖。 不过,开放 API 不能简单理解成“把数据库数据全部暴露出去”。 实际发布时,至少需要明确: 如果接口面向外部合作伙伴,还需要进一步考虑数据脱敏、调用限流、审计日志和服务稳定性。 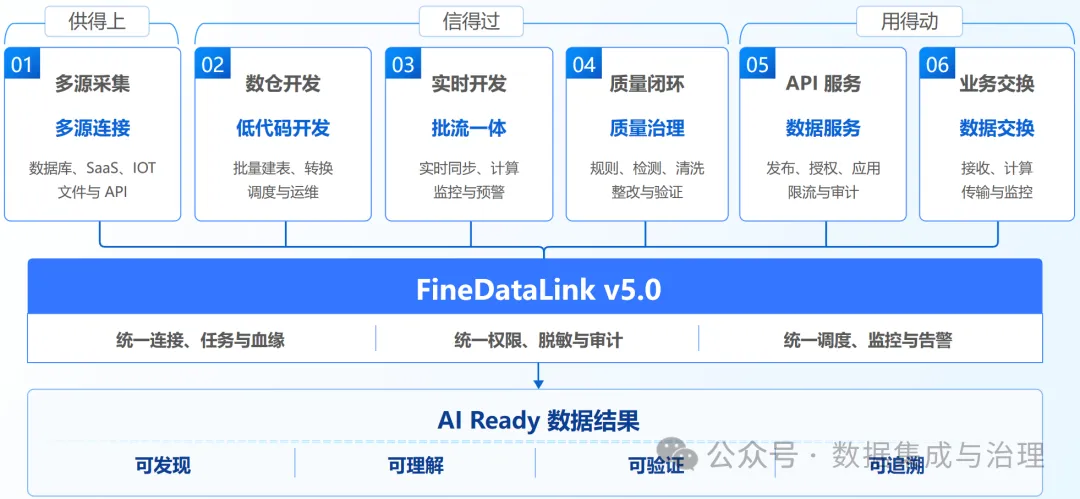

八、最后:理解 API,记住这五个问题 
以后遇到一个陌生 API,可以按照下面的顺序分析。 是查询数据、提交订单,还是执行某项操作? 接口地址、请求方法、参数和认证方式分别是什么? 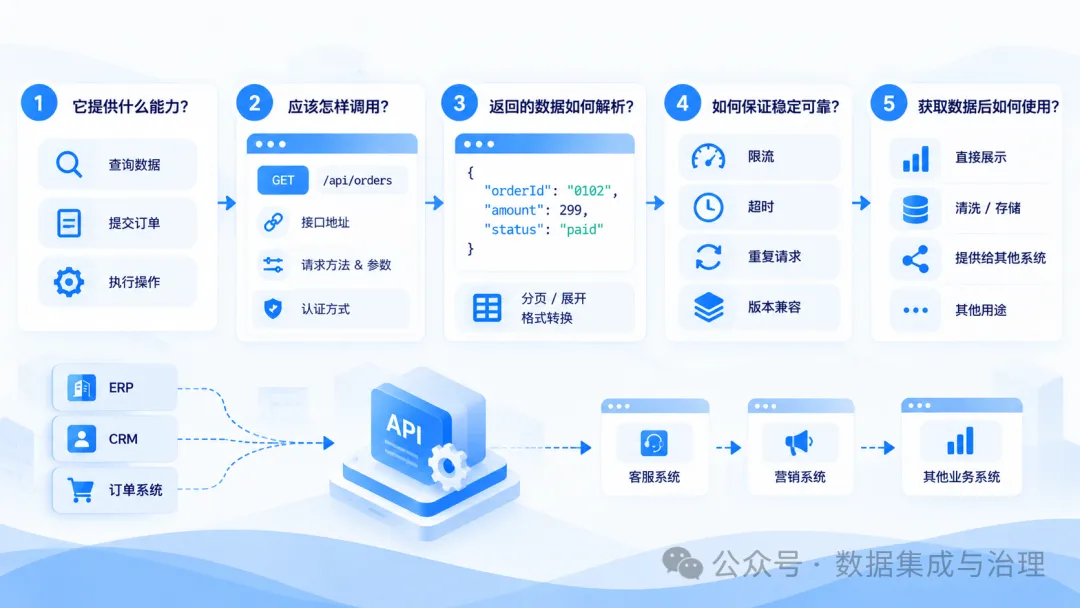
JSON 里哪些字段有用?是否需要分页、展开和格式转换? 有没有限流、超时、重复请求和版本兼容问题? 是直接展示,还是进一步清洗、存储,再提供给其他系统? 理解这五个问题,基本就能看清一次 API 调用从请求到落地的完整过程。 对于企业而言,API 打通了不同系统之间的通信通道,但数据真正流动起来,还需要解决格式、口径、权限、时效和稳定性等问题。 API 让不同软件能够互相交流,而完善的数据集成链路,才能让这些交流持续转化为可用的业务数据。 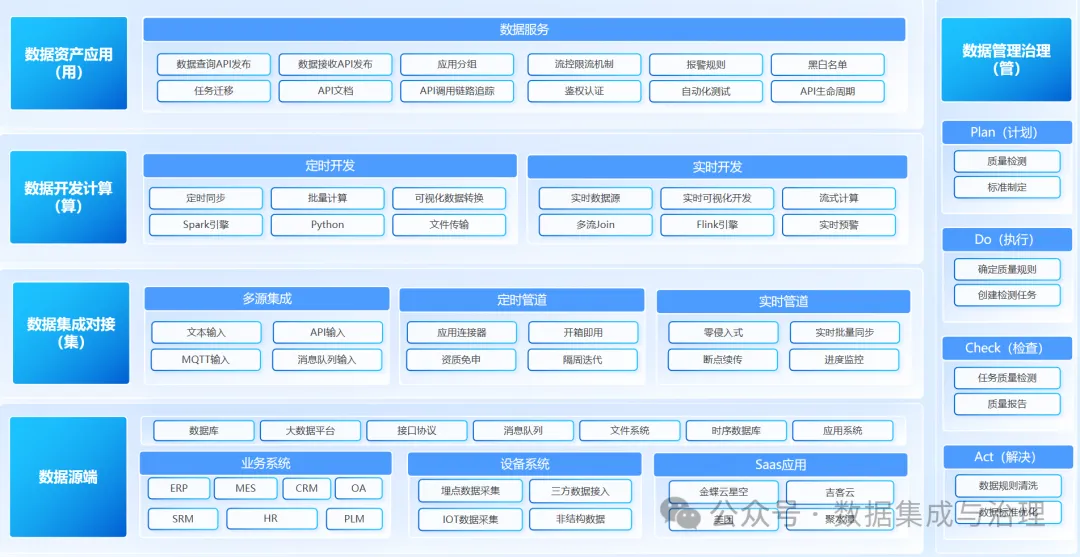

点击【阅读原文】,体验文中同款资料包 
调用方: 需要使用某项功能的软件。 API: 双方约定好的调用入口和规则。 服务方: 真正执行查询或业务操作的系统。 响应结果: 服务方处理后返回的数据或状态。
GET /api/orders?date=2026-10-011.接口地址:访问哪里?
https://example.com/api/orders2.请求方法:希望执行什么操作?
3.请求参数:需要什么数据?
date=2026-10-014.返回结果:拿到了什么?
{"orderId":"O102","amount":299,"status":"paid"}B 系统使用 Python,数据库是 PostgreSQL。
第一,通信方式统一。
第二,内部实现相互独立。
B 系统使用 clientCode 表示客户编号。
第一种:主动轮询(Polling)。
第二种:事件推送(Webhook)。
第三种:增量拉取。
{"orderId":"O102","customer":{"id":"C01"},"items":[{"sku":"A01","qty":2}]}1.数据结构转换
customer.id,再将 items 数组展开为商品明细。2.字段标准化
3.数据去重与更新
第一,身份认证。
第二,接口限流。
第三,调用超时。
第四,重复请求。
第五,接口升级。
GET /api/customers/1001哪些字段允许对外提供? 哪些用户有权访问? 单次查询最多返回多少条? 数据更新频率和接口版本如何管理?
① 它提供什么能力?
② 应该怎样调用?
③ 返回的数据如何解析?
④ 如何保证稳定可靠?
⑤ 获取数据后如何使用?