ARTICLE · 1255381
AI气象模型不敢报极端天气,锅在评分规则上

过去两年,气象和 AI 圈在争同一件事:面对破纪录的高温、寒潮和大风,盘古、GraphCast 这些 AI 大模型到底行不行。
诡异的是,两边都有论文撑腰。Zhang 等人 2026 年的结论是 AI 不行;Olivetti 和 Messori 2024 年只看最极端的那 5%,说 AI 反超。
同行评审都过了,数据都摆着,结论却对不上。这篇论文给的答案是:谁都没算错,是给模型打分的那张考卷,本身偏了。
先看结论
1. 换个评分指标,AI 与物理模型的名次会 180 度对调。
2. 不是谁算得更准,是两套评分在惩罚不同的错误。
3. AI 不敢报、物理模型爱报,这是两类指标的偏心来源。
4. 只挑极端样本评分,等于提前判物理模型赢。
下文拆解这场名次反转是怎么发生的,以及换到你的评测场景该怎么避开。
论文 Can We Trust Evaluations of AI Weather Forecasts for Extremes? How Evaluation Protocols Shape Model Rankings
作者 Sam Allen、Tobias Biegert、Zhongwei Zhang、Sebastian Lerch
机构 卡尔斯鲁厄理工学院统计研究所、马尔堡大学数学与计算机科学系
链接 arXiv:2610.31237
备注 NeurIPS 2026 Workshop TAE(Trust-AI-Eval)接收
一个总喊狼来了,一个从不喊
极端天气预报这件事,学界吵了两年还没停。
Zhang 等人 2026 年的结论是:AI 模型预报破纪录的高温、寒潮、大风,不如物理模型。
Olivetti 和 Messori 2024 年给出相反答案:在最极端的百分之五高温和大风事件上,AI 模型略胜一筹。
到了 Biegert 等人 2026 年,结论又变成:AI 模型给出的预报信息量更大。
同一个问题,三个结论。要么有人算错了,要么他们算的其实是三件不同的事。
这篇论文的答案是后者。而且它给出的证据相当扎心:这批作者自己,就在两套指标下得出了两个相反的结论。
先说清楚他们在比什么。
先说清楚这张考卷怎么出的。四个模型跑同一批时次:2022 年全年,每天 00 和 12 时两个起报点,共 708 个初始化时次,统一插到 0.25 度网格上,预报时效取 1、3、5、7、10 天五个点。
考卷的答案是初始化四个模型所用的同一套分析场。破纪录的门槛来自 1979 到 2017 年的 ERA5 再分析,按变量、格点、月份分别定。选 2022 年不是随手挑的,这一年不在任何 AI 模型的预训练或微调数据里,避开了拿训练集考自己的问题。陆地结果排除了南极,全球范围的结果放在附录里做稳健性检查。
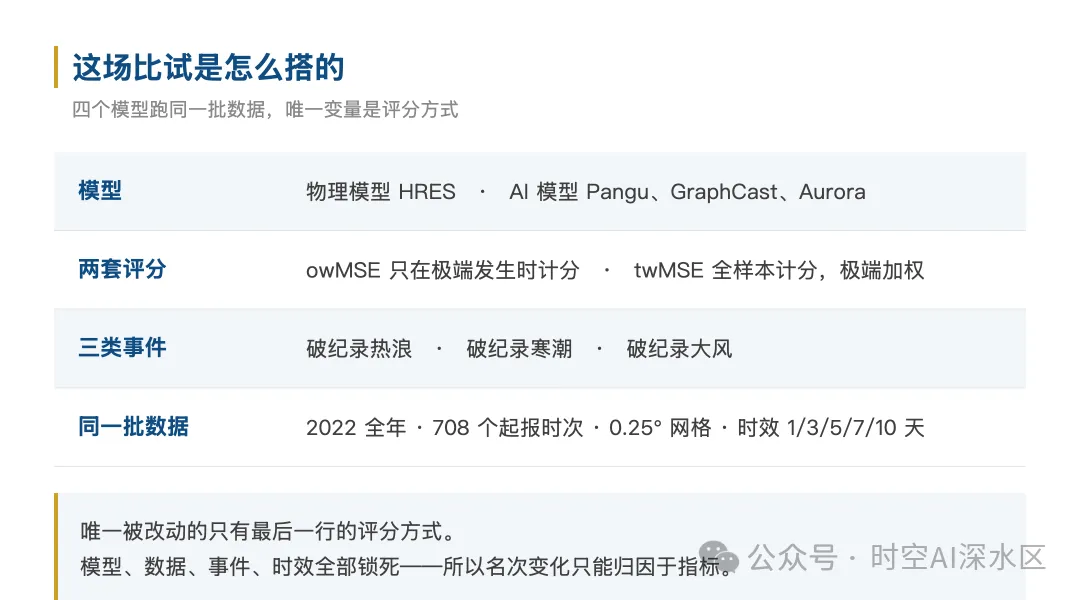
自制示意图|依据论文第 3 节实验设置整理。四个模型、三类事件、同一批数据全部固定,唯一变量是评分方式。
一类是靠物理方程推演的数值天气预报,论文里用的是 ECMWF 的高分辨率模式 HRES。另一类是用历史数据训练出来的 AI 模型,比如 GraphCast、Pangu-Weather、Aurora。
这两类模型有个先天差异。AI 模型训练时的目标函数,基本是均方误差或平均绝对误差。物理模型不是。
所以拿 RMSE 去比,等于让一个专门练过这项的人,和一个没练过的人对打。这在方法上不公平,学界早就知道,于是有了各种公平比较的方案。
问题就出在这里。方案不止一种。
同一个实验,换个指标,名次对调
一种做法叫 owMSE,也就是发生加权均方误差。只在真实发生过极端事件的样本上算分,看谁报得准。
另一种叫 twMSE,阈值加权均方误差。全样本都算分,但极端事件的分量被放大。
两种做法听起来都在关注极端,但它们偏袒的模型正好相反。
论文把机制说得很清楚。owMSE 不惩罚误报,模型在这一侧怎么滥报都不扣分。twMSE 反过来,它对误报的惩罚是漏报的三倍。同一个实验设计,同一批数据,换个指标,名次对调。
论文的结论是:只看观测到的极端事件,物理模型倾向于最好;用阈值加权评分,AI 模型总体上更好。
具体到模型也值得记一笔。全数据口径下,第一天的物理模型分数略低;时效拉长以后 Aurora 的温度预报最准,GraphCast 在一周以上的风速上 MSE 最低,而 Pangu-Weather 在多数设置里垫底。
换成看破纪录事件,画面就变了。owMSE 下物理模型在三类记录、各个时效上通常分数最低,Pangu 最高,这正好复现了 Zhang 等人 2026 年的结论。而 twPCRPS 下,物理模型不再稳定领先,与 Biegert 等人的结果对上了。
这就解释了开头那三个打架的结论。他们不在同一条赛道上。
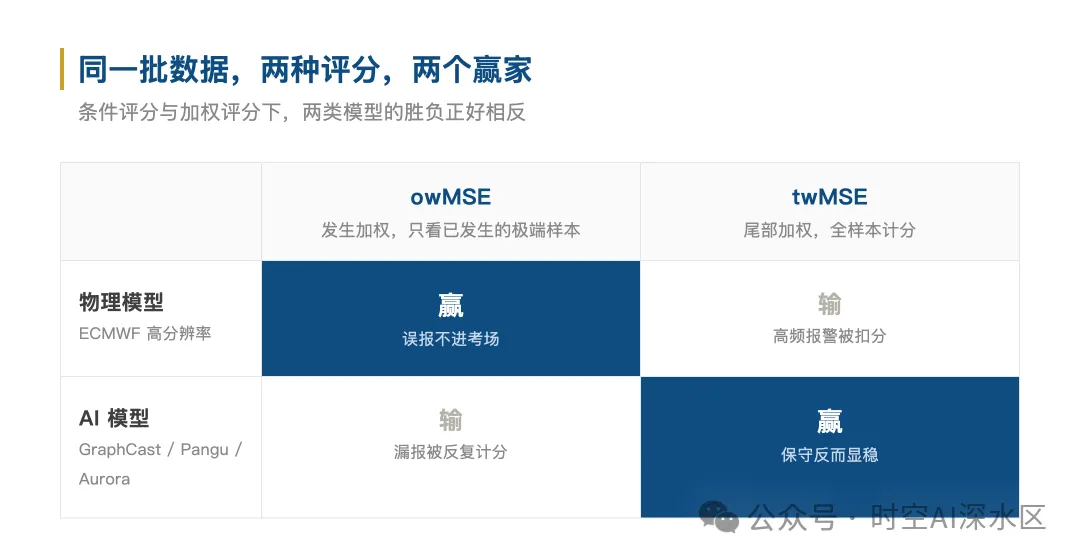
左:owMSE 下物理模型领先;右:twMSE 下 AI 模型反超。同一批数据,两套指标,名次对调。自制示意图,依据论文摘要与 Table 2 结论绘制。
这里有个更值得记的概念,论文引的是 Lerch 等人 2017 年的说法,叫预报员困境。只统计真实发生过极端事件的样本,那些报了但没发生的误报,直接不进考场。这就等于系统性地偏袒更爱报警的模型。
你想想现实里的场景。一个人天天喊狼来了,另一个人几乎不喊。如果只统计狼真的来了那几次谁喊对了,天天喊的人赢。因为他的分母本来就大。
但如果把误报也算成本,结论立刻反过来。天天喊的人被罚得很惨,不喊的人反而显得稳重。
预报评分就是这样一个东西。你怎么设考场,决定了谁是好学生。
拆开看:AI 不敢报,物理模型爱报
论文用列联表把错误拆成两类。
AI 模型的问题是不敢报。它预报极端事件出现的频率,低于实际频率。分数主要被漏报拖累。
物理模型不是这样。它的分数主要被误报拖累。
这个判断有具体数字支撑。论文统计了热浪、寒潮、大风三类破纪录事件,物理模型的漏报率在三类里都是最低的,分别是 46.89%、48.68%、62.30%。
频率偏差更能说明问题。所有 AI 模型的这个值都小于 1,意思是它们预报极端事件的次数偏少。物理模型在寒潮和大风上接近 1,分别是 0.945 和 0.994,基本不偏;只有热浪这一类到了 1.521,属于明显高估。
再看误报的代价。在阈值加权评分下,物理模型的分数里有 65.1% 到 85.7% 来自误报。也就是说,这套指标下它大部分的分差,都是在为报错了的事件付账。
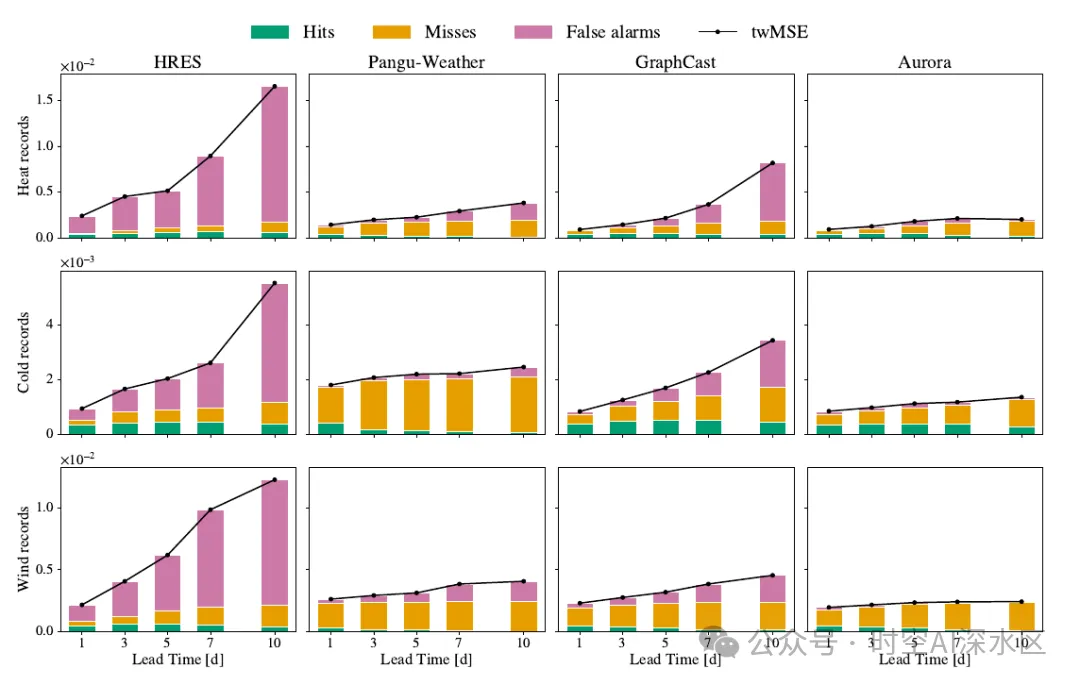
论文原始 Figure 3:四列是四个模型,纵向三行分别是热浪、寒潮、大风破纪录事件。绿色命中,橙色漏报,粉紫误报。物理模型(HRES)的粉紫块随预报时效迅速膨胀,AI 模型则以橙块为主。图源 arXiv:2610.31237 Figure 3。
现在再看那两套指标,偏袒从哪来就清楚了。
只统计真实发生极端事件的样本,误报被豁免,漏报被放大。误报多的模型在这一侧不受罚,漏报多的模型被反复计分。
加权评分则把所有样本都算进来,误报要付代价。物理模型的高频报警开始扣分,AI 模型的保守反而显得稳。
再往深一层,论文做了分数分解,发现两者差距主要来自校准,不是分辨能力。
分解的时候,出现了一个更反直觉的结果。
同一批模型,在两种指标下拆出来的校准分量,排名正好相反。owMSE 下物理模型的校准分量最小,Pangu 最大。twMSE 下翻了过来,物理模型的校准分量最大,Aurora 最小。同一个词,两套算法,两个相反的结论。
原因在附录里:owMSE 所谓校准,要求模型永远预测极端事件会发生,这本身就不是我们希望模型满足的性质。按它算出来的校准分,方向是歪的。
这两个词值得停一下。分辨能力,是指模型能不能把极端事件和普通天气区分开。校准,是指它报出来的概率,和真实发生频率对不对得上。
论文的结论是:AI 模型不是分不清极端事件,是它报出来的概率,系统性低于真实发生频率。
这个差别很关键。分辨能力差,说明模型没学到东西。校准差,说明它学到了,但不敢用。
一个不敢用的模型,和一个不会用的模型,修起来完全是两回事。前者要调的是错误的定价,后者要补的是模型能力。
换到你的评测场景,这件事还在重演
这篇论文讲的是气象,但它的结构在别处一模一样。
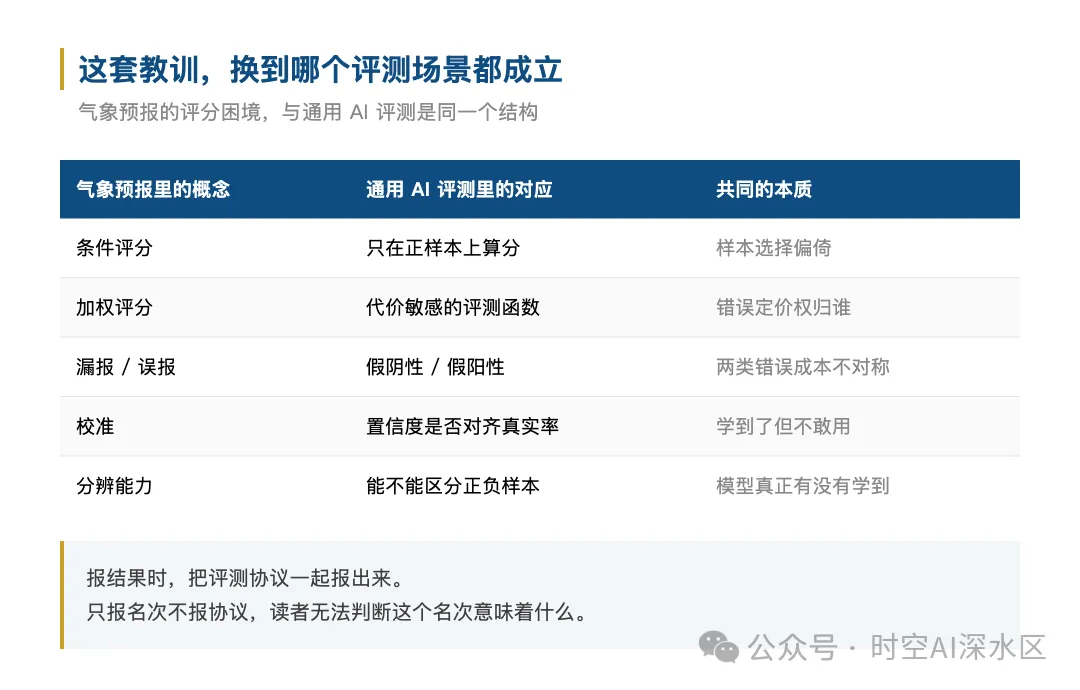
五组概念对照:气象预报的评分困境与通用 AI 评测是同一个结构。自制映射表,结构参照论文核心论证。
举个离得最近的例子。大模型的 benchmark 排名,同样高度依赖你选了哪套题、怎么加权、要不要只统计答对了的样本。换一版评测集,榜首换人,这不是新闻。
再往远处看,任何 A 比 B 强的结论,都藏着一个前提:在什么分布上评、用什么指标评、错误怎么定价。
这三件事一旦没说清,谁更强就是一句没有信息量的话。
论文给的行动含义很朴素:报结果的时候,把评测协议一起报出来。只报名次不报协议,读者没法判断这个名次意味着什么。
对做模型的人,还有一层更实际的。如果你的模型在某个指标上一直输,先别急着改模型,先看看这个指标在惩罚哪一类错误。有可能你输的不是能力,是错误定价。
对做决策的人,也有一层。一个系统报不报极端,价值取决于你更怕哪一种代价。错过一次台风的代价,和空跑十次应急的代价,本来就不相等。
指标是中立的,但指标的后果不是。选指标的人,其实已经在替所有人做了一次风险定价。
我的判断
当指标能决定谁第一,某某模型 SOTA 这个说法就在贬值。以后读到某个模型超越物理模型的结论,先翻到方法部分看它用什么指标。这不是苛求,这类结论的效力本来就依赖于此。
选指标是价值判断,不是技术细节。owMSE 偏袒爱报警的模型,twMSE 偏袒保守的模型,选哪个,等于回答漏报和误报哪个更贵。这个问题气象界吵了几十年没有共识,因为答案取决于你在防什么灾。防台风疏散,漏报是灾难。防农业灌溉,空报一次浪费的是水费。同一套指标服务两个场景,谁都不服谁。
这个坑在具身智能上会更严重。现在的机器人评测大多还在比任务成功率,但物理世界的错误不可逆。撞一次墙就结束了,不像天气预报错一次还能等下一次。如果评测停留在成功率这种粗颗粒指标上,将来一定会在安全边界上重演今天这场争论。
所以别急着追排名。先问清楚,这个排名是在什么条件下、用什么代价换来的。
时空AI深水区
我是 rui,时空大数据方向在读博士。这个号只讲时空数据与 AI,每篇论文先验货,再开讲。