ARTICLE · 1262242
13份体检结果,100多页PDF,用WorkBuddy 30分钟全搞定
上周末下午六点多,家里人复查回来,牛皮纸袋往餐桌上一放,说了句"这回的都在里头了"。
我数了数。13 份,139 页,四个批次。最早的一份是去年 3 月,最新的一份是这个月。
这三年,这样的袋子攒了不止一个。
每次都是往抽屉里一塞,下次去医院再翻出来。医生问"上次那个数值多少",家里人就在包里掏半天。掏出来也白搭——全是扫描件,手机上划不动,字选不中,谈何对比。
这次我说,让我试试。
家里人在旁边看着,来了句:"这玩意儿能认得清吗?我在手机上放大了都糊。"
我说不知道,先试试。
第一步就卡住了。我把 PDF 丢给它,它回我一句:这个文件里没有文字。
不是坏了。扫描件整页就是一张图。你用鼠标在上面划,划不出一个字。它跟我一样,也得先"看见"才行。
那就让它看。
我给的话是:把这个文件夹里所有 PDF 每一页都渲染成图片,再逐页把文字认出来,存成文本。
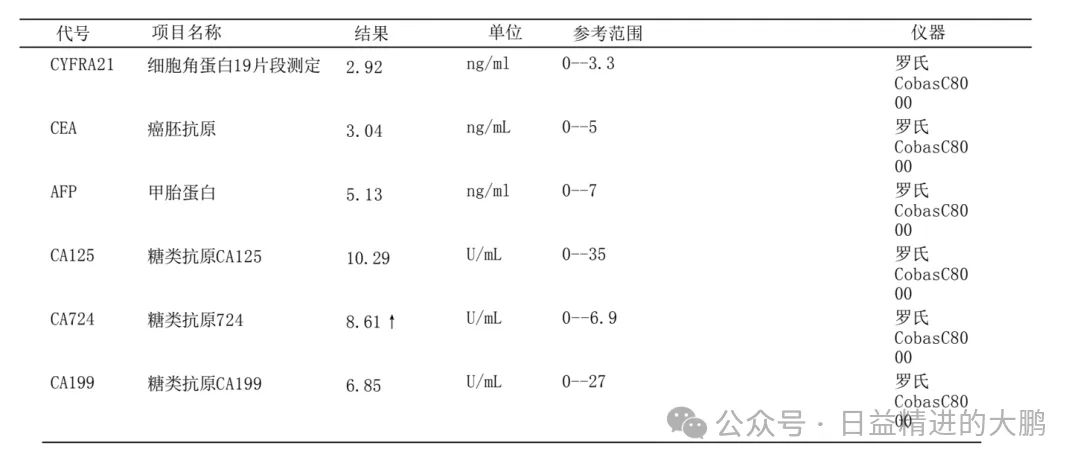
二十来分钟,139 页全认完了。中文医疗报告的识别质量比我想的好,患者信息、项目名称、数值、参考范围、检查结论,一行一行全出来了。
我把其中一份的识别结果跟原件对了两页,家里人凑过来看了一眼,"哟,连那个小字都认出来了"。她没再说什么,转身去烧水了。
中间我犹豫过一次。病历、住院号、身份证号,这些东西传到网上的识别服务去,我不太放心。后来确认是本地跑的,文件一步没出门,才敢往下做。
认出来的化验单长这样。姓名、年龄、住院号那一条我都裁掉了,只留项目和数据:
认字只是最便宜的那一步。
真费劲的在后面。它认出来的表格,数值跟表头对不上——病理免疫检测那张最典型,几个数值整行错位,看着还挺合理,我拿原件一对才发现位置错了。从那以后我给自己定了条规矩:它交回来的是录入稿,不是结论;凡是数值,必须拿原件核一遍。
还有一类它实在认不出:骨密度报告"印象"那一栏是勾选项,框里有没有打勾,它看不见。
真正让我坐直的是第三步。
AI还能把四个批次的检查数值按日期并排,做成一张跨年份的对比表。一并排,之前单看一份报告时怎么都注意不到的东西,自己跳出来了。
抽血化验那几张放一起就是这个效果——同一个项目,三个日期,箭头一直在:
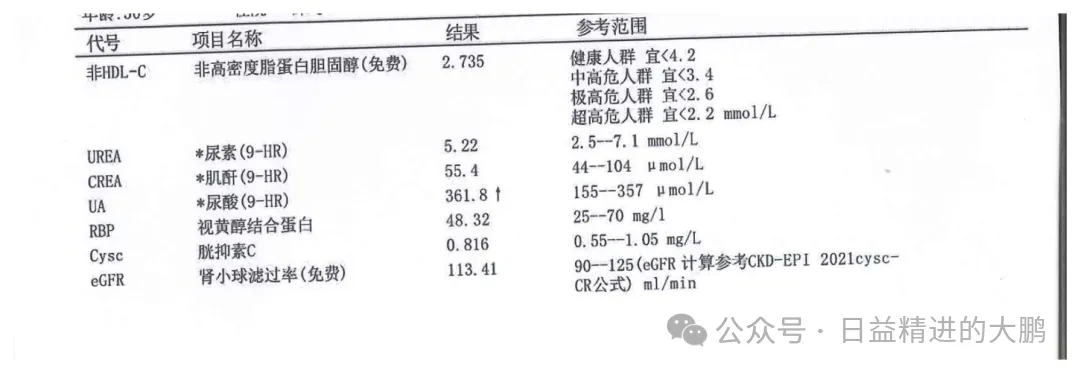
抽血化验做了一轮又一轮。甘油三酯,高。尿酸,高。血脂,高。一次两次没人当回事,因为每个人每次看的都是"这一次"。
还有一条更扎眼的。睡眠监测报告上写着:AHI 46.2 次每小时,最低血氧 76%,重度睡眠呼吸暂停。
这条数据在那儿躺了很久。每次复查医生都在看血常规那几个指标,节奏快,没人往这边多停一秒。
不是谁的错。是没人把它们放在一起看过。
跨日期对比值钱的地方,不在省了几分钟,在于它能把一条藏在每一次"都还行"里的曲线拽出来。
那天晚上我把表从头看到尾,心里有点后怕。不是说以前漏了什么天大的事,而是这一年半,我们每次只看"这一次",从来没人把"每一次"摆在一起看过。
说到底,体检报告最没用的地方就是"攒着"。攒一年是一摞纸,攒三年是一个谁也说不清的抽屉。
它替不了的部分我也说清楚。它交回来的是整理好的录入稿,不是诊断——这张表说明什么、要不要紧、接下来怎么办,得医生说了算。我能做的,是让下次去医院的时候,医生问"上次多少",家里人能一句话答上来,不用再翻包。
想试试?打开 WorkBuddy,对它说一句:
"把这个文件夹里所有体检报告 PDF 都认出文字,按检查日期整理成一张异常项对比表,认不准的格子单独标出来。"
一句就够。别替它想步骤,它自己会拆。
你们家里,是不是也有这么一个抽屉?