ARTICLE · 1269956
EasyAI_RK3588/50路1080p关键帧识别/每路多算法/WorkBuddy 智能助手+8agent智能体-深度解析
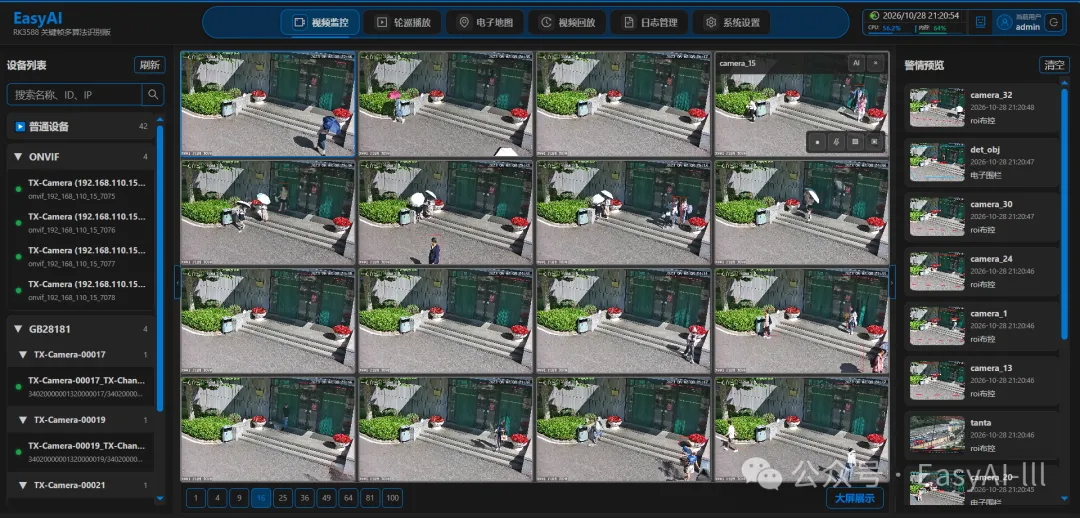
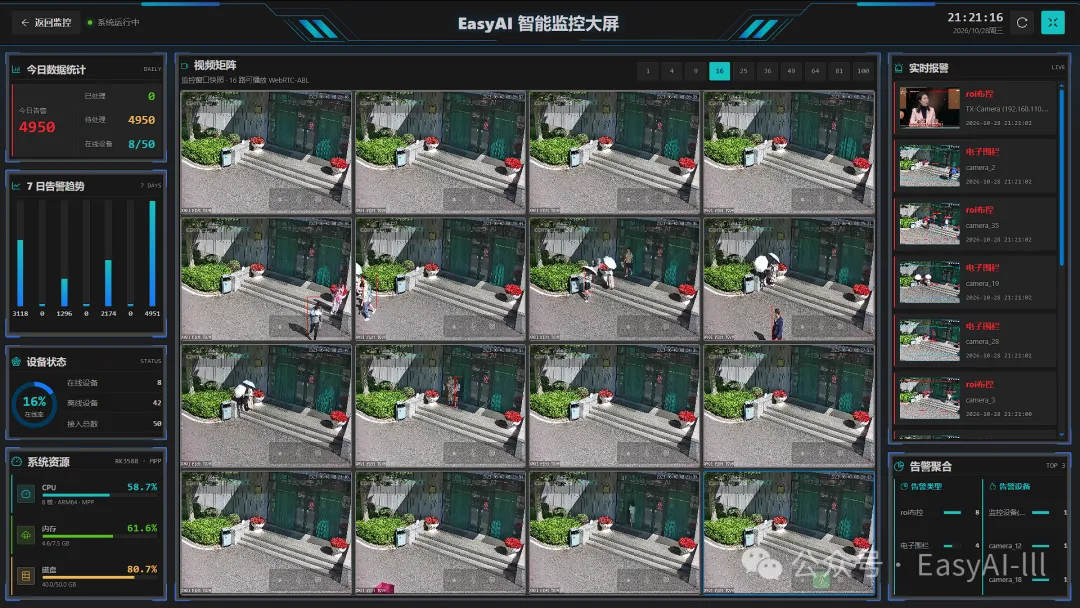
EasyAI_RK3588 凭什么能做到 50 路:七项关键策略,把算力花在真正需要分析的画面上
EasyAI_RK3588 关键帧版面向 50 路,靠的是七项协同策略:压缩流直推、关键帧硬解、RKNN/NPU 推理、模型任务共享、候选帧调度、队列隔离、异步报警与大模型回调。每一项都对准一段实际负载:
**推流:H.264/H.265 + BSF 压缩码流直推。**视频完整连续地送出去,预览不必逐帧解码后再重新编码。 **解码:只为识别需要的关键帧调用 Rockchip MPP。**MPP 输出 NV12,非识别帧不做模型图像转换。 **推理:RKNN/NPU 承担算法推理,多路复用同类模型/算法任务。**设备自己的 ROI、参数、运行时段和报警状态仍独立。 **调度:ROI、离岗、电子围栏、共现按候选关键帧跳帧;OCR 按秒限频。**控制算法调用密度,不把跳帧参数误当成视频帧率。 **队列:拉流处理、算法识别、推流、报警分开排队并限制积压。**拥塞时记录丢弃,避免旧帧无限堆积拖高延迟。 **报警:算法规则判定后由设备回调组装图片与 JSON,再异步 HTTP 发送。**识别、报警和网络发送不互相等待。 **复核:大模型走异步请求与结果回调。**普通视频关键帧直接检测,GB28181 可复核算法报警,各自按业务规则处理。
看数字更直观:**50 路 × 25 FPS = 每秒 1250 个输入帧;若 GOP 为 50,平均约每秒 24 个关键帧识别候选。**完整码流仍持续推送,识别图像候选在这个示例中约为逐帧处理的 1/50。I 帧间隔、算法组合、跳帧、录像和队列状态会改变实际负载,这个估算说明的是架构如何省下处理量,不是脱离现场条件的实测承诺。
这就是 EasyAI_RK3588 关键帧版面向 50 路设计的工程方法:**码流直推减掉逐帧编解码,关键帧识别减掉大部分像素处理,同类任务复用减少重复资源,队列与回调守住实时链路。**下面逐项拆开看技术如何落地。
一、六个技术抓手,支撑七项关键策略
1. H.264/H.265 压缩码流 BSF 直推
普通视频预览不需要每帧都先解码成像素、再编码回视频。EasyAI 对 H.264/H.265 压缩包做 BSF 格式适配后逐包推流,关键帧参数集按需补齐;播放器收到完整码流后,按正常参考关系解出连续画面。
**省下什么:**多数预览场景不必为推流承担逐帧解码、颜色转换和重新编码成本。输入带宽和推流本身仍然存在,但像素处理负载显著不同。
2. 只为识别需要的关键帧准备图像
I 帧是帧内编码画面,解码它不需要先解出前面的 P/B 帧;但仍然需要 H.264/H.265 参数集和完整帧数据。P/B 帧依赖参考图像,从码流中间单独抽出 P/B 帧去解,缺少参考帧就可能花屏、块状错乱或没有有效画面。
EasyAI 让预览继续走完整压缩流,识别则按关键帧候选取图。识别不是“只传 I 帧”,而是“完整视频照常推,只有需要分析的关键帧才转成像素图像”。
**省下什么:**不再把每路每秒 25 张甚至更多图像都送去算法识别,图像解码与预处理围绕关键帧候选展开。
3. RKMPP 硬解,NV12 按需进入识别
关键帧图像优先由 Rockchip MPP/RKMPP 解码,输出 NV12。符合条件的推流路径可使用 MPP 的 DMA/DRM 帧;识别路径需要模型输入时,再将图像准备到主机缓冲区,转换为 RGB 并按设备配置旋转,然后送入算法调度器。
**省下什么:**H.264/H.265 解码交给 RK3588 视频硬件;非识别帧避免无意义的颜色转换。这里不把“硬解”包装成“全流程零拷贝”:识别图像仍可能涉及映射、复制、转色和旋转,这些成本要如实计入容量。
4. 多路共享同类模型任务,设备规则仍独立
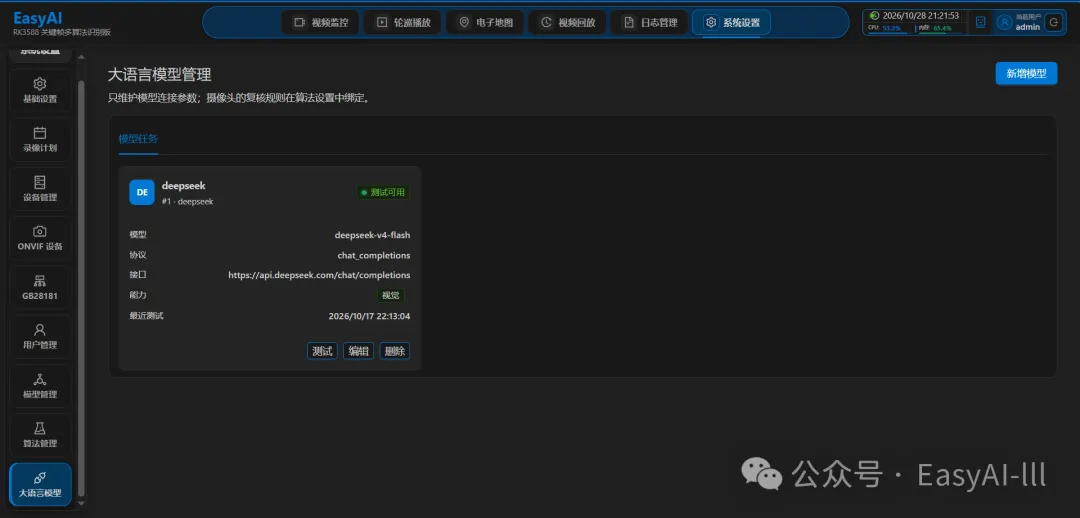
同类模型/算法任务供多路设备复用,避免每路重复创建相同推理资源;每台设备自己的 ROI、运行时段、算法参数、跳帧状态、报警间隔和业务事件仍分别维护。共享的是模型与任务资源,不是把不同设备的规则或报警结果混在一起。
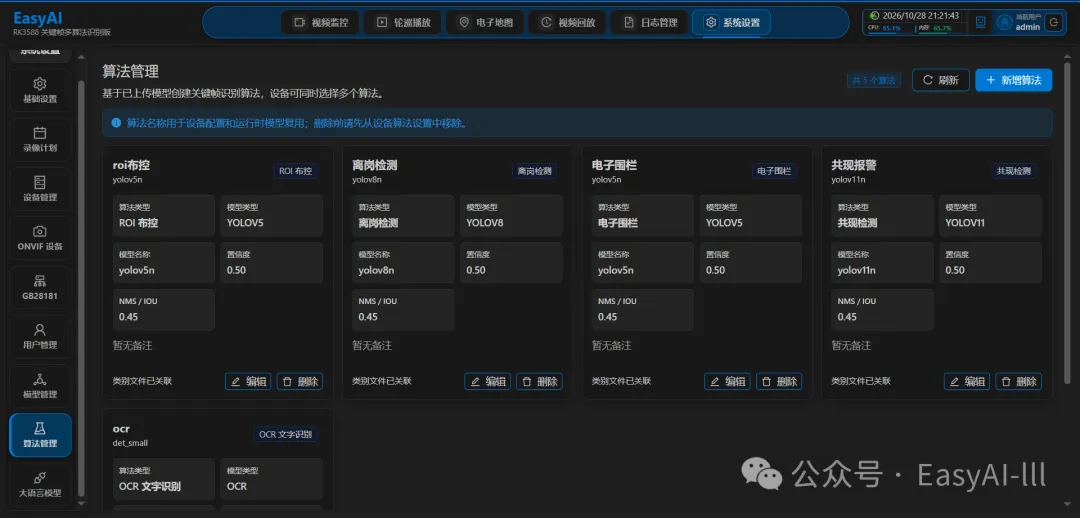
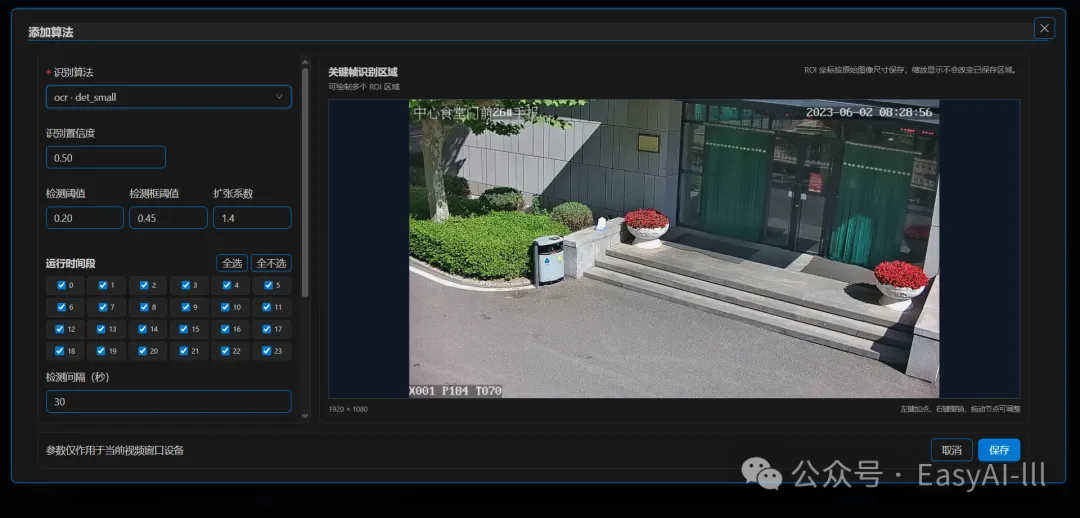
关键帧版当前开放 ROI 布控、离岗检测、电子围栏、共现报警和 OCR。前四类的 skip_framenum 按候选关键帧计数;设置为 2,表示一次识别后跳过接下来的 2 个候选关键帧。OCR 的 interval_seconds 是秒级限频,不是跳帧数。
**省下什么:**复用重复模型/任务资源,并让各算法按业务频率运行。跳帧降低模型调用量,但它发生在关键帧解码和图像进入算法调度之后,不能追回已经发生的解码、拷贝和转色成本。
5. 解码、识别、报警和推流分队列处理
压缩包解码队列、算法图像队列、报警队列和推流侧队列各自服务不同工作。队列设置上限,避免旧图像无限排队,让某一段变慢时不至于把整个处理链路拖成越来越大的延迟。
算法图像队列实时优先,满载时拒绝新识别图像,不积压旧 RGB 帧;报警队列和 HTTP 客户端也有各自的发送条件。过载时系统可能丢弃待处理候选或跳过发送,因此要同时监控队列长度、丢弃计数和接收端结果,不能只看设备是否在线。
6. 算法规则、报警回调和大模型异步解耦
模型识别结果还要经过区域状态、停留/离开时长、算法报警间隔和事件状态判断。符合条件后,识别调度器通过设备回调交还图像、报警 JSON 和设备上下文;普通报警发送线程再把图片编码为 JPEG/Base64,与 JSON 一起异步提交 HTTP。
**带来的变化:**解码线程不用等算法回调或网络发送;报警也不是模型一返回检测框就算送达,而是经过规则判定、队列、图片编码、HTTP 客户端和接收端处理。
二、关键帧到报警:一条完整的数据流
一帧从输入到报警,依次经过:
拉流读取压缩包 → H.264/H.265 经 BSF 逐包直推 → 关键帧进入设备处理队列 → MPP 解码为 NV12 → 按需复制并转换 RGB → 算法异步队列 → RKNN/NPU 推理与规则判断 → 结果回调 → 图片和报警 JSON 入队 → JPEG/Base64 编码 → 异步 HTTP 发送。
从代码入口看,普通视频主线是 forward_passthrough_packet → queue_decode_packet → process_video_packet → submit_mpp_packet / process_mpp_decoded_frame → multalg_imagedet_taskscheduler_manage_process_async → async_recog_thread → recog_result_callback_fun → alarmdata_send_thr。算法结果回调把结果图、JSON 和设备任务上下文交回业务层;每项报警都可以沿设备 ID 与事件信息继续追踪。
本地视频按流时间戳与视频帧率控制播放节奏,压缩包优先使用 DTS 推进,避免 B 帧 PTS 顺序造成不均匀读取。实时流则跟随输入到达。推流队列满时,H.264/H.265 不能简单地任意删掉一个参考包继续发送;需要丢弃时要恢复到可用关键帧,重建解码参考链,否则客户端就会花屏或等不到画面。
算法的 timeout_time 是停留/离开等业务持续时长门限,例如目标进入区域后需要持续多久才报警;它不是拉流超时、模型请求超时或 HTTP 超时。只有有效报警节点才进入业务回调。普通算法报警回调会按事件签名节流,按配置启动报警录像,把设备 ID、时间、报警算法结果和录像路径组进 JSON,再连同对应图像压入 ls_alarm_image。
普通算法报警队列默认上限为 4,满载时记录丢弃;当前普通视频 chart 报警辅助入口没有检查同一个容量上限,属于需要留意的实现边界。报警发送线程取出图像后编码为 JPEG/Base64,写入 JSON 的 alarm_image 字段,再提交主、备用 HTTP 地址。HTTP 客户端不可写时会跳过本次发送;进入异步客户端队列不等于接收端已落库。
三、大模型复核:请求异步发出,回调决定报警去留
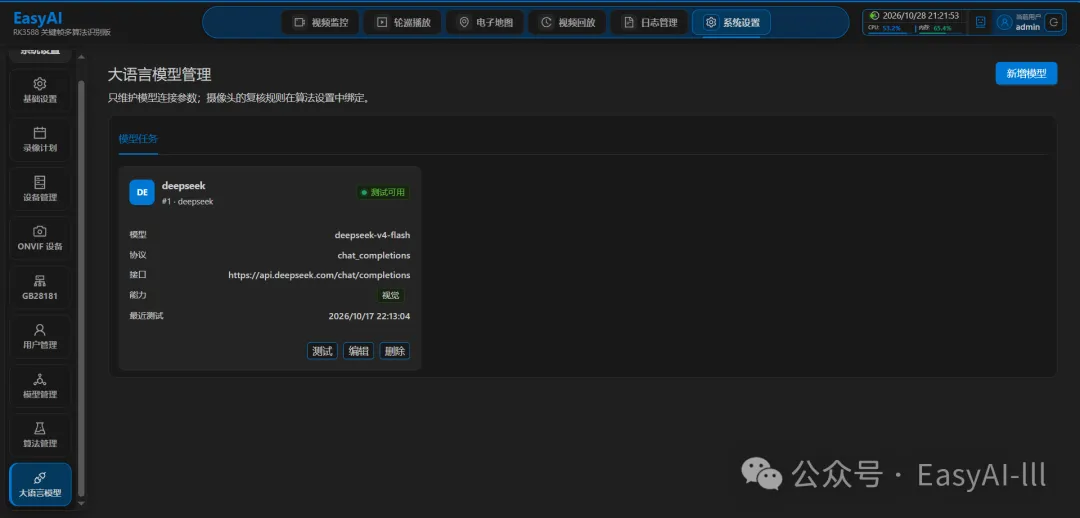
大模型不在每一帧上运行,也不是算法回调里自动执行的一步。关键帧版的大模型入口按设备类型有不同语义。
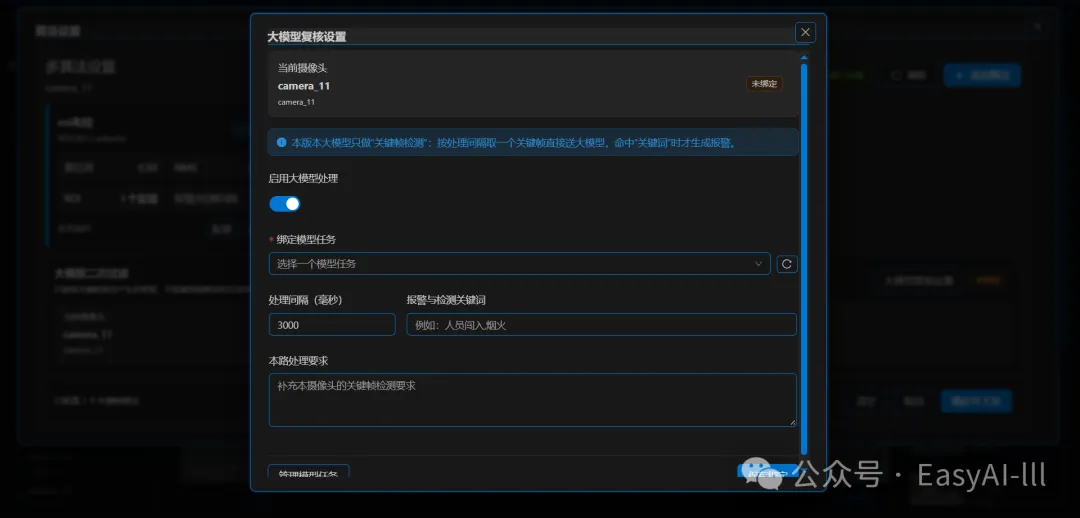
普通视频:chart 让模型直接识别关键帧
设备绑定 chart 后,业务按配置间隔从关键帧路径取图,带着图片、提示词和关键词异步提交大模型网关。请求上下文保存设备 ID 与本次图像;同设备请求未返回时不重复提交,超出保护时间后允许重试,解码线程不会等待模型。
模型返回后由回调检查请求状态和关键词。命中时生成 LLM 报警 JSON,把本次关键帧图像一起放入报警队列,随后沿普通报警发送线程编码并异步 HTTP 上报;未命中或请求失败则不生成 chart 报警。
对应异步调用链是 llm_review_chart_async → llm_model_gateway_manage_chart_camera_async → llm_review_chart_callback → 报警队列。回调上下文保留设备、关键词和原始关键帧,模型结果返回后才决定是否形成报警。
这叫“大模型直接检测关键帧”,不是“算法报警的大模型二次复核”。当前普通视频算法报警仍按算法规则直接进入报警队列;代码中虽保留复核回调辅助函数,普通算法报警路径没有接入它。
GB28181:review 复核算法报警
GB28181 有独立的取流、MPP、结果回调和 HTTP 发送流程,不使用普通视频的 ls_alarm_image 发送线程。绑定 review 时,算法报警会连同图像和原报警 JSON 异步提交大模型;回调命中关键词才放行原报警,未命中则抑制。
模型请求失败、提交失败或复核上下文创建失败时,GB28181 采用 fail-open,直接放行原报警;同一通道的复核请求挂起期间,新报警也直接发送,避免积压。放行后 sendAlarmNow 将图像编码为 JPEG/Base64,连同报警 JSON 和设备/通道标识经异步 HTTP 发送。
对应调用链是 sendAlarm → llm_model_gateway_manage_review_camera_async → onAlarmReviewResult → sendAlarmNow。这里的回调处理原算法报警的“放行或抑制”;chart 回调则是模型直接识别关键帧后“生成或不生成新报警”,两者不是同一个动作。
GB28181 也支持 chart 关键帧直接检测。当前兼容逻辑允许历史 review 绑定触发关键帧检测;chart 命中后形成的报警还可能再次进入 review 闸门。因此,排查 GB28181 大模型链路时,要看清楚本次回调来自“算法报警复核”还是“关键帧直接检测”。
OCR:识别结果独立上报
OCR 结果从普通报警节点中分流,单独发送到报警地址下的 /ocr/result;GB28181 也走独立 OCR 上报。OCR 可附带关键帧图片用于结果展示,但不混入普通算法报警和 LLM 复核流程。
四、50 路怎么算:把平均负载和突发负载分开
拿 25 FPS、GOP 50 做条件化估算:
每路平均约 0.5 个关键帧候选/秒; 50 路合计约 24 个关键帧候选/秒; 某一个算法若 skip_framenum=1,理想平均模型调用约减半到 12 次/秒;跳帧降低模型调用,不会同步减掉前面的关键帧解码与图像准备成本。
这只是固定 GOP、算法全时运行、没有队列丢弃时的平均估算。摄像机关键帧可能同时到达,可变 GOP 会改变候选率;每路算法数量、跳帧参数、录像模式、大模型频率、推流客户端数也都会改变整机负载。48 路不是脱离配置的保证值,必须明确测试条件。
验证时逐路记录编码格式、分辨率、帧率、GOP、码率、算法和模型绑定、skip_framenum、OCR 间隔、预览客户端及录像方式。全机同时记录关键帧到达率、MPP 解码成功率、算法入队/完成/丢弃数、NPU 推理耗时、报警队列与 HTTP 实际送达、推流连续性、录像连续性、CPU/内存/温度和网络流量;稳定运行与关键帧集中到达都要测。
结语:50 路不是单点性能,是整条链路的结果
EasyAI_RK3588 关键帧版做的不是把视频变少,而是把计算分配得更准:完整压缩流持续直推;MPP 只为需要图像的关键帧解码;RGB 只进入识别链路;同类模型任务由多路共享;算法规则与大模型结果通过异步回调进入报警发送。
BSF 直推减少视频处理,I 帧/GOP 降低识别候选密度,跳帧控制 NPU 请求,队列保护实时性,回调把算法、报警和网络发送拆开。它们共同构成 50 路的工程基础。最终路数由现场码流、算法组合、录像和预览负载,以及长时间实测决定。
关键帧的价值,是让完整视频继续流动,同时把 RK3588 的解码和 NPU 推理资源集中用在真正需要分析的画面上。