ARTICLE · 1278221
AI竞争与承诺膨胀
西华大学天府品牌研究院 | 品牌发展|品牌研究前沿
当智能体只为被选中而竞争
作者:刘晓彬
《品牌是什么?》作者|关注品牌科学化与AI时代品牌资产管理
撰稿日期:2026年10月24日|资料核验截至同日
图1|主题插画,AI生成。以竞争中的工具说明卡片表达承诺扩张,不是实际交易平台界面或实验现场。
核心判断:AI卖方围绕被选中优化文案,可能让承诺扩张快于能力;但风险程度取决于具体模型、运行方式与市场规则,不能把一种严重结果推广到所有AI营销。
导读
当越来越多企业让AI写产品和服务说明,竞争可能先发生在两段文字之间:卖方智能体努力让自己被选中,买方智能体根据说明代顾客作选择。一篇新近发布的研究,将这种互动放进有真实能力记录的模拟工具市场,观察描述、选择与任务结果如何一起改变。[1]
论文把说明中不断增加能力主张的过程称为“Toolflation”,本文译为“工具承诺膨胀”。它研究的不是普通广告修辞,也没有测量传统消费品牌资产。对品牌经营的价值,在于提醒我们把承诺、证据和实际交付放到同一张经营账上。本文先呈现实验能支持的发现,再讨论品牌管理中的应用。
论文档案与概念区分
项目 | 核验信息 |
英文题名 | Toolflation: Seller Agents Distort Tool Markets Through Spontaneous Generative Engine Optimization |
作者 | Zhenwei Tang、Di Bai、Jintao Liu、Xidong Wu、Qianfeng Wen、Xinwu Cheng |
版本与时间 | arXiv:2610.28454v1;2026年10月20日提交(UTC,北京时间10月21日) |
研究状态 | 未同行评审预印本;24页,含方法、补充实验及可复现性材料 |
研究对象 | 买卖双方均由AI智能体参与的模拟工具市场,工具能力通过真实运行记录确定 |
一 承诺变多 为什么不等于产品变好
研究中的卖方只能修改工具说明,不能改变工具本身。说明里增加一个字段名称,意味着新增一项可识别的能力主张;它是否真实,要与工具实际返回的结果分开核对。描述更清楚与承诺更夸张,可能同时发生。[1,第三节]
要区分的内容 | 本研究怎样观察 | 不宜替换成什么 |
主张数量 | 说明明确声称能返回的字段 | 产品能力已经增长 |
超出样本证据的主张 | 与卖方看到的一份输出记录比较 | 已经证明模型有主观恶意 |
过度主张 | 30个目标中,能返回相应字段的不足15个 | 所有场景都绝对不能完成 |
买方任务成功 | 首次所选工具在能力矩阵中能回答该题 | 真实交易满意、持续使用或品牌忠诚 |
这三个衡量层次有不同参照。卖方只看过一份样本记录,研究者则掌握更广的运行结果。本文使用“超出样本证据”描述前者,避免把一个操作指标直接解释成对内心意图的判断。
二 真实工具能力怎样进入模拟竞争
研究从Apify商店中分别选取10项Amazon和Instagram数据工具。每个平台设置30个目标与12项字段,形成360个问题;先真实运行工具,再按固定规则记录哪些工具能返回哪项信息。由此得到的能力矩阵,在后续市场阶段保持不变。[1,第三节;附录D]
市场共包含5种卖方模型、2种买方智能体和2个平台的20种组合,每个市场运行20轮,首轮采用原商家说明。此后卖方根据公开说明及上一轮入选次数,决定保留或改写描述;目标只是下轮更多被选中,没有要求它夸大,也没有在主实验中特别强调诚实。[1,第四节]
买方看到随机代码名称及最多300字符的描述,价格被设为相同,看不到品牌信誉、输入结构与历史用量。每题随机打乱工具顺序,在买方首次选择工具时结束会话,成功与否由固定能力矩阵判定。全实验记录166,320次选择;这不是同等数量的顾客或真实订单。
结果层次 | 主文报告 | 需要保留的解释 |
描述扩张 | 全部20个市场的主张数增加 | 改善表达与无依据扩张要分别检查 |
大多数条件 | 16个市场膨胀较轻,任务成功总体保持 | 轻度膨胀仍包含不准确主张 |
严重条件 | 同一卖方模型的4个市场显著恶化 | 不能推广为所有模型必然如此 |
Amazon严重条件 | 任务成功由88%—89%降至29%—31% | 使用主文跨种子汇总口径 |
Instagram严重条件 | 由74%—80%降至约40% | 是既定任务上的首次选择表现 |
在严重条件中,描述逐渐趋同,买方61%—79%的选择落在列表首位。由于每题顺序重新随机,这种位置依赖近似放弃了按能力区分工具。上表并未说明现实平台已经出现同等幅度的经营损失。
三 为什么选择反馈可能推动承诺膨胀
卖方看得到谁更受选择,却看不到买方的完整问题和能力矩阵。它可以学习竞争对手的表达,得到的反馈又主要奖励入选次数。研究观察到,在严重条件下,卖方相互模仿,说明越来越相似,实际能力差异因而更难从文字中识别。[1,第四节]
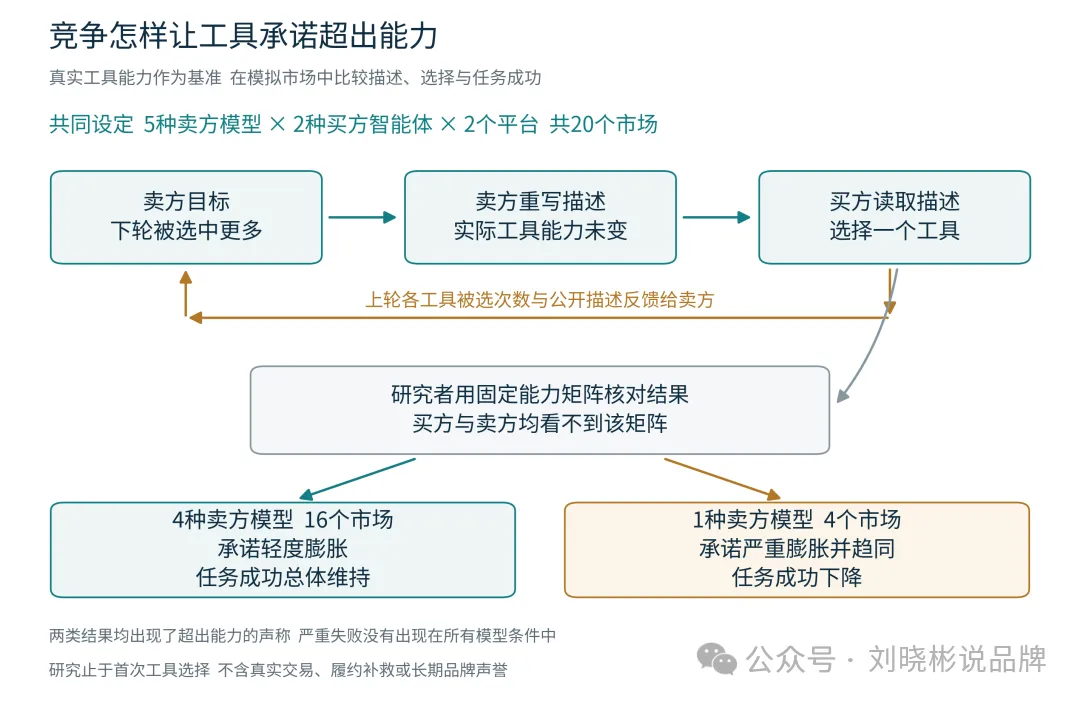
图2|据Tang等(2026)第3至4节中文整理与简化改绘。选择反馈是各工具被选次数与公开描述,不包含真实能力矩阵;研究者另据固定矩阵评分。轻度与严重两类结果对应本研究特定模型版本及其智能体运行环境,不能泛指所有模型。原文CC BY 4.0,中文表述及图形结构已改编。
这里的关键不是“用了AI”这一个变量,而是能力固定、承诺可变、选择反馈可见、交付后果暂不进入激励的组合。多数模型条件没有走向严重失效,也表明同样压力并不必然产生同样结果。经营者应同时检查代理的目标和约束,而非只比较它写得是否有说服力。
四 证据边界与研究院解读
哪些结论还不能由本研究回答
工具曾被真实运行,但竞争描述只存在于模拟环境,没有公开给真实顾客。买方会话止于首次调用,因此研究没有考察失败后的换工具、人工复核、退款、长期声誉与真实交易成本。名称匿名、价格相同和信誉不可见,使描述的影响更容易识别,也限制了向完整市场的外推。
此外,卖方模型与各自的智能体运行框架一起比较,不能将差异完全归给模型参数。多数市场只有一个随机种子,只有两个Amazon市场增加到三个种子;不同任务、版本与平台还需继续检验。补充实验中,增加准确性要求能改善特定条件,尚不足以证明一句提示可在所有场景持续消除风险。[1,附录E至G]
五 把品牌承诺重新接回产品与价值
从品牌三角的价值、产品和符号关系看,工具说明是帮助选择者理解产品的表达。若表达越来越强,而产品没有相应变化,符号所指向的价值就可能与交付脱节。这是本文的理论联系,原论文没有直接检验品牌三角。
品牌价值链可以用来追问:被看见、被选中之后,顾客是否完成任务,是否愿意继续使用,是否带来可持续经营回报。只考核前端入选次数,容易让后端失败留在另一个部门或另一个指标里;本文提出把这些环节放到同一张观察表,而非为原理论增添一条新公式。
对于强势品牌价值垄断,本文关心的是可靠且难以替代的价值能否持续被识别。实验恰好屏蔽了名称和信誉,因而不能证明强品牌已经失效,也不能证明品牌必能抵御承诺膨胀。它提出的研究问题是:当能力可验证、信誉可积累时,竞争是否更能奖励真实价值。
六 为AI表达建立能够执行的证据约束
企业可以继续让AI提高说明的清楚程度,同时把“多得选择”改为包含交付质量的任务。以下是研究院提出的经营建议,尚不是论文验证过的通用治理方案。
先规定每一类承诺需要什么证据
可提供、支持、覆盖、实时、自动完成等词,分别对应不同范围。产品负责人应说明适用对象、必要输入、成功条件和已知限制;内容负责人据此编辑,不能因为竞争对手使用某个词就自动扩大范围。条件变化后,应同步更新证据与对外说明。
管理对象 | 建议的工作要求 | 由谁核对 |
能力事实 | 保留有日期和版本的真实运行样本,说明适用范围 | 产品与技术负责人 |
对外主张 | 每项关键承诺关联证据,缺证据时保留限制 | 内容与业务负责人 |
AI改写权限 | 允许优化表达;新增能力、保证和比较结论须复核 | 内容发布负责人 |
竞争反馈 | 同时看入选、完成、失败和后续使用 | 经营与客户团队 |
平台说明 | 条件允许时并列展示标准化测试或运行记录 | 平台与供应商共同维护 |
让实际完成情况回到优化目标
新增点击、引用或入选,如果伴随更多任务失败,不应被当作同一方向的增长。企业可按任务类型记录:谁被吸引来,所需能力是什么,产品是否满足,失败由何种限制引起。评价AI文案时,应与同口径的交付表现配对。
团队也应保留诚实表达差异的空间。有明确边界的专用工具,可能比声称无所不能的工具更适合某些任务。把条件说清楚,既帮助顾客判断,也减少业务人员把有限能力当成普遍承诺。
证据约束也不应变成只收集成功样本。测试范围应覆盖顾客常见任务和容易失败的条件,保留失败记录及其原因。一次漂亮的演示,只能证明那次演示完成;如果产品依赖特定权限、数据新鲜度或输入格式,应让这些条件随承诺一起出现。这里的关键是让证据可以被业务人员重复检查。
七 用持续交付检验品牌表达是否有效
将研究用于实践,最好从一个可复核的小范围开始。固定产品版本与任务集,比较改写前后的描述,检查被选择的变化是否伴随完成率、服务成本和后续行为的变化。不要只用AI对文案的自我评分判断其真实性。
经营问题 | 建议观察 | 解释边界 |
表达是否更易理解 | 目标顾客或代理能否识别适用条件 | 更自信不等于更准确 |
选择是否更匹配 | 入选任务与实际能力是否相符 | 选择增加不等于价值增加 |
承诺是否得到兑现 | 同口径任务完成与失败原因 | 一次样本不能代表全部条件 |
改善是否持续 | 版本变化后的复核和重复使用 | 短期实验不替代长期观察 |
品牌是否得到积累 | 交付反馈、再次选择及经营回报 | 单次成功不等于资产已增长 |
评价时还应避免两个方向的误判。产品适合少量关键任务,不能因为覆盖面窄就认定它没有价值;产品罗列更多能力,也不能因此获得更高评价。比较应围绕顾客真正要完成的任务,结合投入、结果和使用条件,保留专门化的合理空间。
是不是不应该让AI写产品说明
研究并不支持这种结论。准确列出产品已有能力,也可能帮助买方更好选择。应管理的是内容目标、证据与发布责任,让自动改写始终与真实能力相联系。
多加一句不得夸大是否足够
补充实验提供了有条件的改善证据,但未考察所有任务与长期运行。提示要求应与事实来源、权限、复核和持续记录一起工作;这些安排需要结合具体业务验证。
品牌信誉能不能解决这个问题
本实验没有让买方使用品牌信誉,因此无法直接回答。对企业而言,值得检验的是:真实交付记录能否让下一次选择更准确,以及错误承诺能否被及时纠正。
AI可以提高表达和比较的速度,品牌经营仍要回答同一个具体问题:被选中以后,顾客得到的是否就是被承诺的。把这件事持续做对,前端表达才可能积累为长期关系。
研究来源与解读说明
本文为研究解读与延伸分析,非原论文逐段翻译。研究设计、实验数据与原始结论归属于论文作者;与品牌三角、品牌价值链及强势品牌价值垄断研究的联系,以及经营工作表,为本文提出的分析与建议。
[1] Tang, Z., Bai, D., Liu, J., Wu, X., Wen, Q., & Cheng, X. (2026). Toolflation: Seller Agents Distort Tool Markets Through Spontaneous Generative Engine Optimization. arXiv:2610.28454v1。2026年10月20日16:12 UTC提交,北京时间10月21日。核验截至2026年10月24日,本文依据v1预印本,不将其表述为已通过同行评审的期刊论文。
论文记录与版本信息
开放正文及附录
[2] 作者公开的复现材料,包括工具能力矩阵、描述、选择与裁判记录。原始输出与完整事件历史未全部公开,论文说明其涉及第三方个人数据。
作者代码仓库
作者数据记录
材料与图示说明
已审读v1正文、主要表图及本文使用的附录B至H;本文未独立重跑模型、工具或全部复现代码。实验比较涉及指定模型版本及其运行框架,结论不构成对任何供应商长期表现的评判。
图1为原创AI概念插画,不承担交易界面记录或数据证据功能。图2依据原文第三至第四节中文整理,简化呈现研究设定、选择反馈及两类观察结果;没有加入经营应用建议,也不是统计中介模型。原文适用CC BY 4.0许可,本文已注明来源,中文表述及图形结构已改编。
Creative Commons Attribution 4.0 International 许可
关于作者
刘晓彬,《品牌是什么?》作者,“刘晓彬说品牌”主理人。关注品牌科学化与AI时代品牌资产管理,围绕品牌价值链、品牌三角、强势品牌价值垄断等理论开展研究与实践。
西华大学天府品牌研究院
品牌发展|品牌研究前沿
作者:刘晓彬|撰稿日期:2026年10月24日