ARTICLE · 1278260
【开源】AI 记岔了,你能翻出那条记忆删掉它
【开源】AI 记岔了,你能翻出那条记忆删掉它
上周让它帮你写的周报,这周它又套了同一套句式——连客户名字都还是旧的。
你想纠正它。可你只能打开一个新对话,把背景从头讲一遍。
先说一个大多数人忍着没说的麻烦
用 AI 干活的头一个月,你会觉得它无所不能。用到第三个月,问题开始变得具体:
它记错了,而你不知道它记错了什么。
你让它按你的习惯写文案,它记住了"要口语化",顺便也记住了"每条结尾加个感叹号"——后者是你三个月前随手改的一句话,早就不是你要的了。它每次都照做,你每次都手动删掉,删了三个月。
更糟的是多项目并行。A 项目的技术栈是 Vue,B 项目是 React。你在 B 项目里说"按老规矩写",它给你来了个 Vue 的 <script setup>——因为它把 A 项目的"老规矩"当成了通用规则。
这不是模型笨。模型表现得很聪明,它只是没有边界感。
业界主流做法是把所有东西塞进一个上下文池:项目 A 的记忆、项目 B 的偏好、上周的临时决定、三年前的规范,全在一口锅里。池子越大,串味越容易。等你想清理,你会发现根本没有"清理"这个动作——只有"重开对话",然后一切归零。
记忆不可见,等于不可控。你调不动一个你看不见的东西。
PilotDeck 想换个容器
PilotDeck 是一个开源的智能体操作系统,由清华 THUNLP、ModelBest、OpenBMB 和 AI9Stars 联合开发并开源,采用 AGPL-3.0 协议,主语言是 TypeScript。据 README,该项目目前已有近 5 千 Star。
它没有去做更强的模型编排,也没有去卷更多工具。它先解决一个更底层的问题:AI 干活的地方,应该是一个个独立的舱,而不是一个大通铺。
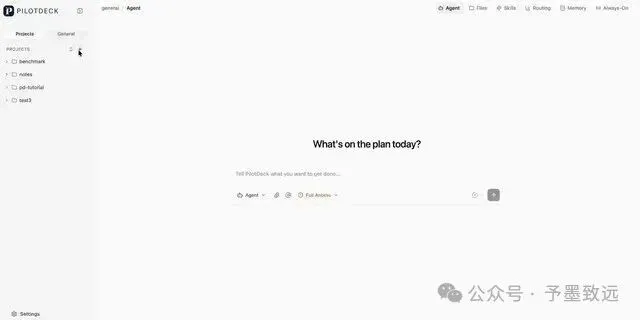
每个 WorkSpace 拥有自己的文件系统、自己的记忆库、自己的技能集。项目 A 的记忆,物理上到不了项目 B。检索范围是有界的,技能是随任务自然长出来的。
这个设计选择听着朴素,但它把前面那两个麻烦一起解决了:串味不可能发生,因为压根没有共享池;至于"记错了改不掉",它选了更笨也更管用的办法——把记忆摊开来给你看。
能力一:工作舱隔离,一个项目一个世界
PilotDeck 把 WorkSpace 当作系统的第一性单位,不是文件夹,是执行环境。
这意味着三件事同时被隔离:
- 文件系统
:每个舱有自己的工作目录,AI 读不到别的舱的草稿 - 记忆存储
:写入时就打上舱的标签,检索时按舱过滤 - 技能集合
:你在 A 舱训出来的写作技能,不会突然出现在 B 舱的候选列表里
对比一下常见的做法:Claude Code、Cursor 这类工具把模型推理深度嵌进了 IDE,强在"写代码这一件事";Claude Cowork 引入了桌面端的项目级隔离,方向对了,但主要面向知识工作;而 PilotDeck 面向的是多项目、长周期的办公场景——你可能同时在做三份周报、两个方案、一个数据看板,它们之间不该有任何关系。
隔离带来的第二个好处经常被忽略:检索变准了。
范围越小,召回越准。全库检索时,AI 得在一万条记忆里判断哪条相关;限定在单个舱里,候选可能只有两百条。这不只是省钱,是回答质量的差别。
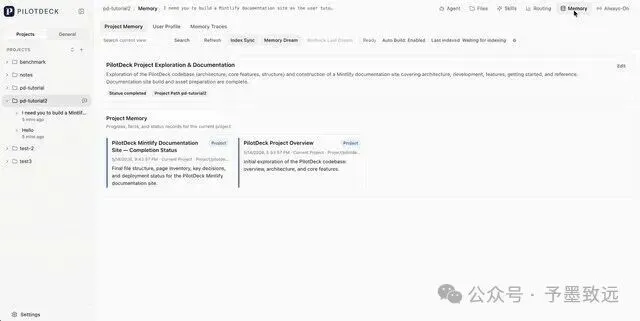
能力二:记忆是白盒,能翻、能改、能回滚
这是 PilotDeck 最不一样的地方,也是我建议你重点看的。
它把记忆的全链路拆成了四段,每一段都可见:生成 → 提取 → 存储 → 检索。
AI 记错了,你可以直接定位到那条记忆,然后改掉或删掉。不用重开对话,不用重新解释背景,不用假装什么都没发生。
它还做了两件配套的事:
第一,关键决策可以钉住。 有些规则你不希望它被"优化"掉,比如"对外文档不许出现内部项目代号"。钉住之后,记忆整合时不会动它。
第二,Dream Mode 带一键回滚。 AI 在空闲窗口会整理记忆——合并重复项、压缩冗长条目。这个过程有风险:压缩可能压掉你以为它记得的东西。所以 PilotDeck 给了回滚。这是我在同类系统里很少见到的谨慎,它承认了自己会错。
对照主流的黑箱记忆,差别很直接:
记忆系统的成熟标志,不是记得多,是错得起。
能力三:按难度派活,账单砍到零头
说完记忆,说钱。这一节有 README 里的实测数字。
PilotDeck 内置智能路由:先判断任务难度,难的交给旗舰模型(如 Claude 3.5 Sonnet / GPT-4o),简单的降级给轻量模型。
在小红书风格的社媒运营工作流里,它给出的对比是这样的:
| $2.83 | 1.1× | ||
从 12.58 美元到 2.83 美元,省掉的不是 10%,是 77%。
更值得看的是第二组:7 个复杂任务(多语言播客推送、多源数据报告、领域文献综述、代码库架构文档等)的评测。结果显示,"强主模型 + 轻子模型"的组合不但更便宜,分数还更高:
| Sonnet 4.6(主)+ MiniMax-M2.7(子) | 70.6 | $3.15 |
70.6 分对 69.1 分,成本从 18.36 美元降到 3.15 美元——约六分之一。
为什么混合还能更准?我的理解是:单个旗舰模型在长链路里会"疲劳",越到后面越容易走捷径;而把执行环节交给专门的子模型,主模型只保留规划和检查点,反而少犯迷糊。
这也正是"跑后台 Agent"能不能算得过账的关键。如果每次都按旗舰价结算,让 AI 通宵干活就是烧钱;降到一个零头,这件事才成立。
配置起来就是一行 YAML。
能力四:你合上电脑,它接着干
PilotDeck 想打破"你问一句、它答一句"的循环。
你交办完就可以走人。它会继续发现候选任务、跑长时间监控,最后把成果落成本地文件,再留一份总结报告等你回来看。
注意"落成本地文件"这个细节。它不是给你一段"我已经帮你整理好了"的漂亮话,而是真的在磁盘上留下 Word、Excel 或 PPT。2.0 版本专门补了这三个办公 Skills,走的就是"一键出可直接用的成品"。
我见过太多 Demo 停在"你看,它能理解我的意图"。理解意图不值钱,交出文件才值钱。
三行命令跑起来
官方给了一行安装脚本,macOS / Linux 用这个:
curl -fsSL https://raw.githubusercontent.com/OpenBMB/PilotDeck/main/install.sh \ | bash
Windows 用 PowerShell(普通用户权限即可):
powershell-ExecutionPolicyBypass-c \ "irm https://raw.githubusercontent.com/OpenBMB/PilotDeck/main/install.ps1 | iex"
装完直接启动,浏览器打开 http://localhost:3001:
pilotdeck # 启动服务 pilotdeck status # 看运行状态
有个前置条件别踩坑:Node.js 必须是 22.13 以上、23 以下。内置 SQLite 运行时依赖这个区间,版本不对会在安装中途报错。
国内网络拉 npm 包慢的话,安装时挂上镜像:
curl -fsSL https://raw.githubusercontent.com/OpenBMB/PilotDeck/main/install.sh \ | NPM_CONFIG_REGISTRY=https://registry.npmmirror.com bash
喜欢容器的话,一条命令也能起:
docker compose up -d --build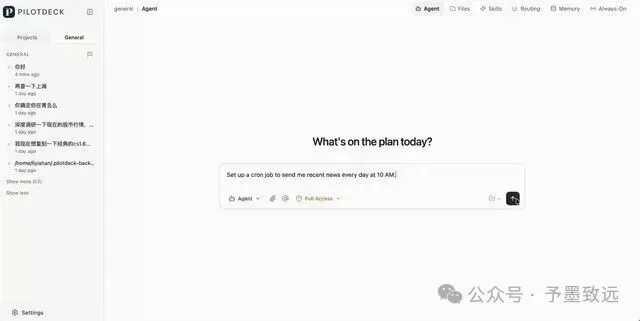
接自己的模型,只改一个文件
配置文件在 ~/.pilotdeck/pilotdeck.yaml。也可以完全不碰文件——2.0 支持在 Web 界面里可视化配置供应商。
手动配的话长这样:
schemaVersion: 1 agent: model: deepseek/deepseek-v4-pro model: providers: deepseek: protocol: openai url: https://api.deepseek.com/v1 apiKey: sk-your-api-key
支持的协议覆盖得比较全:OpenAI、Anthropic、原生 Google Gemini、DeepSeek、Qwen、Kimi、MiniMax,以及任何 OpenAI 兼容端点。
想跑本地模型也不用额外适配,PilotDeck 走 Ollama 的 OpenAI 兼容接口:
ollama serve ollama pull qwen3:0.6bschemaVersion: 1 agent: model: ollama/qwen3:0.6b model: providers: ollama: protocol: openai url: http://localhost:11434/v1 models: qwen3:0.6b: {}
本地模型不需要 API Key。想先零成本试水,这条路最省事。
架构:为什么选"舱",而不是"更长的上下文"
行业里有一派思路是无限堆上下文:窗口不够就扩,扩不了就压缩,压缩不行就外挂检索。方向没错,但它默认了一个前提——所有信息该待在一起。
PilotDeck 的判断相反:绝大部分信息本来就不该待在一起。
所以它的架构是分层的:底层是舱级的文件与记忆存储,中层是智能路由与 MCP 工具接入,上层是三个一致的前端(Web / CLI / IM)——同一套后端,在网页里用、在终端里用、在飞书企微里发消息用,行为是一致的。
整个系统原生支持 MCP,接外部工具不用自己写胶水。要扩展也不复杂,一个 plugin.json 就能挂上四类东西:
- MCP Servers
:任意 MCP 服务,一等公民 - Tools & Skills
:注册自定义工具,或从社区拉技能 - Lifecycle Hooks
:拦截 PreToolUse、UserPromptSubmit等关键事件 - Custom Memory
:换掉默认的记忆存储实现
开源核心和插件定制的边界划得很清楚。这一点对想二开的人来说很重要——你不用 fork 整个仓库去改一行逻辑。
它不适合谁
说点实话,免得你装完失望。
如果你只是偶尔问 AI 几个问题,PilotDeck 是杀鸡用牛刀,一个网页版聊天框足够。
如果你全部工作都在一个代码仓库里,Claude Code 或 Cursor 的 IDE 内体验更顺,它们在这一件事上打磨得更久。
PilotDeck 的甜点区很明确:多项目并行、任务跨天、成果要落成文件、成本要能算账。符合这四条,它值得你花半小时装一下;不符合,收藏就好。
最后
AI 工具发展到今天,拼的早就不是"能不能做",而是"做完之后你能不能放心"。
能不能放心,取决于两件事:它记住的东西你看不看得见,它花的钱你算不算得清。
PilotDeck 把这两件事都摊到了台面上。据 README,项目已有近 5 千 Star,采用 AGPL-3.0 协议,支持一行安装和 Docker 部署。
如果你也遇到过"AI 记错了却只能重开对话"的时刻,这个仓库值得看一眼。
仓库地址:github.com/OpenBMB/PilotDeck
官网和在线 Demo 在 pilotdeck.openbmb.cn,不想装可以先在网页上试。真上手了,欢迎回来聊聊你踩到的坑——尤其是记忆那块,那才是最见真章的地方。