ARTICLE · 1281786
惊呆!1.3B模型OCR神器,秒杀付费软件
惊呆!1.3B模型OCR神器,秒杀付费软件
红果儿 | 2026年10月30日
最近在GitHub上闲逛,挖到一个让我眼前一亮的宝藏项目——面壁智能开源的MiniCPM-OCR系列。这个项目才发布没多久,但性能表现简直让人不敢相信!1.3B的小模型在多个基准测试上碾压了那些动辄几十亿参数的大模型,而且还是开源的,这意味着普通人也能免费使用这种级别的OCR能力。
我为什么盯上它
看到这个项目的时候,我正在找一款好用的OCR工具。之前用过不少OCR软件,要么是收费的,要么就是识别准确率不高,特别是处理复杂文档表格时经常出错。面壁智能发布的MiniCPM-OCR系列有两个模型:1.3B的解析模型和2B的判别模型,虽然参数不大,但表现惊人。MiniCPM-OCR 1.0在Real5-OmniDocBench上取得了93.68分,在OCRBench v2上取得了54.7分的SOTA(最先进水平)。最让我意外的是,经过DSpark加速后,它的处理速度达到了1.217页/秒,端到端效率提升了55%!
它到底是啥
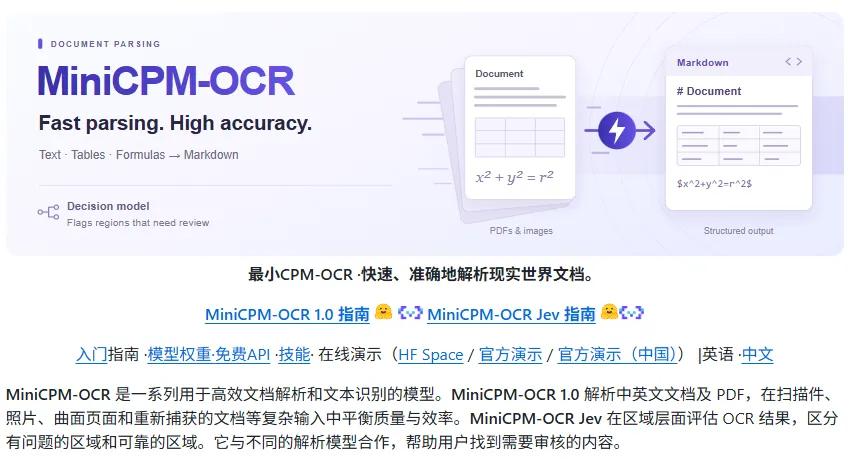
MiniCPM-OCR不是一个简单的图片文字识别工具,而是一套专门为文档理解设计的OCR系统。它不仅能识别文字,还能理解文档结构,提取表格、标题、段落等信息。与那些只能做简单文字提取的OCR工具不同,MiniCPM-OCR能够理解文档的语义关系,这对处理复杂文档特别有用。
它能帮你干嘛
1. 文档表格提取:能从PDF或图片中准确提取表格数据,保留表格结构和格式。比如你可以直接上传一份财务报表,它会帮你把表格数据完整提取出来,方便后续分析。
2. 文档内容理解:不仅能识别文字,还能理解文档内容,自动提取标题、段落、列表等结构化信息。这对于需要快速处理大量文档的研究人员或分析师特别有用。
3. 多语言识别:支持多种语言的文字识别,包括中文、英文等。对于需要处理多语言文档的用户来说,一个工具就能解决所有问题。
安装方法
使用MiniCPM-OCR有点困难,它不是那种下载即用的:
1. 在GitHub上下载模型文件和代码
2. 安装必要的依赖库(Python环境)
3. 运行示例代码,输入要处理的图片或PDF文件
4. 几秒钟后就能得到结构化的文档内容
要注意的坑
虽然这个项目很强大,但还是有几处需要注意的地方:
1. 模型大小:虽然是轻量级模型,但1.3B的模型仍然需要一定的硬件资源,普通电脑可能会运行较慢。
2. 更新频率:项目还处于早期版本,可能会有一些不稳定的情况,建议定期关注更新。
3. 中文优化:虽然支持中文,但在处理某些特殊格式或复杂版式的中文文档时,可能还需要进一步优化。
4. 部署门槛:虽然提供了开源代码,但对于完全不懂编程的用户来说,部署和使用可能有一定难度。
我的判断
• 需要高效处理文档的学生、研究人员和办公人士:值得试,特别是经常需要提取表格和处理大量文档的人。
• 想找免费OCR替代付费软件的人:它的性能已经接近甚至超越了某些付费软件。
• 只需要简单文字提取功能的普通用户:看看就好,如果你的需求只是识别图片中的文字,可能有更简单的工具。
• 一句话总结:它最像是一个轻量级的文档理解专家,把复杂的AI技术包装成了普通人也能使用的工具。
项目地址
https://github.com/OpenBMB/MiniCPM-OCR
这个开源OCR工具的出现,让我看到了AI技术普惠化的希望。以前只有大公司才能用到的先进技术,现在普通人也能免费使用了。如果你经常需要处理文档,不妨试试这个神器,可能会给你带来惊喜!
觉得文章有用,就帮忙点个"赞"和"在看",明天继续帮你挖神器!
📌 访问提示:(注:github.com 为境外站点,国内网络下打开可能不稳定;稍等再试)