ARTICLE · 1282916
从源码理解一个 TypeScript Agent 的执行过程
最近安排了一些 Agent 开发任务,找了几个项目作为学习材料。这篇分析的是社区基于 MiniMax 官方 Mini-Agent 实现的 TypeScript 版本。官方原版使用 Python,主要用于展示 Agent 的核心执行流程。
两个版本的仓库地址:
• Python 原版:MiniMax-AI/Mini-Agent[1],由 MiniMax 官方维护。 • TypeScript 版本:Code-MonkeyZhang/mini-agent-ts[2],由社区开发者基于原项目实现。
这个 TypeScript 版本包含模型推理、工具执行、结果反馈的 ReAct 循环,支持 MCP、Agent Skills,以及 Bash、文件读写等基础工具。代码组织比较直接,可以沿着一次请求读完主要执行链路,适合作为 Agent 开发的入门项目。
本文基于 TypeScript 仓库提交 f0666ad[3]。先把模块关系和执行流程画出来,再沿着一次用户请求往下看。下文关于上下文管理、会话保存和内置工具的判断,均以这一版本为准。
一个具体的问题是:用户说“帮我读一下这个文件”,模型返回一个读取文件的工具调用,后面的文件读取是谁执行的?读取结果又是怎么进入下一次模型请求的?
顺着这条链路,可以把入口、消息历史、模型适配、工具执行,以及 Skills、MCP 的关系串起来。下面的分析依据当前源码,没有运行模型调用和外部 MCP 服务;涉及运行效果的部分,只讨论代码能够说明的行为。
从入口看,先把运行环境装配起来
项目通过命令行交互。入口文件调用 CLI 的 run(),CLI 负责解析工作目录、读取配置、创建模型客户端,注册工具,最后创建一个 Agent 实例。
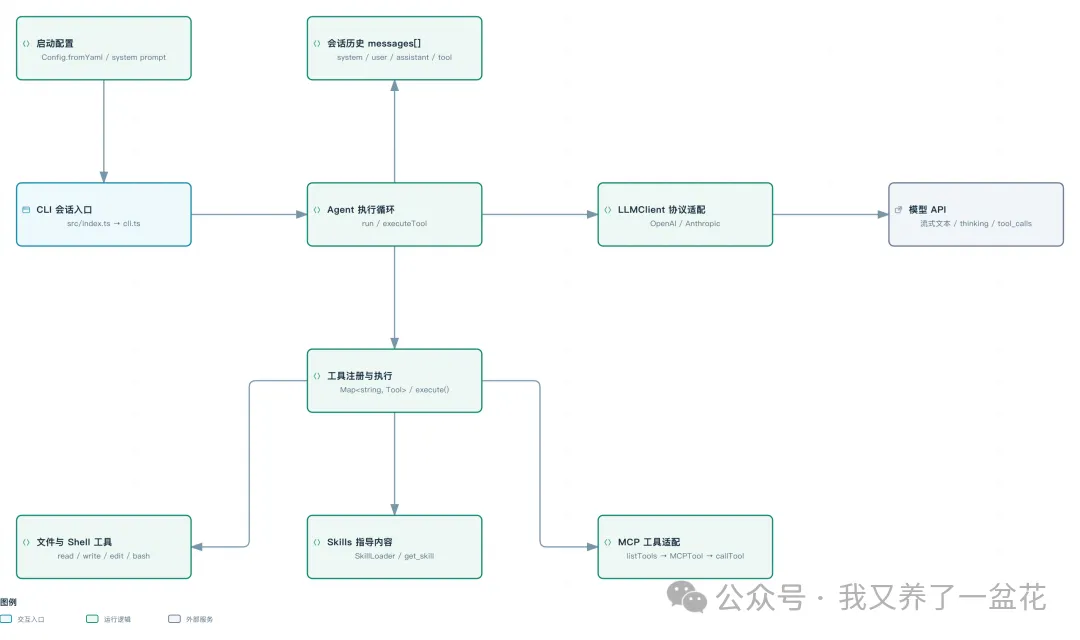
图中的箭头表示主要调用和依赖关系。完整的请求与结果回传过程,可以结合后面的流程图看。
源码可以按下面几个位置阅读:
src/index.tssrc/cli.ts | |
src/agent.ts | |
src/schema/ | |
src/llm-client/ | |
src/tools/ | |
src/skills/ |
CLI 做了比较多的初始化工作,但进入会话后,主要调用关系很短。下面是省略终端输出和错误处理后的调用示意:
const agent = new Agent( llmClient, systemPrompt, tools, maxSteps, workspaceDir);while (true) { const input = await rl.question('You > '); // 省略空输入和退出命令处理 agent.addUserMessage(input); await agent.run();}这里的 Agent 在整个会话中复用。下一次输入仍然交给同一个实例,因此它能够继续携带上一轮的消息历史。
初始化时,Config.fromYaml() 读取 YAML,通过 Zod 校验结构、填充字段默认值,供程序选择模型协议、重试次数、步数和工具目录。基础提示词、发现的 Skills 名称与描述,以及按需补入的工作目录信息,则组成发送给模型的 system 消息。
Agent 将可用工具保存在以名称为键的 Map 中。进入循环后,模型请求携带这些工具的定义,实际调用再按名称查找对应对象。
配置文件按启动时当前目录、用户配置目录、安装包配置目录的顺序查找。CLI 的 --workspace 参数用于指定工作目录,不会同时改变配置搜索所使用的 process.cwd()。启动程序所在目录与 Agent 工作目录可以不同。
核心循环里,每一步做了什么
Agent.run() 用一个受 maxSteps 限制的 for 循环推进任务。每一步先请求模型,收集完整输出,再判断有没有工具调用。
这段流程可以对应到 ReAct 中的推理、行动和观察:模型根据已有上下文决定下一步,程序执行模型请求的工具,再把工具结果交回模型,作为下一步的依据。Tool Calling 提供结构化的动作表达,使用工具名和参数表示一次调用;ReAct 描述这些决策、执行和反馈如何连续发生。
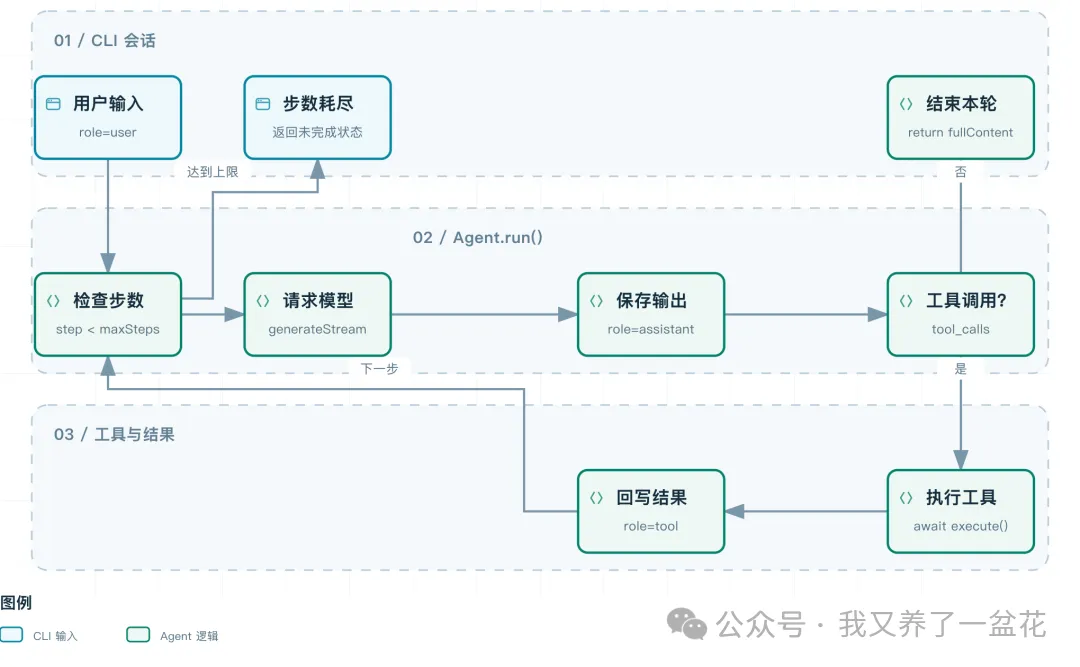
为了突出控制流,可以把源码中的终端样式、日志和输出截断省略掉。下面是按原实现整理的示意代码,辅助变量和局部组织有所调整:
for (let step = 0; step < this.maxSteps; step++) { let content = ''; let thinking = ''; let toolCalls: TToolCall[] = []; // 模型根据当前上下文生成文本或结构化工具调用 for await (const chunk of this.llmClient.generateStream( this.messages, this.listTools() )) { content += chunk.content ?? ''; thinking += chunk.thinking ?? ''; if (chunk.tool_calls) toolCalls = chunk.tool_calls; } this.messages.push({ role: 'assistant', content, thinking: thinking || undefined, tool_calls: toolCalls.length ? toolCalls : undefined, }); if (toolCalls.length === 0) return content; for (const call of toolCalls) { // Action:运行程序执行模型请求的操作 const result = await this.executeTool( call.function.name, call.function.arguments ); // Observation:结果进入历史,下一步再交给模型 this.messages.push({ role: 'tool', content: result.success ? result.content : `Error: ${result.error ?? 'Unknown error'}`, tool_call_id: call.id, tool_name: call.function.name, }); }}模型返回的 tool_calls 提供工具名称和参数。程序据此找到工具对象,调用它的 execute(),把执行结果写回历史。下一步请求模型时,这些结果就会一起发送过去。
模型可以根据新结果继续请求工具,也可以只返回文本。当前实现以“本步没有工具调用”作为正常结束条件,因此正常返回表示这一轮生成已经结束。任务是否符合用户要求,还需要结合输出和实际产物判断。
另外,同一步如果包含多个工具调用,代码会逐个 await。即使两个文件读取之间没有依赖,当前循环也会按返回顺序执行。后续如果要加入并发,需要区分读取和修改操作,并处理结果关联、共享状态及执行顺序,不能直接把这一段整体换成 Promise.all()。
模型如何知道上一步发生了什么
messages 是理解这个实现的另一个入口。
构造 Agent 时,数组里先放一条 system 消息。用户输入后追加 user,模型输出后追加 assistant,工具执行后再追加 tool。
假设用户要求读取一个文件,模型选择调用 read_file,消息的变化可以简化为下面这样。工具调用 ID 和具体内容均为示例:
[ { role: 'system', content: '系统提示词与工作目录等信息' }, { role: 'user', content: '读取 notes.txt 并概括内容' }, { role: 'assistant', tool_calls: [{ id: 'call_1', type: 'function', function: { name: 'read_file', arguments: { path: 'notes.txt' }, }, }], }, { role: 'tool', tool_call_id: 'call_1', tool_name: 'read_file', content: '文件内容……', },]这里既保留了“请求读取文件”这件事,也保留了读取结果。tool_call_id 把二者关联起来,下一次模型请求可以据此继续处理任务。
如果只执行工具,把结果打印到终端,却没有追加到历史,后续请求就缺少这次执行的结果。终端上能看到的内容和模型能收到的上下文,需要分别检查。
源码中还有一个具体区别:工具成功后,终端展示最多截取前 300 个字符,但历史中使用的是 result.content。下面省略终端颜色和错误分支,只保留这一段的数据关系:
// 显示截断只作用于局部变量,不会修改 result.contentlet resultText = result.content;if (resultText.length > 300) { resultText = `${resultText.slice(0, 300)}...`;}console.log(resultText);this.messages.push({ role: 'tool', content: result.content, tool_call_id: toolCallId, tool_name: functionName,});因此,终端输出很短,仍可能向模型发送较长的工具结果。文件读取工具另有处理:它会先选取指定行、添加行号,再按字符数估算 token,对超出预算的内容保留头尾并添加截断说明。这种截断已经改变工具返回内容,也会影响模型收到的信息。
这个项目将历史保存在当前实例的内存中,每一步都把 messages 交给客户端。这里没有看到持久化恢复、上下文裁剪或历史摘要逻辑。随着对话和工具结果积累,请求内容也会增长;单次文件读取虽然有截断处理,整个会话仍然需要单独考虑长度控制。
工具定义和工具实现,分别给谁使用
工具模块提供了统一的 Tool 接口。为方便阅读,下面省略泛型,并按本文的命名习惯调整类型名称:
interface ITool { name: string; description: string; parameters: Record<string, unknown>; execute(params: Record<string, unknown>): Promise<IToolResult>;}interface IToolResult { success: boolean; content: string; error?: string | null;}name、description 和 parameters 会被模型客户端转换成工具定义,描述可用操作及参数结构。模型选择工具后,Agent 根据 name 找到本地对象,调用 execute()。
模型请求中包含工具的描述与参数约束,工具里的文件读写、进程启动等实现保留在程序中。这也解释了为什么新增一个工具通常需要同时处理两件事:描述清楚它能做什么,并实现收到参数后如何执行。
内置工具包括文件读取、写入、字符串替换,以及 Shell 命令执行、后台输出查询和进程终止。它们最终都转换为统一的执行结果,Agent 的循环不需要分别处理文件工具和命令工具。
Shell 工具还维护了一份独立的进程状态。前台命令等待执行结束后返回;设置 run_in_background 时,程序创建子进程,将输出和状态保存在内存管理器中,并先返回 bash_id。后续通过 bash_output 增量读取该进程的新输出,通过 bash_kill 请求终止并移除记录。
后台启动返回成功,表示程序已经发起执行;bash_output 返回成功,表示查询到了对应记录。这两项结果都不能直接证明后台命令已经完成。当前输出接口没有返回内部的 status,尚未取得的退出码也会按 0 返回,因此仅凭查询结果无法可靠区分“仍在运行”和“成功退出”。继续完善时,需要将进程状态或明确的完成标记一并返回。
输出读取使用游标,已经读过的内容不会在下一次查询中自动重发。
参数定义本身也不能保证执行安全。当前调度层直接将参数交给工具,具体工具仍需要检查参数和操作条件。例如文件工具会将相对路径解析到工作目录,同时接受绝对路径;路径中的 .. 也没有被这一层统一限制。工作目录提供了解析基准,还需要额外的校验机制才能限制访问范围。
Bash 工具创建进程时没有把 Agent 的 workspaceDir 作为 cwd 传进去。指定 Agent 工作目录后,文件工具和 Shell 命令的相对路径基准可能不同。这类细节需要顺着工具实现继续看,不能只根据提示词里的工作目录描述判断。
模型适配层处理协议差异
Agent 调用的是 LLMClient.generateStream()。LLMClient 根据配置中的 provider,选择 OpenAI 或 Anthropic 的协议实现。
客户端将流式数据统一为几个内部字段:content 是文本输出,thinking 是从服务商响应中映射的可选推理文本,tool_calls 是带调用 ID、工具名和参数的结构化请求。对照前面的循环代码,Agent 显示和保存前两个字段,根据 tool_calls 调度工具。代码没有解析 thinking 中的自然语言来选择工具,没有这个字段时也可以继续执行循环。
内部响应还带有 done 和 finish_reason 字段,表达响应完成状态和结束原因。当前 Agent.run() 在异步流迭代结束后检查工具调用,没有利用这两个字段进一步区分停止原因。
比如,内部 role: 'tool' 消息在 OpenAI 客户端中会转换成带 tool_call_id 的工具结果;Anthropic 客户端会把它转换成用户消息中的 tool_result 内容块,并通过 tool_use_id 建立关联。内部系统消息在两种请求中的组织方式也有所区别。
这样,执行循环可以围绕内部消息格式编写。更换协议时,需要核对消息转换和流式事件处理是否完整,再验证它们与目标服务的实际兼容性。
流式响应还有一个容易忽略的过程:工具参数可能分成多个 JSON 片段到达。客户端需要先拼接片段,形成完整工具调用,再交给 Agent 执行。当前 OpenAI 实现按调用索引积累片段,Anthropic 实现跟踪工具内容块,在消息结束时返回积累的调用列表。
两种实现都有参数 JSON 解析失败后使用空对象的处理。这能让程序继续走到工具执行,但错误信息可能变成后续的“缺少参数”,原始格式问题就不容易直接看出来。若要完善诊断,可以让解析失败成为明确的协议层错误,并保留对应调用信息。
客户端把重试次数配置传给 SDK。请求重试和工具重试需要分别考虑:模型请求出现错误后重新发送,与重新执行一次文件写入或命令,对外部状态的影响不同。当前 Agent 循环没有统一重试工具的逻辑。
Skills 和 MCP 如何接进来
读到这里,可以把 Skills 和 MCP 放回前面的执行循环中理解。一个需要回答的问题是:新增一个 Skill 或接入一个 MCP 服务,究竟给 Agent 增加了什么?
Skill 的指导内容最终是 Prompt 文本
在当前项目里,Skill 发挥作用的核心过程,就是将一段描述任务步骤、判断条件和操作约束的文本放进模型上下文。从这个层面理解,“Skill 的本质是 Prompt 字符串”能够对应到代码里的实际行为。
但一个完整 Skill 还包含文件组织和加载约定。Agent Skills 的格式以包含 SKILL.md 的目录为基础,文件中保存名称、描述和指令,也可以附带脚本、参考资料、模板等资源。因此,文本负责指导模型,配套资源由模型和运行程序按需使用。Agent Skills 概述[4]
假设要给 Agent 增加“整理日志”的能力,一个简化的技能文件可以这样写。下面是教学示例:
---name: summarize-logsdescription: 根据用户指定的日志,整理错误时间线和相关代码定位。---读取用户指定范围内的日志。按时间顺序整理异常,保留文件位置和必要的原文片段。涉及原因判断时,分别写出已确认的事实和待验证的解释。只做分析,修改文件前需要用户明确授权。这些内容描述了完成任务的方法。模型读取后,可以据此选择读取文件、执行查询等动作。Skill 中没有实现日志读取函数,实际读取仍由工具完成。
在这个项目中,加载过程分成两步。
启动时,SkillLoader 递归查找 SKILL.md,解析名称、描述和正文,并缓存完整内容。名称和描述会拼进系统提示词,告诉模型有哪些技能、分别适用于什么任务。发现技能后,程序还会注册一个 get_skill 工具。
需要使用时,模型调用 get_skill,程序从缓存中取出对应技能。GetSkillTool 中的格式化方法直接返回一个字符串,下面保留了它的核心内容:
return `# Skill: ${skill.name}${skill.description}---${skill.content}`;这个字符串作为工具执行结果,经由 role: 'tool' 消息进入历史。下一次模型请求携带它,模型就能读取完整指导内容。
因此,当前项目中有两条不同的上下文路径:
名称与描述 → 启动时追加到 system prompt完整指导内容 → get_skill 返回 → tool 消息 → 后续模型请求前面说的“按需加载”,主要指完整正文按需进入模型上下文。当前实现已经在启动发现阶段读取了磁盘文件,后续 get_skill 取的是缓存。
这种组织方式可以让系统提示词先保留技能目录,在需要时再展开具体步骤。如果所有技能正文都提前拼进去,即使本次任务只涉及日志整理,也要携带其他技能的完整内容。
文字指令如何变成实际操作
假设 Skill 要求运行一个配套脚本,模型还需要发起 Bash 等工具调用,由程序执行脚本。脚本产生的结果再通过工具消息返回,继续进入同一套循环。
get_skill 返回指导文本 → 模型根据文本选择下一步 → 请求文件工具或 Bash 工具 → 程序执行操作 → 返回结果当前源码没有一个“读取 Skill 后自动执行全部步骤”的独立执行器,也没有把每个 Skill 自动注册成一个新的原生函数。真正注册的入口是 get_skill,具体文件或脚本操作仍然使用已有工具。
因此,写入 Skill 的流程条件与执行层的控制需要分别看。比如,技能文本要求“修改前取得授权”,会成为模型决策时的指令;如果需要程序强制检查授权,仍应在工具执行路径中实现。仅仅返回这段字符串,不会自动为写文件或执行命令增加拦截逻辑。
MCP 可以按客户端与服务端接口来理解
MCP 的工具调用部分,确实可以借助 Server 接口来理解:服务端提供能力,客户端获取能力描述,并按约定发出调用请求。
更完整地说,MCP 是客户端和服务端之间交换上下文及能力的协议。它定义了 JSON-RPC 消息和相关交互,服务端可以提供 Tools、Resources、Prompts 等能力。当前项目主要接入其中的 Tools,因此下面重点看工具发现和调用。MCP 架构概述[5]
结合当前实现,可以对应出三个位置:
例如,一个 MCP Server 可以封装已有的日志查询接口,将它暴露为带名称、描述和参数 Schema 的工具。客户端先获取工具列表,再根据模型选择发出调用;服务端处理参数、访问实际数据源并返回结果。这是一个假设场景,实际接口由对应服务实现。
MCP Server 也不要求一定部署为远程 HTTP 服务。当前项目支持 stdio,通过本地进程的标准输入输出通信;也兼容 SSE 和 HTTP 类传输。连接方式由配置和 SDK 适配,不能把所有 MCP 调用都理解成模型直接请求一个公网 URL。
模型选择工具,客户端负责调用 Server
启动时,项目根据配置创建连接,通过 listTools() 获取服务提供的工具。每个工具随后被包装成实现了 Tool 接口的 MCPTool,与内置工具一起注册到 Agent。
工具名称、描述和参数定义经过模型适配层发送给模型。模型返回工具调用后,Agent 找到对应的 MCPTool,再由客户端向 Server 发出请求。
启动:MCP 配置 → 建立连接 → listTools() → 注册 MCPTool执行:模型返回工具名和参数 → Agent.executeTool(name, params) → MCPTool.execute(params) → session.callTool({ name, arguments: params }) → MCP Server 执行并返回结果 → 归一化为 success / content / error → 追加 tool 消息这条链路中,服务连接和调用由运行程序处理。模型根据收到的工具定义构造请求,实际的客户端通信逻辑保留在程序中。
如果已有普通 HTTP 接口,可以由一个 MCP Server 将它包装成标准工具;也可以在 Agent 内部编写一个直接调用该接口的本地工具。两种方式都能进入当前循环,选择哪一种,需要看是否希望通过统一协议向不同 Agent 应用提供能力。
连接层还负责超时和退出清理。当前注册表直接使用工具名称作为 Map 的键,重复注册同名工具会覆盖已有项,因此多个服务之间,以及外部工具和内置工具之间,都需要处理名称冲突。
Skill 与 MCP 怎样配合
沿用前面的日志整理示例,可以把整理步骤和结果格式放进 Skill,把日志查询能力通过 MCP 工具提供给 Agent。
Skill:说明查哪些线索、如何组织结论、什么情况需要继续核对MCP Tool:接收查询条件,访问日志服务,返回实际记录Agent:根据上下文选择工具,执行后继续处理结果这是一种常见的职责组合,但二者也有交叉:Skill 可以附带可执行脚本,MCP 协议也支持提供 Prompt 模板。理解当前项目时,更明确的观察方式是跟踪它们分别进入哪条路径:Skill 正文被格式化成指导文本进入消息历史,MCP 工具则被注册为可调用对象,实际执行发生在服务端。
二者都沿用原有的 Agent 循环。它们分别增加了模型可读取的任务指导和程序可调用的能力,消息历史仍然负责把这些信息与执行结果带入下一步请求。
对照流程图,再看几个结束和异常条件
流程图把一次执行画成了闭环,但闭环能否按预期退出,还要看具体条件。
maxSteps 限制的是一次 run() 中的模型请求步数,默认值是 50。一次模型请求可以返回多个工具调用,所以它不等于工具执行次数;下一次用户输入再次调用 run() 时,计数也会重新开始。
达到上限后,方法会返回一个未完成状态字符串。当前 CLI 只调用 await agent.run(),没有打印返回值。普通文本已经在流式接收时显示出来,但这个步数上限提示没有走同一条输出路径,因此需要单独处理。这个例子里,方法的返回行为和终端上的可见反馈存在差别。
工具执行错误通常会被转换成 success: false,并以错误文本写回历史,后续模型仍然能够读取它。模型调用等异常则会传到 CLI,由 CLI 打印错误并调用 agent.messages.pop()。
pop() 只能删除最后一条消息。如果异常发生前已经写入过 assistant 和工具结果,它无法撤销本轮产生的全部历史。这段错误处理的注释写的是移除未完成的用户消息,但实际删除对象取决于数组当时的内容。
如果继续完善这里的行为,可以在处理用户输入前记录历史起点,再明确失败时保留哪些消息、如何处理未配对的工具调用。已经完成的文件修改和命令也不能靠删除消息撤销,需要分别处理会话状态与外部操作结果。
与 Claude Code 相比,还需要补哪些运行能力
之前整理过一些围绕 Claude Code 源码暴露事件的公开架构分析,这里结合官方文档,对照看看这个极简项目还可以补充哪些运行能力。
读完这个项目的核心循环,再看 Claude Code 这样的编码 Agent,可以继续问一个问题:如果让它在真实项目中持续工作,用户还需要程序提供哪些保证?
比如,一个修改任务运行了十几步,用户想中途调整要求;终端意外退出后,希望继续上次的工作;模型读取了大量日志,后面的请求仍然需要记得最初的修改限制。这些情况都需要执行循环之外的配套机制。
这部分依据公开研究和官方文档整理,没有直接下载、执行或逐文件审计泄露源码。下文分别说明官方公开能力、历史实现线索和本文的扩展建议;历史快照的内部接口不代表当前安装版本。
官方将 Claude Code 的工作过程概括为收集上下文、采取行动、验证结果,并说明用户能够在过程中打断和调整任务。这为对照提供了一个观察范围:既看模型如何继续,也看程序如何控制执行、处理停止和保存状态。How Claude Code works[6]
先根据前面读到的 TypeScript 源码,整理出几项差距。这里的“需要补充”表示从学习项目继续扩展的方向,具体业务可以只实现其中一部分。
动作授权需要进入工具执行路径
前面已经看到,模型生成工具名和参数后,当前 Agent 会直接调用 execute()。如果要把它用于持续修改代码或访问外部系统,就需要在执行前加入参数校验和动作授权。
Claude Code 官方提供按工具和参数配置的权限规则,并有不同权限模式。具体动作是否需要确认,由配置和模式共同决定。Permissions[7]
对这个项目,可以先让调用经过这样的路径:
收到完整工具参数 → 校验参数与目标资源 → 判断动作是否已经获准 → 允许执行 / 拒绝 / 等待用户确认 → 执行并记录结果例如,“读取当前目录的文件”和“执行一个会修改多个目录的命令”,需要的判断条件不同。确认也应关联本次具体参数,避免用户批准读取文件后,程序把这个决定扩展到后续写入操作。
权限策略和执行环境还要分别处理。官方文档中的 Bash 沙箱约束 Shell 命令及其子进程的文件和网络访问,文件工具、MCP 服务和 Hook 不在这一 Bash 沙箱范围内。Sandboxing[8]
因此,给当前项目加入一个受限 Shell 后,仍然需要检查文件工具的路径处理和 MCP 服务自己的权限。每一条能产生操作的通道,都要明确它接受什么限制。
长任务需要管理上下文和会话
当前 messages 同时承担了运行中的上下文和会话历史。它容易理解,但随着日志、文件内容和工具结果增加,需要进一步决定哪些信息继续发送给模型。
Claude Code 官方说明会在接近上下文限制时压缩对话,也提醒摘要可能丢失早期的详细指令,持久规则需要通过项目指令等方式保留。上下文压缩说明[6]
如果在这个项目中加入压缩,至少要考虑保存当前目标、用户限制、已完成动作、重要证据的位置和未解决问题。大段日志可以保留在本地,后续通过工具重新读取。压缩前后的任务约束是否一致,也需要单独核对。
会话保存又是另一项工作。Claude Code 的 CLI 会持续保存本地会话记录,并支持恢复会话。Sessions[9]
当前项目已经有日志功能,会记录模型请求、响应和部分工具信息,但还没有看到从日志重建会话的入口。继续实现时,可以先把输入、assistant 工具调用、工具结果和运行状态写成结构化记录,保留调用 ID 与顺序,再实现加载和恢复。
恢复历史以后,外部动作的状态仍需核对。假设命令已经执行完成,但进程在保存结果前退出,重启时直接重放命令就可能重复修改文件。会话记录应区分“准备执行”“已经发出”“已确认完成”和“结果未知”;恢复时根据实际文件或接口结果决定下一步。
取消、调度和错误恢复需要共享运行状态
当前 CLI 收到 SIGINT 后会关闭输入界面,但没有把统一的取消信号传入模型请求和工具调用。用户发出了停止指令,并不能据此确认所有进行中的操作都已经结束。项目虽然提供 bash_kill,它仍然需要一次具体的工具调用。
继续补充时,可以由会话控制层维护 AbortSignal,向模型客户端、工具执行器和子任务传递。各层要报告动作是已取消、已完成,还是结果仍然未知。对已经发出的外部写操作,还需要查询结果,不能简单归类为“没有执行”。
工具调度也需要更丰富的契约。公开的历史工具系统分析[10]展示过 isConcurrencySafe(input)、工具运行状态和队列调度等设计。这些是理解特定快照的线索,不能据此断言当前安装版本采用完全相同的内部接口。
可以借鉴的职责是:工具声明执行特性,调度器根据状态决定何时启动。对于当前项目,先区分只读操作和写入操作,再按目标文件、共享目录或业务对象判断冲突,会比统一开启并发更容易控制。
在现有 maxSteps 之外,还可以加入工具调用次数、总耗时和用量预算。达到限制时,由执行层返回明确的停止原因,交给 CLI、IDE 等调用方展示。
子 Agent 和 Hook 分别解决什么问题
当前 Skills 和 MCP 已经能够扩展知识与工具,但执行过程中的固定处理,还需要相应的生命周期入口。
Claude Code 的 Hook 提供工具调用前后、停止等事件的扩展方式,各事件的返回规则和阻断能力有所区别。Hooks reference[11]
如果在当前项目中增加 Hook,可以先围绕已有调用点设置工具前检查、工具后记录和结束前检查。比如,编辑工具返回成功以后,记录实际修改的文件;任务结束前,检查是否存在尚未返回结果的调用。Hook 的超时和失败是否阻止主流程,也需要明确约定。
子 Agent 则适合处理需要独立上下文的任务。官方支持为子 Agent 配置提示词、可用工具和权限,让它处理局部任务后返回结果。Subagents[12]
假设主任务要同时阅读大量日志和分析一组源码,可以让两个子任务分别整理关键定位,再把必要结论交给主 Agent。当前项目只有一个 Agent 实例和一份历史;如果加入委派,还需要任务标识、输入范围、结果汇总和取消传播。
独立上下文也不能自动解决共享文件的冲突。两个子任务如果能够写同一目录,就仍然需要约束修改范围或协调执行顺序。因此,多 Agent 可以作为后续选项,单 Agent 的状态与恢复机制需要先有清楚的定义。
结束生成后,还需要说明验证依据
当前 run() 没有收到工具调用就返回文本。对于问答,这通常足以结束一轮交互;对于代码修改,还需要区分文件是否成功写入、修改是否符合要求、哪些结果已经检查,以及哪些仍未确认。
执行层可以记录修改文件、工具退出码、用户要求的检查结果和未执行事项,供最终回答引用。比如,一次编辑成功可以证明文本替换已完成,但页面行为还需要相应的运行证据。用户只要求源码分析时,则应保持只读。
增加这类反馈时,也应沿用任务本身的授权和验收条件。检查动作是否需要执行、能够证明什么,应由具体任务决定。
接下来做什么
回到这个项目,可以把后续工作放进现有的调用链中,逐步增加职责:
1. 在 executeTool()前加入统一参数校验和动作授权,先明确哪些操作能够执行。2. 将输入、模型调用、工具结果和停止原因保存为本地结构化事件,让 CLI 从事件显示进度。 3. 为模型请求和工具执行加入统一取消信号、超时与预算,明确每种停止状态。 4. 加入会话恢复和上下文预算,核对恢复后是否重复操作、压缩后是否保留限制。 5. 再根据实际任务增加并发、Hook 或子 Agent,并观察它们是否改善耗时和结果质量。
这是基于当前实现提出的扩展顺序。只做只读资料问答时,可以先保留串行执行;需要长期修改代码和调用外部服务时,再把动作状态、权限与恢复条件做完整。
前面的流程图可以继续作为阅读入口。沿着“用户输入、模型请求、工具执行、结果写回”往下跟,再检查每一步的授权、记录、取消和恢复,就能把一个可运行的循环逐步扩展成适合具体任务的 Agent。
除了本文的两个版本,还可以按想了解的问题,选择其他开源实现对照阅读。
这些仓库覆盖的范围有所不同。阅读时可以先挑同一个问题,例如“一次工具执行失败后如何继续”,分别找到输入、状态变化和返回结果,再比较各自的处理条件。想先读短小的循环,可以继续看 mini-swe-agent;想了解日常编码工具的组织方式,可以看 Codex CLI 和 OpenCode;涉及运行环境和多会话管理时,再看 OpenHands。
上面的定位依据各仓库当前的项目说明整理,推荐的阅读重点是本文的选择,不代表已经逐文件分析了这些项目。实际阅读时可以固定一个提交版本,避免把不同版本的实现混在一起。
引用链接
[1] Python 原版:MiniMax-AI/Mini-Agent: https://github.com/MiniMax-AI/Mini-Agent/tree/main[2] TypeScript 版本:Code-MonkeyZhang/mini-agent-ts: https://github.com/Code-MonkeyZhang/mini-agent-ts[3] `f0666ad`: https://github.com/Code-MonkeyZhang/mini-agent-ts/tree/f0666add5f77100c6f0c9a331e49095ad492508d[4] Agent Skills 概述: https://agentskills.io/home[5] MCP 架构概述: https://modelcontextprotocol.io/docs/learn/architecture[6] How Claude Code works: https://code.claude.com/docs/en/how-claude-code-works[7] Permissions: https://code.claude.com/docs/en/permissions[8] Sandboxing: https://code.claude.com/docs/en/sandboxing[9] Sessions: https://code.claude.com/docs/en/sessions[10] 历史工具系统分析: https://claude-harness.dev/en/articles/03-tool-system[11] Hooks reference: https://code.claude.com/docs/en/hooks[12] Subagents: https://code.claude.com/docs/en/sub-agents[13] Codex CLI: https://github.com/openai/codex[14] OpenCode: https://github.com/anomalyco/opencode[15] mini-swe-agent: https://github.com/SWE-agent/mini-swe-agent[16] OpenHands: https://github.com/OpenHands/OpenHands