ARTICLE · 1288814
端侧AI工具链原理(07):混合精度
端侧AI工具链原理(07):混合精度
端侧AI工具链原理(07):混合精度
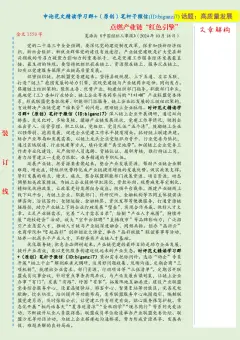
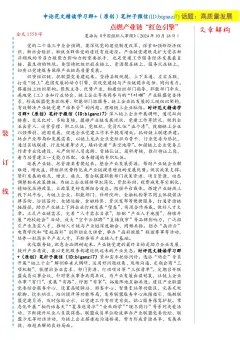
量化不是把 FP32 改成 INT8,而是给端侧模型重新设计一套低位宽数值契约。
校准集必须覆盖真实分布。相机模型得包住亮度、ISO 和运动,几十张“看着正常”的图片根本代表不了量产数据。
PTQ 适合快速部署,QAT 用来让参数适应误差。但 Fake Quant 的配置一旦跟目标 Kernel 对不上,学出来的就是错误硬件模型。
混合精度本质是离散优化。穷举每层选哪种精度根本算不过来,工程上只能先全图低比特,再把最敏感的层逐层恢复成 FP16。
验收得看四层证据:数值误差、真实任务指标、底层是否真落到低精度 Kernel,以及最终时延和功耗。没有硬件收益的 INT8,只是换了种数据类型。
要不要我帮你把这篇贴图号再压缩到 300 字以内,保留最核心的几个实操建议?
原文端侧AI工具链原理(07):PTQ、QAT与混合精度:量化不是把FP32改成INT8
收录于AI SoC全栈贴图
作者提示: 个人观点,仅供参考
广东,8小时前,