ARTICLE · 1291078
为什么网上的 AI 自查胎记不靠谱
一篇关于"拍照识胎记"的清醒帖
这是老陈的第 23 篇科普原创
老陈,《胎记的诊断与治疗》编者
「胎记 · 疤痕 · 纹身 · 激光 · 护肤」100问
把复杂的科普,说成人话
不少人问我:网上那些"拍照识胎记"的小程序、AI 工具,到底靠不靠谱?有的还号称"拍一张就知是哪种、要不要紧"。
我的态度很明确:别拿它当诊断,最多当个"提醒你去看医生"的门卫。
这不是保守。皮肤影像 AI 在更硬核的皮肤癌筛查领域,早已交过学费。有项研究把这件事量化得明明白白,正好拿来当胎记自查的"前车之鉴"。
据该研究称(研究者为伦敦 NHS 顾问皮肤科医生,数据取自 2025 年公开的 MILK10k 活检库,200 个病灶均含病理报告):他们让前沿大模型和一台 2015 年老模型同场考"六选一判断病灶性质"。结果——老模型首选正确率 62%,两个大模型仅 42%。
听着像大模型输了?更吓人的在后面:那个"赢了"的老模型,把 30 例黑色素瘤放走了 18 例。其中一例,耳朵上不到 0.8 毫米的浸润性黑色素瘤,两个大模型异口同声判成"无害的老年疣",放走。
注意,测试以病理结果为核对标准,能查清哪些病灶被判错;有病理答案用来评分,不等于模型看到了病理答案。这些结果也不能换算成胎记识别的准确率,更不能证明你手里的工具已在目标胎记人群中充分验证。
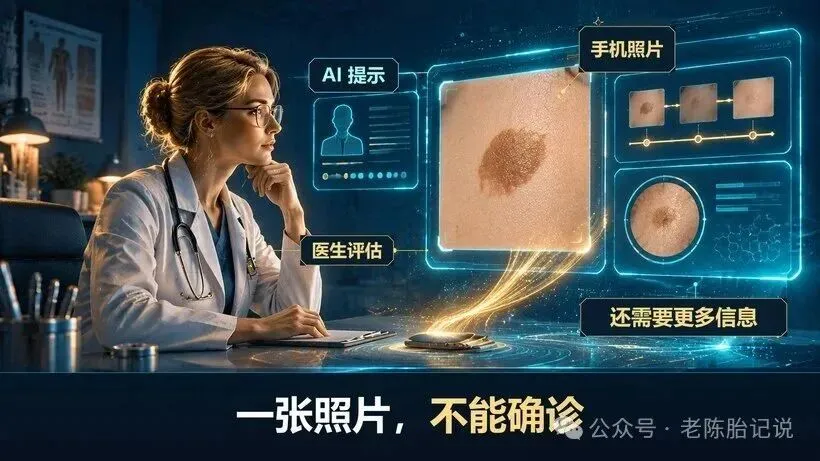
照片只呈现局部,判断还需要更多信息。
判断胎记,重要的不只是“照片像什么”,还有“现在缺了什么信息”:出生就有还是后来出现?最近是否变大、变厚?长在哪儿?有无其他表现?必要时还要结合皮肤镜或进一步检查。一个工具若不追问这些,收张照片就给你确定名称,跳过的可能正是决定下一步的关键信息。
下面把这事拆成三层讲,它能骗你三次。
先看整体判断的局限
老陈 /01/ AI自查
准确率,是最不值钱的数字
漂亮的整体准确率,可能遮住关键漏诊
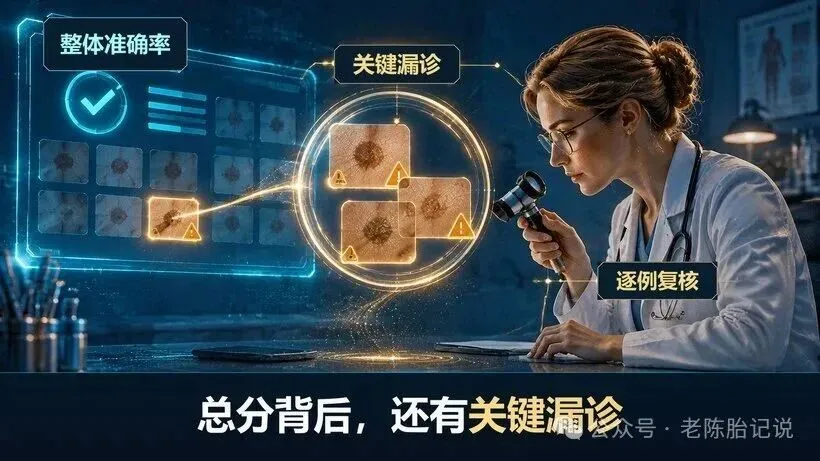
整体分数之外,还要看关键风险有没有漏掉。
回到那项研究。老模型 62% 首选正确率,看着赢了;但按报告阈值,它漏掉 18 例黑色素瘤。分类总分和漏诊风险,是两项得分开看的结果。只比“62% vs 42%”,看不出哪些危险病例会被放走。
网上那些"AI 识胎记"也是同一套路。它最爱亮"识别准确率 90%",但你要看它是在什么题上考出来的。
真实的考题分两种:
一种是"一眼就能认"的题——典型的太田痣、典型的鲜红斑痣,颜色形状都标准。AI 在这类题上考高分,不稀奇。
另一种是"长得像"的难题——咖啡斑和色素痣怎么分?色素型与血管型打错激光会怎样?卡波西样血管内皮瘤(KHE)和普通婴幼儿血管瘤长得像,危险程度却天差地别。门诊里真正让人栽跟头的,全是这一类。
问题在于:整体准确率会把这些难题悄悄平均掉。它报个漂亮的 90%,你看不到"那几道最难的题它全错了"——正如研究里 62% 背后藏着 18 例被放走的黑色素瘤。
更该追问一句:它有没有在胎记人群里验证过?皮肤癌任务上的成绩,不能直接当成胎记自查的成绩。而且论文里表现好的医疗 AI,也未必是你手机里的那个——“用了同款大模型”,不等于继承了研究系统的诊断能力。
所以看到"AI 识别胎记准到 90%",先别激动。问一句:它那张"难题卷",交了吗?
再看判断阈值怎么定
老陈 /02/ AI自查
线画在哪,决定它害不害人
线画得松一点,漏掉的风险就高一点
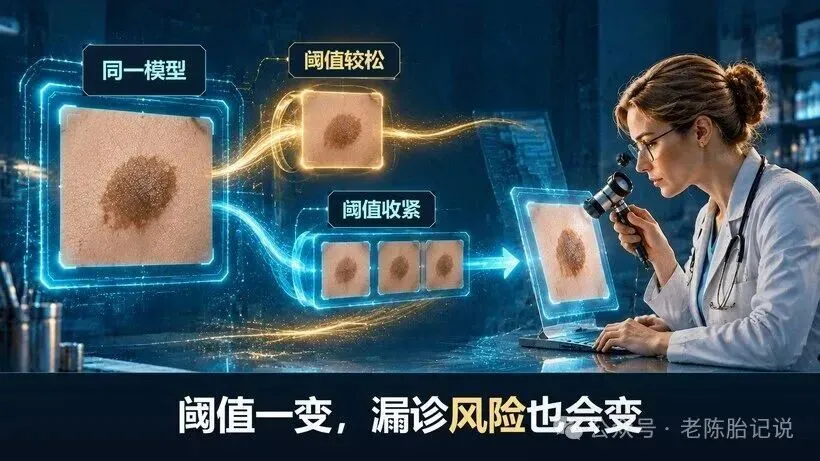
判断阈值影响哪些风险被放行。图为概念示意。
部分影像工具会输出风险分数,再按门槛给“建议就医”或“暂不转诊”等提示。风险分数不一定等于真实患病概率,要看它有没有经过校准和人群验证;通用聊天 AI 说话的肯定程度,更不能当成概率。
这条线画在哪儿,差别巨大。还是那项研究:老模型不是"答错"才放走黑色素瘤,它每例都输出概率,"放不放人"由阈值决定。研究者把阈值设在"让 90% 恶性病灶过线",皮肤镜图用 17.0%、临床照用 35.5% 的概率线——30 例黑色素瘤,18 例被放走。可把阈值调紧到保守策略,放走的从 18 例掉到 1~2 例。
同一模型、同一批题,改阈值就改漏诊数量;但误报会增加多少、是否适合真实临床,还得一起评价。
当测试人群里低风险占多数,一个工具即使常答“没事”,整体成绩也不难看。但真正要警惕的是:它会不会把少数“该警惕”的,混在大量低风险里一起放走。
被它放走的,可能是:需定期随访恶变风险的先天性巨痣,提示神经纤维瘤病(NF1)的多发咖啡斑,要警惕 Sturge-Weber 综合征(青光眼、癫痫风险)的眼周鲜红斑痣,以及可能伴发卡梅现象(严重凝血障碍,可危及生命)的 KHE。
线画松一分,漏掉的就不是"多切一块痣"的小事,而是那几个要命或致残的。这才是自查最该怕的地方。
分清判别和就医分诊
老陈 /03/ AI自查
判别和分诊,是两个岗位
类型未必看得准,风险提示仍有价值
“它是什么”和“要不要就医”,是两种不同的问题。
还是那项研究,一个值得注意的变化:两个大模型做“六选一判别”时首选正确率 42%;换成患者口吻,只给一张照片问“我需要看医生吗”,在另一组 100 例活检确诊的黑色素瘤上,它们分别建议 99 例和 98 例就医。
这说明在这组确诊病例中,它们较少漏掉就医建议,但不能据此说“分诊接近满分”。这组样本没告诉我们,会让多少不需转诊的人也去就医。
对自查工具,还要看建议会怎样改变人的行动:会不会让该就医的人放心拖延,会不会把可观察的情况说得必须立即治疗?建议就医只是一步,减少延误、避免无谓检查和恐慌,才是更完整的评价。答对诊断,也不等于证明患者得到了更好的治疗结果。
胎记也是一样:
判别(这是哪一型、什么性质)——很难。连非专科医生都常分错色素型和血管型,更别说一张手机照片。
分诊(这个该不该去看医生)——任务不同,可探索辅助提醒的价值,但仍要验证漏诊、误报和实际就医影响。拿不准应寻求专业评估,不能把工具的“没事”当成排除风险。
所以正解很清楚:别在家用 AI 给自己确诊"这是哪种胎记",但可以用一个简单原则自查"要不要就医"。
出现下面任意一条,别犹豫,去正规胎记专科:
· 拿不准它到底是什么;
· 明显在变大、变深、变厚,或边界变得不规则;
· 破溃、出血、反复结痂;
· 长在特殊部位(眼周、口鼻周围、会阴);
· 伴随其他异常(如身上多处咖啡斑、肢体不对称、癫痫发作等)。
最后,把判断落到行动
老陈 /04/ AI自查
给你能直接用的几条
拿不准、在变化或长在关键部位,就去就医
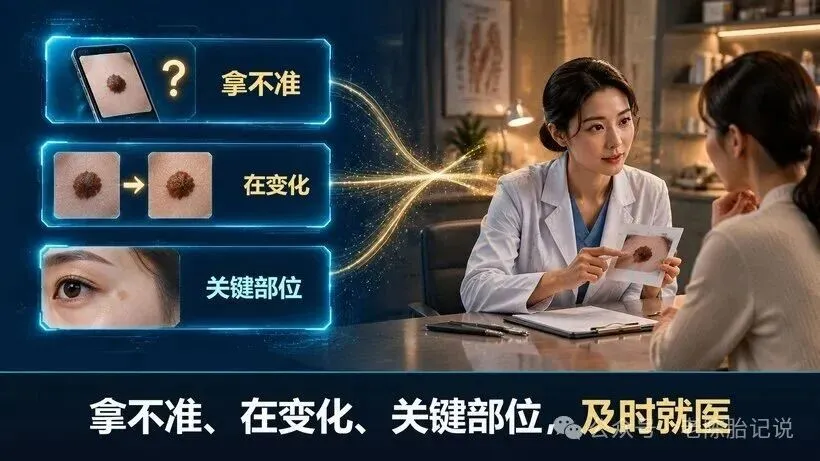
1. 不拿 AI 自查当确诊。它顶多提醒你"该去看看",下不了"这是什么、怎么治"的结论。
2. 记住警示信号清单。上面那五条,占一条就就医,不占也建议定期观察。
3. 该观察的别过度治,该警惕的别放过。部分婴幼儿血管瘤可在医生评估后观察,但 KHE、特殊部位鲜红斑痣、巨痣、NF1 相关信号这些,需专科评估,别自己扛。
4. 去正规胎记专科。医生结合皮肤镜、病史和必要检查做的判断,比一张手机照片靠谱得多。
还要分清:识别出可能的类型,不等于已经决定怎么治。要不要治、何时治、用什么方法,还要结合年龄、部位、范围、变化和功能影响。照片识别结果不能直接变成激光、用药或手术的指令。
一个准确率,回答不了你最关心的全部问题。要看它测了谁、给了什么信息、有没有漏掉危险情况,也要看它的建议会把人带向什么行动。皮肤癌评测中的漏诊值得警惕,但胎记自查靠不靠谱,仍要拿出对应人群和用途的证据。
拿不准的时候,最稳妥的做法只有一个:去正规医院的皮肤科或胎记专科,让医生用皮肤镜实打实看一眼。这一眼,比任何手机里的 AI 都值。
数据来源与边界说明:文中引用的皮肤癌 AI 筛查数据,出自皮肤科医生 Magnus Lynch 于 2026 年 10 月 25 日在 Lynch Lab 网站自发布的测试报告(数据集为 2025 年公开的 MILK10k 活检库)。该报告属非同行评审的自发布基准测试,样本仅 200 个病灶(其中黑色素瘤 30 例),结论存在统计不确定性。
#ai检查 #胎记检查 #色素痣 #黑素瘤早筛 #鲜红斑痣 #太田痣 #皮肤镜检查
END