ARTICLE · 1291471
通用 AI 助手记不住你是谁?50K star 的港大项目把记忆拆成三层
你有没有过这种体验:跟 AI 助手聊了半小时,它对你的背景、项目、甚至你用什么语言交流都摸得一清二楚;然后第二天换个会话,它问你是谁。
不是它笨。是通用大模型的知识停在预训练那一刻,它没有"你"这个概念——你说过的话,对它来说只是又一段上下文。
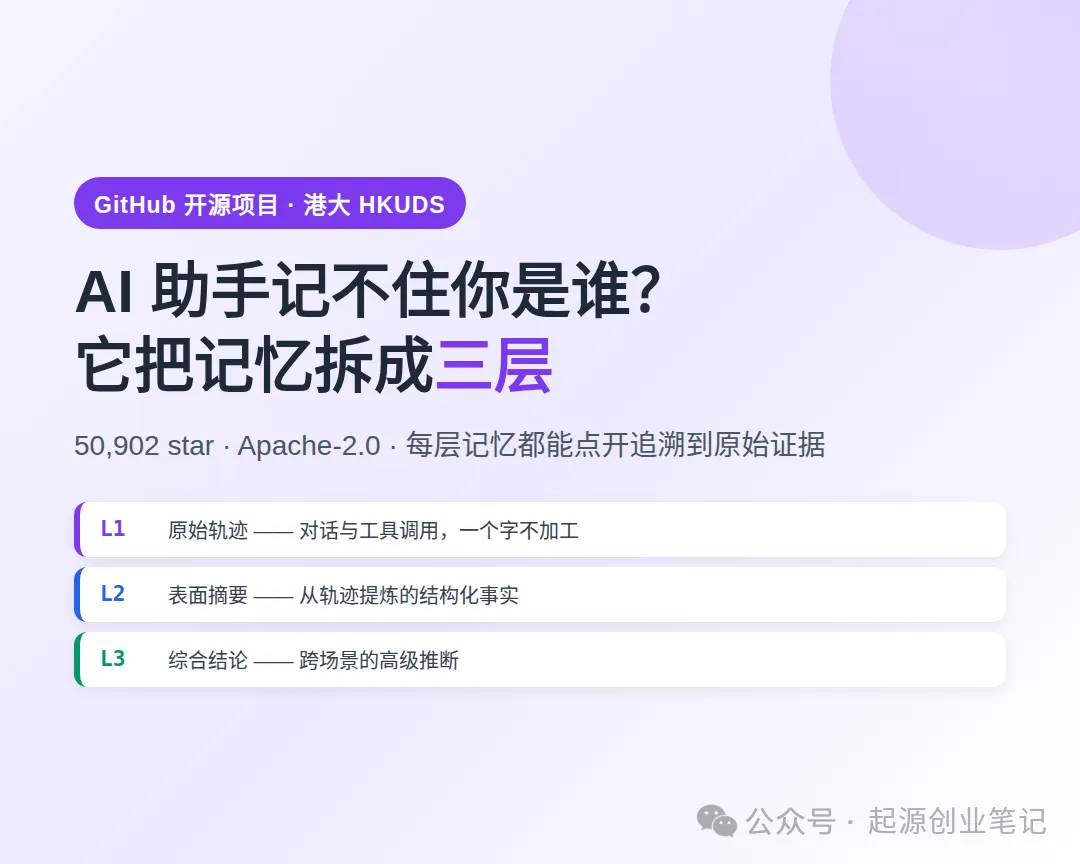
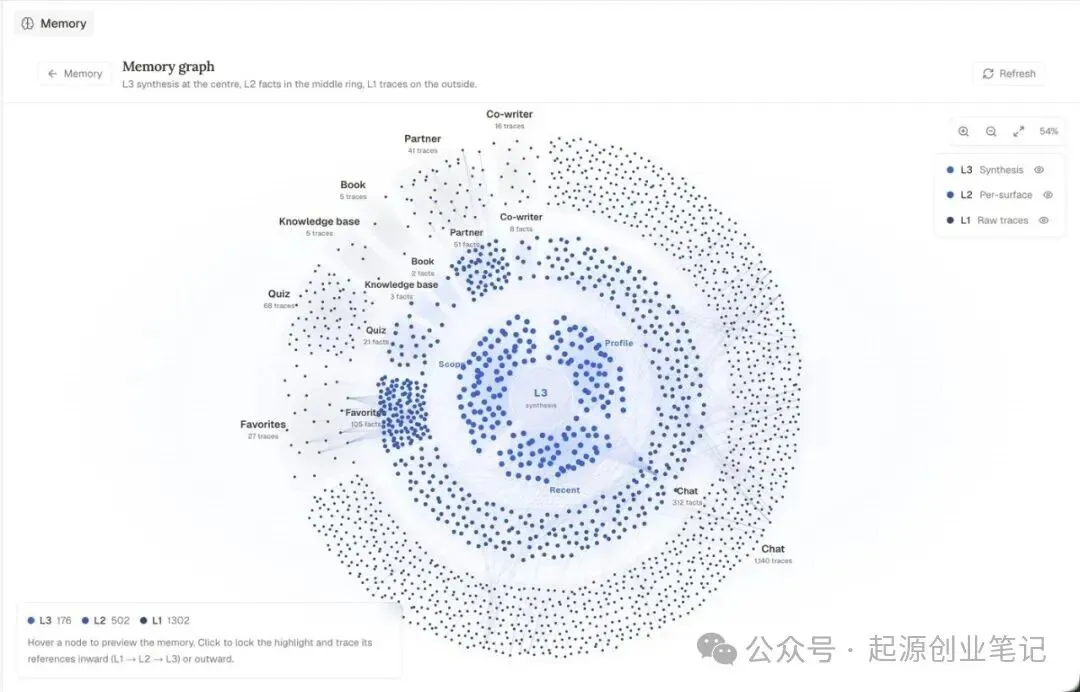
港大一个团队把这件事拆开重做了一轮:把记忆做成三层,每一层都能点开看、能追溯、能改。 L1 是原始轨迹,L2 是从轨迹里提炼的表面摘要,L3 是跨场景的综合结论。Memory Graph 把 L2 的每条事实链回 L1 的原始证据,把 L3 的结论链回贡献它的那些表面。
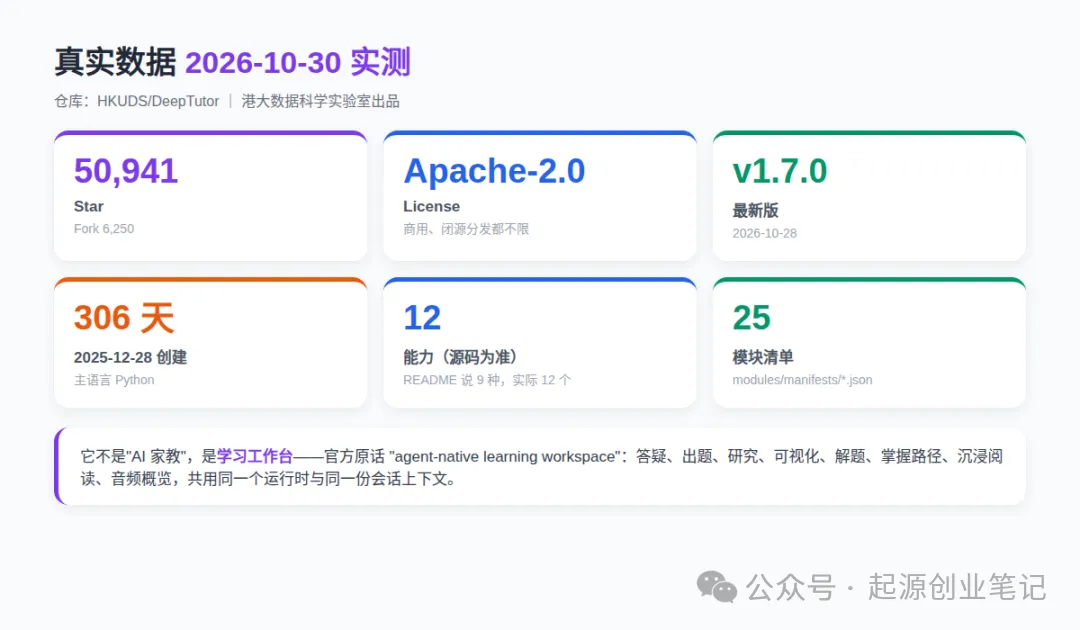
这个项目叫 DeepTutor,目前 50,941 star,Apache-2.0 协议,港大数据科学实验室出品,还发过 arXiv 论文。
一、它的真实数据,先摆出来
| Apache-2.0 | |
>=3.11,<3.15 | |
有一个细节值得单独说:它不是"AI 家教",是"学习工作台"。 官方描述是 "agent-native learning workspace"——把答疑、出题、研究、可视化、解题、掌握路径、沉浸阅读、音频概览这些能力放进同一个运行时,共用同一份会话上下文。
主仓库:https://github.com/HKUDS/DeepTutor
二、为什么"AI 失忆"值得单独做个项目
论文摘要里,作者对问题的判断相当直接:
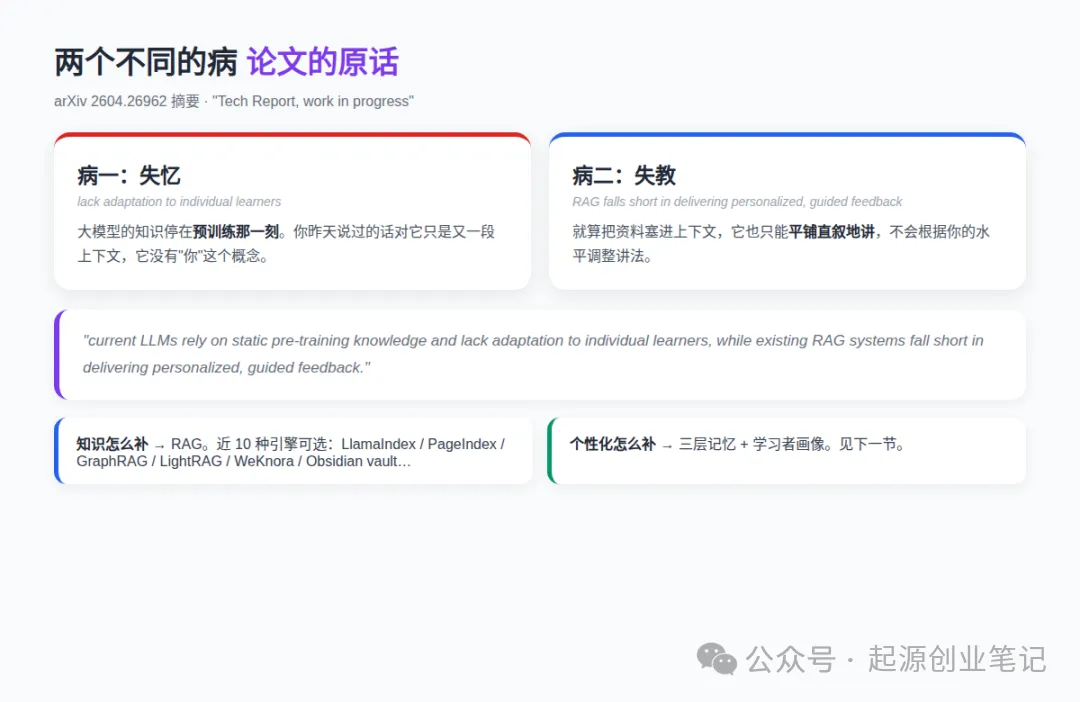
current LLMs rely on static pre-training knowledge and lack adaptation to individual learners, while existing RAG systems fall short in delivering personalized, guided feedback.
翻译过来是两句:大模型的知识是静态的,不随学习者变化;现有的 RAG 系统虽然能把资料塞进上下文,但给不出个性化的引导。
这两句话拆出了两个不同的病:
• 失忆——模型不知道"你是谁、你在哪、你已经会了什么" • 失教——就算塞给它一堆资料,它也只能平铺直叙地讲,不会根据你的水平调整讲法
DeepTutor 的解法是把两件事分开处理:知识靠 RAG 补(10 种引擎可选),个性化靠 三层记忆 + 学习者画像 补。
还有个细节挺有意思:它能从 ChatGPT、Claude Code、Codex 的官方数据导出里导入历史对话,变成可搜索、可续接的会话。不是让你重新讲一遍自己,是把你的历史搬过来。
三、核心能力一:把记忆做成三层,而且能查证
这是整个项目技术上最扎实的部分。
L1 原始轨迹(traces)——对话和工具调用的原始记录,一个字都不加工。 L2 表面摘要(surface summaries)——从 L1 里提炼出的结构化事实。 L3 综合(synthesis)——跨场景、跨时间的高级结论。
关键不在分层本身,而在 Memory Graph 把它们连起来了:L2 的每一条事实都能链回 L1 的原始证据,L3 的每条结论都能链回贡献它的那些表面。
这解决的是一个真实痛点——AI 给你的结论,你凭什么信? 多数记忆系统给你一个黑盒结论,你没法验证它是从哪句话推出来的。DeepTutor 的做法是让你点开看证据链。
官方文档 docs-for-dev/ 里甚至专门放了一份 REASONING_SAFETY_CHECKLIST.md,让用户在"答案丢了之前的约束、引用了弱证据、或跟选定的资料冲突"时,先按清单收集诊断信息再去提 issue。把"AI 不可信"当成工程问题处理,这点比功能列表更值钱。
论文给了两个数字(作者自测,未经第三方验证,论文状态是 "Tech Report, work in progress"):
• 个性化指标平均提升 10.8% • 通用 agentic reasoning 在 5 个 backbone 模型上提升 29.4%
配套还提出了 TutorBench——一个交互式评测基准,用大学课程、五个领域的学习者画像做评测,并配了一套 LLM 扮演学生模拟器的第一人称交互评测协议。
四、核心能力二:能被别的 AI 驱动,也能挂一堆 AI 进来
这个项目的定位很特别——它自己就是给 agent 用的。
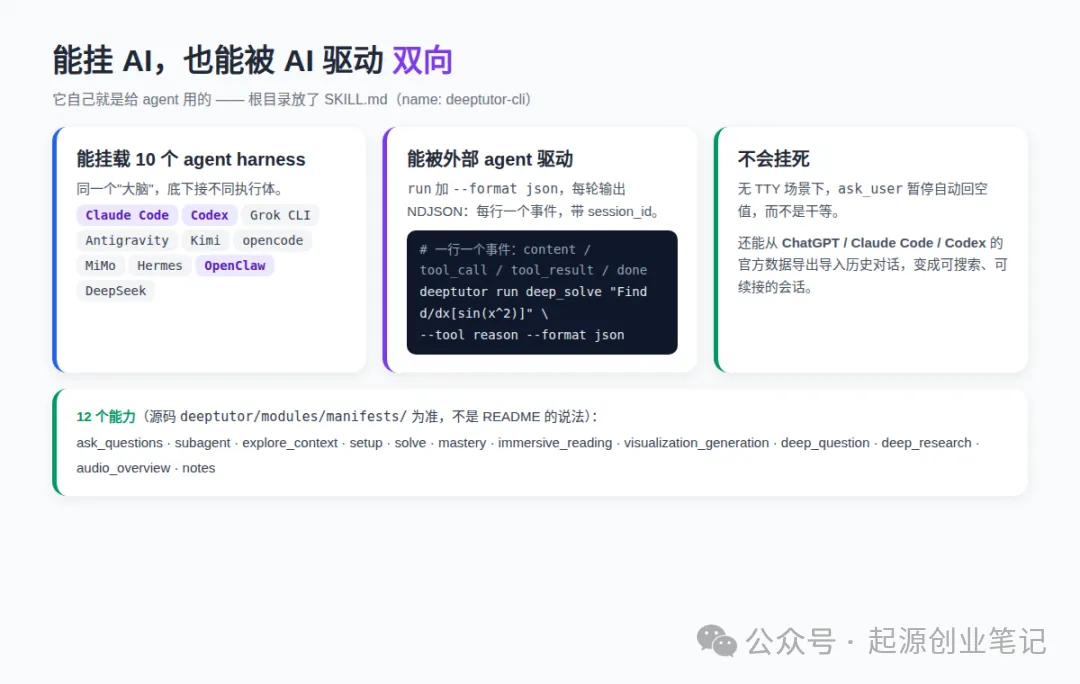
能挂载 10 个 agent harness:从对话框里可以直接调起 Claude Code、Codex、Grok CLI、Antigravity、Kimi、opencode、MiMo、Hermes、OpenClaw、DeepSeek。同一个"大脑",底下接不同的执行体。
能被外部 agent 驱动:CLI 的 run 子命令加 --format json,每一轮输出 NDJSON(每行一个事件:content / tool_call / tool_result / done),每行带 session_id。而且明确处理了无 TTY 场景——ask_user 暂停时自动回空值,不会挂死。
官方在仓库根目录放了 SKILL.md(name 是 deeptutor-cli),就是给 agent 读的交接文档。
还有 12 个能力(源码 deeptutor/modules/manifests/ 为准,不是 README 的说法):
ask_questions subagent explore_context setupsolve mastery immersive_readingvisualization_generation deep_questiondeep_research audio_overview notes以及 25 个模块清单(core / knowledge / mastery / memory / notebook / partners / questions / research / reading / server / solve / visualize / video-lesson / books / co-writer / calendar / web / parsing / providers / renderer-anim + 4 个 parser)。v1.7.0 的模块化安装不是宣传语,源码里确实是这套结构。
另外,Partners 支持把 AI 接到 IM 平台,官方仓库里能看到 16 个 IM 渠道的实拍:微信、QQ、钉钉、企业微信、Telegram、Discord、Slack、Matrix、Teams、邮件、WhatsApp、Zulip、Mattermost、MoChat、NapCat 等。
五、自带技能社区,81 个教学 skill 现成可装
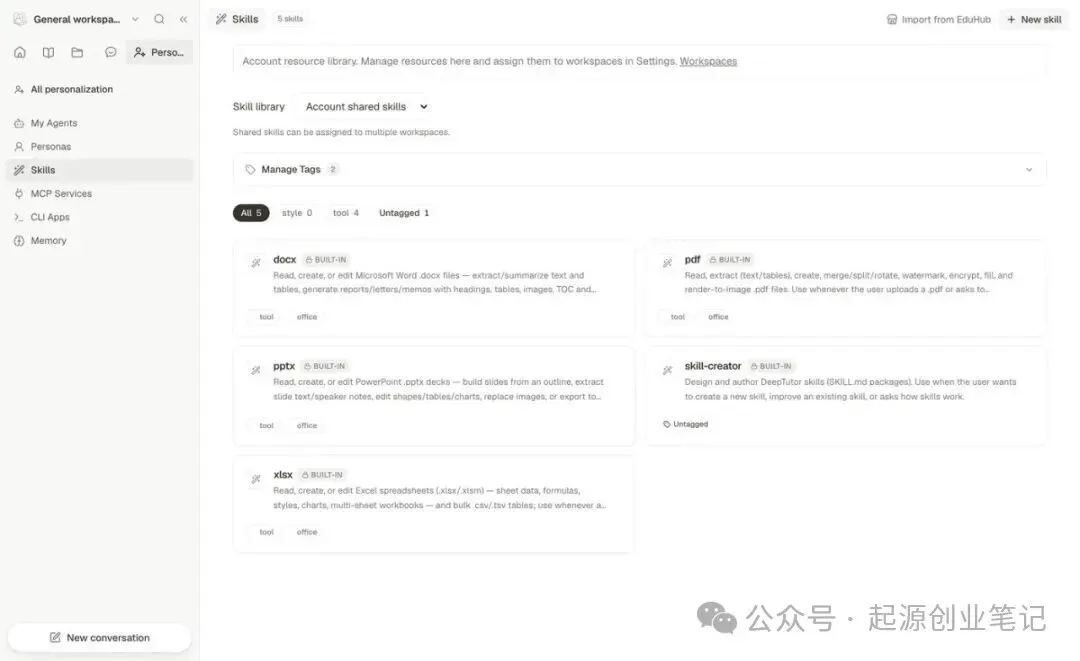
DeepTutor 顺手做了个教育向的技能注册表 EduHub,内置在应用里,不用配置。
它的 skill 用的是开放的 Agent-Skills 格式——就是一个文件夹加一份 SKILL.md(YAML frontmatter + Markdown)。这个格式不是 DeepTutor 专有的,任何说这个格式的注册表都能变成你的技能来源。
实测拉了一下,目前 81 个 skill,其中教学相关的 33 个。看几个名字就知道它想干什么:
• review-coach——带用户系统复习一门课:先清点全部考点、建覆盖率账本和依赖框架,再切成一讲讲推进,每讲配分层递进的习题,每讲结束核对无缺漏• explain-it-back——把读完之后的碎片化回忆整理成一段连贯的解释• learn-to-apply——苏格拉底式的知识迁移引导• llm-learning-coach——用户丢进 md/word/ppt/pdf,自动拆解知识点再按最适合的形式呈现• clawhub-quiz-creator——从任意主题或内容生成测验
装起来很简单:
deeptutor skill search "socratic tutor" # 在默认 hub 里搜deeptutor skill install socratic-tutor # 拉取 → 校验 → 注册deeptutor skill install eduhub:socratic-tutor@1.2.0 # 钉死版本deeptutor skill list # 本地已装,带来源知识库那边给的选择也很足:LlamaIndex、PageIndex、GraphRAG、LightRAG、远程 LightRAG Server、自建 WeKnora、腾讯 IMA、MarginNote 4、Kiwix ZIM、Obsidian vault——近十种,加上可插拔的文档解析器。
还有一个省钱的细节:可以直接用你自己的 ChatGPT 订阅,不用 API Key。在 Settings → Providers 里走 OpenAI Codex OAuth 登录,凭据只落在 data/system/user-secrets/<owner>/private/openai-codex/,不需要 OPENAI_API_KEY。
六、上手:三条路,按你的场景挑
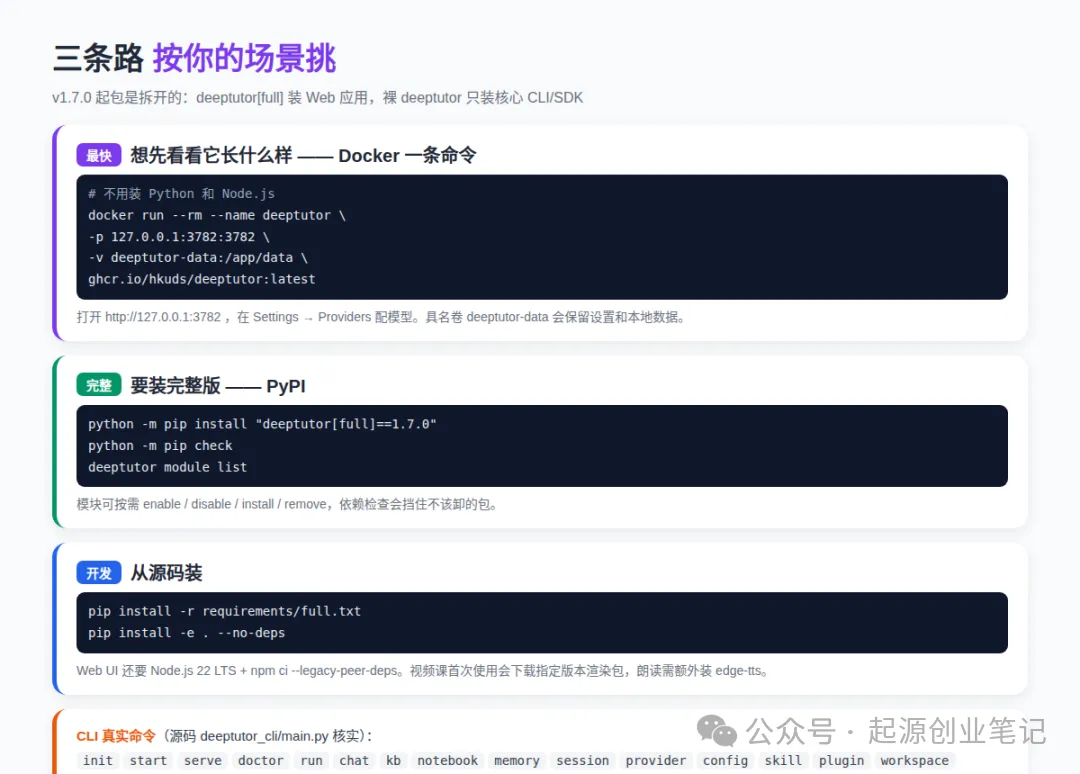
想先看看它长什么样——Docker 一条命令
docker run --rm --name deeptutor \ -p 127.0.0.1:3782:3782 \ -v deeptutor-data:/app/data \ ghcr.io/hkuds/deeptutor:latest打开 http://127.0.0.1:3782 ,在 Settings → Providers 里配模型。deeptutor-data 这个具名卷会保留你的设置和本地数据,下次直接接着用。
要装完整版——PyPI
python -m pip install "deeptutor[full]==1.7.0"python -m pip checkdeeptutor module listv1.7.0 开始包是拆开的:deeptutor[full] 装 Web 应用和标准功能模块,裸 deeptutor 只装核心 CLI/SDK。可以用 deeptutor module list 看哪些装了、哪些能用,再按需 enable / disable / install / remove。
从源码装
pip install -r requirements/full.txtpip install -e . --no-depsWeb UI 还要 Node.js 22 LTS 和 npm ci --legacy-peer-deps。视频课功能第一次用会下载指定版本的渲染包,朗读功能需要额外装 edge-tts。
CLI 真实命令目录(源码 deeptutor_cli/main.py 核实):
deeptutor init / start / serve / doctor / run / chatdeeptutor kb / notebook / memory / session / provider / configdeeptutor skill / plugin / workspace / moduledeeptutor run 支持的能力:chat / deep_solve / deep_research / deep_question / mastery / visualize / math。
deeptutor kb 的子命令:create / add / list / info / search / delete / set-default。
七、适合谁,短板也得说清楚
适合:
• 学生和自学者——三层记忆 + 覆盖率账本 + 掌握路径,是给"系统性学一门东西"设计的 • 老师和教育产品的人——EduHub 那套 skill 格式开放,可以自己写教学 skill 发出去 • 已经在用 Claude Code / Codex 的人——能挂成子 agent,能用 NDJSON 被驱动 • 想要一个自托管学习工作台的人——数据全在本机, DSH_HOME那套本地持久化,支持数据库
Apache-2.0,商用、闭源分发、二次开发都不受限——这一点比大多数教育类开源项目省心。
几个必须知道的短板:
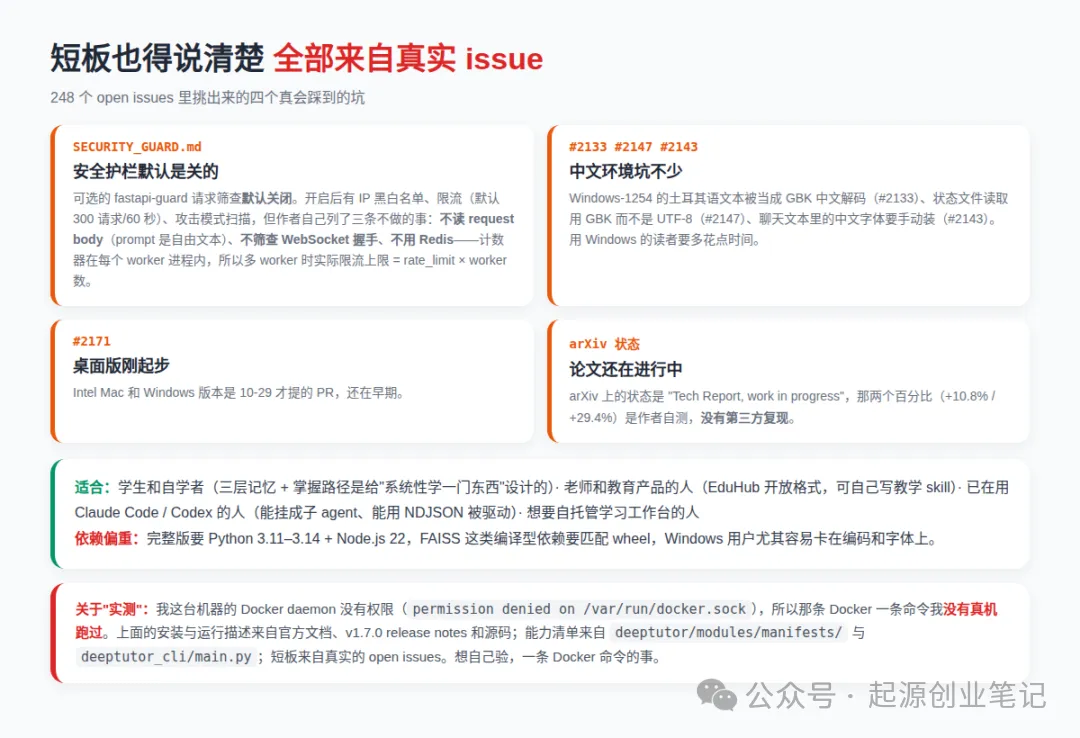
1. 安全护栏默认是关的。 仓库里有 docs-for-dev/SECURITY_GUARD.md,可选的 fastapi-guard 请求筛查默认关闭。开启后有 IP 黑白名单、滑动窗口限流(默认 300 请求/60 秒)和攻击模式扫描,但作者自己列了三条不做的事:
• 不读 request body(prompt、文档、聊天记录都是自由文本,扫描关闭) • 不筛查 WebSocket 握手,只管 HTTP • 不用 Redis——计数器在每个 worker 进程内,所以 backend_workers > 1时,实际限流上限是 rate_limit 乘以 worker 数。这不是 bug,但多 worker 部署时得自己算
2. 中文环境坑不少。 248 个 open issues 里有一串编码问题:Windows-1254 的土耳其语文本被当成 GBK 中文解码(#2133)、状态文件读取用 GBK 而不是 UTF-8(#2147)、聊天文本里的中文字体要手动装(#2143)。用 Windows 的读者要预期多花点时间。
3. 桌面版刚起步。 Intel Mac 和 Windows 版本是 10-29 才提的(#2171),还在早期。
4. 论文还在进行中。 arXiv 上的状态是 "Tech Report, work in progress",那两个百分比是作者自测,没有第三方复现。
5. 依赖偏重。 完整版要 Python 3.11–3.14 + Node.js 22,FAISS 之类编译型依赖要匹配 wheel,源码安装还得分模块装。Windows 用户尤其容易卡在编码和字体上。
关于"实测": 我这台机器的 Docker daemon 没有权限(
permission denied on /var/run/docker.sock),所以那条 Docker 一条命令我没有真机跑过。上面关于安装和运行的描述来自官方文档、v1.7.0 release notes 和源码,能力清单来自deeptutor/modules/manifests/与deeptutor_cli/main.py,短板来自真实的 open issues。想自己验,一条 Docker 命令的事。
八、写在最后
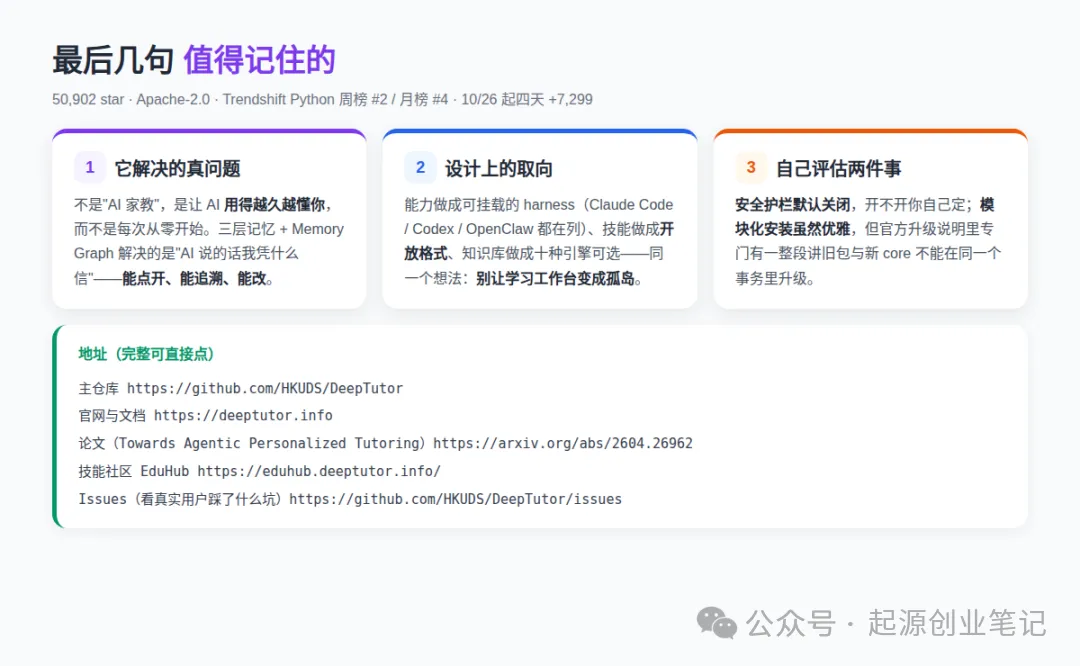
它想解决的问题其实很朴素:AI 用得越久,应该越懂你,而不是每次都从零开始。
三层记忆 + Memory Graph 不是一个炫技的设计——它解决的是"AI 说的话我凭什么信"这个具体问题。L2 的事实能链回 L1 的原始证据,L3 的结论能链回贡献它的表面。你能点开、能追溯、能改。
而它把能力做成可挂载的 harness(Claude Code、Codex、OpenClaw 都在列)、把技能做成开放格式、把知识库做成十种引擎可选——这些选择背后是同一个想法:别让学习工作台变成一个孤岛。
50,941 star 不是白来的。它在 GitHub 趋势的第三方追踪站 Trendshift 上挂着日榜徽章(当前是 Python 周榜第 2、月榜第 4),10 月 26 日起四天涨了 7,299 个 star。
要盯的两件事:一是安全护栏默认关闭这件事,你自己评估要不要开;二是模块化安装虽然优雅,但升级时的坑不少——官方升级说明里有一整段在讲"旧版 deeptutor-cli 包和新 core 不能在同一个事务里升级"。
想试的话,下面三个地址。
• 主仓库:https://github.com/HKUDS/DeepTutor • 官网与文档:https://deeptutor.info • 论文(DeepTutor: Towards Agentic Personalized Tutoring):https://arxiv.org/abs/2604.26962 • 技能社区 EduHub:https://eduhub.deeptutor.info/ • Issues(看真实用户踩了什么坑):https://github.com/HKUDS/DeepTutor/issues